Traducción automática. Leer el original en inglés: Your performance review is a memory test →
Pregunta a cualquier engineering manager quién es su mejor ingeniero. La respuesta llega antes de que termines la pregunta, sin dudar y sin un “déjame comprobar algo primero”. Lo saben. Siempre lo han sabido.
Ahora pídeles que muestren el trabajo.
Te darán una historia. Una buena historia, normalmente, sobre un incidente que alguien gestionó a las 2 de la madrugada, o un refactor que desbloqueó un trimestre. Lo que no obtendrás es un número, una comparación, ni ninguna mención a los cuatro ingenieros cuyo trabajo el manager no presenció. Esa confianza se construye a partir del recuerdo, y el recuerdo es una función de la proximidad.
Aquí está la tesis. El rendimiento en ingeniería se juzga desde la memoria, la memoria premia la visibilidad en lugar del valor, y el trabajo que realmente quieres que la gente haga está escrito en un roadmap que nunca está conectado con aquello con lo que los evalúas. Esos dos documentos no tienen nada que ver entre sí en casi todas las empresas que he visto, incluida la mía.
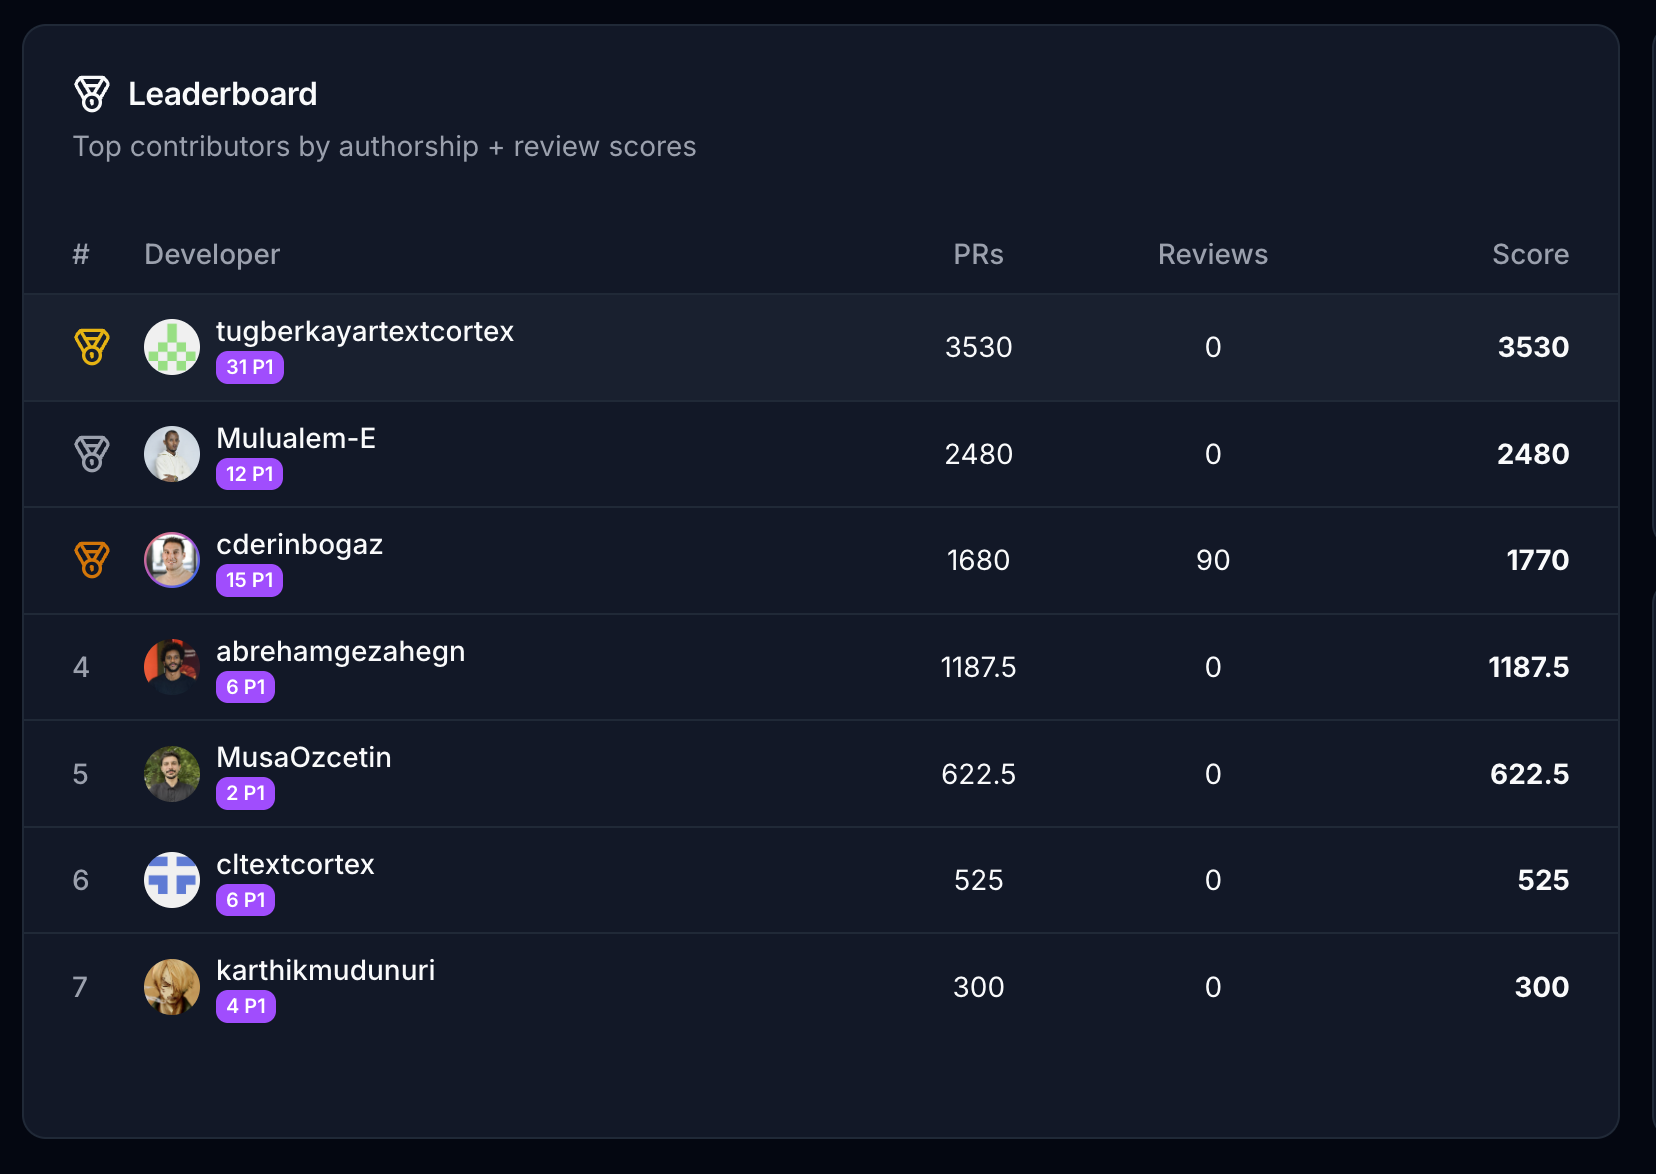
Así que los conectamos. Cada pull request fusionado es leído por un modelo, se le asigna una severidad, y se multiplica por cuánto le importa a nuestro roadmap el componente que tocó. El resultado es una tabla de clasificación mensual, y alimenta las decisiones de bonus. Aquí está la nuestra.
La sabiduría recibida dice que esto no se puede medir, y la sabiduría recibida es un encogimiento de hombros
La posición estándar sobre medir el rendimiento individual es que no debes hacerlo, porque cada proxy es una trampa. Las líneas de código premian la hinchazón. El número de commits premia la fragmentación. Los tickets cerrados premian a quien coge los pequeños primero. Los story points son una negociación que ocurre antes de que empiece el trabajo. Incluso los buenos frameworks son deliberadamente a nivel de equipo: DORA mide cuatro cosas sobre un pipeline de entrega y no dice nada sobre las personas, algo que sus autores dejan explícito.
Todo eso es correcto, y nada de ello es una respuesta. La clasificación ocurre de todos modos, cada año, en época de compensación, en una sala, desde la memoria, ponderada por quién se sentó al lado de quién en esa sala. Negarse a medir te compra una clasificación sin rastro de auditoría y sin apelación.
Llamémosla la prima del ingeniero ruidoso: la diferencia entre lo bien que te valoran y lo bien que rendiste, explicada enteramente por tu distancia respecto a quien escribe tu evaluación. Pide a cualquier humano que compare las contribuciones técnicas de quince personas a lo largo de un año usando solo lo que les pasó por delante, y esto es lo que sale. Cualquiera de nosotros lo produciría.
Esa prima fue inevitable hasta hace unos dos años, porque la materia prima para una mejor respuesta era un montón de diffs que nadie tenía tiempo de leer. Esa restricción ha desaparecido. Un modelo puede leer cada diff de tu repositorio cada mes por menos del coste de la reunión donde actualmente adivinas. Leerlos es la parte fácil. Decidir cuánto vale lo leído es todo el problema, y eso no es una cuestión técnica.
La fórmula entera cabe en una línea
Aquí está, completa, del camino de puntuación en GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0No lo he simplificado para el blog. Es la línea tal como se ejecuta, sin regresión oculta, sin ponderación aprendida, sin término de reputación y sin ajuste por antigüedad. Severidad por importancia, o cero.
La severidad es una escalera fija, establecida una vez y visible para todos los que son evaluados.
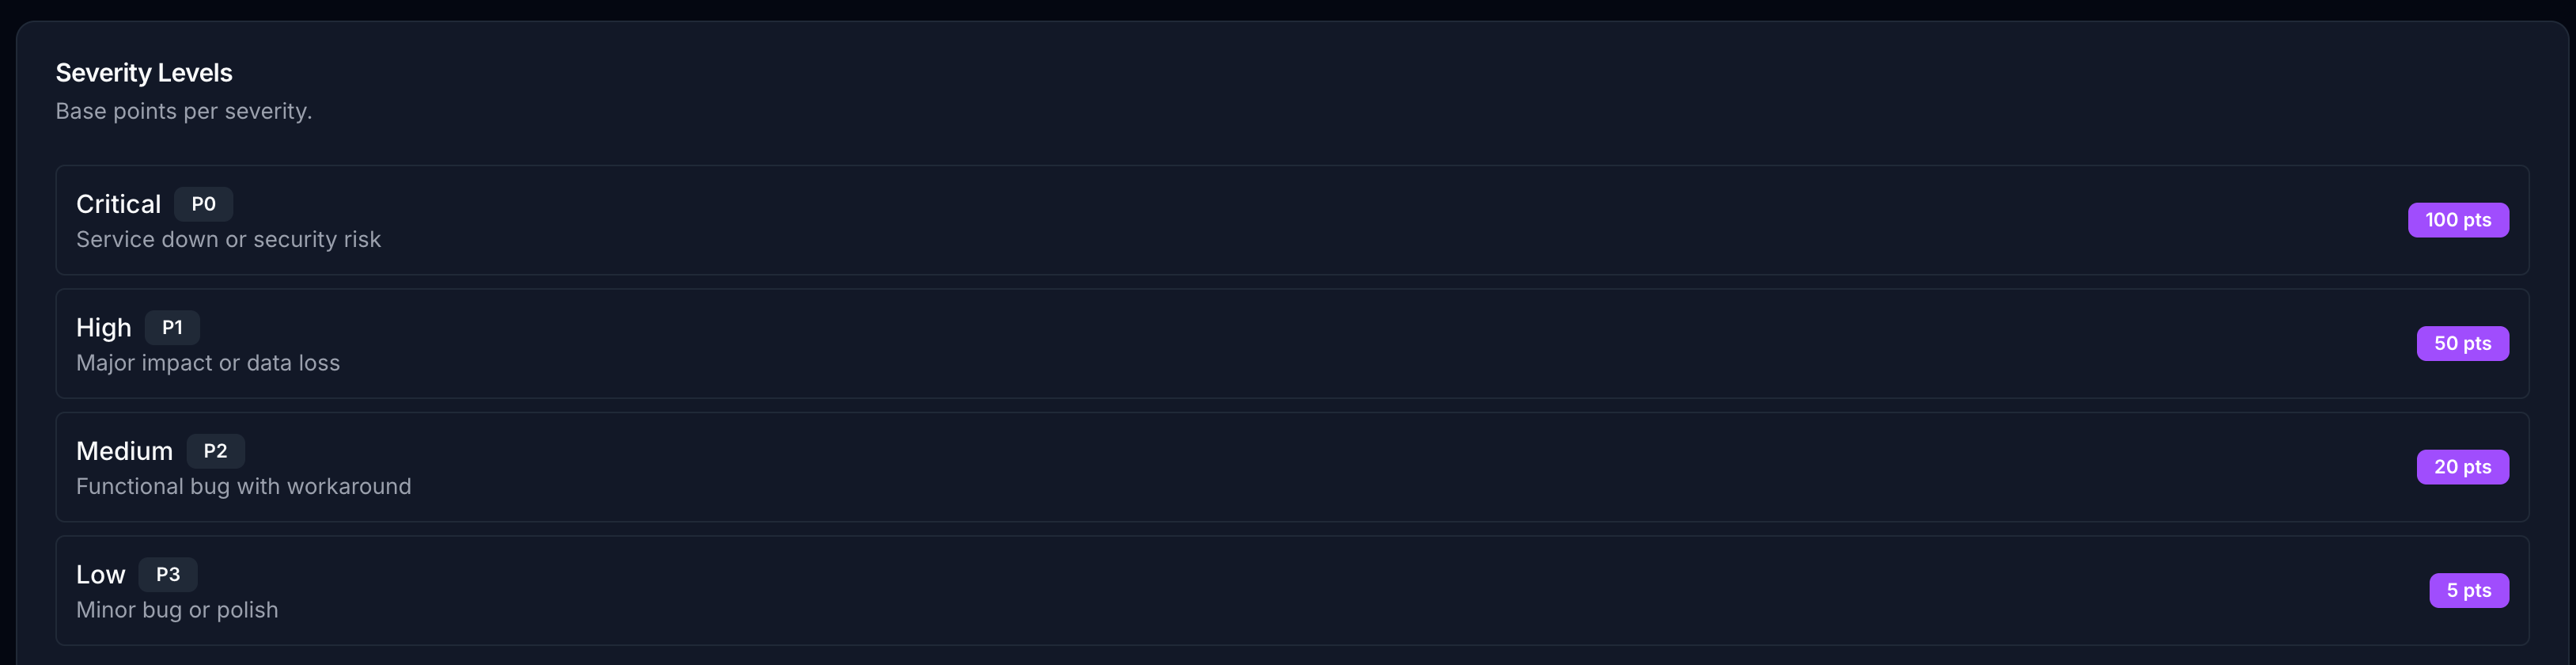
Una corrección crítica vale veinte de baja prioridad. Esa proporción es una declaración de política, y la escribimos en lugar de dejarla en la cabeza de alguien.
La importancia es la mitad que importa. Cada componente lleva un multiplicador, y el multiplicador es lo que el producto necesite este trimestre.
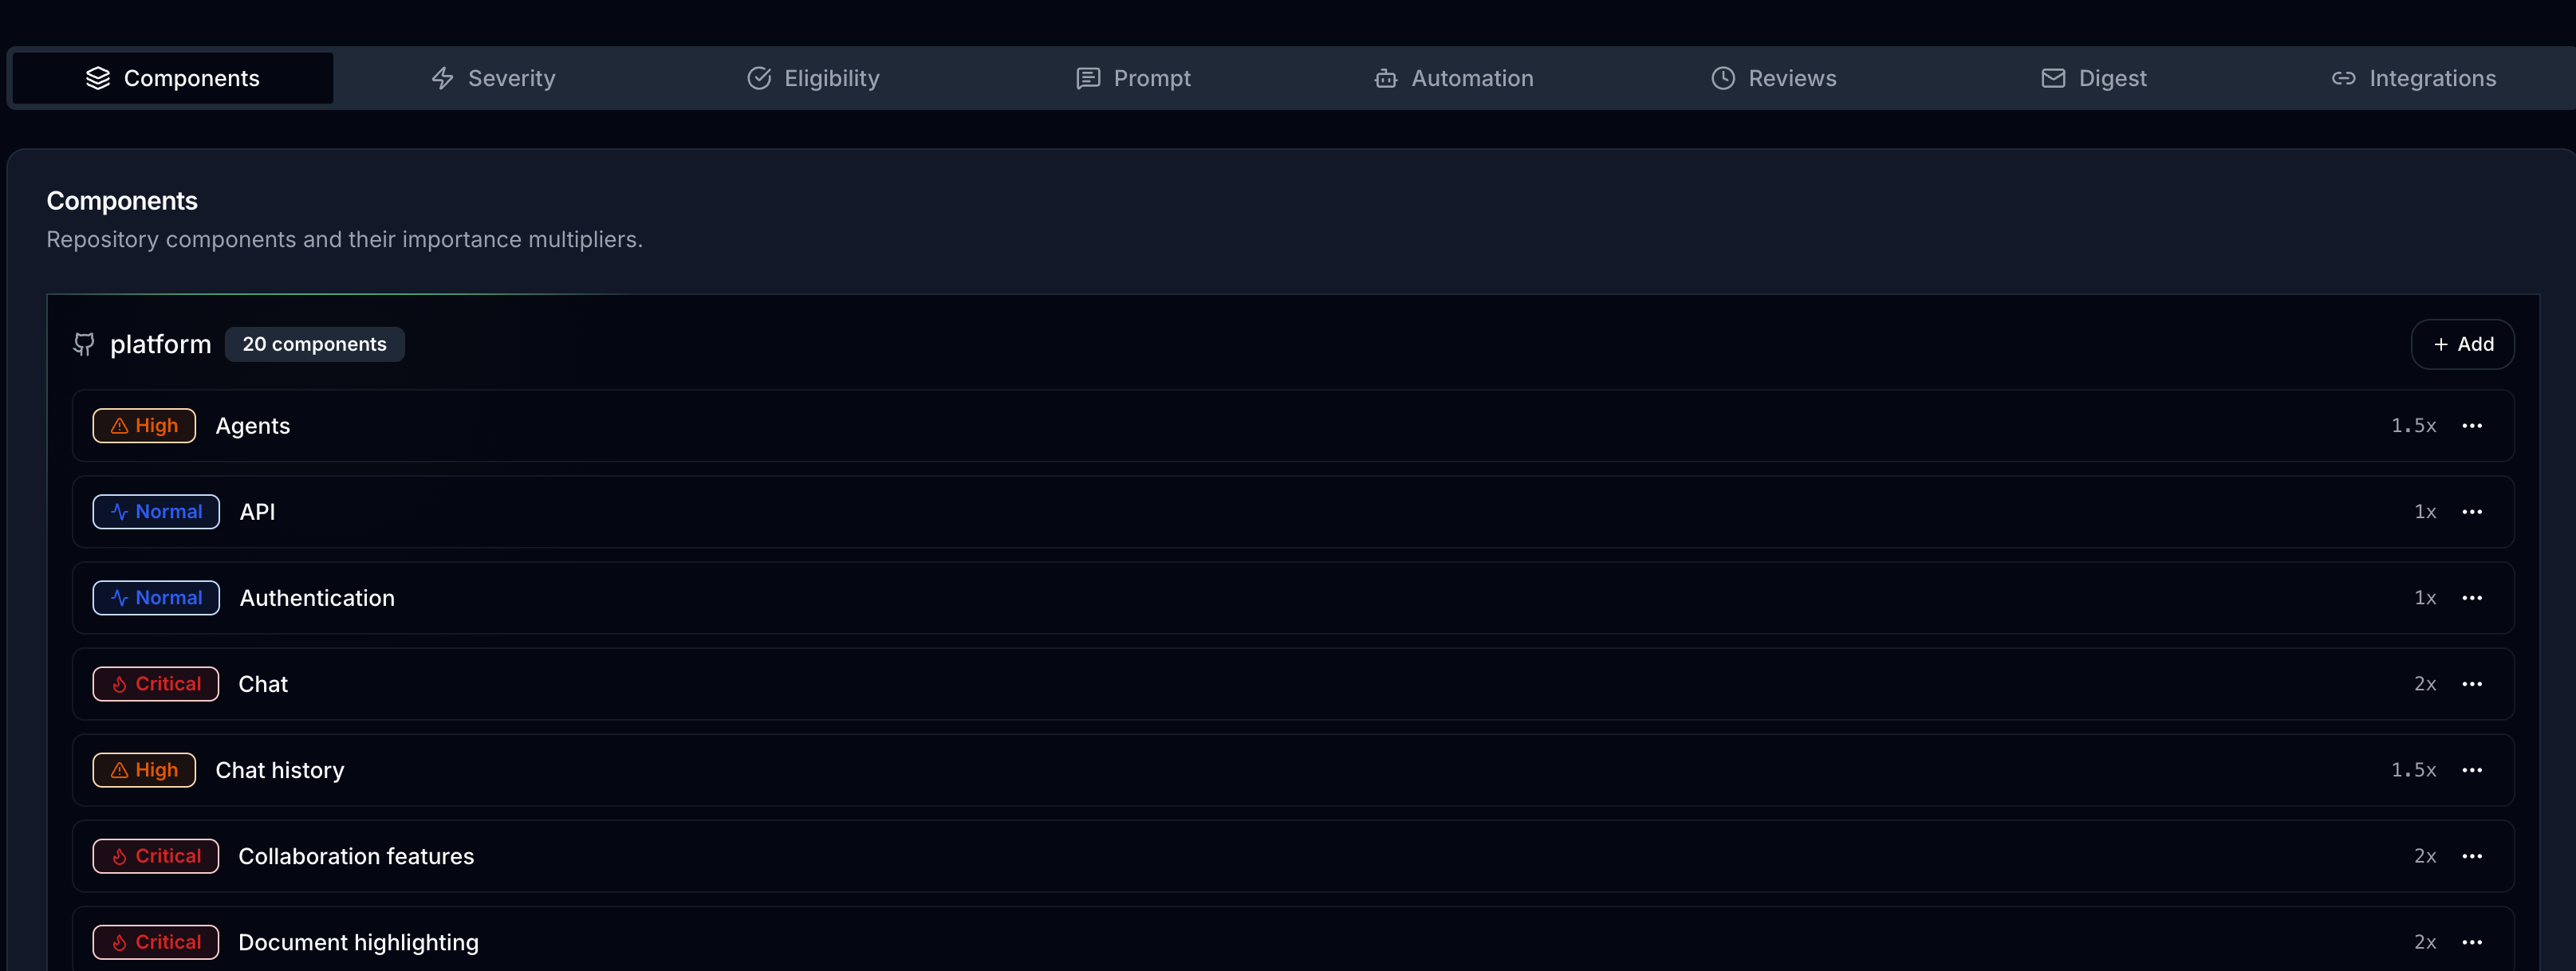
Chat es 2.0x porque chat es en lo que estamos apostando el producto. Authentication es 1.0x porque funciona y nos gustaría que siguiera funcionando en silencio. Esas son decisiones de producto, y la tabla de multiplicadores es donde se reescriben en un campo que paga.
El documento de estrategia y el input de compensación se convirtieron en el mismo documento. Ese es el movimiento. El modelo es fontanería y la tabla de clasificación es una representación de ello, y si el roadmap cambia en octubre, entonces el incentivo cambia en octubre, en lugar de en un ciclo de evaluación catorce meses después.
Déjame explicar esto, porque es la parte que la gente se salta. Cuarenta personas inteligentes, cada una optimizando local y honestamente, producirán un trimestre de trabajo que no suma lo que la empresa dijo que quería. Nadie en esa imagen es perezoso, que es lo que lo hace difícil. Los mandos intermedios existen en gran parte para arreglarlo, llevando la estrategia en conversaciones de escritorio en escritorio, perdiendo fidelidad en cada salto. Una tabla de multiplicadores hace el mismo enrutado en un solo salto, y en octubre sigue diciendo exactamente lo que escribiste en enero.
Joi Ito ya puso nombre a la diferencia. Uno de los nueve principios de Whiplash, escrito con Jeff Howe en 2016, es pull over push: tiras de la red cuando lo necesitas en lugar de mantenerlo todo en stock. Ito describía recursos. La dirección se comporta igual. Una organización push acumula la estrategia en la capa de gestión y la reparte en conversaciones, por eso llega al borde de la empresa tarde y con pérdidas. Una organización pull publica la estrategia como una lista de precios y deja que la gente tome lo que necesita. La tabla de multiplicadores es esa lista de precios.
Una corrección crítica en chat vale cuarenta commits de pulido en la API
Junta las dos mitades y la brecha es severa. Un P0 en chat puntúa 100 base por 2.0, es decir, 200 puntos. Un P3 en la API puntúa 5. Cuarenta a uno, que es la distancia entre el pull request más valioso que puedes fusionar aquí y el menos valioso.
Esa proporción es deliberadamente violenta, y consigue lo que los incentivos suaves nunca logran. Nadie reorganiza su semana por una diferencia del 15%. La gente definitivamente reorganiza su semana por una de 40x.
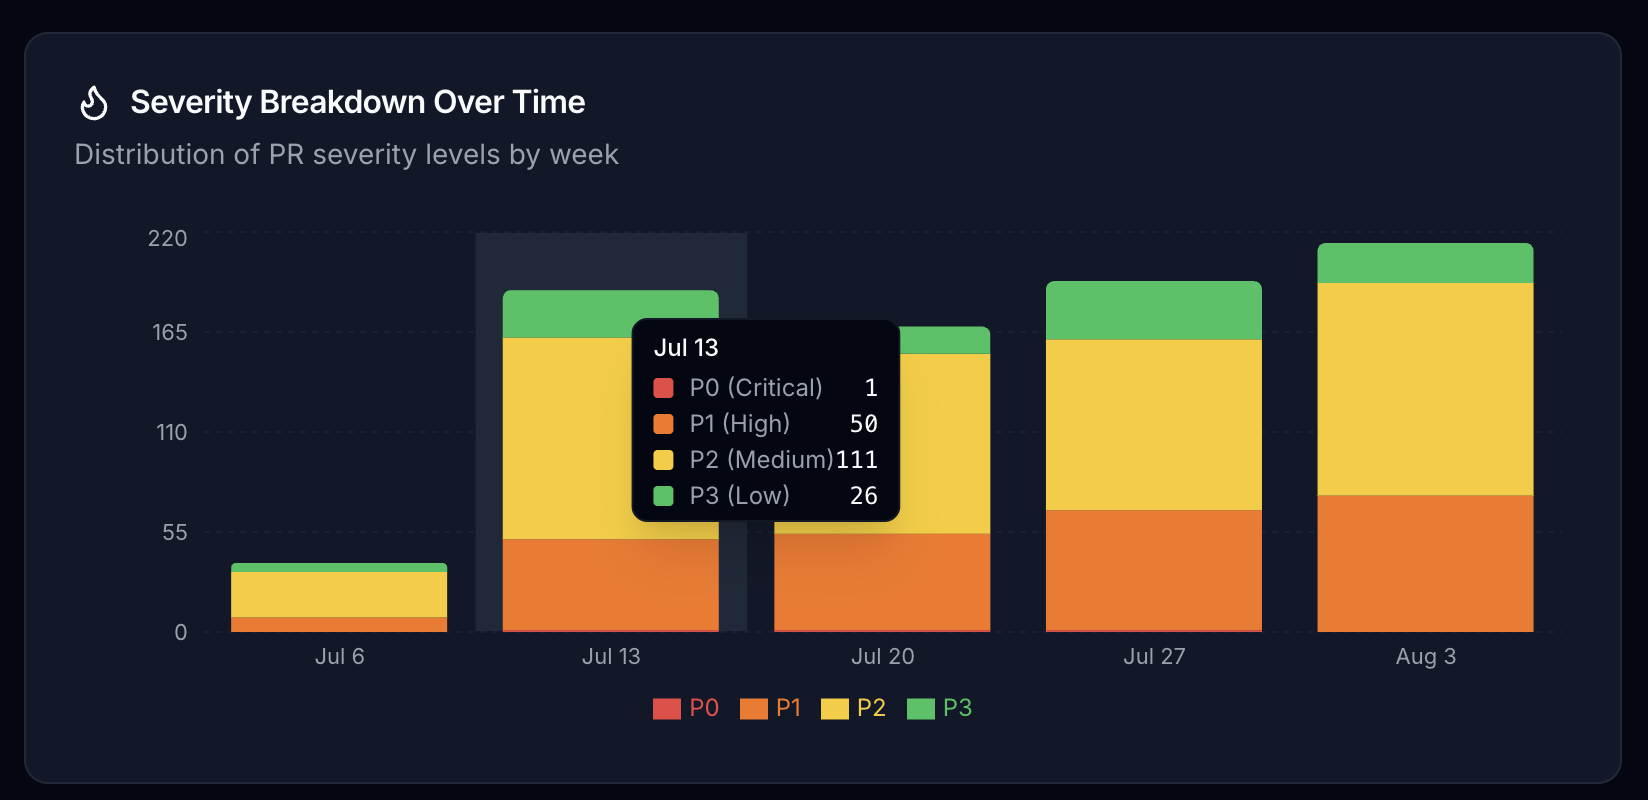
188 pull requests en una sola semana. Los P2 son el 59% de ellos, que es lo que parece una semana normal de ingeniería en cualquier sitio. Ahora ponle peso. Esos 111 P2 valen 2.220 puntos. Los 50 P1 valen 2.500. Menos de la mitad de pull requests concentran más de la mitad del valor de la semana. Cuenta pull requests y concluyes que la semana fue de P2. Ponles peso y la semana fue de cincuenta piezas de trabajo concretas, y puedes nombrar quién las hizo.
Dos personas fueron el 58% de la producción, y yo tenía el orden equivocado
Siete desarrolladores, 10.415 puntos. El desarrollador principal acumula 3.530 de ellos, el 33,9% de todo lo que el equipo produjo en valor. Los dos primeros suman el 57,7% entre ambos.
Una concentración así suele significar que los dos primeros trabajan en los componentes de mayor multiplicador, que es exactamente lo que les pedimos. El número describe dónde aterriza el valor, y yo no leería nada en él sobre los otros cinco.
El orden es lo que rompió mi predicción.
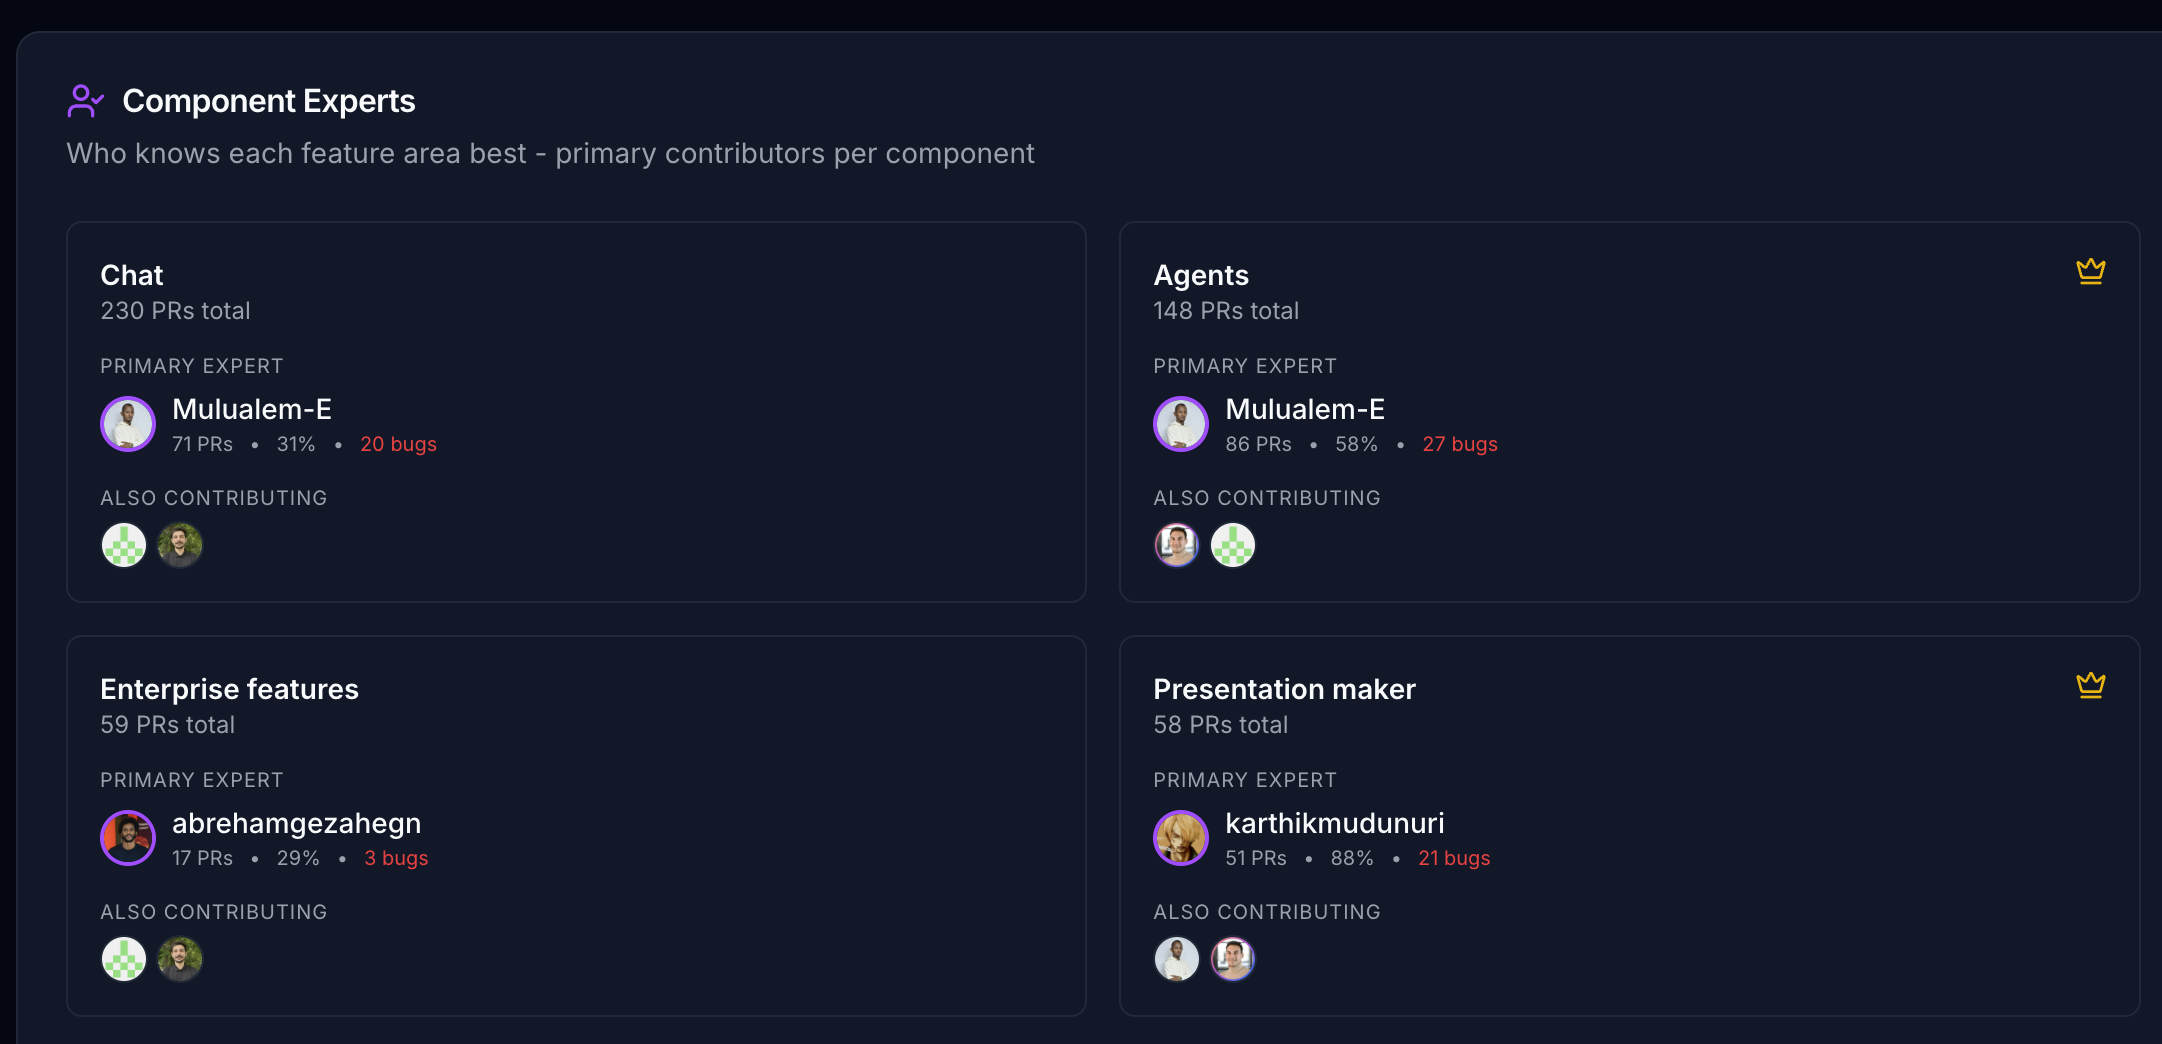
Mulualem-E es el experto principal en chat, nuestro componente de 2.0x, con 71 de sus 230 pull requests, y en agents, nuestro componente de 1.5x, con 86 de 148. Si me hubieras descrito eso y me preguntaras quién encabeza la clasificación, lo habría dicho sin dudar. Él es segundo. El primer puesto es de tugberkayartextcortex, con 31 pull requests P1 frente a los 12 de Mulualem-E.
La mezcla de severidad ganó a la propiedad del componente. Ser dueño del área más importante del producto resulta no ser lo mismo que aterrizar repetidamente trabajo de alto impacto dentro de ella, y hasta que publicamos esto no habría podido decirte cuál de las dos cosas estaba premiando nuestra compensación. Premiaba la que yo hubiera notado por casualidad. Esa es la prima del ingeniero ruidoso, pillada en mi propia empresa. Mi intuición tenía a las dos personas correctas y el orden equivocado, y el orden equivocado es lo que decide un bonus.
Payments es 45% correcciones de bugs y nadie tuvo que discutirlo
Puntuar cada pull request también acaba con la costumbre de discutir sobre calidad desde la anécdota.
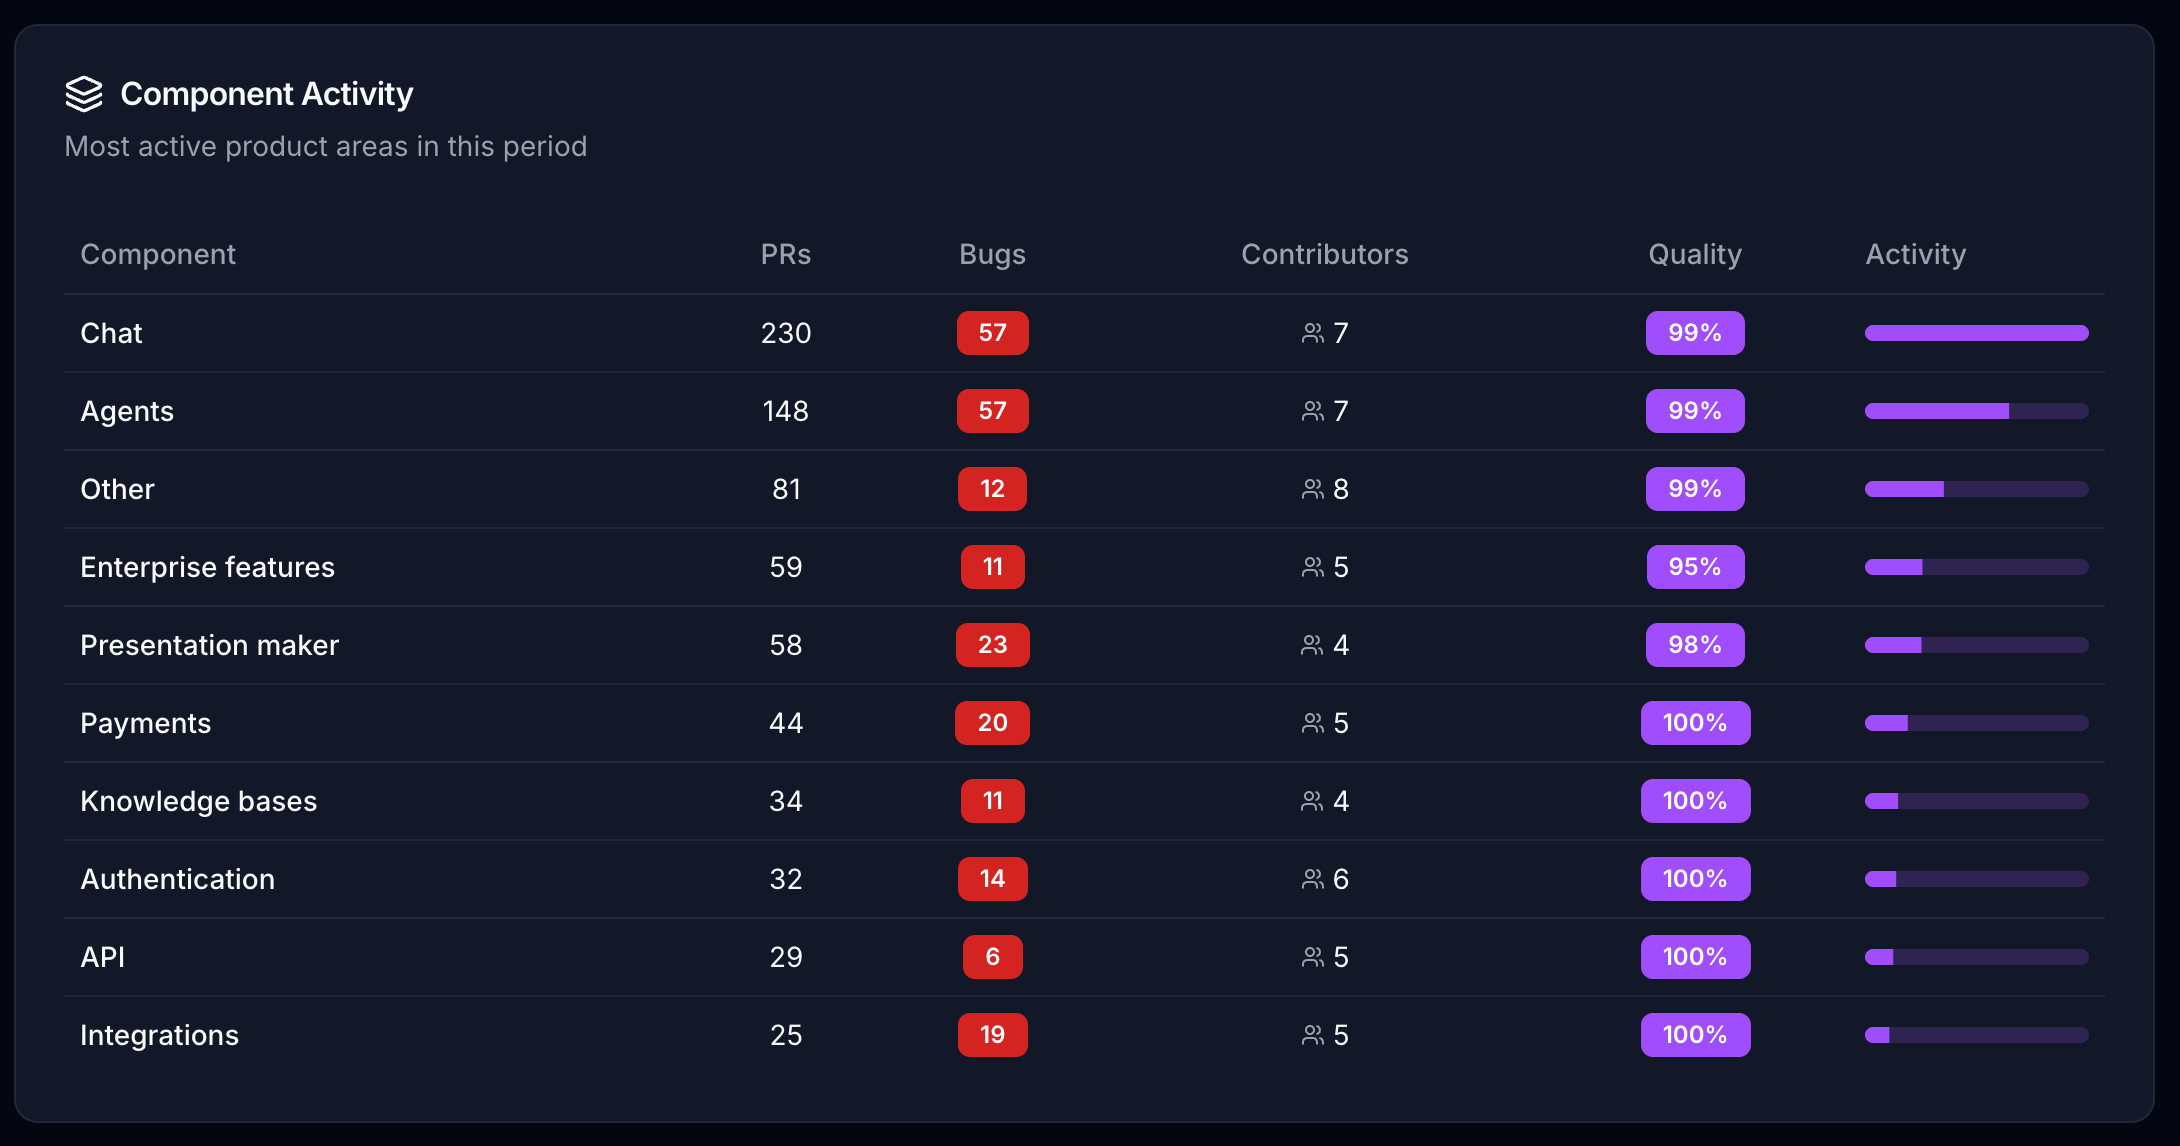
740 pull requests en los diez componentes más activos, 230 de ellos correcciones de bugs en lugar de trabajo nuevo. Solo chat son 230 pull requests, que es lo que parece un multiplicador de 2.0x cuando funciona. Luego payments: 44 pull requests, 20 bugs, un 45% de tasa de bugs en el componente que toca el dinero.
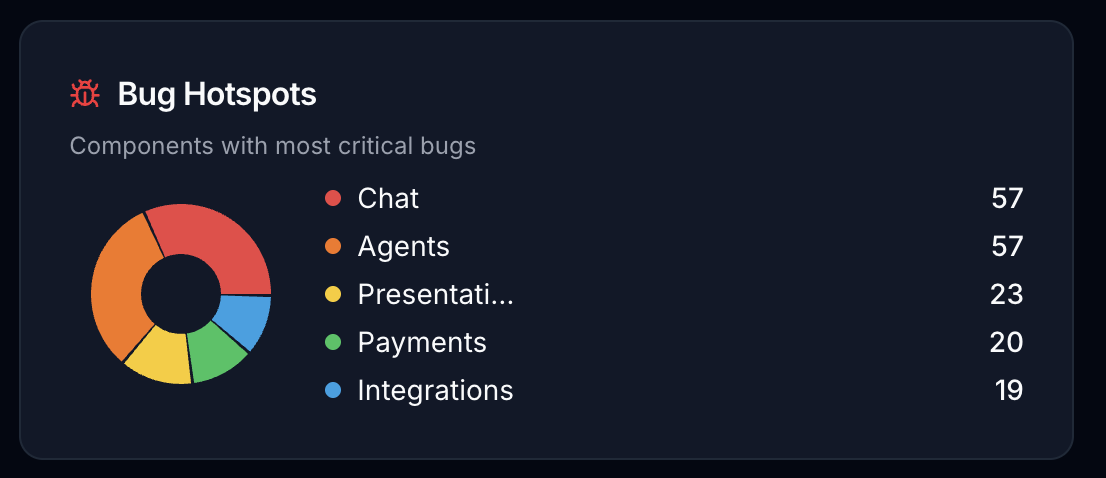
Chat y agents empatan con 57 bugs cada uno, pero chat los produjo en 230 pull requests y agents en 148. Mismo número de bugs, 55% más de trabajo detrás de uno de ellos. Esa es una señal sobre agents que ninguna retrospectiva iba a sacar a la luz, porque nadie fusionó suficientes de ambos para notarlo.
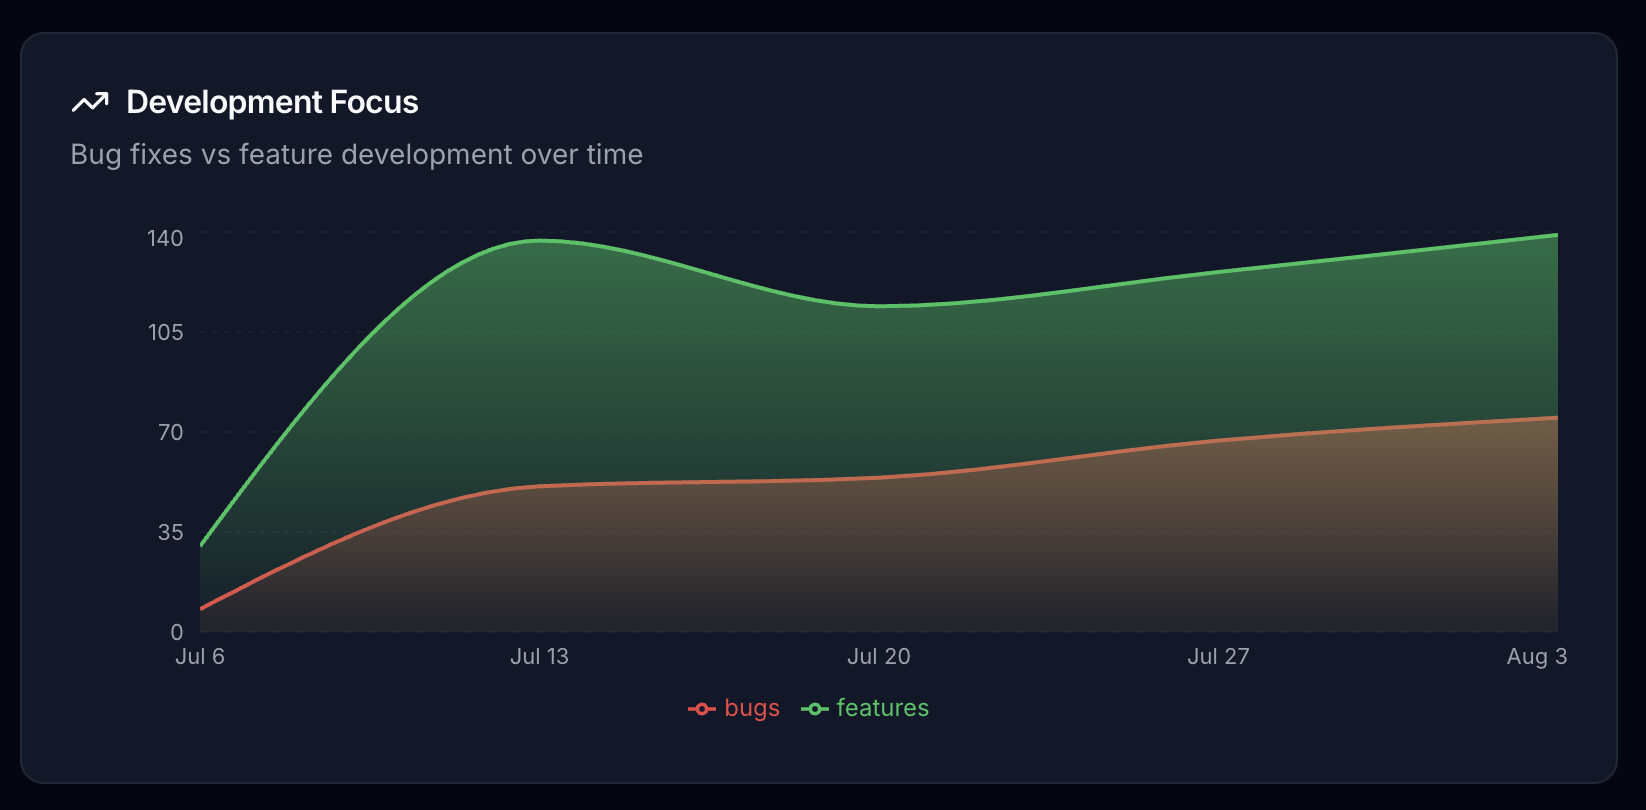
Los bugs y las funciones suben juntos en lugar de compensarse. Cinco semanas están bien dentro del ruido que produciría la llegada de un solo proyecto grande, así que trata ese gráfico como una descripción del periodo y nada más.
No tengo una cifra de mejora, y no deberías confiar en nadie que la tenga
Esta es la afirmación que quiero hacer. Desde que empezamos a publicar esto mensualmente, el trabajo se ha desplazado hacia los componentes que marcamos como importantes, porque los ingenieros quieren la puntuación.
No voy a ponerle un porcentaje. Lo activamos a mitad de proceso. No había línea base ni repositorio de control, y nunca acordamos de antemano qué significaría “desplazado”. Los multiplicadores cambiaron durante el período. También la plantilla. Cualquier cifra que publicara sería una que elegí después de ver los datos, lo que la convierte en decoración.
Lo que cambió es la discusión. La gente dejó de preguntarse si su trabajo era valorado y empezó a preguntar por qué un componente estaba calificado en 1.0x. Esa es una pelea que merece la pena tener, y es lo único por lo que habría pagado por sí solo.
Nuestra propia herramienta tampoco está limpia, y el filo más afilado es este: una pull request que puntúa cero no te dice qué criterio de elegibilidad se cerró sobre ella. Si falta el enlace al issue o los tests, la puntuación es cero sin importar la gravedad, y a la persona con más de qué discutir se le da lo mínimo con qué discutir. Estamos arreglando eso antes que cualquier otra cosa de la lista.
Apunta al roadmap y luego dale la regla a la gente
Quita la autoridad de un organigrama y lo que queda debajo es una tabla de enrutamiento. Lleva “lo que importa este trimestre” hacia afuera desde las personas que lo decidieron, y “quién hizo qué” de vuelta hacia adentro, y hace ambas cosas lentamente y con distorsión en cada salto. Todo lo que te disgusta de la política corporativa es un artefacto de compresión de ese enrutamiento. Los managers han sido el único hardware disponible para ese trabajo.
Ya no son el único hardware disponible. Un modelo que lee cada diff, más una tabla de multiplicadores, hace el enrutamiento hacia afuera en un salto y el enrutamiento hacia adentro en una consulta. Esa es la organización pull, y quiero ser exacto sobre sus límites. Nada se aplana. El liderazgo sigue fijando los multiplicadores, así que la estrategia sigue decidiéndose en una sala por unas pocas personas, y todo lo que cambia es el viaje fuera de esa sala. Lo que queda para los humanos es la parte que siempre fue el trabajo y nunca tuvo tiempo: decidir cuáles deberían ser los multiplicadores, y sentarse con las personas a las que esas decisiones movieron.
La política no desaparece. Se mueve. Se mueve de “¿mi manager recuerda mi trimestre?” a “¿por qué mi componente está calificado en 1.0x cuando el roadmap lo llama core?”, y esa segunda pelea trata sobre la estrategia real de la empresa, realizada en público, en una tabla que cualquiera puede leer. Prefiero tener esa pelea cada mes que la actual, celebrada una vez al año, en privado, por alguien reconstruyendo once meses de memoria.
Alguien va a gestionar esto mal. Alguien va a poner un marcador en la pared sin explicaciones de elegibilidad y sin rastro de anulaciones y va a despedir al decil inferior, y se le echará la culpa al modelo en lugar de a la persona que eligió los multiplicadores.
Así que mídeme con el mismo instrumento. Si ejecutas algo como esto, publica la tabla de multiplicadores, para que la gente discuta con la estrategia en lugar de con la puntuación. Publica el desglose por pull request, para que cualquiera que haya puntuado cero pueda ver qué compuerta se cerró sobre ellos y apelarla. Publica el registro de anulaciones, porque un número que un humano cambió a mano es el único número que vale la pena auditar. Publicamos el primero. Hacemos el tercero mal. No publicamos el segundo en absoluto, y ese es el que decide si algo como esto es una herramienta de gestión o solo una forma más rápida de ser injusto.
GitRank está en gitrank.dev y tiene licencia CC BY-NC 4.0. La puntuación en la ruta de producción se ejecuta en Claude Haiku 4.5 a temperatura 0.3. Todas las cifras anteriores provienen de nuestro propio repositorio de plataforma entre el 6 de julio y el 3 de agosto de 2026, tamaño de muestra de una empresa y siete desarrolladores, que es una descripción de nosotros y no un benchmark de nada.