Traducción automática. Leer el original en inglés: Train your own Jev: an 11x faster System-1 model with almost free hosting →
El viernes escribí sobre Raya, el router que elige un nivel de modelo para cada prompt en TextCortex. Saca un 81% en nuestro benchmark de 563 prompts y responde en 30 ms en una CPU en Falkenstein. Ese artículo no contaba cómo construir uno.
La receta ya es pública, en la
carpeta training/
del repo de Raya en Hugging Face, bajo Apache-2.0. Describe la decisión, haz que dos
LLM etiqueten tus datos, entrena, evalúa, exporta a ONNX. Esta mañana ejecuté todos los pasos
salvo el etiquetado en un portátil Apple M4 para comprobar que funciona tal como
está escrito. El entrenamiento tardó 34 segundos y la exportación 24.
Esta es la tesis. Si en cada petición le mandas a un modelo frontier la misma pregunta con un conjunto fijo de respuestas, esa pregunta tiene que ir a un clasificador pequeño que sea tuyo. Usa el modelo grande una vez, como profesor, y deja de pagarle por cada decisión.
Le estás pagando a un LLM por responder la misma pregunta un millón de veces.
El README llama al resultado un System-1 model, y me quedo con el término. Un System-1 model responde una pregunta bien definida sobre una entrada, al instante, con probabilidades a las que puedes ponerles un umbral. ¿Qué modelo debe responder este prompt? ¿Este ticket necesita a una persona? ¿Qué equipo es dueño de esta petición? Es un encoder Laya con fine-tuning, de unos 300 millones de parámetros, corre en decenas de milisegundos y no tiene tarifa por llamada.
Llamar a un modelo de chat para esto es contratar a un abogado para que te ordene el correo: una factura por sobre, una espera por cada uno y una copia de tu correo en el servidor de otro. Para una empresa europea esa última parte puede zanjar la conversación: construimos Raya porque el router que queríamos no tenía despliegue en la UE.
La espera es fácil de medir. Raya responde en 30 ms en el p50 en producción. Cuando medí Jev, el router alojado al que Raya sustituye, tardaba unos 350 ms por llamada: Raya es aproximadamente 11 veces más rápido. Corre en un servidor de Hetzner de 84 € al mes que ya estaba en nuestra factura, así que el hosting no nos costó nada nuevo.
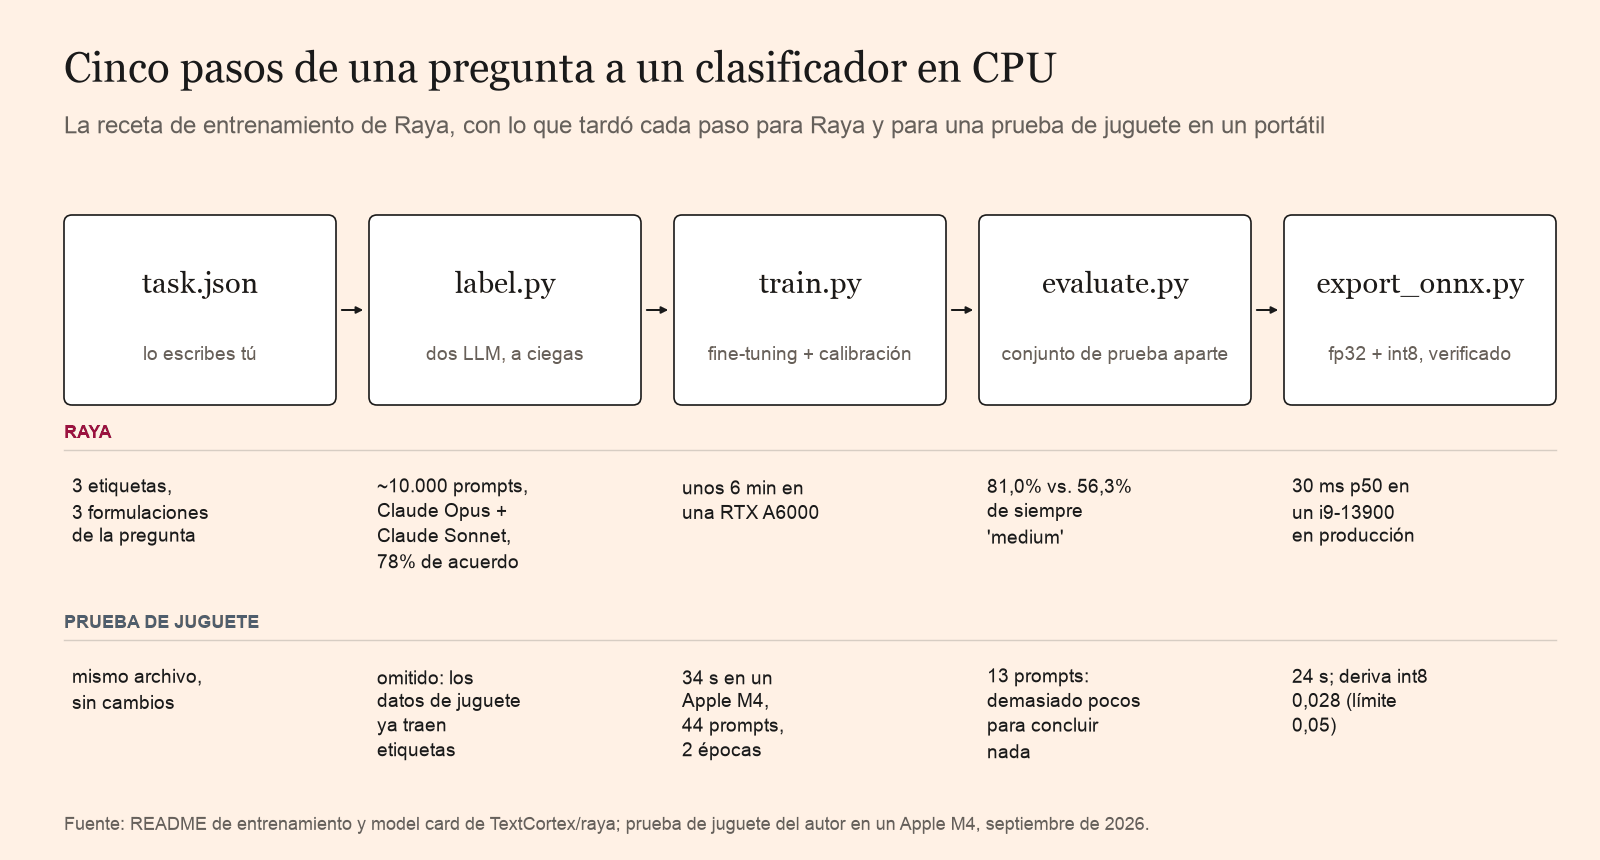
Toda la receta son cuatro scripts y un archivo JSON.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Antes de todo eso escribes task.json: las etiquetas y una o más
formulaciones de la pregunta. Raya tiene tres: “Route this prompt to a model”, una
versión más larga con una rúbrica por nivel y una puntuación de dificultad de 1 a 3. El
modelo se entrena con todas las formulaciones y con las opciones barajadas en cada época, así que
aprende la decisión en sí. El archivo también contiene la rúbrica que leen los
anotadores, y
la de Raya
viene incluida como plantilla.
Dos anotadores que discrepan valen más que uno que parece seguro.
Probablemente tienes entradas y ninguna etiqueta. label.py envía cada entrada a dos o
más LLM, por separado, con la misma rúbrica. Las unas 10.000 etiquetas de Raya salieron
de Claude Opus y Claude Sonnet, sin que ninguno viera las del otro. Sirve cualquier endpoint
compatible con OpenAI, incluidos el de Anthropic, OpenRouter, vLLM y Ollama.
Donde los anotadores coinciden obtienes una etiqueta limpia. Donde discrepan, la fila
conserva los dos votos y train.py aprende un objetivo 50/50. Esa es la respuesta
honesta para un prompt en el que dos modelos fuertes se dividen. Forzar ahí una etiqueta dura
le enseña al modelo un cara o cruz como si fuera un hecho.
El script también imprime con qué frecuencia coincidieron los anotadores. Apunta ese número. Es aproximadamente el techo de lo que tu modelo puede sacar frente a estas etiquetas. Para Raya fue un 78%. Si tus anotadores coinciden el 75% de las veces y tu modelo saca un 90%, ha aprendido las manías de uno de los anotadores, y la solución es una rúbrica más estricta.
En cuanto a volumen, el README habla de 1.000 a 5.000 entradas reales para un primer modelo, en
los idiomas que de verdad atiendes. Deja las clases desbalanceadas; train.py
pondera él mismo las etiquetas raras. Guarda un conjunto de prueba
con el que nada se entrene ni se valide nunca.
La GPU es la parte barata.
Raya se entrenó en unos seis minutos en una sola RTX A6000 de 48 GB. En mi M4 hizo dos épocas sobre las 40 filas de entrenamiento de juguete en 22 segundos, 34 contando la carga del modelo.
Congela la tabla de embeddings de tokens para ahorrar memoria, elige la mejor época según la validación y luego ajusta una temperatura por pregunta para que una probabilidad de 0,9 acierte más o menos nueve veces de cada diez. Esa calibración es lo que te permite actuar sobre un umbral más adelante, por ejemplo enviar un prompt al nivel frontier solo por encima de 0,6.
El punto de partida por defecto es mmBERT-base, el encoder multilingüe de Laya. Pasa
--base TextCortex/raya para adaptar Raya a tu propio tráfico de enrutado.
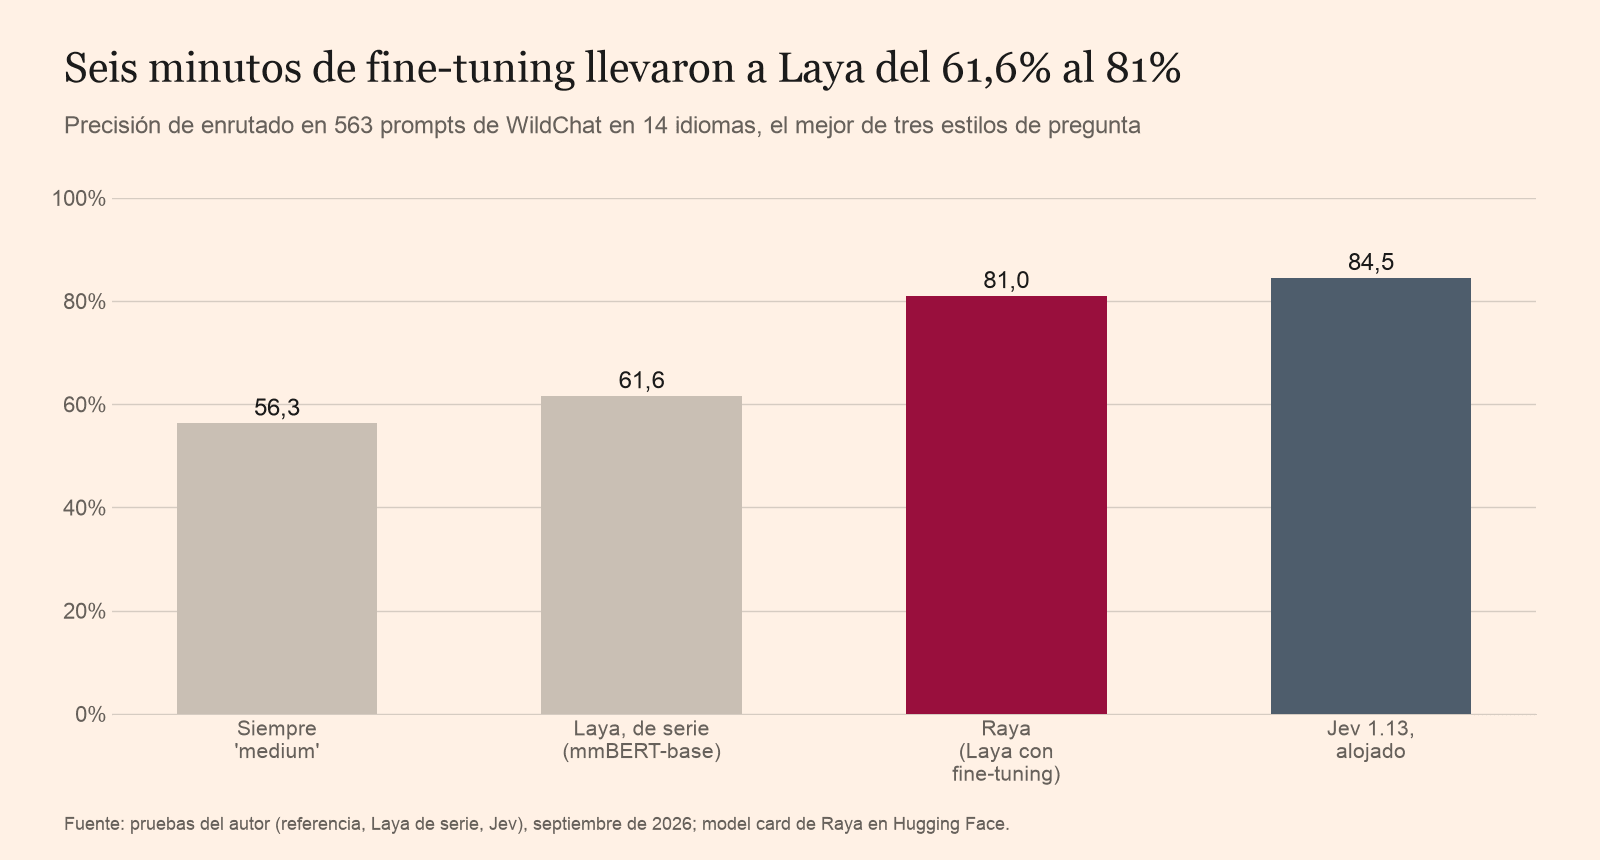
Seis minutos de GPU llevaron a Laya del 61,6% al 81%, a tres puntos y medio de Jev. Las etiquetas son donde se te va la tarde.
Los datos de juguete demuestran que la fontanería funciona y nada más.
La carpeta incluye 44 prompts de enrutado escritos a mano para entrenar y 13 para
probar. El README promete cinco minutos. El entrenamiento y la exportación tardaron menos de
un minuto, sin contar la instalación, con las versiones fijadas. La llamada de ejemplo del README enrutó “Prove that √2 is irrational.”
a frontier_model con 0,52.
Después, evaluate.py le dio al modelo de juguete un 46,2% en la formulación corta, un 84,6%
en la formulación con rúbrica y un 69,2% en la puntuación de dificultad. La formulación corta
mandó 12 de los 13 prompts a medium. Trece prompts no bastan para distinguir esas
cifras del ruido, y 44 filas de entrenamiento son, en palabras del README, “demasiado
pocas para entrenar un modelo útil”.
Lo útil que hizo evaluate.py fue imprimir primero esta línea:
13 rows with a gold label; always answering 'small_model' scores 38.5%Esa es la línea base constante. En el
primer benchmark,
Laya de serie perdió contra return "medium" en dos de sus tres estilos de pregunta.
Toda evaluación debería empezar con la puntuación del modelo que no hace nada.
Exporta una vez y luego mide en la CPU que de verdad vas a alquilar.
export_onnx.py escribe un archivo fp32 y un archivo int8 por bloques, y luego compara
ambos con PyTorch en tus datos de prueba. La exportación falla si cambia alguna elección
o si las probabilidades se desvían más de 0,001 en fp32 o 0,05 en int8. Mi modelo de juguete
salió con 0,00000 y 0,02790.
Qué archivo desplegar depende del silicio. Como midió el artículo anterior, el int8 por bloques conservó la precisión de Raya y fue el más rápido en un i9-13900 con instrucciones VNNI, pero tardó más del doble que fp32 en un EPYC 7502P sin ellas. Mide en tu propio hardware antes de elegir.
Alquila el modelo grande una vez y luego deja de pagarle por cada decisión.
La industria de los modelos frontier cobra cada llamada, así que cada llamada parece un trabajo para un modelo frontier. Cualquier llamada que elige de una lista fija de respuestas es una clasificación facturada como razonamiento. Una vez escritas las etiquetas, el LLM es una forma cara de llegar a un veredicto al que un encoder de 300M llega en 30 ms en un hardware que ya pagas.
Hay un límite que te debo. Los datos de entrenamiento de Raya no son públicos, así que puedes construir tu propio Raya con esta carpeta, pero no puedes reproducir el nuestro. Y Raya aprendió de los mismos dos anotadores que escribieron las etiquetas del benchmark, lo que infla su 81%.
Así que mídelo con tu propio tráfico. Ejecuta evaluate.py sobre un conjunto de prueba que tu modelo
nunca haya visto. Si no supera la línea base constante por un margen amplio,
ajusta la rúbrica antes de tocar nada más. Si la receta falla en tu
decisión, mándame las cifras y las publicaré.