Tłumaczenie maszynowe. Przeczytaj angielski oryginał: Your performance review is a memory test →
Zapytaj dowolnego kierownika inżynierii, kto jest jego najlepszym inżynierem. Odpowiedź pada zanim skończysz zadawać pytanie — bez wahania i bez „daj mi chwilę, sprawdzę“. Wie. Zawsze wiedział.
Teraz poproś, żeby pokazał tę pracę.
Dostaniesz historię. Zwykle dobrą historię o incydencie obsłużonym o drugiej w nocy albo refaktorze, który odblokował kwartał. Czego nie dostaniesz, to liczby, porównania albo jakiegokolwiek opisu pracy czworga inżynierów, przy których kierownik nie siedział w pokoju. Ta pewność buduje się z pamięci, a pamięć jest funkcją bliskości.
Oto teza. Wydajność inżynierską ocenia się z pamięci, pamięć nagradza widoczność, a nie wartość, a praca, którą faktycznie chcesz, żeby ludzie wykonywali, jest zapisana w roadmapie, która nigdy nie jest połączona z tym, według czego ich oceniasz. Te dwa dokumenty nie mają ze sobą nic wspólnego w prawie każdej firmie, jaką widziałem — łącznie z moją.
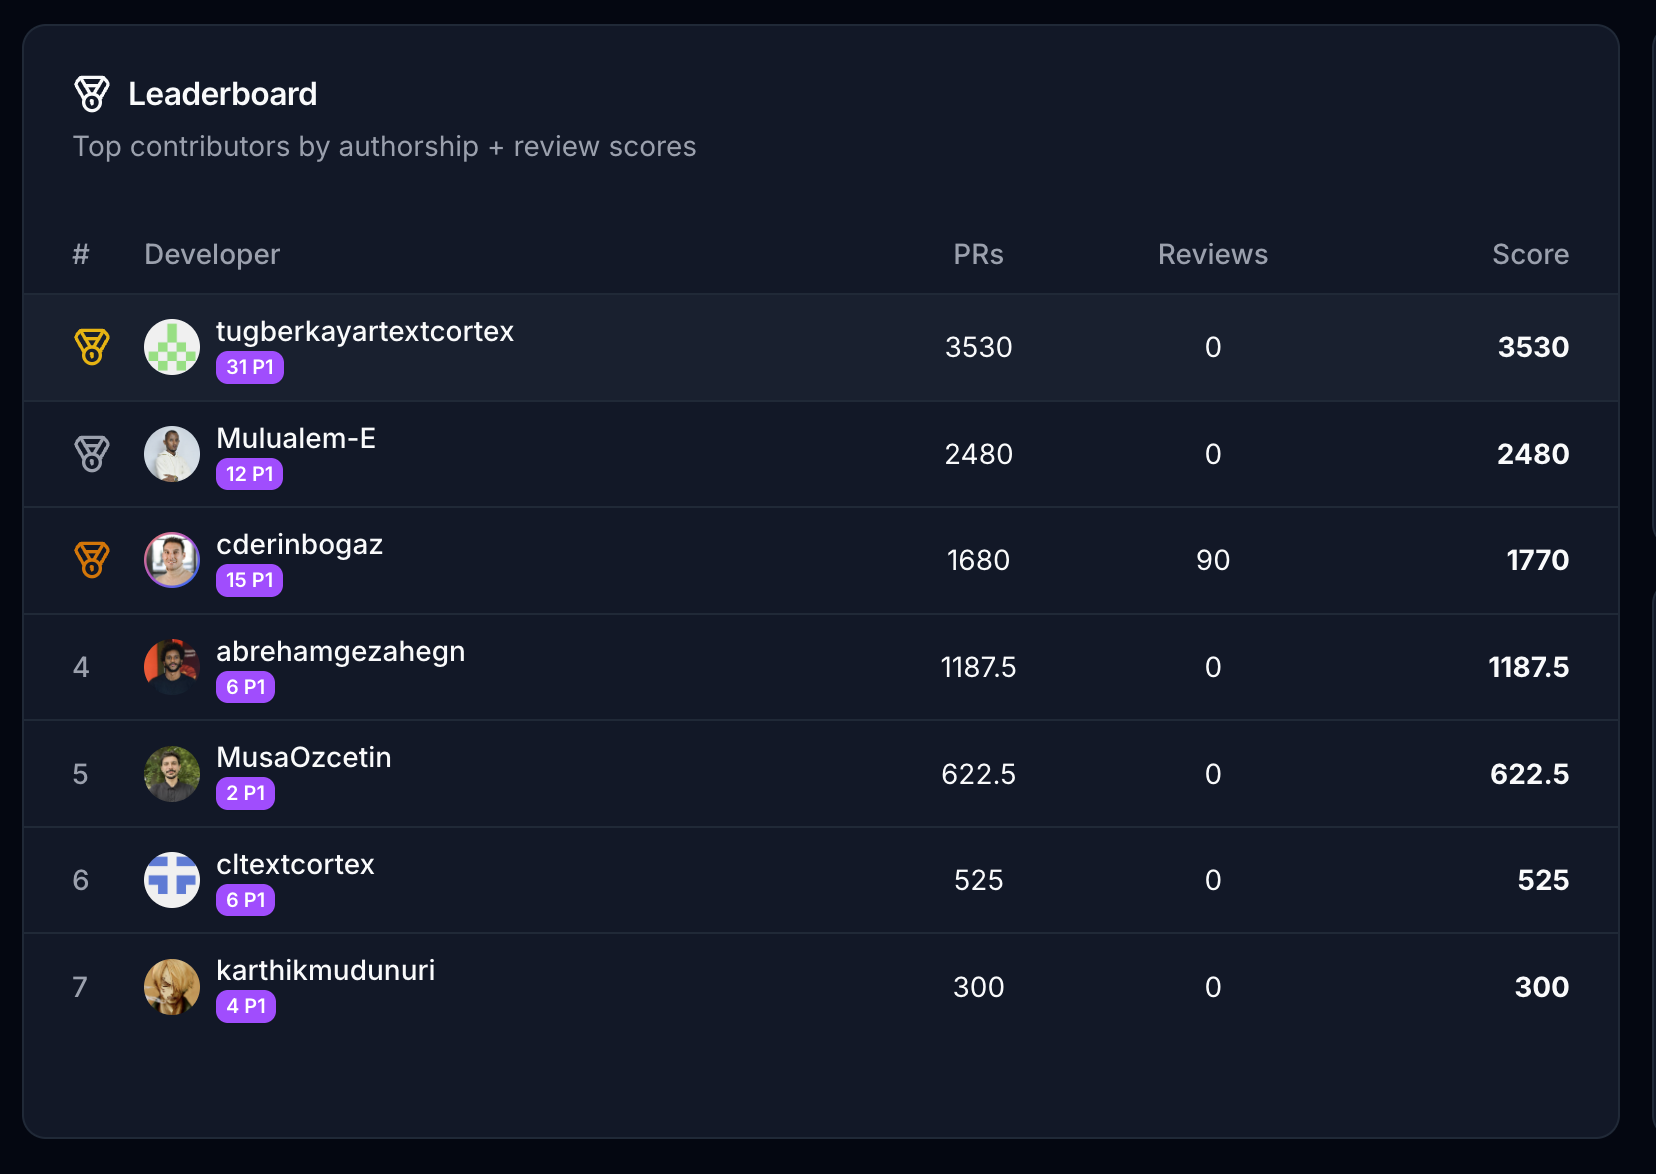
Więc je połączyliśmy. Każdy scalony pull request jest czytany przez model, dostaje przypisaną severity i jest mnożony przez to, jak bardzo nasza roadmapa zależy od komponentu, którego dotyczy. Wynik to comiesięczna tablica wyników, która zasila decyzje o premiach. Oto nasza.
Powszechna mądrość mówi, że tego nie da się zmierzyć, a powszechna mądrość to wzruszenie ramion
Standardowe stanowisko w sprawie mierzenia indywidualnych wyników jest takie, że nie wolno, bo każdy proxy to pułapka. Liczba linii kodu nagradza rozdęcie. Liczba commitów nagradza dzielenie. Zamknięte tickety nagradzają tego, kto pierwszy zgarnie małe. Story points to negocjacje prowadzone przed rozpoczęciem pracy. Nawet dobre frameworki są celowo na poziomie zespołu: DORA mierzy cztery rzeczy w pipeline dostarczania i nie mówi nic o ludziach, co jej autorzy wprost przyznają.
Wszystko to jest prawdą i żadne z tego nie jest odpowiedzią. Ranking i tak powstaje — co roku, przy okazji wynagrodzeń, w pokoju, z pamięci, ważony tym, obok kogo siedziała osoba w tym pokoju. Odmowa mierzenia kupuje ci ranking bez śladu audytowego i bez odwołania.
Nazwijmy to premią głośnego inżyniera: różnicą między tym, jak dobrze jesteś oceniany, a tym, jak dobrze pracowałeś, w całości wyjaśnianą odległością od osoby piszącej twoją ocenę. Poproś dowolnego człowieka o porównanie wkładu technicznego piętnastu osób w ciągu roku, używając wyłącznie tego, co akurat zauważył — i to jest wynik. Każdy z nas by go wyprodukował.
Ta premia była nieunikniona do mniej więcej dwóch lat temu, bo surowiec na lepszą odpowiedź to była sterta diffów, których nikt nie miał czasu czytać. To ograniczenie zniknęło. Model może przeczytać każdy diff w twoim repozytorium co miesiąc za mniej niż koszt spotkania, na którym obecnie zgadujesz. Czytanie to łatwa część. Decydowanie, ile to czytanie jest warte, to cały problem — i to nie jest pytanie techniczne.
Cały wzór mieści się w jednej linii
Oto on, w całości, ze ścieżki punktowania w GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0Nie uprościłem tego na potrzeby bloga. To jest ta linia, jak działa, bez ukrytej regresji, bez wyuczonych wag, bez członu reputacji i bez korekty o staż. Severity razy ważność — albo zero.
Severity to stała drabinka, ustawiona raz i widoczna dla wszystkich ocenianych.
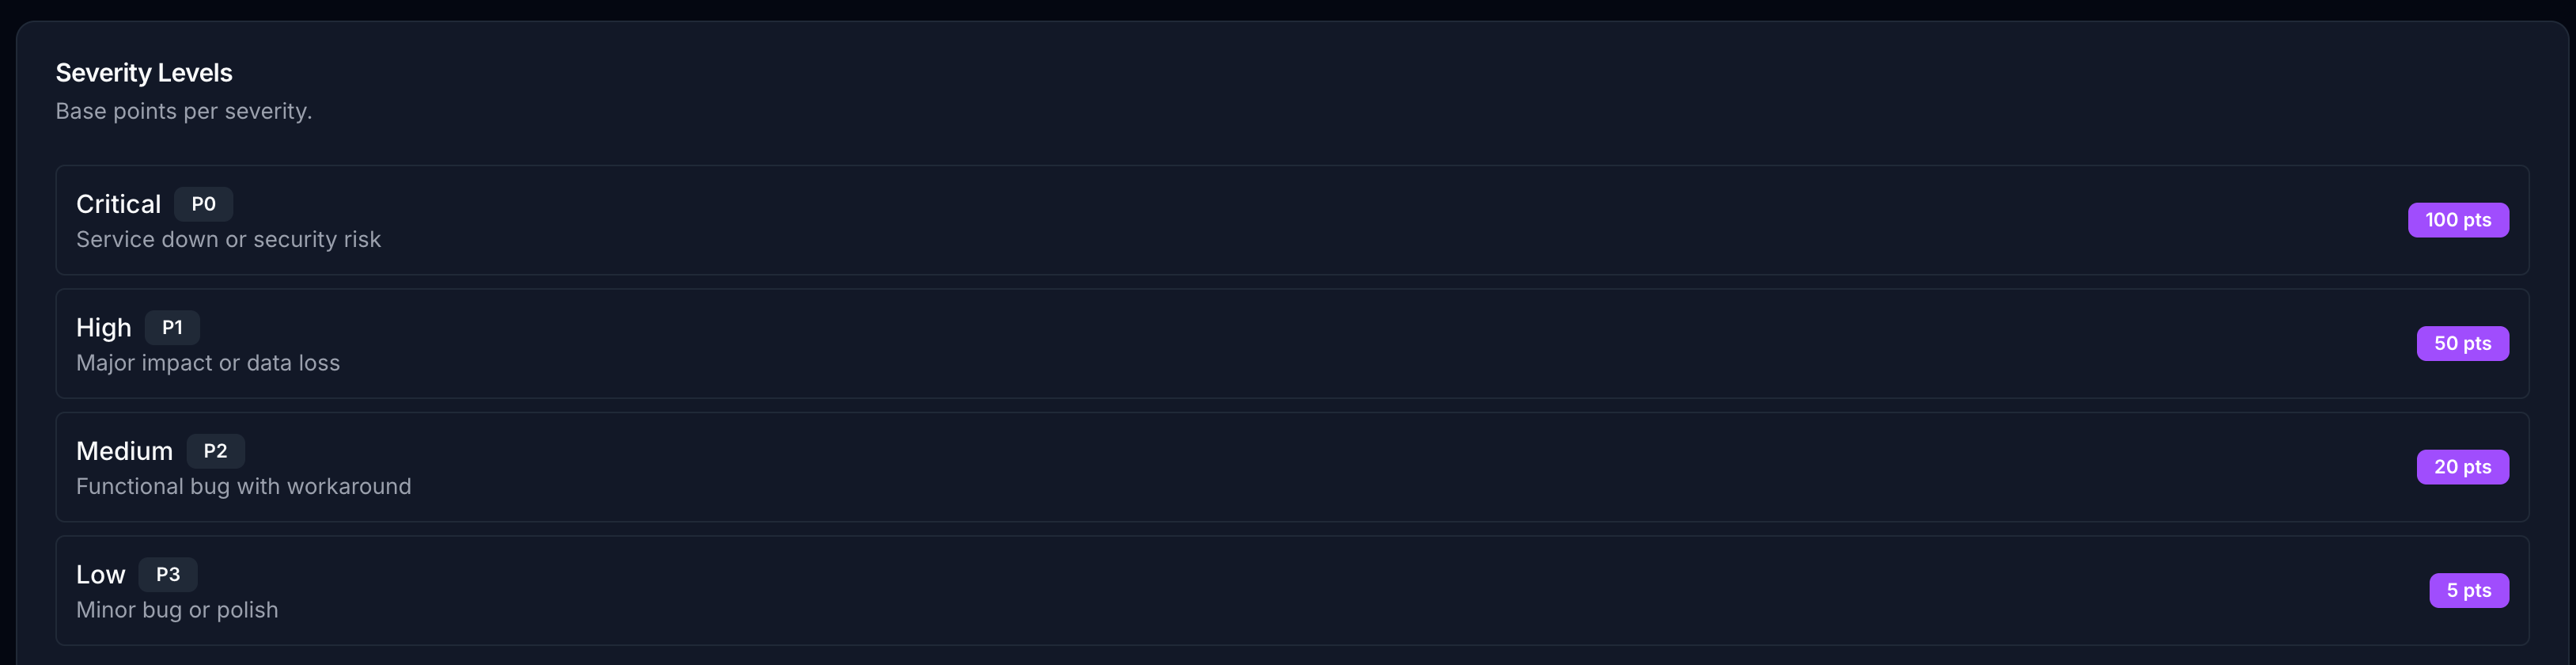
Krytyczna poprawka jest warta dwadzieścia tych o niskim priorytecie. Ten stosunek to deklaracja polityki, a my zapisaliśmy ją zamiast zostawiać w czyjejś głowie.
Ważność to ta połowa, która się liczy. Każdy komponent ma mnożnik, a mnożnik jest tym, czego produkt potrzebuje w tym kwartale.
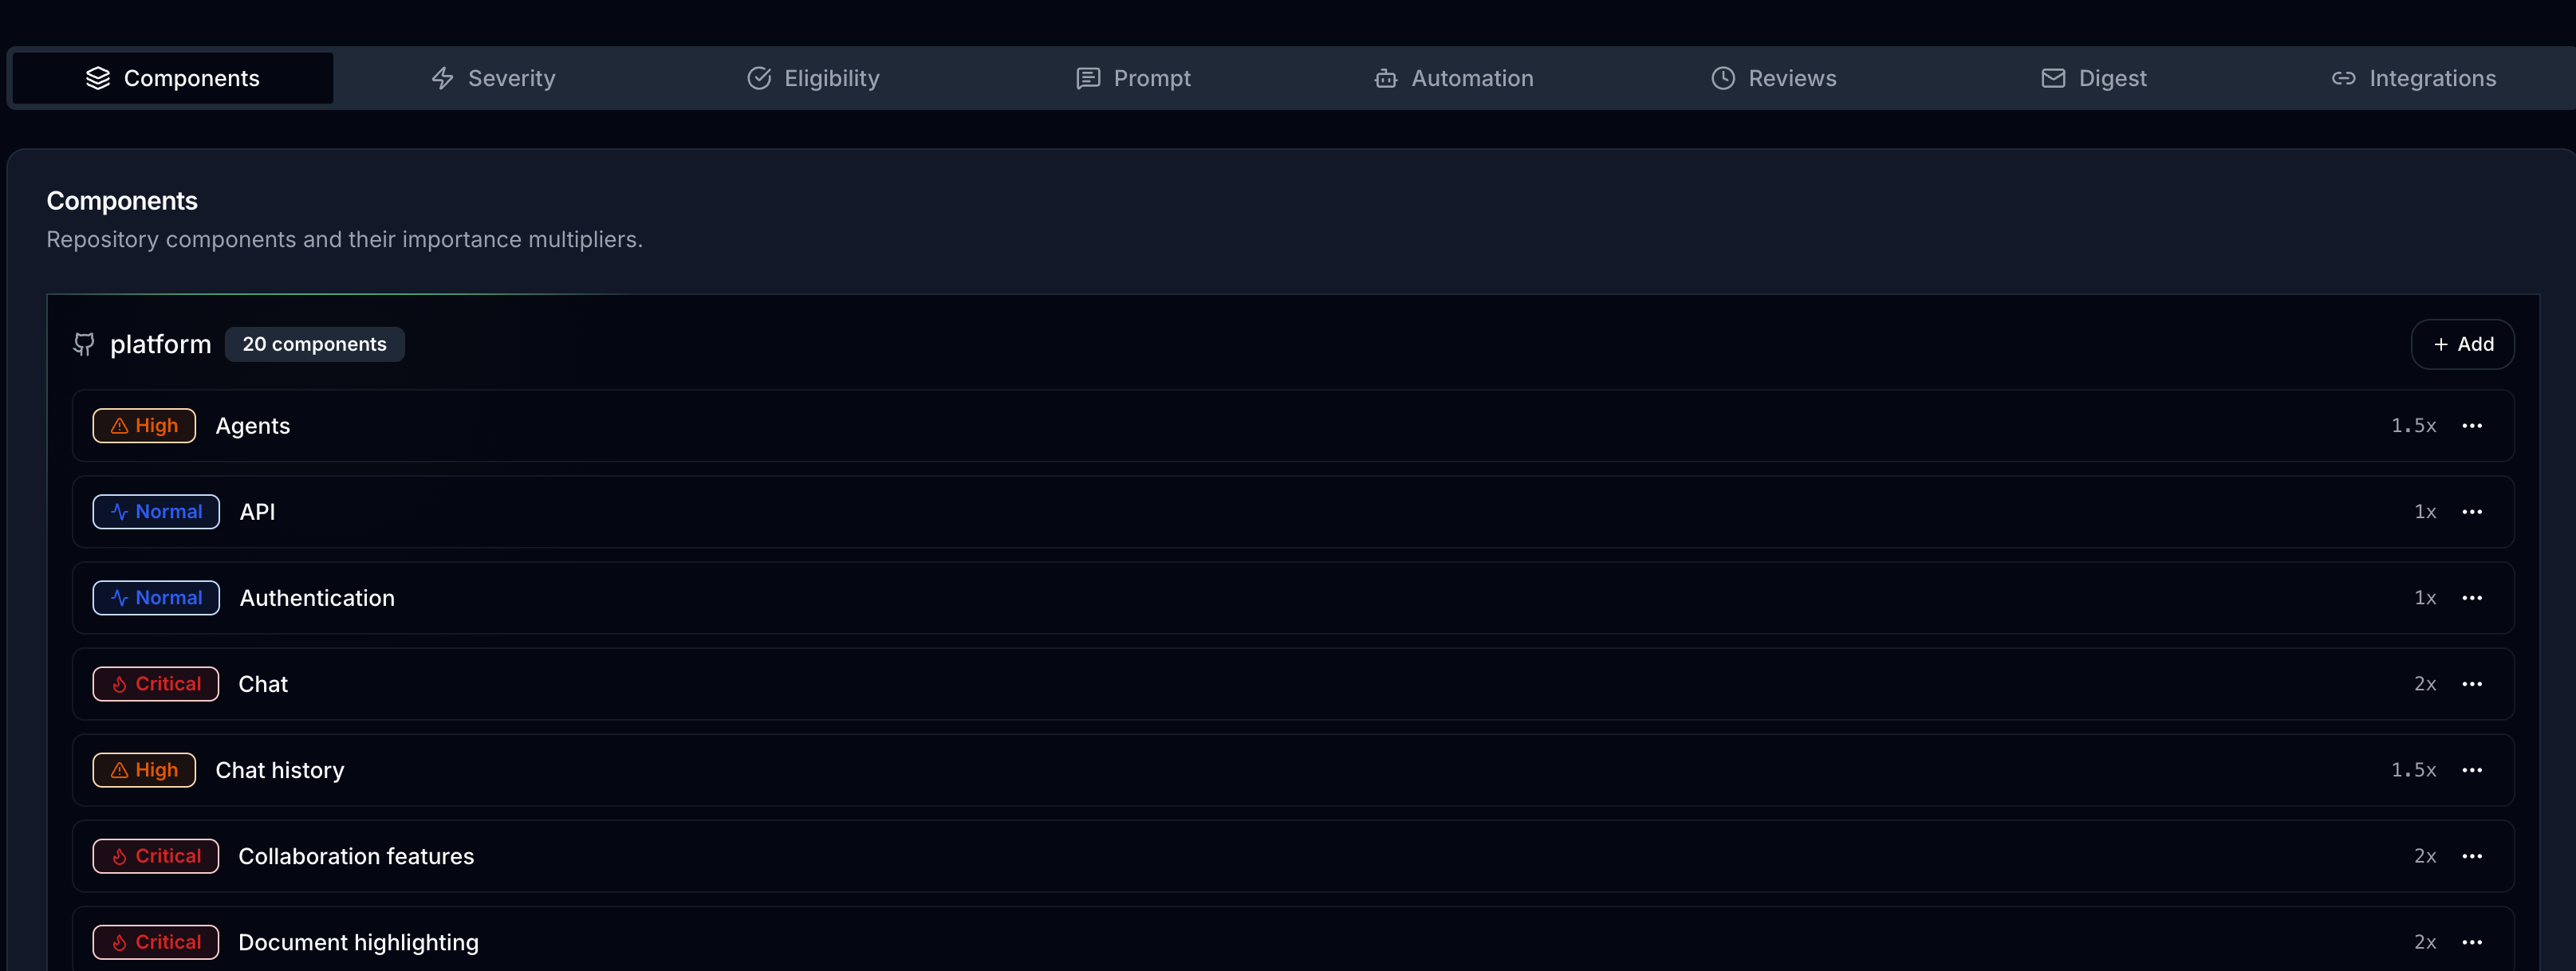
Chat ma 2.0x, bo chat to zakład, na który stawiamy produkt. Authentication ma 1.0x, bo działa i chcielibyśmy, żeby dalej działał po cichu. To decyzje produktowe, a tabela mnożników to miejsce, gdzie są przepisywane na pole, które płaci.
Dokument strategii i wkład do wynagrodzeń stały się jednym dokumentem. To jest ten ruch. Model to hydraulika, a tablica wyników to jej renderowanie — a jeśli roadmapa zmieni się w październiku, to motywacja zmienia się w październiku, a nie w cyklu ocen czternaście miesięcy później.
Rozpiszę to, bo to część, którą ludzie pomijają. Czterdzieści mądrych osób, każda optymalizująca lokalnie i uczciwie, wyprodukuje kwartał pracy, który nie składa się na to, czego firma powiedziała, że chce. Nikt na tym obrazku nie jest leniwy — i właśnie to czyni to trudnym. Middle management istnieje w dużej mierze po to, żeby to naprawiać, przenosząc strategię w rozmowach od biurka do biurka, tracąc wierność na każdym przeskoku. Tabela mnożników robi to samo trasowanie w jednym skoku, a w październiku wciąż mówi dokładnie to, co wpisałeś w styczniu.
Joi Ito już nazwał tę różnicę. Jedna z dziewięciu zasad w Whiplash, napisanej z Jeffem Howe w 2016 roku, to pull over push: wyciągasz z sieci to, czego potrzebujesz, zamiast trzymać wszystko na zapasie. Ito opisywał zasoby. Kierunek zachowuje się tak samo. Organizacja typu push gromadzi strategię w warstwie zarządczej i rozdaje ją w rozmowach, dlatego dociera ona na skraj firmy późno i z ubytkami. Organizacja typu pull publikuje strategię jako cennik i pozwala ludziom brać z niego to, czego potrzebują. Tabela mnożników jest tym cennikiem.
Krytyczna poprawka w czacie jest warta czterdzieści poprawek kosmetycznych w API
Połącz obie połówki, a rozpiętość jest ogromna. P0 w czacie dostaje 100 punktów bazowych razy 2,0, czyli 200 punktów. P3 w API dostaje 5. Czterdzieści do jednego — tyle wynosi różnica między najbardziej wartościowym pull requestem, jaki można tu scalić, a najmniej wartościowym.
Ten stosunek jest celowo brutalny i robi to, czego łagodne zachęty nigdy nie osiągają. Nikt nie reorganizuje swojego tygodnia wokół 15% różnicy. Ludzie absolutnie reorganizują swój tydzień wokół 40-krotnej.
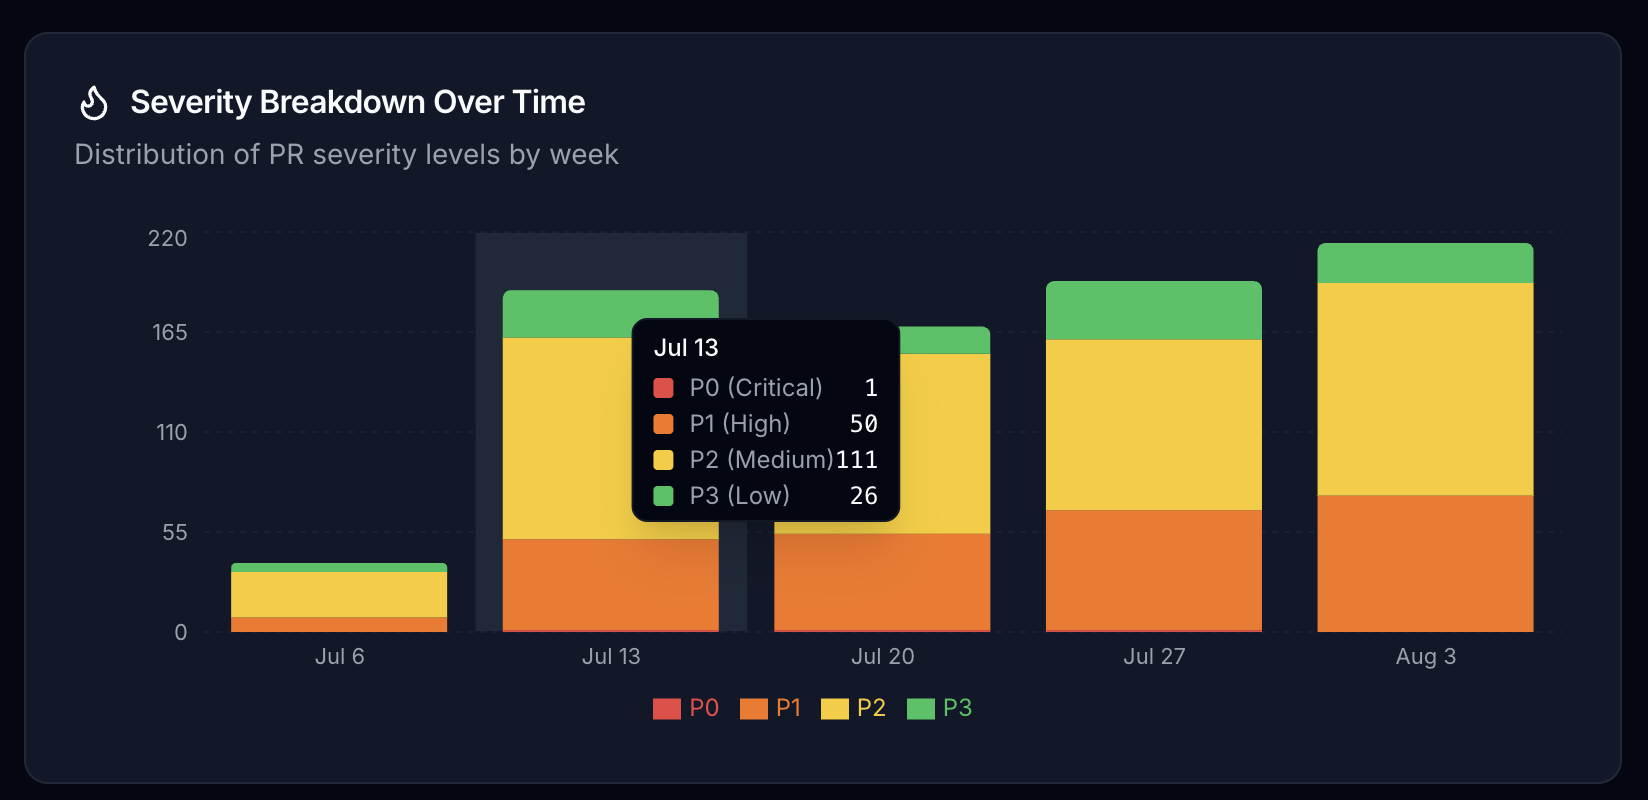
188 pull requestów w jednym tygodniu. P2 to 59% z nich, czyli to, jak wygląda normalny tydzień pracy inżyniera wszędzie. Teraz to zważ. Te 111 P2 jest warte 2 220 punktów. Te 50 P1 jest warte 2 500. Mniej niż połowa pull requestów niesie więcej niż połowę wartości tygodnia. Policz pull requesty, a dojdziesz do wniosku, że tydzień dotyczył P2. Zważ je, a tydzień dotyczył pięćdziesięciu konkretnych prac i możesz wskazać, kto je wykonał.
Dwie osoby odpowiadały za 58% wyników, a ja miałem złą kolejność
Siedmiu programistów, 10 415 punktów. Najlepszy programista ma 3 530 z nich, czyli 33,9% wszystkiego, co zespół wyprodukował pod względem wartości. Najlepsi dwaj mają między sobą 57,7%.
Taka koncentracja zwykle oznacza, że najlepsi dwaj pracują nad komponentami o najwyższym mnożniku, czyli dokładnie tym, o co ich prosiliśmy. Liczba opisuje, gdzie ląduje wartość, i nie wyciągałbym z niej żadnych wniosków o pozostałej piątce.
To kolejność zbiła moją prognozę.
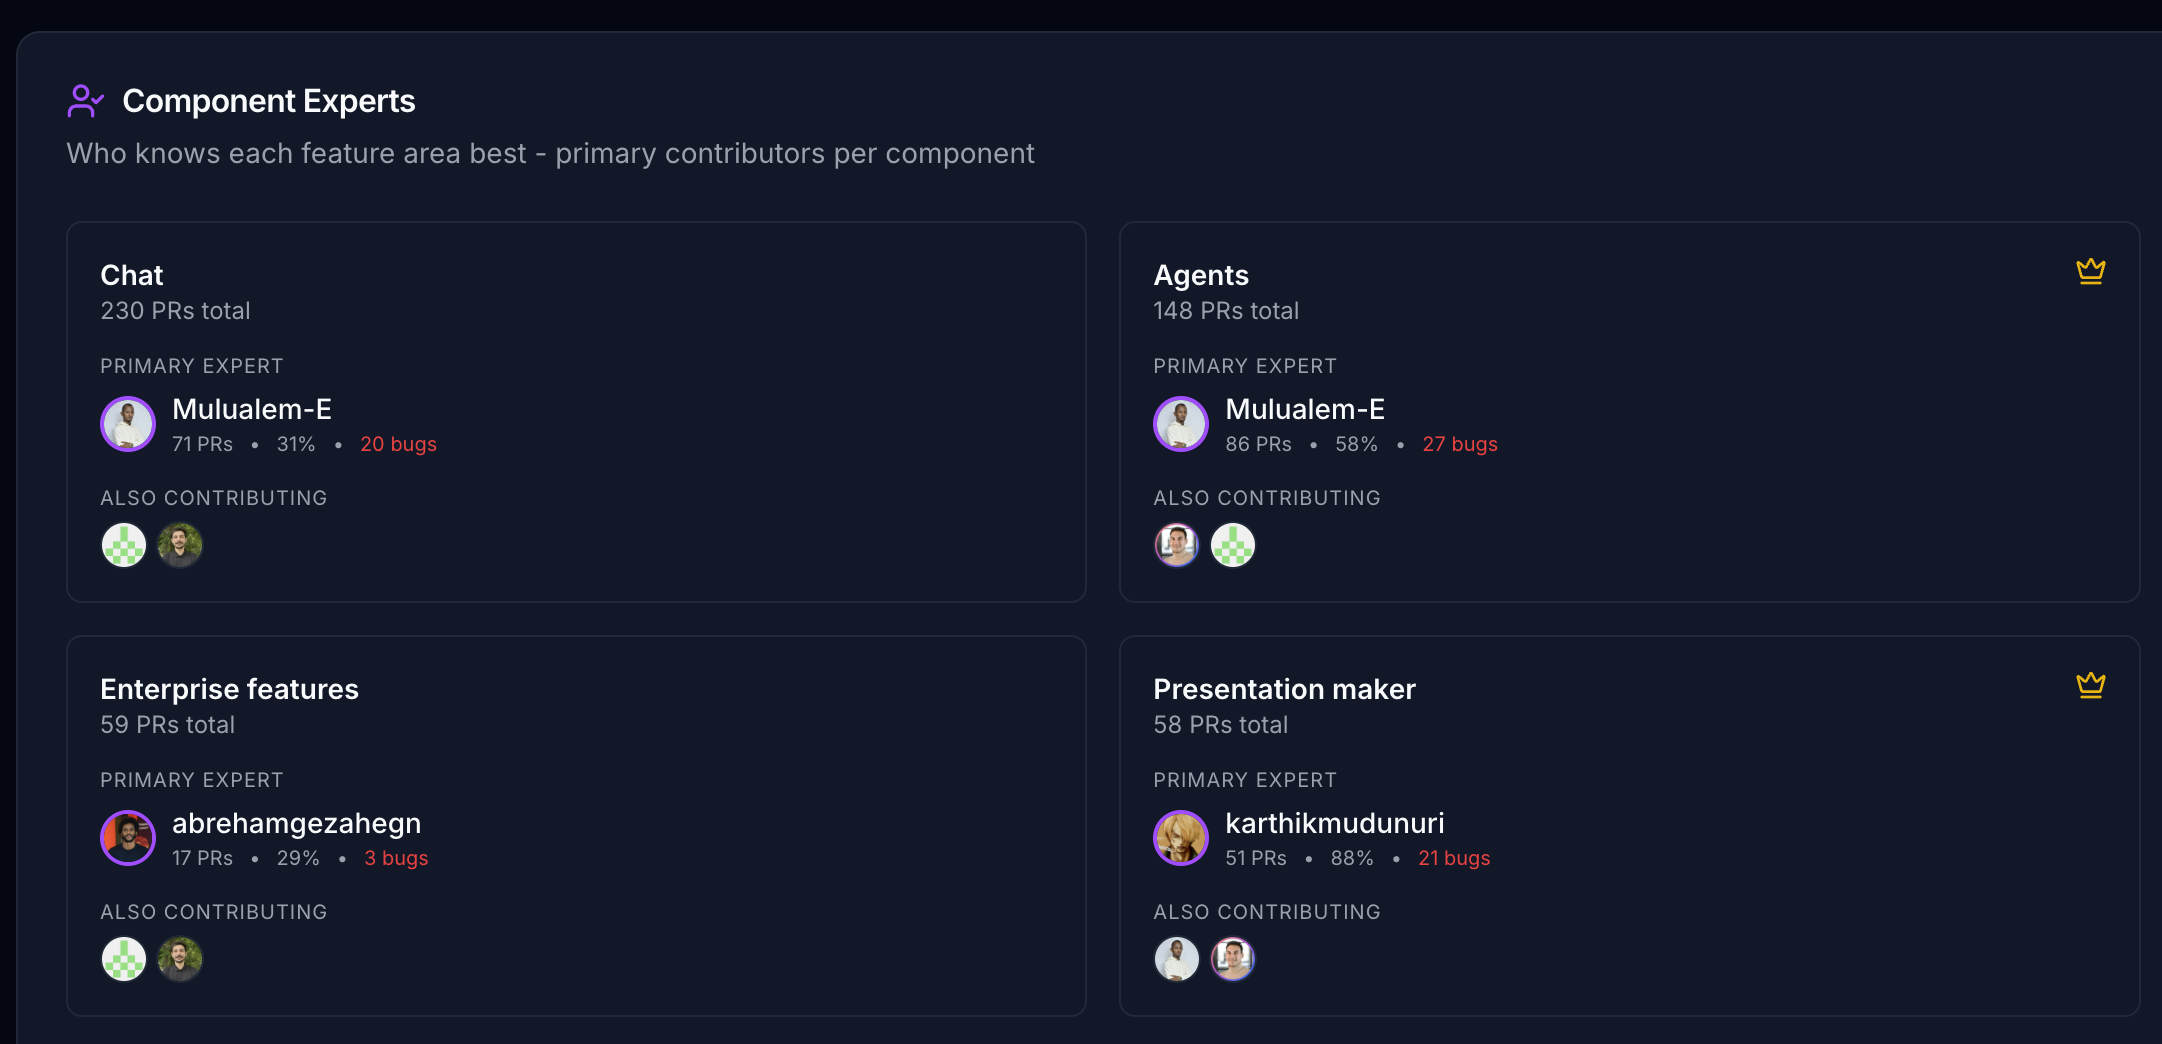
Mulualem-E jest głównym ekspertem od czatu, naszego komponentu 2.0x, z 71 spośród 230 pull requestów, oraz od agentów, naszego komponentu 1.5x, z 86 spośród 148. Gdybyś mi to opisał i zapytał, kto prowadzi w rankingu, powiedziałbym bez wahania, że on. Jest drugi. Pierwsze miejsce należy do tugberkayartextcortex, z 31 pull requestami P1 wobec 12 Mulualem-E.
Rozkład ważności pokonał posiadanie komponentu. Posiadanie najważniejszego obszaru produktu okazuje się nie być tym samym, co wielokrotne dostarczanie pracy o dużym wpływie w jego obrębie, i dopóki tego nie opublikowaliśmy, nie mogłem ci powiedzieć, które z tych dwóch nasze wynagrodzenie nagradzało. Nagradzało to, które akurat zauważyłem. To premia dla głośnego inżyniera, przyłapana we własnej firmie. Moja intuicja wskazała właściwe dwie osoby, ale w złej kolejności, a to właśnie kolejność decyduje o premii.
Payments to 45% poprawek błędów i nikt nie musiał się o to kłócić
Punktowanie każdego pull requesta kończy też nawyk kłótni o jakość na podstawie anegdot.
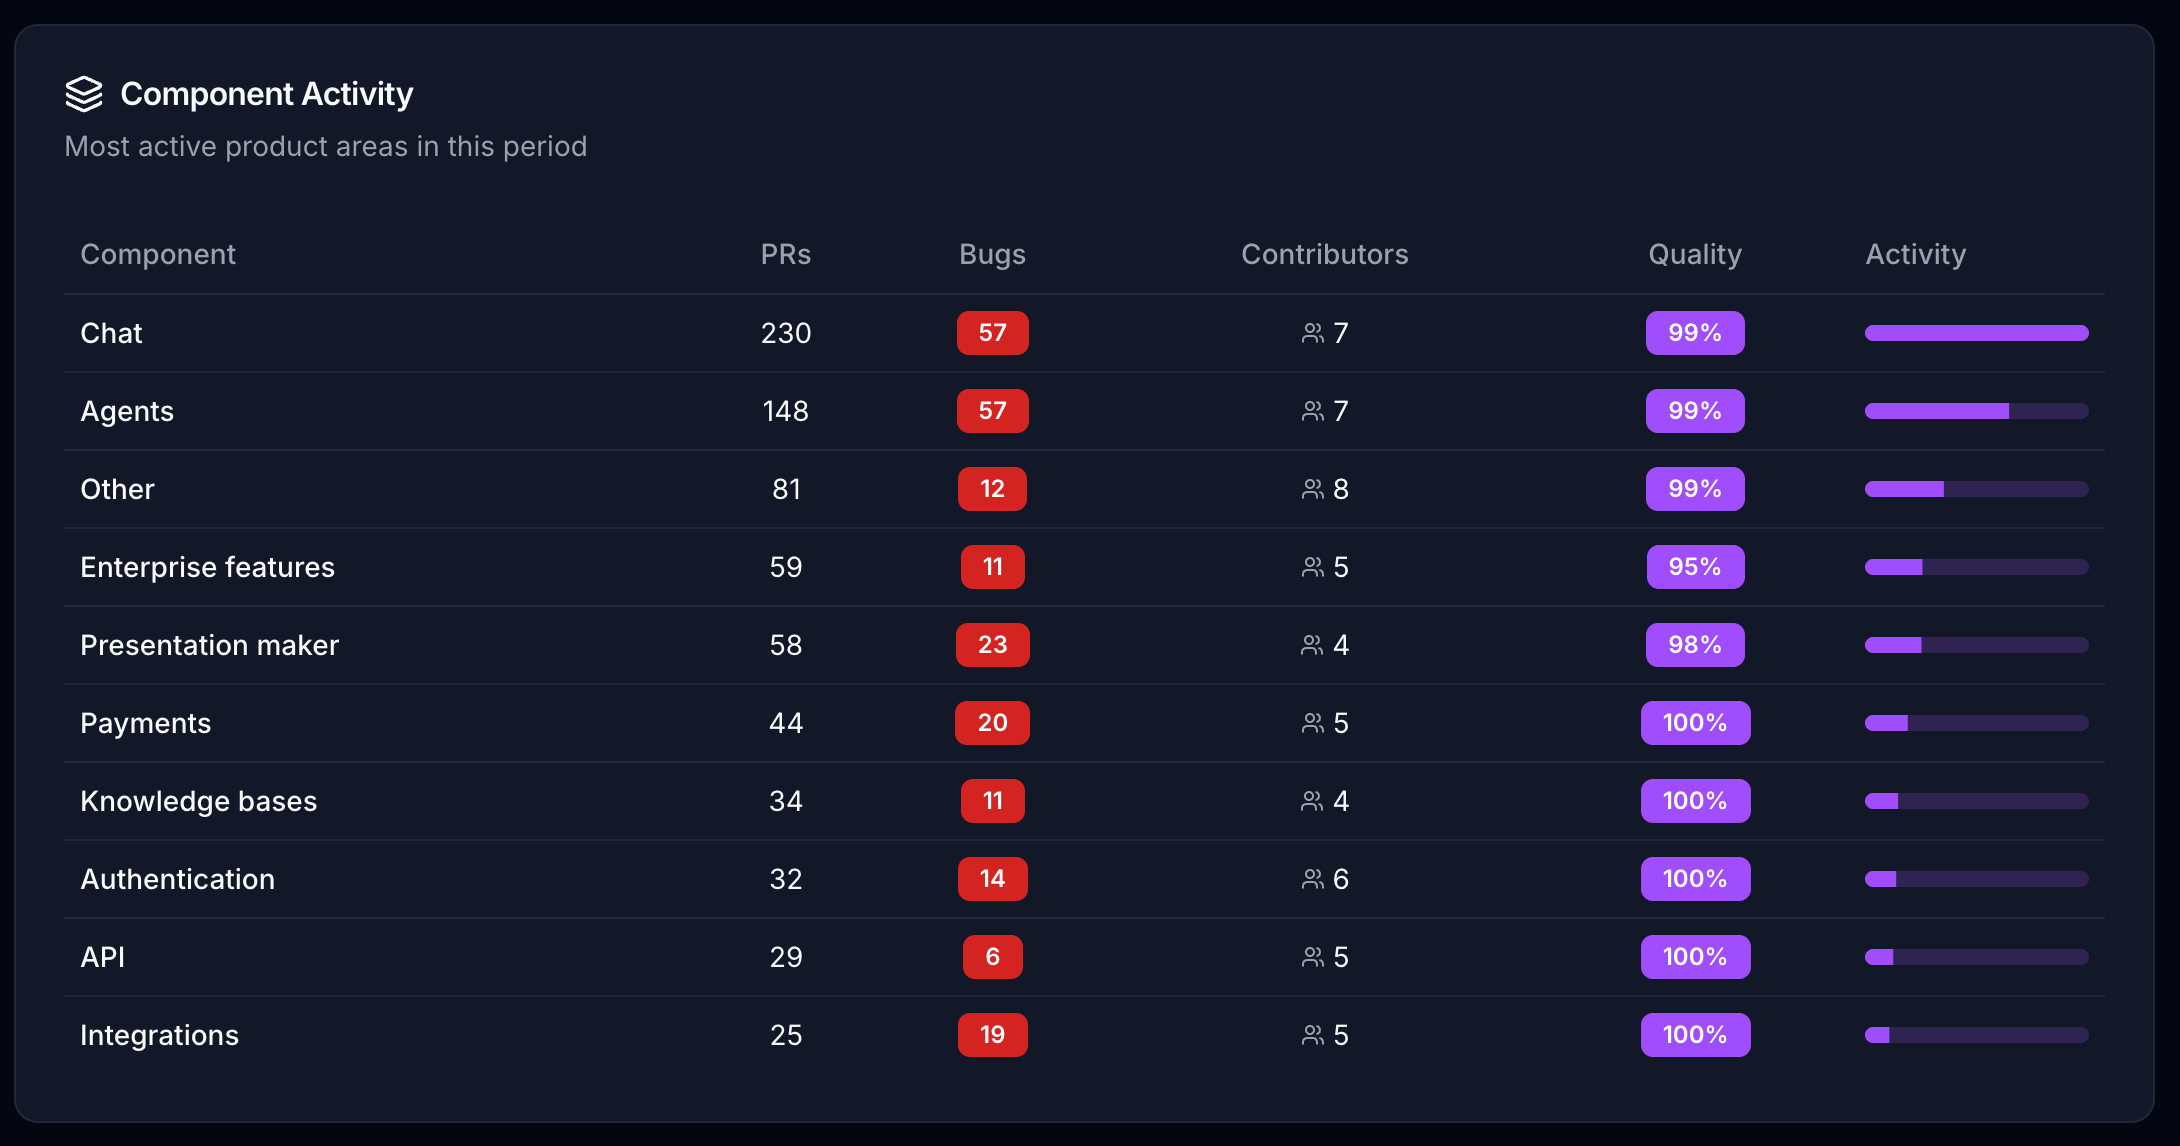
740 pull requestów w dziesięciu najbardziej obciążonych komponentach, z czego 230 to poprawki błędów, a nie nowa praca. Sam czat to 230 pull requestów, czyli to, jak wygląda mnożnik 2.0x, gdy działa. Potem payments: 44 pull requesty, 20 błędów, 45% wskaźnik błędów w komponencie, który dotyka pieniędzy.
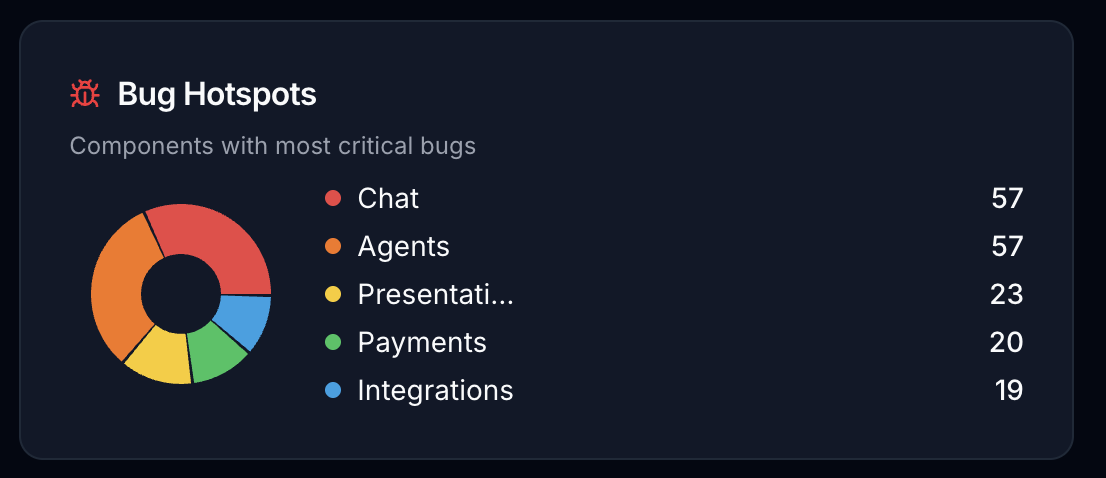
Chat i agenci mają po 57 błędów, ale czat wyprodukował je w 230 pull requestach, a agenci w 148. Ta sama liczba błędów, 55% więcej pracy za jednym z nich. To sygnał o agentach, którego żadna retrospektywa nie miała szansy wydobyć, bo nikt nie scalił wystarczająco dużo jednych i drugich, żeby to zauważyć.
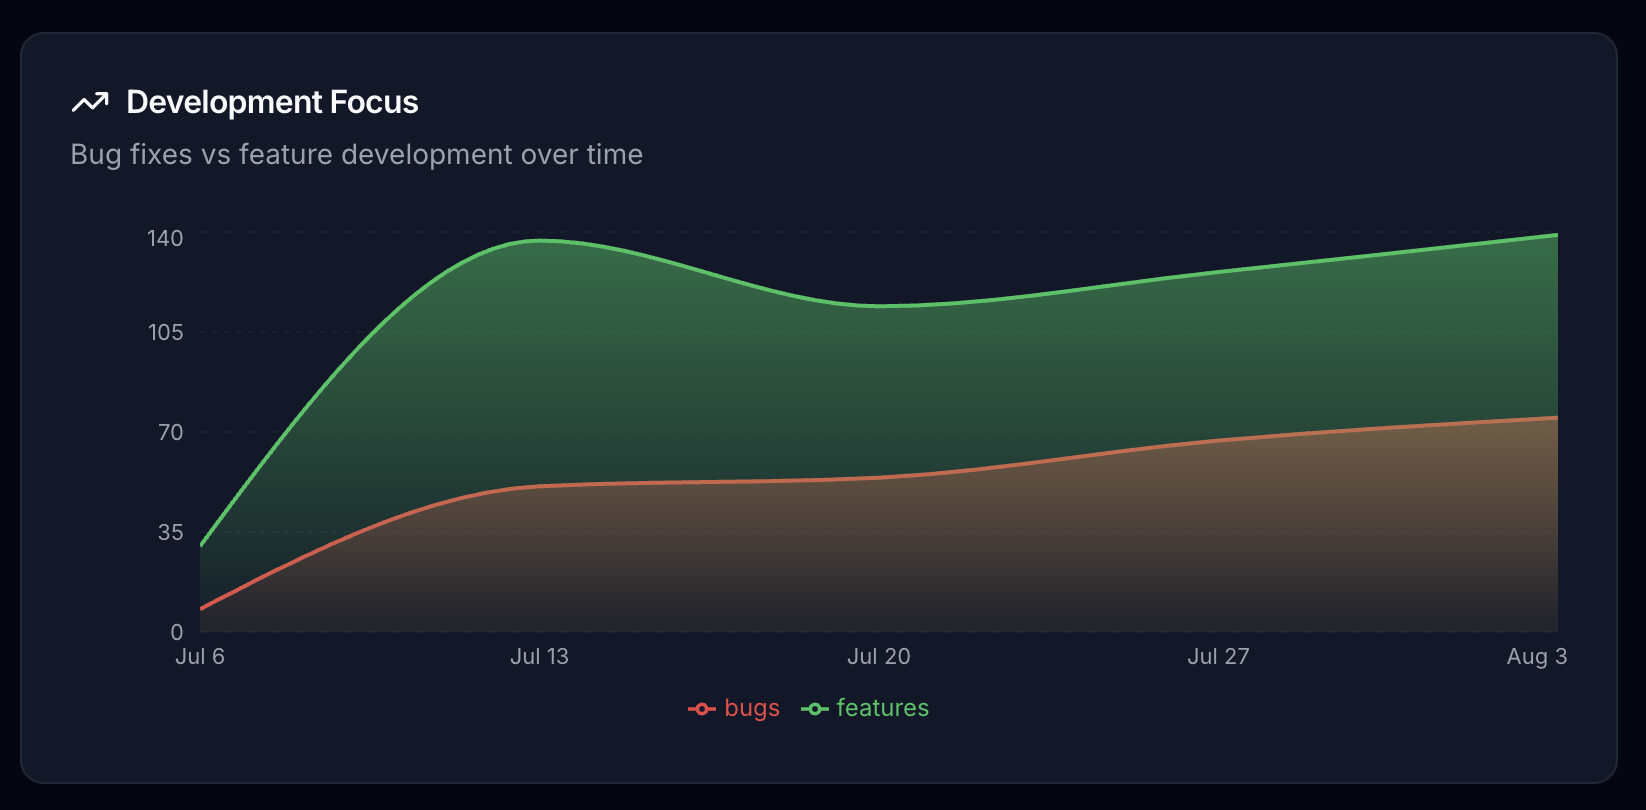
Błędy i funkcje rosną razem, zamiast jedno kosztem drugiego. Pięć tygodni to zdecydowanie za mało, by odróżnić to od szumu, jaki wywołałoby wylądowanie jednego dużego projektu, więc traktuj ten wykres jako opis okresu i nic więcej.
Nie mam liczby wzrostu i nie powinieneś ufać nikomu, kto ją ma
Oto teza, którą chcę postawić. Odkąd zaczęliśmy publikować to co miesiąc, praca przesunęła się w stronę komponentów, które oznaczyliśmy jako ważne, bo inżynierowie chcą wyniku.
Nie podaję procentu. Włączyliśmy to w trakcie działania. Nie było linii bazowej ani repozytorium kontrolnego i nigdy z góry nie ustaliliśmy, co miałoby znaczyć „przesunięcie“. Mnożniki zmieniały się w tym okresie. Podobnie liczba osób w zespole. Każda liczba, którą bym opublikował, byłaby wybrana po obejrzeniu danych, co czyni ją ozdobnikiem.
Zmienił się argument. Ludzie przestali pytać, czy ich praca jest doceniana, a zaczęli pytać, dlaczego komponent ma ocenę 1.0x. To lepsza walka do prowadzenia i jedyna rzecz, za którą zapłaciłbym osobno.
Nasze własne narzędzie też nie jest czyste, a najostrzejsza krawędź jest taka: pull request z wynikiem zero nie mówi ci, które kryterium kwalifikacyjne go zamknęło. Zabraknie linku do issue albo testów i wynik jest zero niezależnie od wagi, a osoba, która ma najwięcej do zakwestionowania, dostaje najmniej argumentów. Naprawiamy to przed wszystkim innym na liście.
Skieruj to na roadmapę, a potem daj ludziom miarkę
Zdejmij autorytet ze schematu organizacyjnego, a to, co zostanie pod spodem, to tabela routingu. Przenosi „co jest ważne w tym kwartale“ na zewnątrz od ludzi, którzy to zdecydowali, i „kto co zrobił“ z powrotem do środka, i robi to powoli i z zniekształceniami na każdym przeskoku. Wszystko, czego nie lubisz w korporacyjnej polityce, jest artefaktem kompresji tego routingu. Menedżerowie byli jedynym dostępnym sprzętem do tego zadania.
Nie są już jedynym dostępnym sprzętem. Model, który czyta każdy diff, plus tabela mnożników, robi routing na zewnątrz w jednym przeskoku, a do wewnątrz w jednym zapytaniu. To jest organizacja pull i chcę być precyzyjny co do jej ograniczeń. Nic nie zostaje spłaszczone. Przywództwo nadal ustala mnożniki, więc strategia nadal jest decydowana w jednym pokoju przez kilka osób, a zmienia się tylko droga z tego pokoju. Dla ludzi zostaje część, która zawsze była zadaniem i nigdy nie miała czasu: decydowanie, jakie powinny być mnożniki, i siedzenie z ludźmi, których te decyzje dotknęły.
Polityka nie znika. Przenosi się. Przenosi się z „czy mój menedżer pamięta mój kwartał“ na „dlaczego mój komponent ma ocenę 1.0x, skoro roadmapa nazywa go kluczowym“, a ta druga walka dotyczy faktycznej strategii firmy, prowadzona publicznie, w tabeli, którą każdy może przeczytać. Wolałbym mieć tę walkę co miesiąc niż obecną, odbywającą się raz w roku, prywatnie, przez kogoś rekonstruującego jedenaście miesięcy z pamięci.
Ktoś to poprowadzi źle. Ktoś powiesi tablicę wyników na ścianie bez wyjaśnień kwalifikacyjnych i bez śladu nadpisań i zwolni dolny decyl, i to zostanie zrzucone na model, a nie na osobę, która wybrała mnożniki.
Więc zmierz mnie tym samym instrumentem. Jeśli prowadzisz coś takiego, publikuj tabelę mnożników, żeby ludzie spierali się ze strategią, a nie z wynikiem. Publikuj zestawienie per pull request, żeby każdy, kto dostał zero, mógł zobaczyć, która bramka się na nim zamknęła, i się odwołać. Publikuj log nadpisań, bo liczba zmieniona ręcznie przez człowieka jest jedyną liczbą wartą audytu. Publikujemy pierwszą. Trzecią robimy źle. Drugiej nie publikujemy wcale, a to ona decyduje, czy coś takiego jest narzędziem zarządzania, czy tylko szybszym sposobem na bycie niesprawiedliwym.
GitRank jest na gitrank.dev i jest licencjonowany CC BY-NC 4.0. Scoring na ścieżce produkcyjnej działa na Claude Haiku 4.5 przy temperaturze 0.3. Wszystkie liczby powyżej pochodzą z naszego własnego repozytorium platformy między 6 lipca a 3 sierpnia 2026, wielkość próbki to jedna firma i siedmiu programistów, co jest opisem nas, a nie benchmarkiem czegokolwiek.