Tradução automática. Ler o original em inglês: Your performance review is a memory test →
Pergunte a qualquer gerente de engenharia quem é o melhor engenheiro deles. A resposta volta antes de você terminar a pergunta, sem hesitação e sem “deixa eu verificar algo primeiro”. Eles sabem. Sempre souberam.
Agora peça para mostrarem o trabalho.
Você vai ouvir uma história. Uma boa história, geralmente, sobre um incidente que alguém resolveu às 2h da manhã, ou um refactor que destravou um trimestre. O que você não vai ouvir é um número, uma comparação, ou qualquer relato dos quatro engenheiros cujo trabalho o gerente não estava na sala para ver. Essa confiança é construída a partir da memória, e a memória é uma função da proximidade.
Esta é a tese. O desempenho de engenharia é julgado pela memória, a memória recompensa visibilidade em vez de valor, e o trabalho que você realmente quer que as pessoas façam está escrito em um roadmap que nunca é conectado àquilo que você usa para avaliá-las. Esses dois documentos não têm nada a ver um com o outro em quase todas as empresas que vi, incluindo a minha.
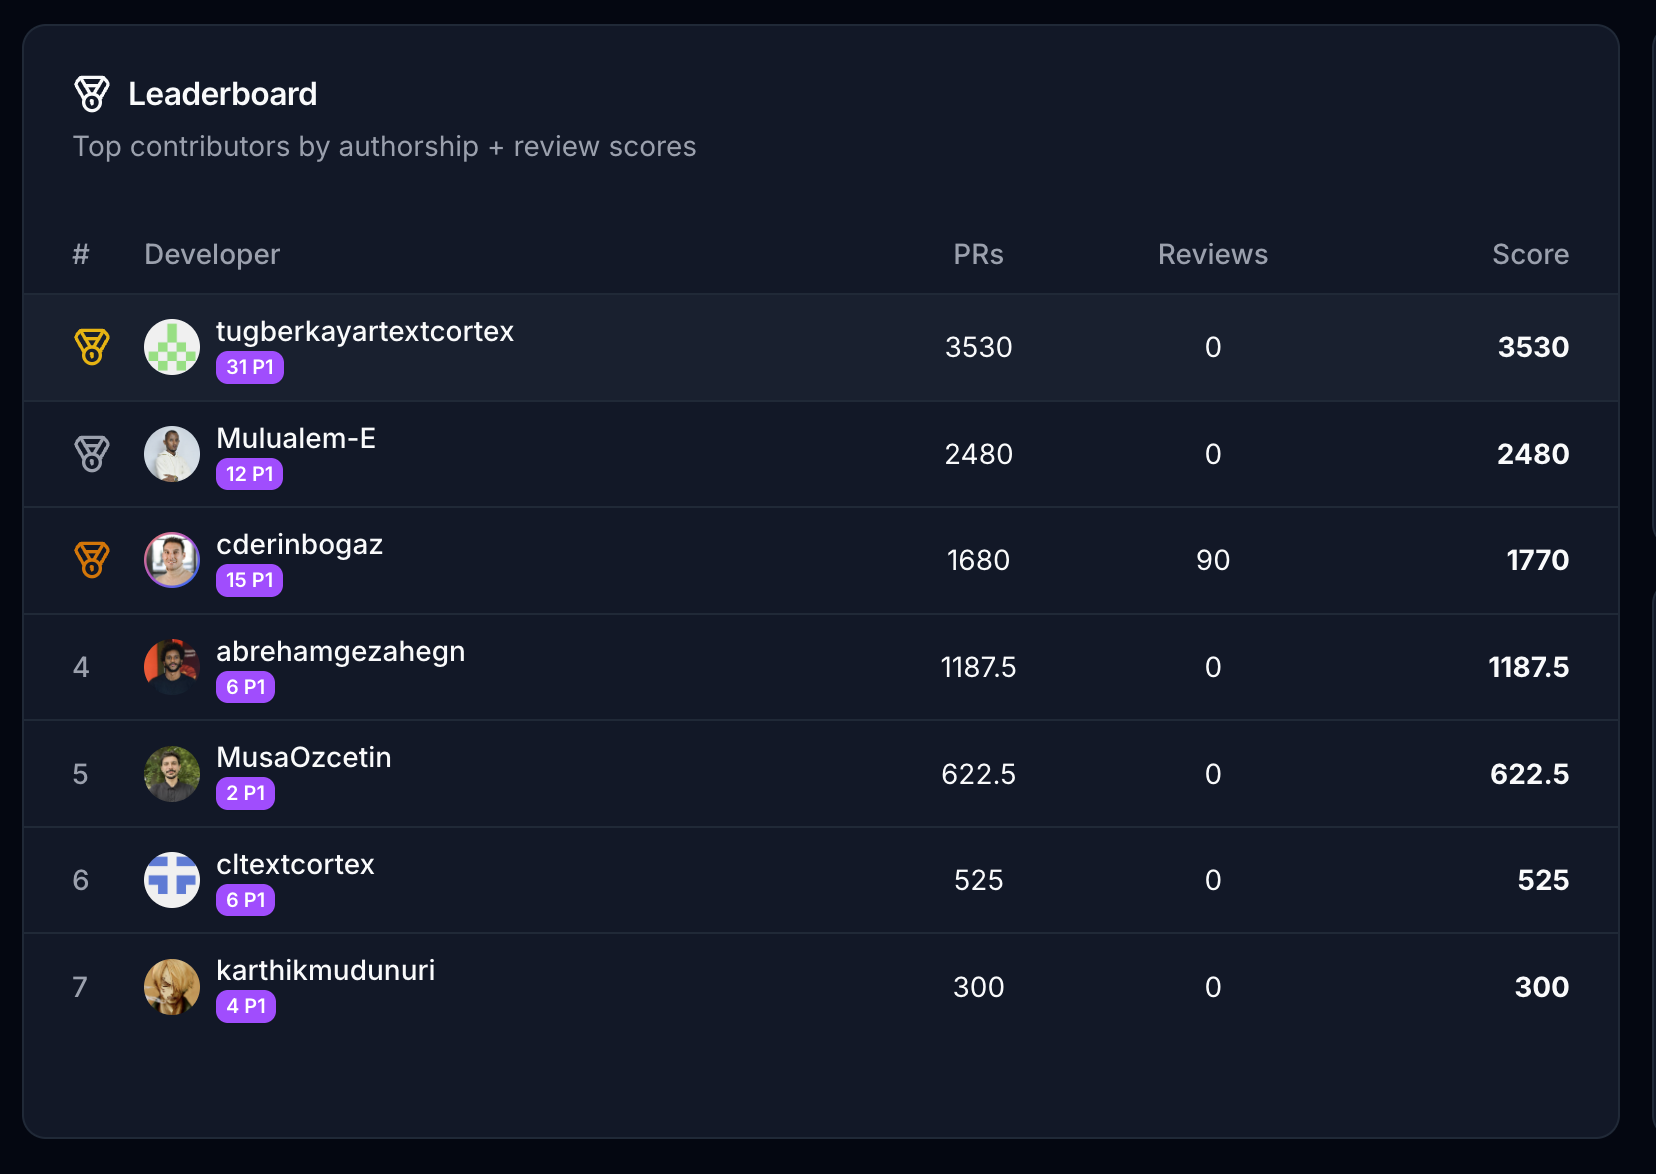
Então nós os conectamos. Cada pull request mesclado é lido por um modelo, recebe uma severidade, e é multiplicado pelo quanto nosso roadmap se importa com o componente que ele tocou. O resultado é um leaderboard mensal, e ele alimenta decisões de bônus. Aqui está o nosso.
A sabedoria convencional diz que isso não pode ser medido, e a sabedoria convencional é um dar de ombros
A posição padrão sobre medir a produção individual é que você não deve, porque todo proxy é uma armadilha. Linhas de código recompensam inchaço. Contagem de commits recompensa divisão. Tickets fechados recompensam quem pega os pequenos primeiro. Story points são uma negociação feita antes do trabalho começar. Até os bons frameworks são deliberadamente em nível de time: DORA mede quatro coisas sobre um pipeline de entrega e não diz nada sobre pessoas, algo que seus autores deixam explícito.
Tudo isso está correto, e nada disso é uma resposta. O ranking acontece de qualquer forma, todo ano, na hora da compensação, em uma sala, pela memória, ponderado por quem a pessoa naquela sala estava sentada ao lado. Recusar-se a medir compra um ranking sem trilha de auditoria e sem recurso.
Chame isso de prêmio do engenheiro barulhento: a lacuna entre o quão bem você é avaliado e o quão bem você performou, explicada inteiramente pela sua distância de quem escreve sua avaliação. Peça a qualquer humano para comparar as contribuições técnicas de quinze pessoas ao longo de um ano usando nada além do que eles por acaso notaram e é isso que sai. Qualquer um de nós produziria isso.
Esse prêmio era inevitável até cerca de dois anos atrás, porque a matéria-prima para uma resposta melhor era uma pilha de diffs que ninguém tinha tempo de ler. Essa restrição acabou. Um modelo pode ler cada diff no seu repositório todo mês por menos do que o custo da reunião onde você atualmente adivinha. Ler é a parte fácil. Decidir quanto vale a leitura é o problema inteiro, e isso não é uma questão técnica.
A fórmula inteira cabe em uma linha
Aqui está ela, completa, do caminho de pontuação no GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0Não simplifiquei isso para o blog. É a linha como ela roda, sem regressão escondida, sem ponderação aprendida, sem termo de reputação e sem ajuste de tempo de casa. Severidade vezes importância, ou zero.
Severidade é uma escada fixa, definida uma vez e visível para todos que estão sendo avaliados.
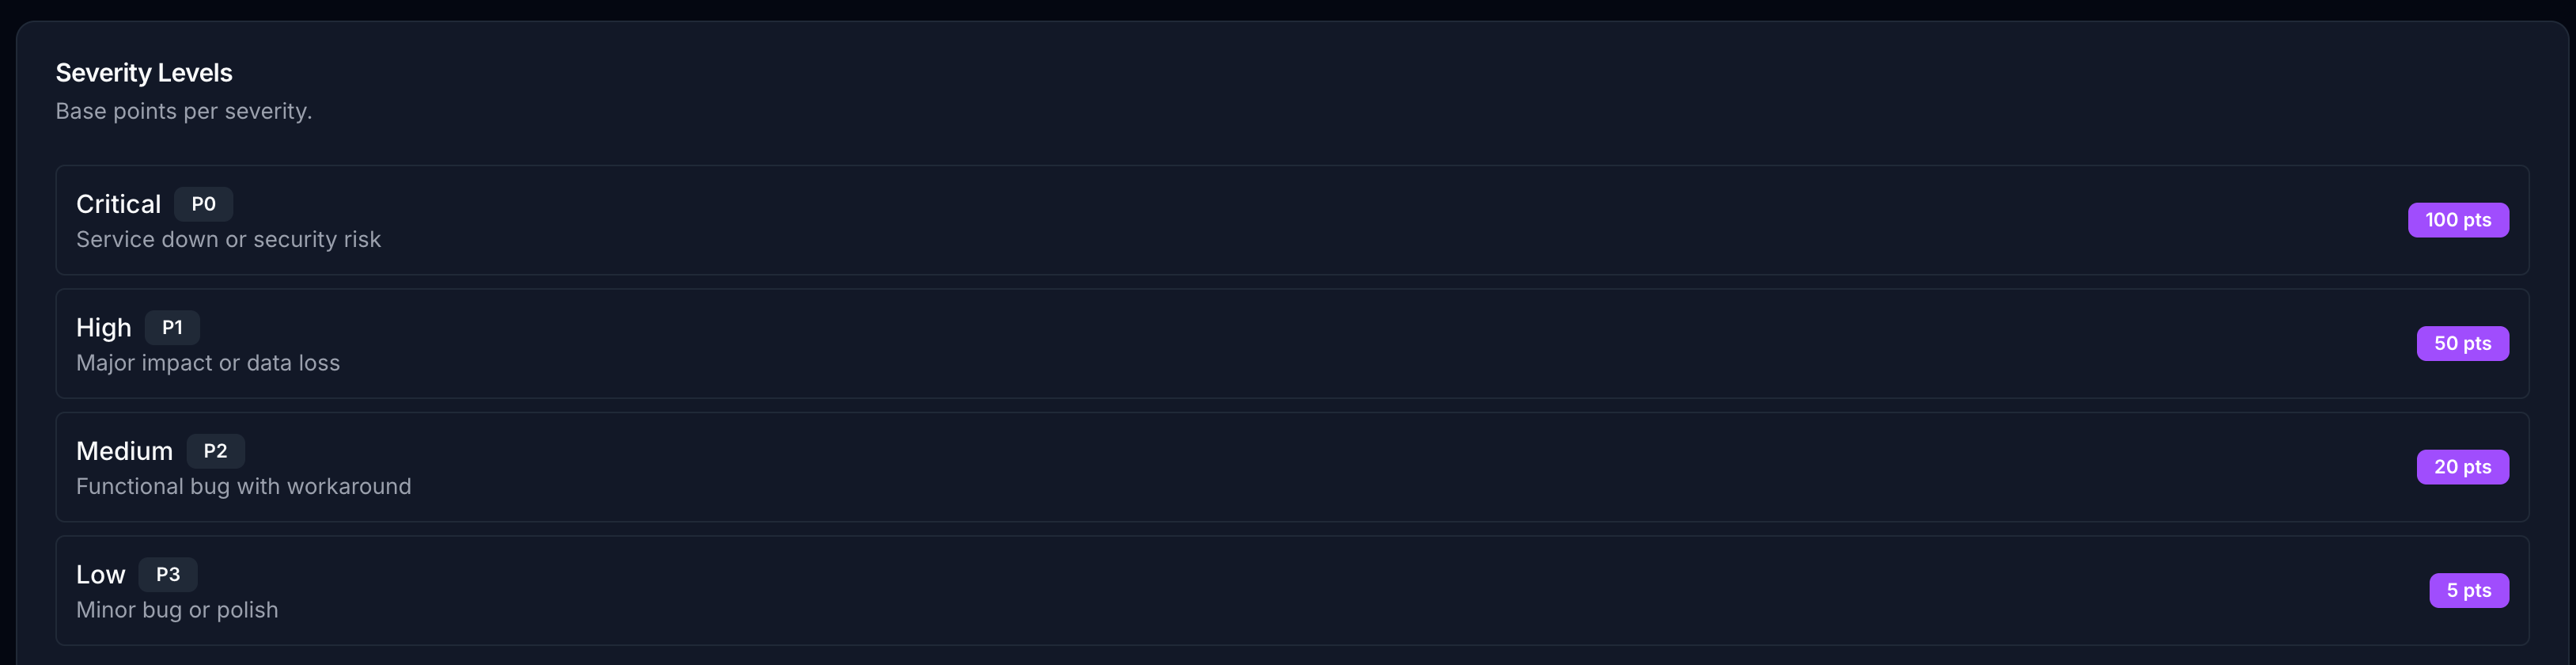
Uma correção crítica vale vinte de baixa prioridade. Essa proporção é uma declaração de política, e nós a escrevemos em vez de deixá-la na cabeça de alguém.
Importância é a metade que importa. Cada componente carrega um multiplicador, e o multiplicador é o que o produto precisa neste trimestre.
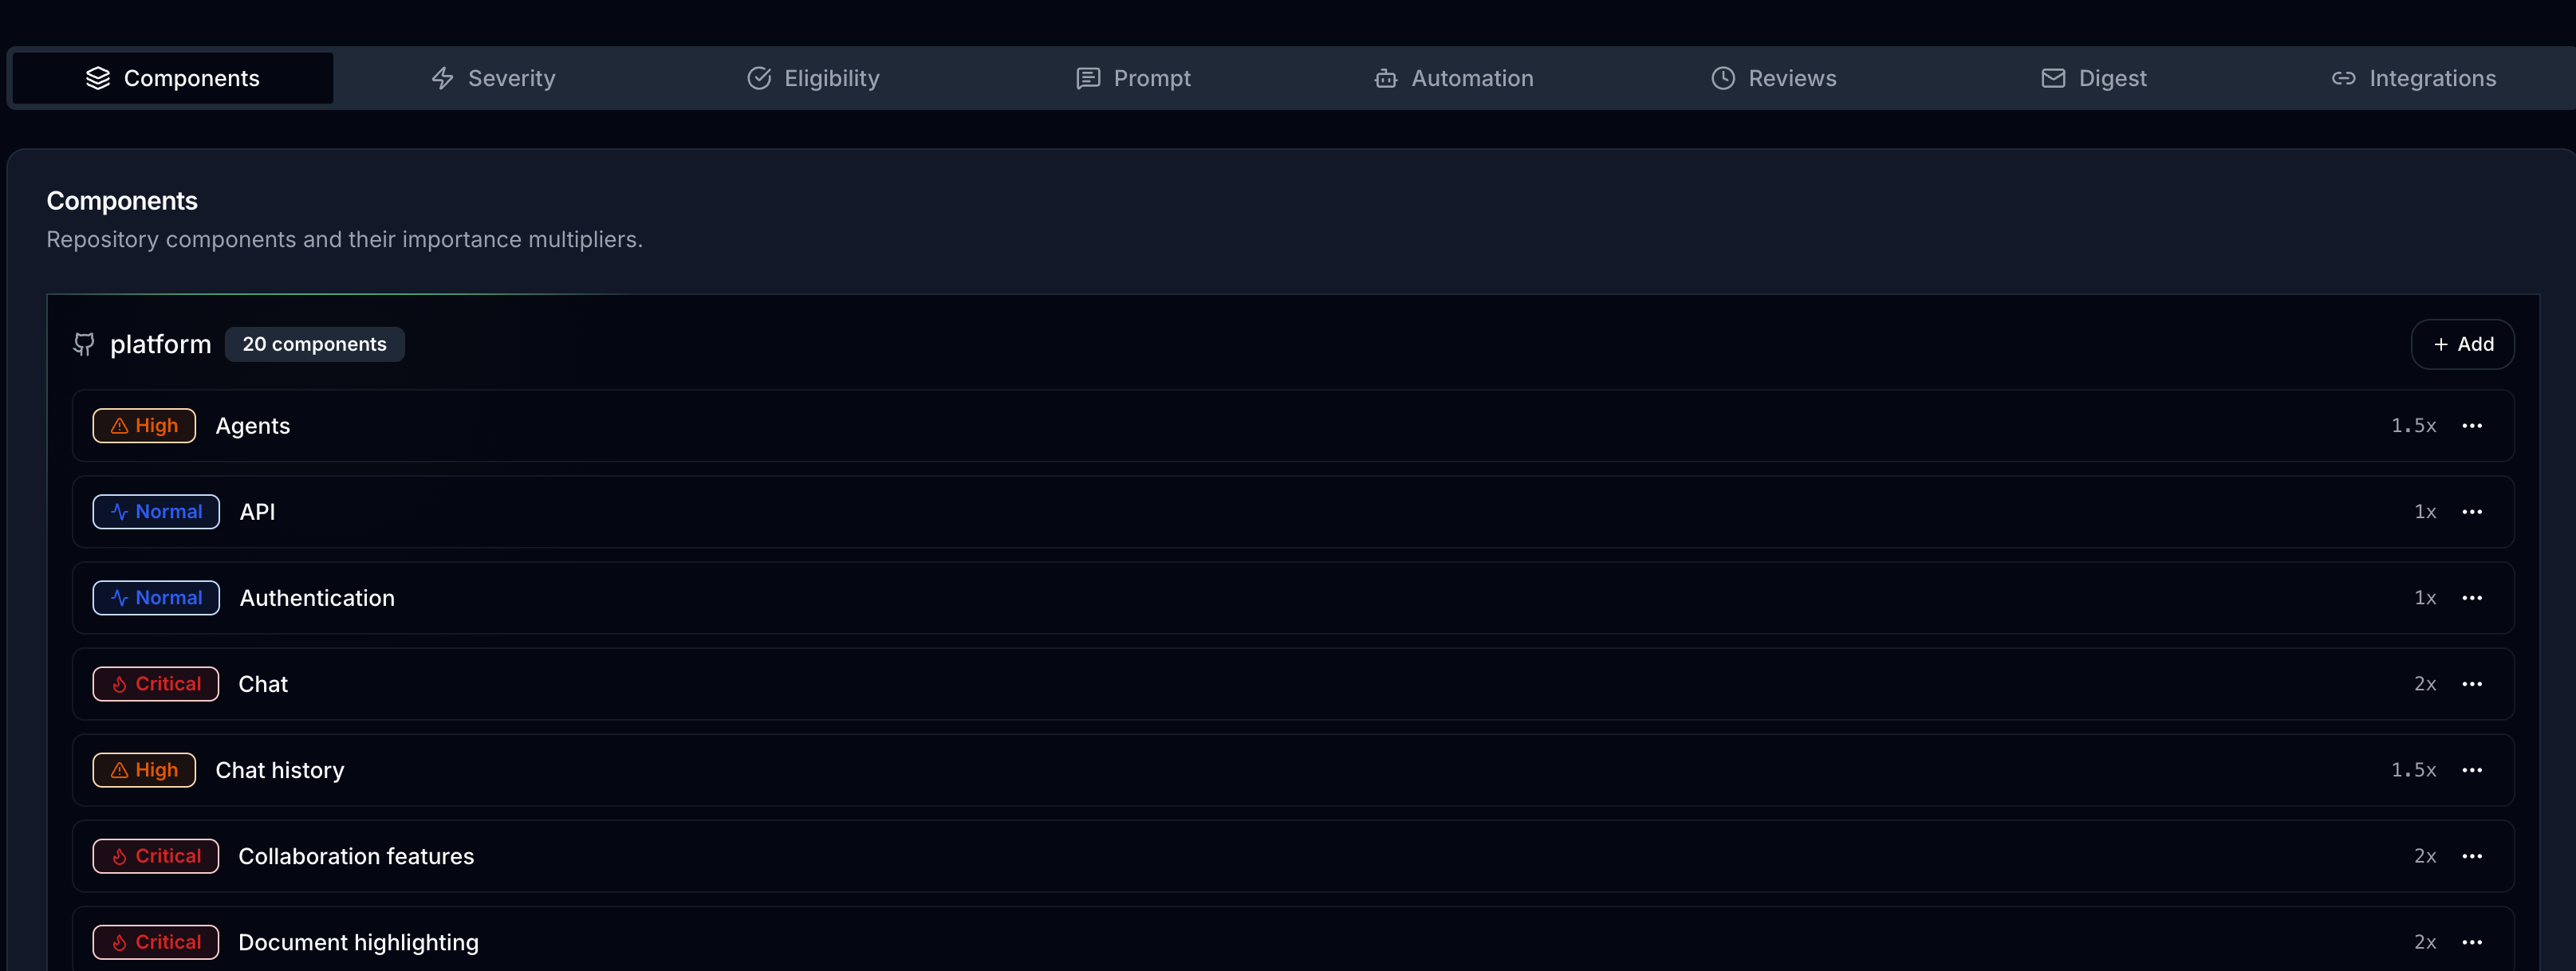
Chat é 2.0x porque chat é onde estamos apostando o produto. Authentication é 1.0x porque funciona e gostaríamos que continuasse funcionando silenciosamente. Essas são decisões de produto, e a tabela de multiplicadores é onde elas são redigitadas em um campo que paga.
O documento de estratégia e a entrada de compensação se tornaram o mesmo documento. Essa é a jogada. O modelo é encanamento e o leaderboard é uma renderização dele, e se o roadmap mudar em outubro, então o incentivo muda em outubro, em vez de em um ciclo de avaliação daqui a catorze meses.
Deixa eu explicar isso em detalhes, porque é a parte que as pessoas pulam. Quarenta pessoas inteligentes, cada uma otimizando localmente e honestamente, vão produzir um trimestre de trabalho que não soma naquilo que a empresa disse que queria. Ninguém nesse quadro é preguiçoso, que é o que torna isso difícil. A gerência média existe em grande parte para corrigir isso, carregando a estratégia em conversas, mesa por mesa, perdendo fidelidade a cada salto. Uma tabela de multiplicadores faz o mesmo roteamento em um salto, e em outubro ela ainda diz exatamente o que você digitou nela em janeiro.
Joi Ito já nomeou a diferença. Um dos nove princípios em Whiplash, escrito com Jeff Howe em 2016, é puxar em vez de empurrar: você puxa da rede conforme a necessidade em vez de manter tudo em estoque. Ito estava descrevendo recursos. Direção se comporta da mesma forma. Uma organização que empurra acumula a estratégia numa camada de gestão e a distribui em conversas, por isso ela chega à borda da empresa tarde e com perdas. Uma organização que puxa publica a estratégia como uma tabela de preços e deixa as pessoas tirarem dela o que precisam. A tabela de multiplicadores é a tabela de preços.
Uma correção crítica no chat vale quarenta commits de polimento na API
Junte as duas metades e a dispersão é severa. Um P0 no chat pontua 100 base vezes 2.0, ou seja, 200 pontos. Um P3 na API pontua 5. Quarenta para um, que é a distância entre o pull request mais valioso que você pode mesclar aqui e o menos.
Essa proporção é deliberadamente violenta, e faz o que incentivos suaves nunca conseguem. Ninguém reorganiza a semana em torno de uma diferença de 15%. As pessoas absolutamente reorganizam a semana em torno de uma de 40x.
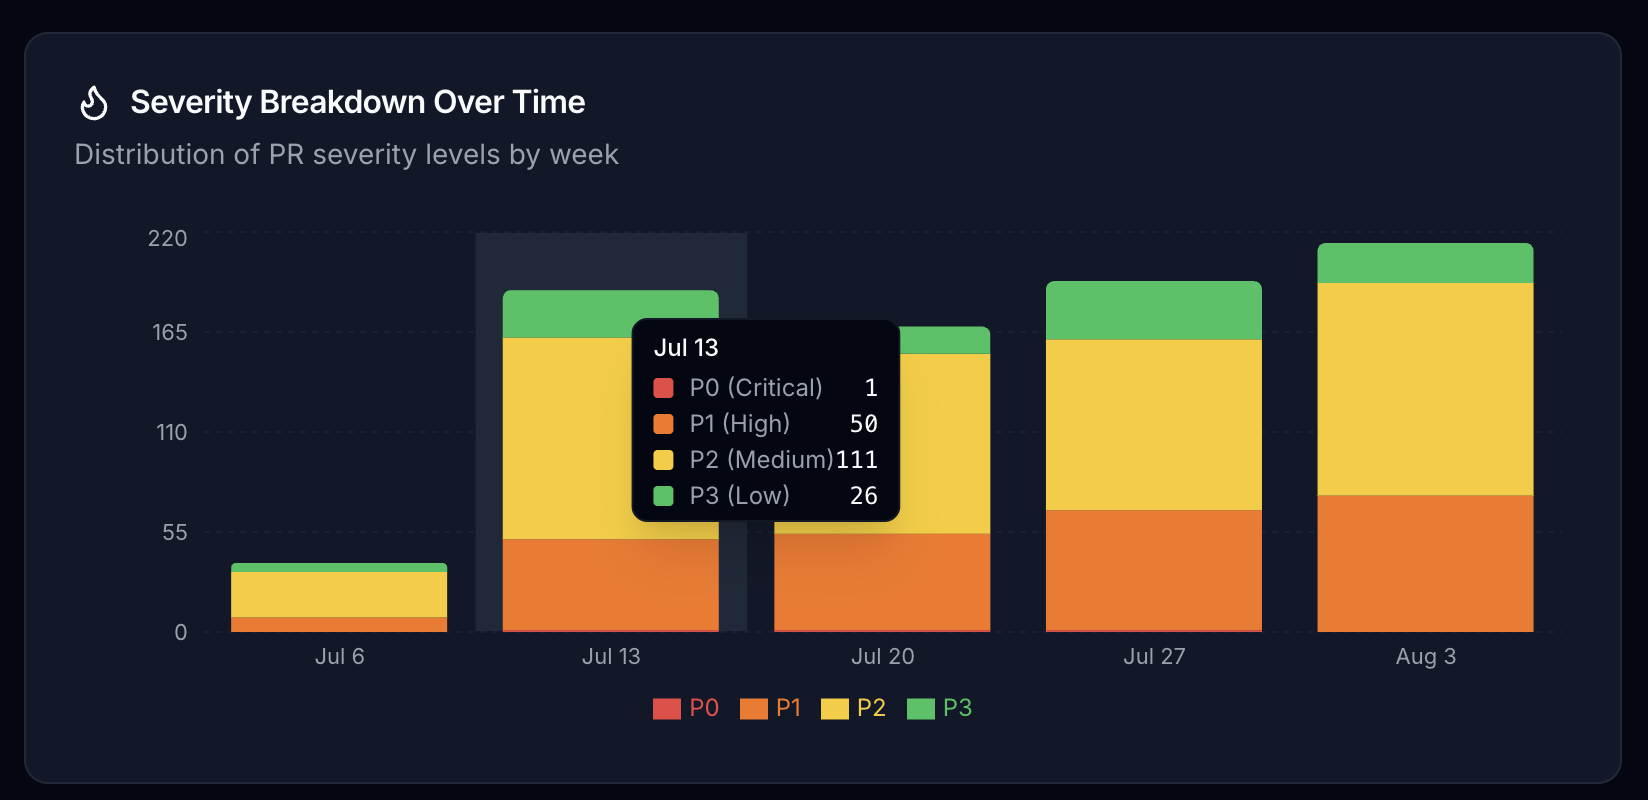
188 pull requests em uma única semana. P2 é 59% deles, o que é o que uma semana normal de engenharia parece em qualquer lugar. Agora pondere. Aqueles 111 P2s valem 2.220 pontos. Os 50 P1s valem 2.500. Menos da metade dos pull requests carregam mais da metade do valor da semana. Conte pull requests e você conclui que a semana foi sobre P2s. Pondere-os e a semana foi sobre cinquenta trabalhos específicos, e você pode nomear quem os fez.
Duas pessoas foram 58% da produção, e eu tinha a ordem errada
Sete desenvolvedores, 10.415 pontos. O principal desenvolvedor detém 3.530 deles, 33,9% de tudo que o time produziu em valor. Os dois primeiros detêm 57,7% entre eles.
Concentração assim geralmente significa que os dois primeiros estão trabalhando nos componentes de maior multiplicador, que é exatamente o que pedimos que fizessem. O número descreve onde o valor está chegando, e eu não leria nada sobre os outros cinco.
A ordenação é o que quebrou minha previsão.
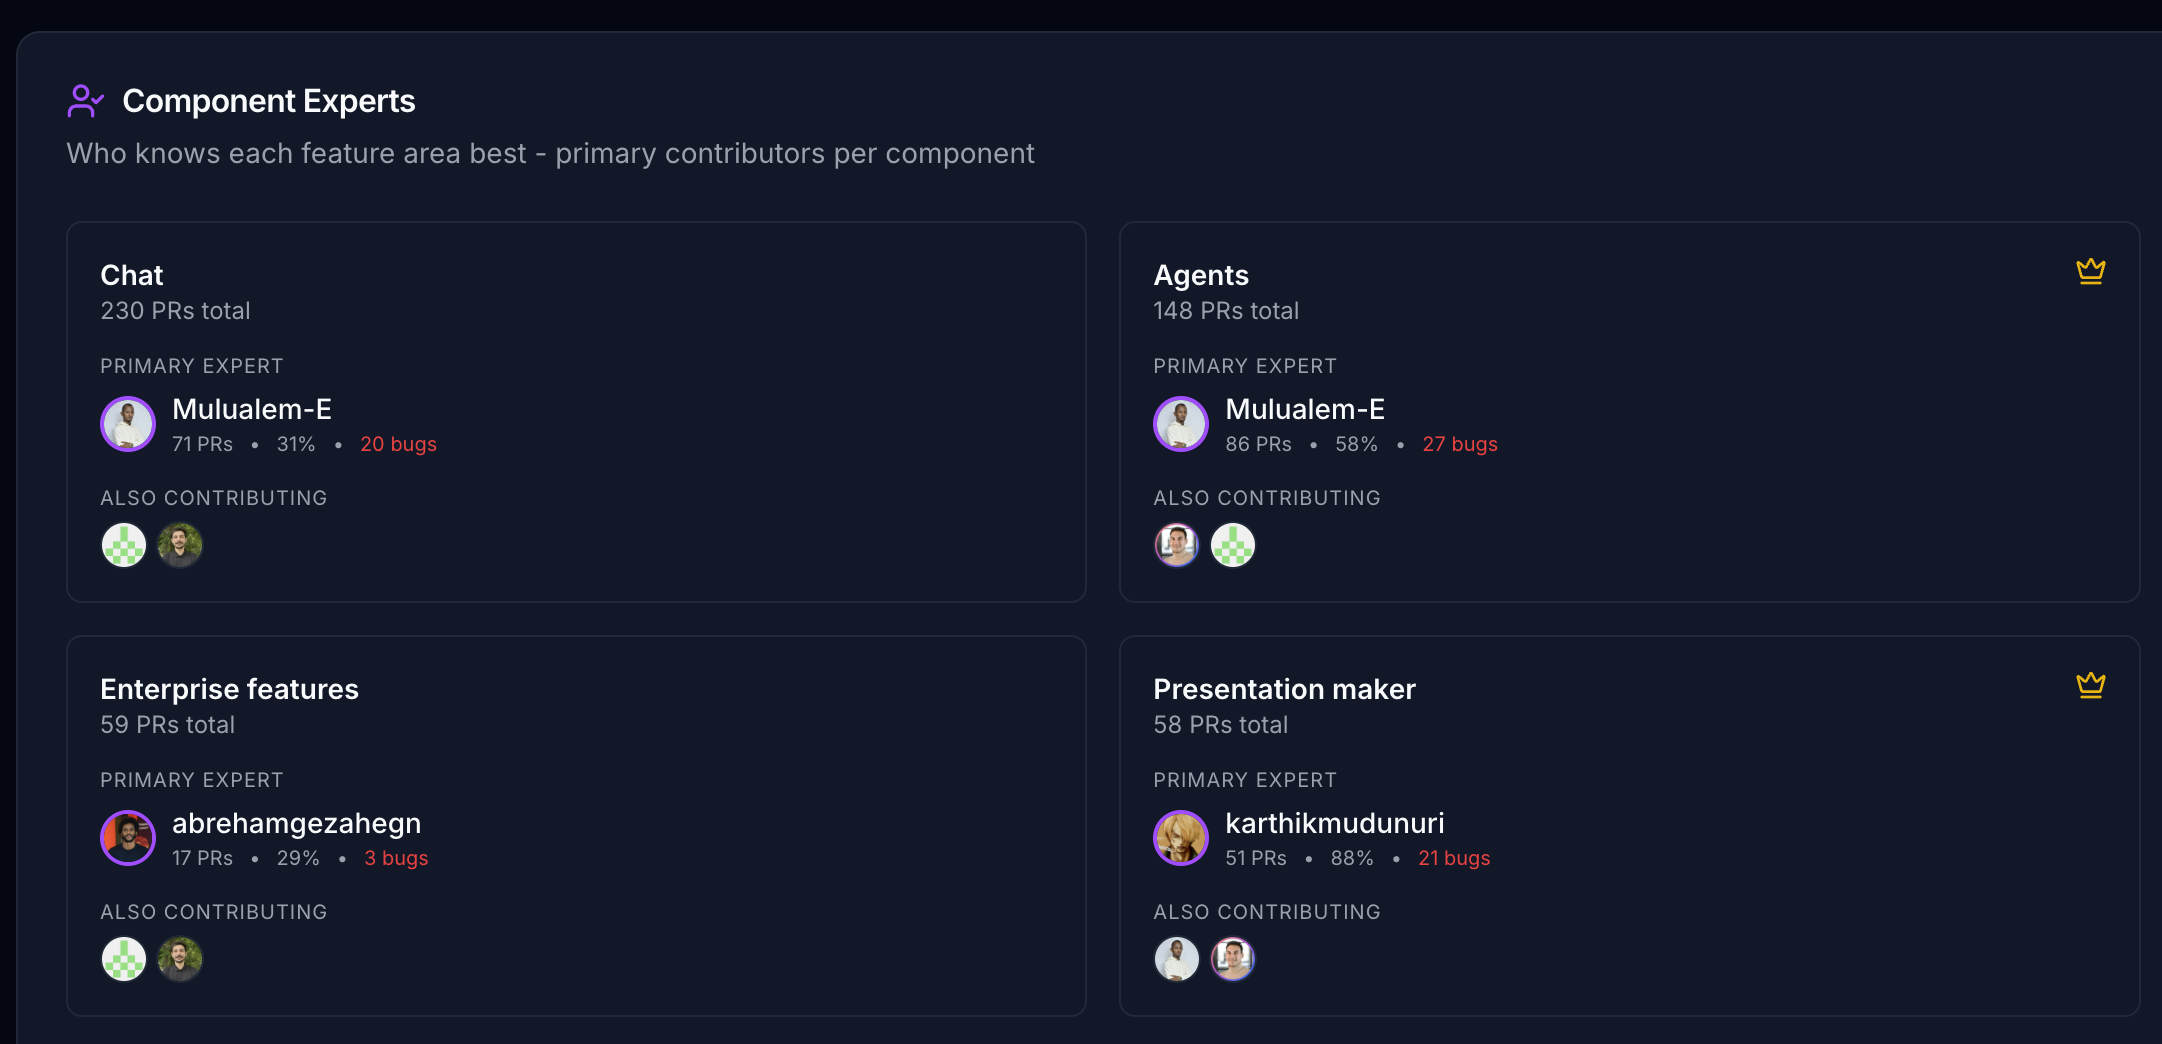
Mulualem-E é o especialista principal em chat, nosso componente de 2.0x, com 71 de seus 230 pull requests, e em agents, nosso componente de 1.5x, com 86 de 148. Se você tivesse me descrito isso e perguntado quem lidera o ranking, eu teria dito ele sem hesitar. Ele é o segundo. O primeiro lugar vai para tugberkayartextcortex, com 31 pull requests P1 contra os 12 de Mulualem-E.
A mistura de severidade venceu a posse de componente. Ser dono da área mais importante do produto acaba não sendo a mesma coisa que repetidamente entregar trabalho de alto impacto dentro dela, e até publicarmos isso eu não poderia ter dito qual dos dois nossa compensação estava recompensando. Estava recompensando aquele que eu por acaso tinha notado. Esse é o prêmio do engenheiro barulhento, capturado na minha própria empresa. Minha intuição tinha as duas pessoas certas e a ordem errada, e a ordem errada é o que um bônus é.
Payments é 45% correções de bugs e ninguém precisou discutir sobre isso
Pontuar cada pull request também acaba com o hábito de discutir qualidade a partir de anedotas.
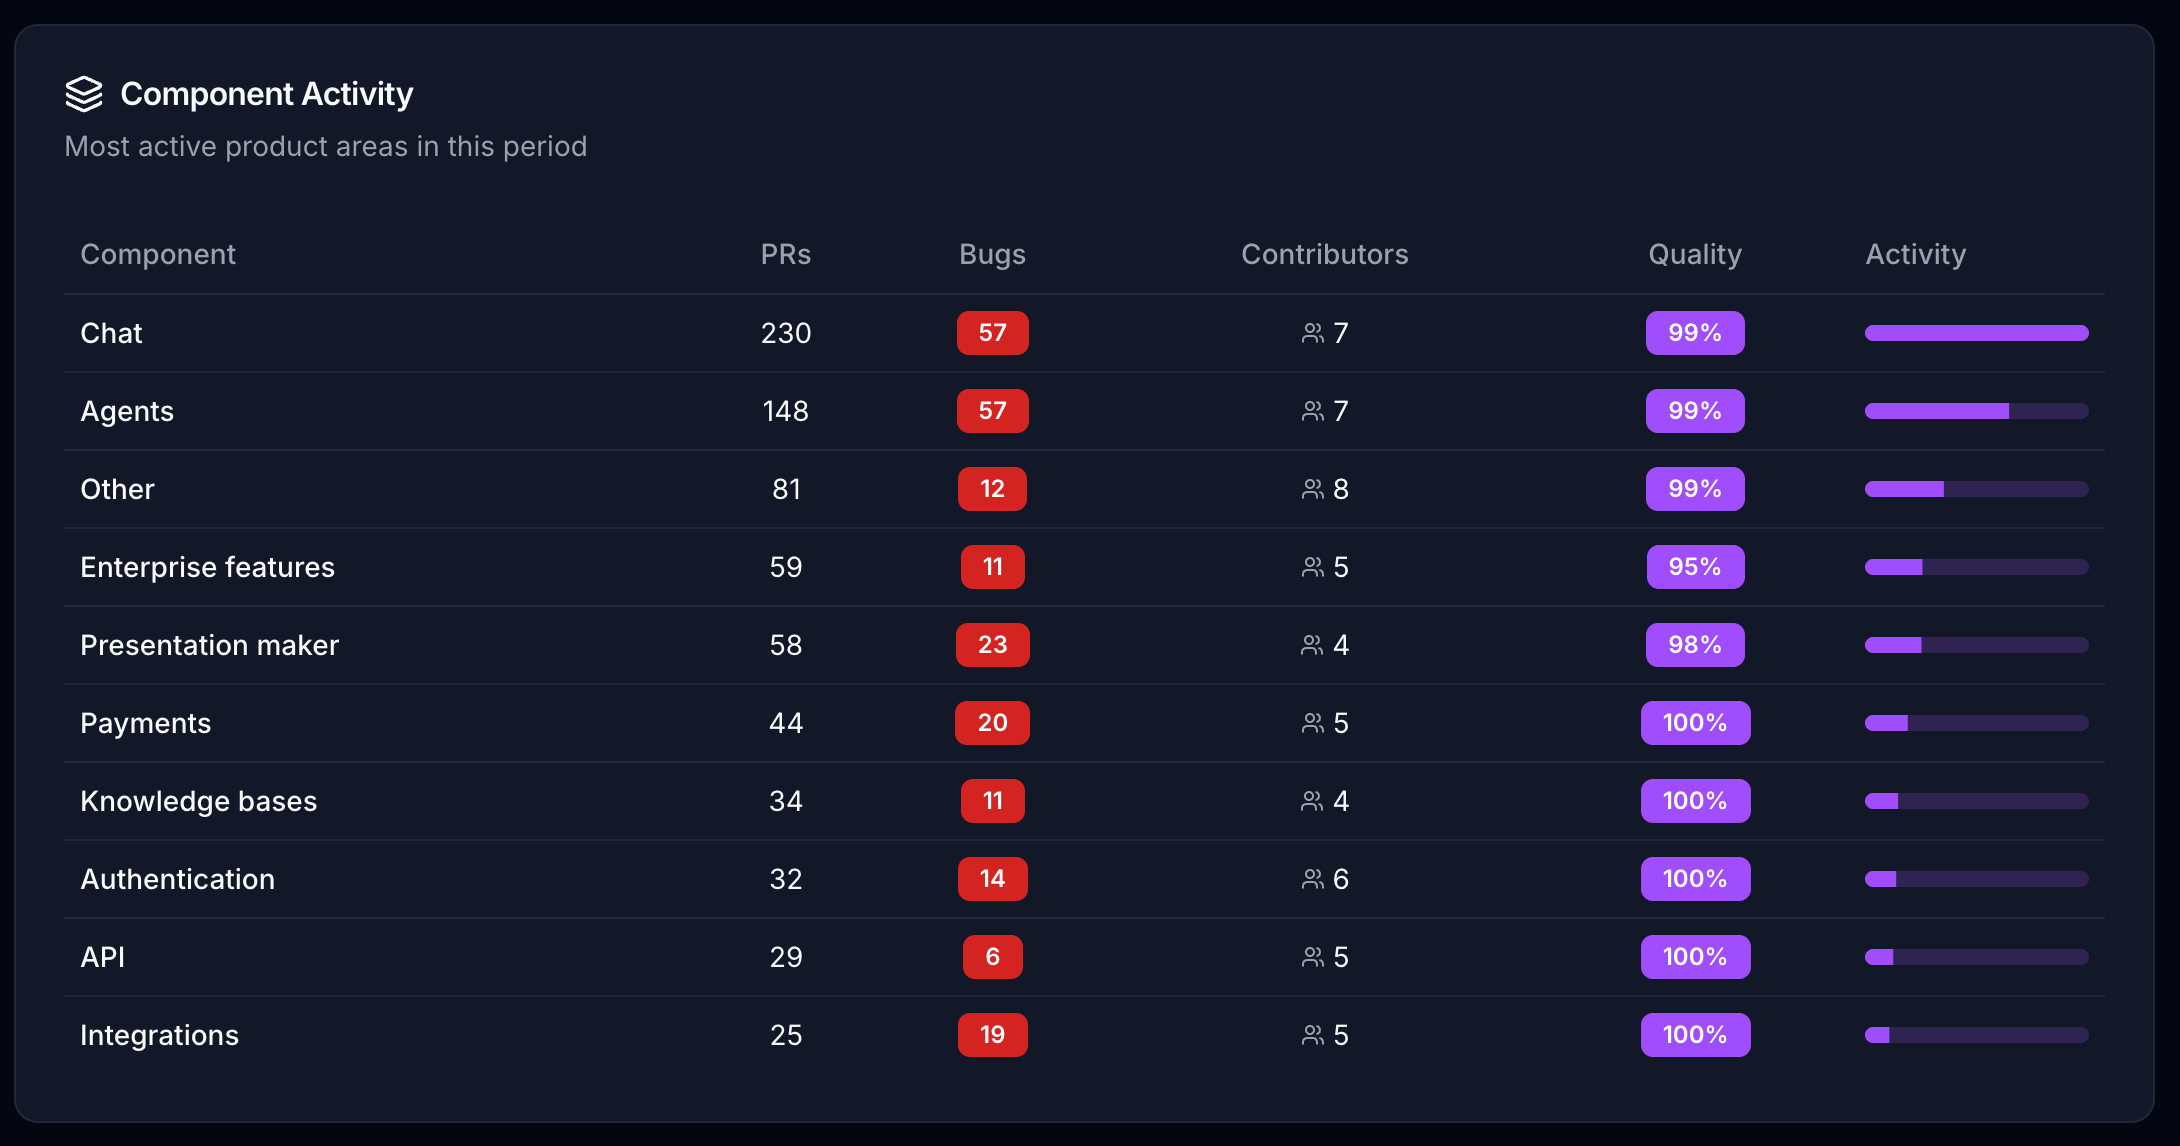
740 pull requests nos dez componentes mais movimentados, 230 deles correções de bugs em vez de trabalho novo. Só o chat tem 230 pull requests, que é o que um multiplicador de 2.0x parece quando está funcionando. Depois payments: 44 pull requests, 20 bugs, uma taxa de bugs de 45% no componente que lida com dinheiro.
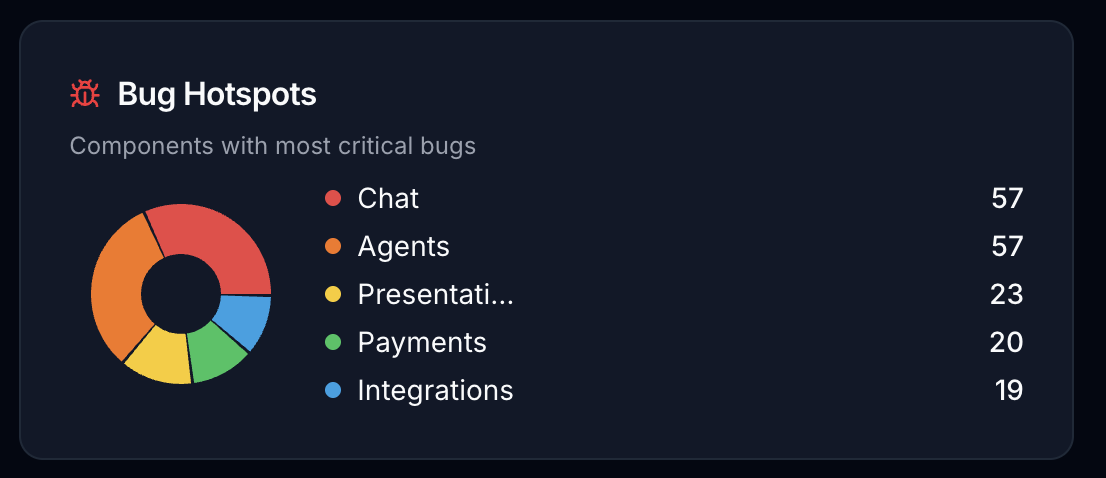
Chat e agents estão empatados com 57 bugs cada, mas chat produziu esses ao longo de 230 pull requests e agents ao longo de 148. Mesma contagem de bugs, 55% mais trabalho por trás de um deles. Isso é um sinal sobre agents que nenhuma retrospectiva iria trazer à tona, porque ninguém mesclou o suficiente de ambos para notar.
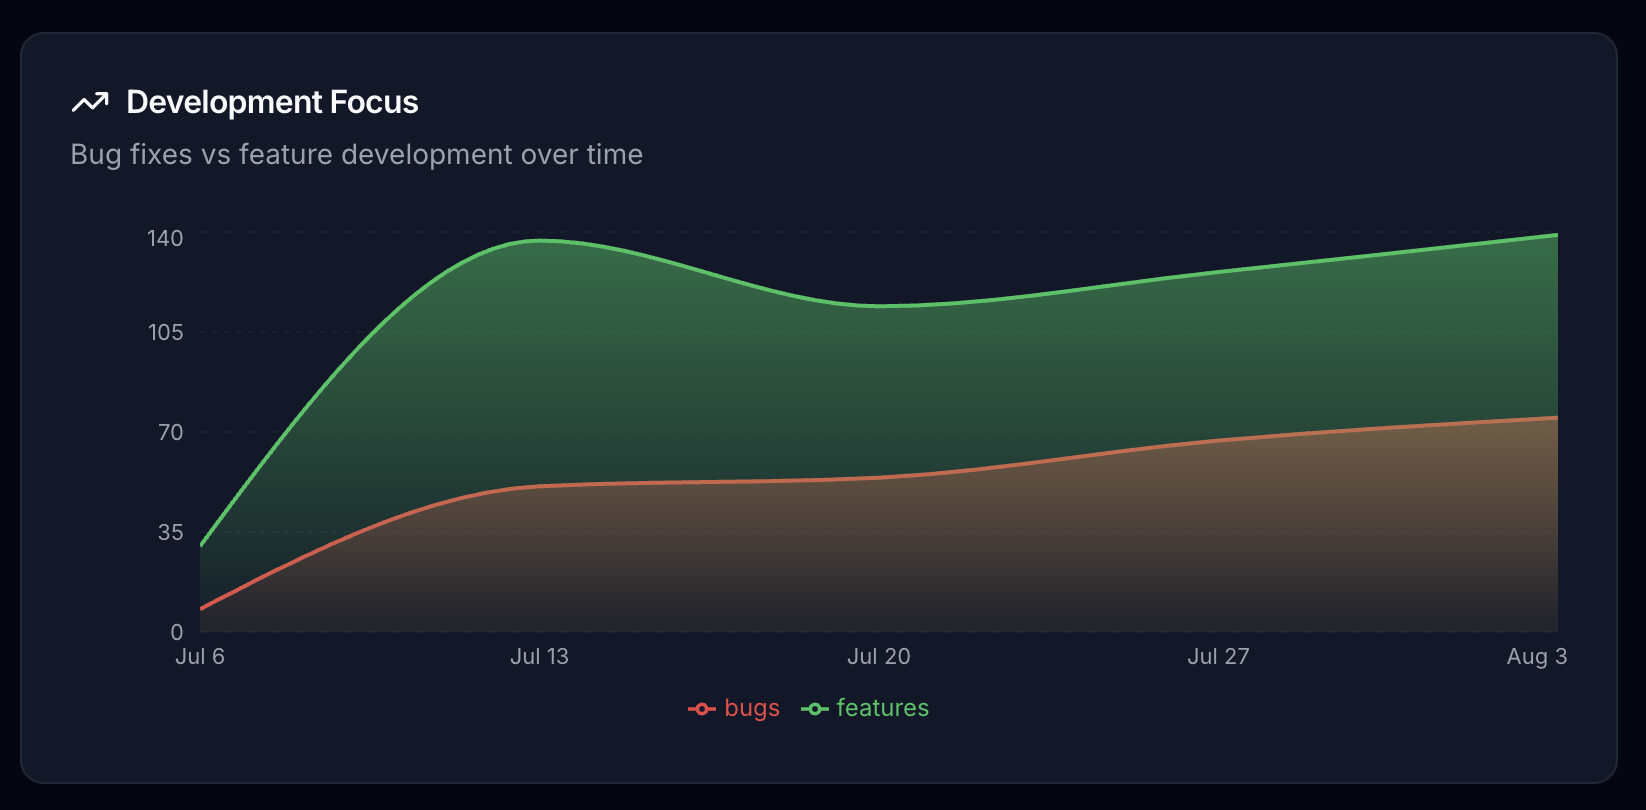
Bugs e recursos sobem juntos em vez de se alternarem. Cinco semanas estão bem dentro do ruído que um único projeto grande chegando produziria, então trate esse gráfico como uma descrição do período e nada mais.
Não tenho um número de uplift, e você não deveria confiar em ninguém que tenha
Eis a afirmação que quero fazer. Desde que começamos a publicar isto mensalmente, o trabalho mudou para os componentes que marcamos como importantes, porque os engenheiros querem o score.
Não vou colocar uma porcentagem nisso. Ativamos isso no meio do fluxo. Não havia baseline nem repositório de controle, e nunca concordamos antecipadamente sobre o que “mudou” significaria. Os multiplicadores mudaram durante o período. O headcount também. Qualquer número que eu publicasse seria um que eu escolhi depois de ver os dados, o que o torna decoração.
O que mudou foi o argumento. As pessoas pararam de perguntar se seu trabalho era apreciado e começaram a perguntar por que um componente era avaliado em 1.0x. Essa é uma briga melhor para se ter, e é a única coisa pela qual eu teria pago sozinha.
Nossa própria ferramenta também não é limpa, e a aresta mais afiada é esta: um pull request que pontua zero não diz qual critério de elegibilidade fechou sobre ele. Perca o link da issue ou os testes e o score é zero independentemente da gravidade, e a pessoa com mais sobre o que argumentar recebe o mínimo com que argumentar. Estamos corrigindo isso antes de qualquer outra coisa na lista.
Aponte para o roadmap, depois entregue a régua às pessoas
Tire a autoridade de um organograma e o que sobra por baixo é uma tabela de roteamento. Ela carrega “o que importa neste trimestre” para fora, a partir das pessoas que decidiram, e “quem fez o quê” de volta para dentro, e faz ambos lentamente e com distorção em cada salto. Tudo o que você não gosta na política corporativa é um artefato de compressão desse roteamento. Gestores têm sido o único hardware disponível para o trabalho.
Eles não são mais o único hardware disponível. Um modelo que lê cada diff, mais uma tabela de multiplicadores, faz o roteamento para fora em um salto e o roteamento para dentro em uma consulta. Essa é a organização pull, e quero ser exato sobre seus limites. Nada é achatado. A liderança ainda define os multiplicadores, então a estratégia ainda é decidida em uma sala por poucas pessoas, e tudo o que muda é o caminho para fora dessa sala. O que resta para os humanos é a parte que sempre foi o trabalho e nunca teve tempo: decidir quais deveriam ser os multiplicadores, e ficar com as pessoas que essas decisões moveram.
A política não desaparece. Ela se move. Ela se move de “meu gestor lembra do meu trimestre?” para “por que meu componente é avaliado em 1.0x quando o roadmap o chama de core?”, e essa segunda briga é sobre a estratégia real da empresa, conduzida em público, em uma tabela que qualquer um pode ler. Prefiro ter essa briga todo mês do que a atual, realizada uma vez por ano, em particular, por alguém reconstruindo onze meses a partir da memória.
Alguém vai administrar isso mal. Alguém vai colocar um placar na parede sem explicações de elegibilidade e sem trilha de override e demitir o decil inferior, e a culpa vai cair no modelo em vez de na pessoa que escolheu os multiplicadores.
Então me meça com o mesmo instrumento. Se você executar algo assim, publique a tabela de multiplicadores, para que as pessoas discutam com a estratégia em vez de com o score. Publique o detalhamento por pull request, para que qualquer um que pontuou zero possa ver qual gate fechou sobre ele e recorrer. Publique o log de overrides, porque um número que um humano alterou manualmente é o único número que vale a pena auditar. Publicamos o primeiro. Fazemos o terceiro mal. Não publicamos o segundo de forma alguma, e é esse que decide se uma coisa dessas é uma ferramenta de gestão ou apenas uma forma mais rápida de ser injusto.
GitRank está em gitrank.dev e é licenciado sob CC BY-NC 4.0. A pontuação no caminho de produção roda em Claude Haiku 4.5 a temperatura 0.3. Todos os números acima vêm do nosso próprio repositório de plataforma entre 6 de julho e 3 de agosto de 2026, tamanho de amostra de uma empresa e sete desenvolvedores, o que é uma descrição de nós e não um benchmark de nada.