Traduction automatique. Lire l’original en anglais: Your performance review is a memory test →
Demandez à n’importe quel manager d’ingénierie qui est son meilleur ingénieur. La réponse arrive avant même que vous ayez fini la question, sans hésitation et sans « laissez-moi vérifier d’abord ». Ils savent. Ils ont toujours su.
Maintenant, demandez-leur de montrer le travail.
Vous obtenez une histoire. Une bonne histoire, en général, à propos d’un incident géré à 2h du matin, ou d’une refactorisation qui a débloqué un trimestre. Ce que vous n’obtenez pas, c’est un chiffre, une comparaison, ou un compte rendu des quatre ingénieurs dont le manager n’était pas dans la pièce. Cette confiance est construite à partir de souvenirs, et le souvenir est une fonction de la proximité.
Voici la thèse. La performance en ingénierie est jugée de mémoire, la mémoire récompense la visibilité plutôt que la valeur, et le travail que vous voulez vraiment que les gens fassent est écrit dans une roadmap qui n’est jamais connectée à ce sur quoi vous les évaluez. Ces deux documents n’ont rien à voir l’un avec l’autre dans presque toutes les entreprises que j’ai vues, y compris la mienne.
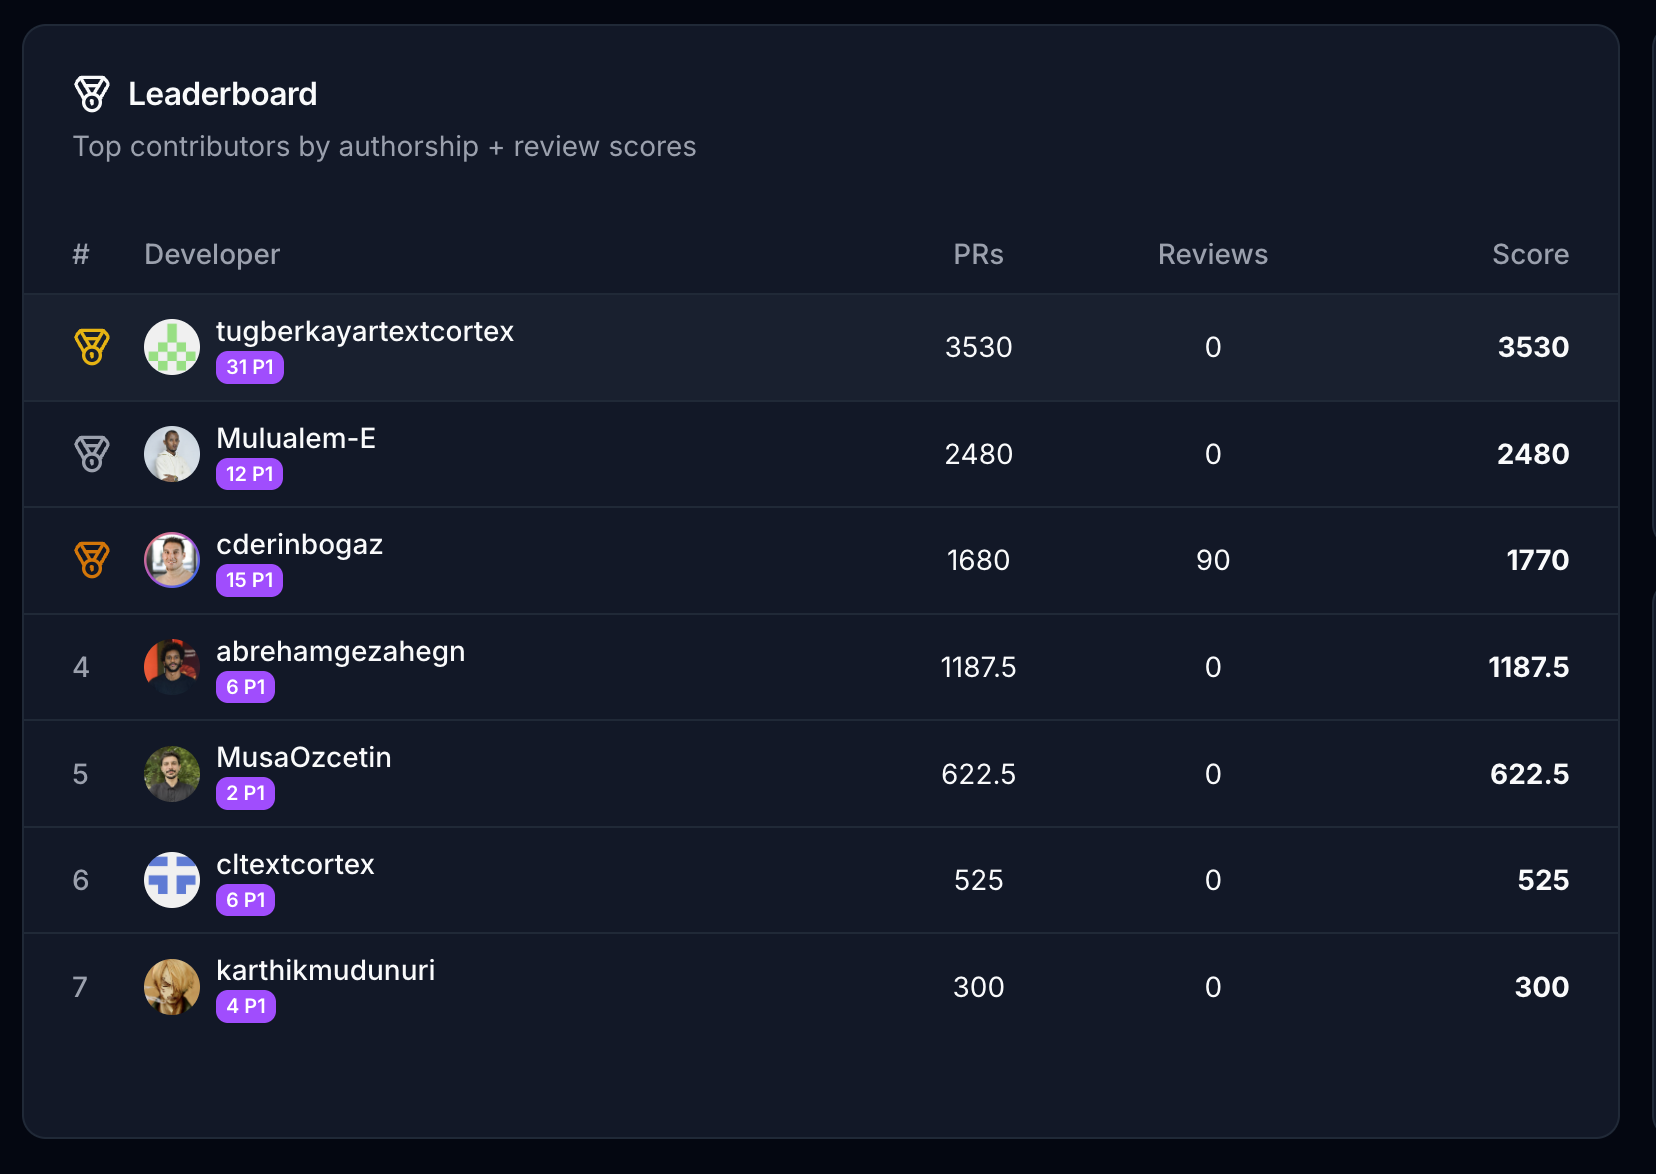
Alors nous les avons connectés. Chaque pull request fusionnée est lue par un modèle, se voit attribuer une sévérité, et est multipliée par l’importance que notre roadmap accorde au composant qu’elle touche. Le résultat est un classement mensuel, et il alimente les décisions de bonus. Voici le nôtre.
La sagesse reçue dit que cela ne peut pas être mesuré, et la sagesse reçue est un haussement d’épaules
La position standard sur la mesure de la production individuelle est qu’il ne faut pas, parce que chaque proxy est un piège. Les lignes de code récompensent le gonflement. Le nombre de commits récompense le découpage. Les tickets fermés récompensent ceux qui attrapent les petits en premier. Les story points sont une négociation menée avant que le travail commence. Même les bons frameworks sont délibérément au niveau de l’équipe : DORA mesure quatre choses sur un pipeline de livraison et ne dit rien sur les personnes, ce que ses auteurs précisent explicitement.
Tout cela est correct, et rien de tout cela n’est une réponse. Le classement a lieu quand même, chaque année, au moment de la rémunération, dans une salle, de mémoire, pondéré par la personne à côté de laquelle le décideur était assis. Refuser de mesurer vous achète un classement sans piste d’audit et sans appel.
Appelons cela la prime à l’ingénieur bruyant : l’écart entre la façon dont vous êtes évalué et la façon dont vous avez performé, expliqué entièrement par votre distance par rapport à celui qui écrit votre évaluation. Demandez à n’importe quel humain de comparer les contributions techniques de quinze personnes sur une année en utilisant uniquement ce qu’il a remarqué par hasard, et voilà ce qui en sort. N’importe lequel d’entre nous produirait cela.
Cette prime était inévitable jusqu’à il y a environ deux ans, parce que la matière première pour une meilleure réponse était une pile de diffs que personne n’avait le temps de lire. Cette contrainte a disparu. Un modèle peut lire chaque diff de votre dépôt chaque mois pour moins que le coût de la réunion où vous devinez actuellement. Les lire est la partie facile. Décider ce que vaut la lecture est tout le problème, et ce n’est pas une question technique.
La formule entière tient sur une ligne
La voici, en entier, depuis le chemin de scoring dans GitRank :
final_score = is_eligible ? severity_base_points × component_multiplier : 0Je ne l’ai pas simplifiée pour le blog. C’est la ligne telle qu’elle s’exécute, sans régression cachée, sans pondération apprise, sans terme de réputation et sans ajustement d’ancienneté. Sévérité fois importance, ou zéro.
La sévérité est une échelle fixe, définie une fois et visible par tous ceux qui sont évalués.
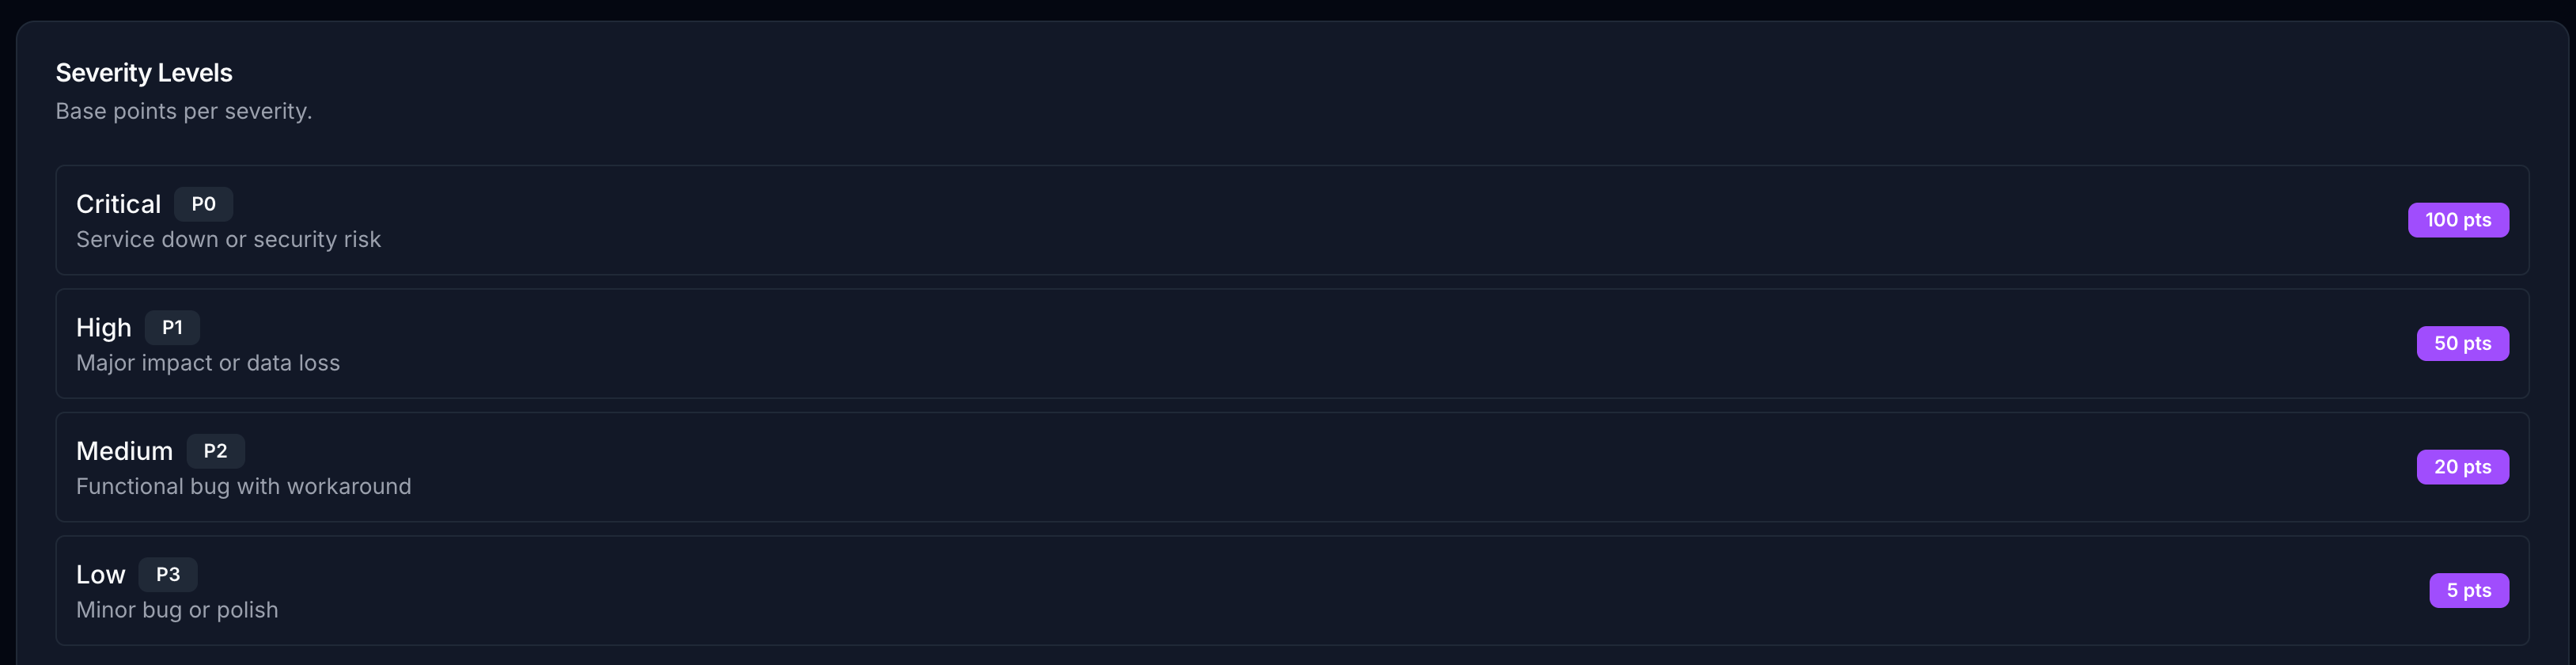
Un correctif critique vaut vingt correctifs à faible priorité. Ce ratio est une déclaration de politique, et nous l’avons écrite au lieu de la laisser dans la tête de quelqu’un.
L’importance est la moitié qui compte. Chaque composant porte un multiplicateur, et le multiplicateur est ce dont le produit a besoin ce trimestre.
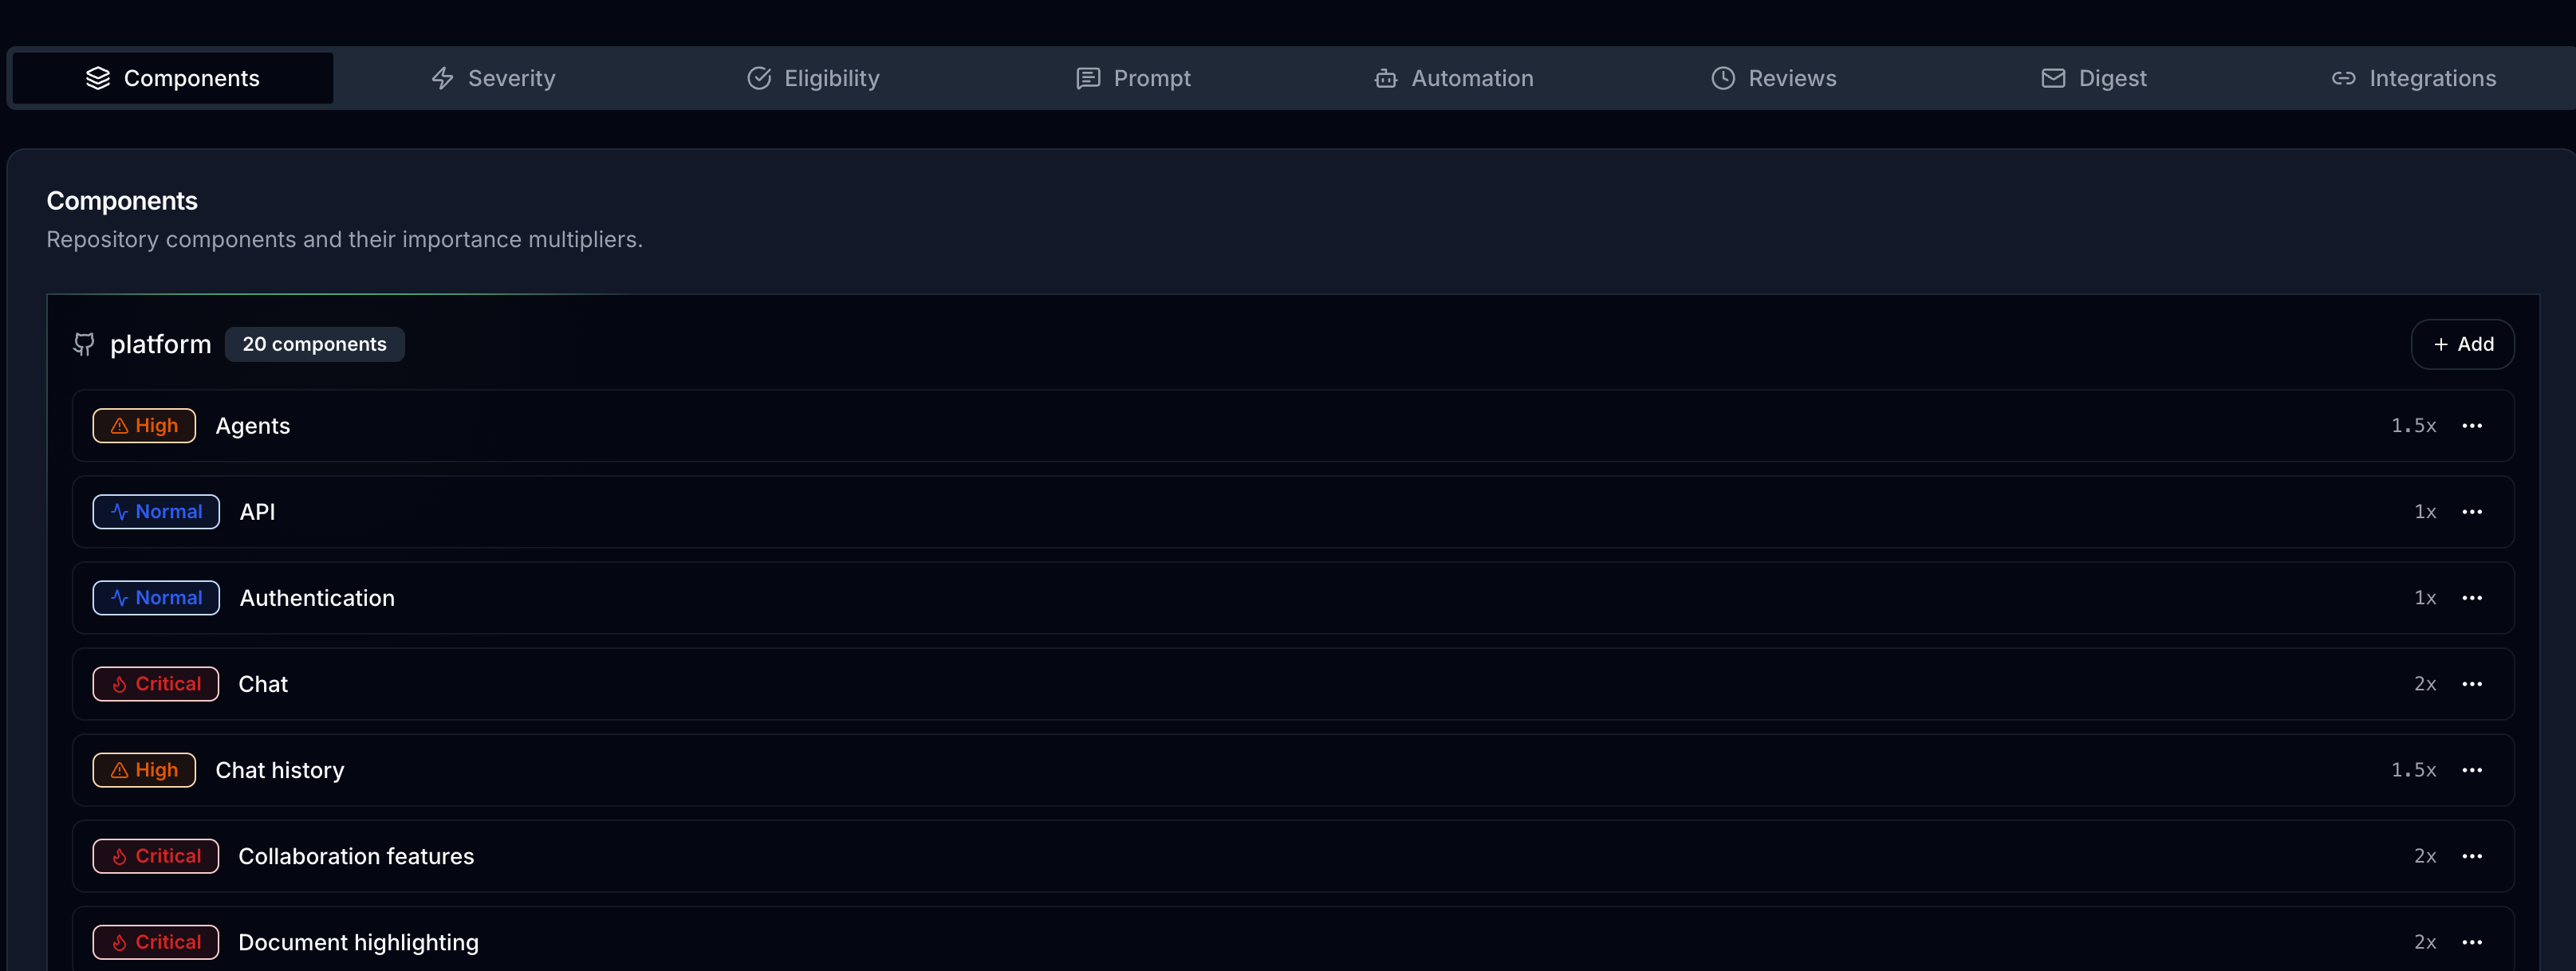
Chat est à 2,0x parce que le chat est ce sur quoi nous misons pour le produit. L’authentification est à 1,0x parce qu’elle fonctionne et que nous aimerions qu’elle continue de fonctionner tranquillement. Ce sont des décisions produit, et la table des multiplicateurs est l’endroit où elles sont retapées dans un champ qui paie.
Le document de stratégie et l’entrée de rémunération sont devenus le même document. C’est ça, le geste. Le modèle est de la plomberie et le classement en est un rendu, et si la roadmap change en octobre, alors l’incitation change en octobre, plutôt qu’à un cycle d’évaluation quatorze mois plus tard.
Laissez-moi expliciter cela, parce que c’est la partie que les gens sautent. Quarante personnes intelligentes, chacune optimisant localement et honnêtement, produiront un trimestre de travail qui ne s’additionne pas pour donner la chose que l’entreprise a dit vouloir. Personne dans ce tableau n’est paresseux, et c’est ce qui rend la chose difficile. Le middle management existe en grande partie pour y remédier, transportant la stratégie dans des conversations, un bureau à la fois, perdant de la fidélité à chaque saut. Une table de multiplicateurs fait le même routage en un seul saut, et en octobre elle dit toujours exactement ce que vous y avez tapé en janvier.
Joi Ito avait déjà nommé la différence. L’un des neuf principes de Whiplash, écrit avec Jeff Howe en 2016, est pull over push : vous tirez du réseau ce dont vous avez besoin plutôt que de tout garder en stock. Ito décrivait les ressources. La direction se comporte de la même façon. Une organisation en mode push stocke la stratégie dans une couche de management et la distribue au fil des conversations, ce qui fait qu’elle atteint la périphérie de l’entreprise tardivement et avec pertes. Une organisation en mode pull publie la stratégie comme une liste de prix et laisse les gens y prendre ce dont ils ont besoin. La table des multiplicateurs est cette liste de prix.
Un correctif critique dans le chat vaut quarante commits de polish dans l’API
Faites tourner les deux moitiés ensemble et l’écart est sévère. Un P0 dans le chat vaut 100 de base fois 2,0, soit 200 points. Un P3 dans l’API vaut 5. Quarante contre un, c’est l’écart entre la pull request la plus précieuse que vous puissiez merger ici et la moins précieuse.
Ce ratio est volontairement violent, et il fait ce que les incitations douces n’arrivent jamais à faire. Personne ne réorganise sa semaine autour d’une différence de 15 %. Les gens réorganisent absolument leur semaine autour d’un écart de 40x.
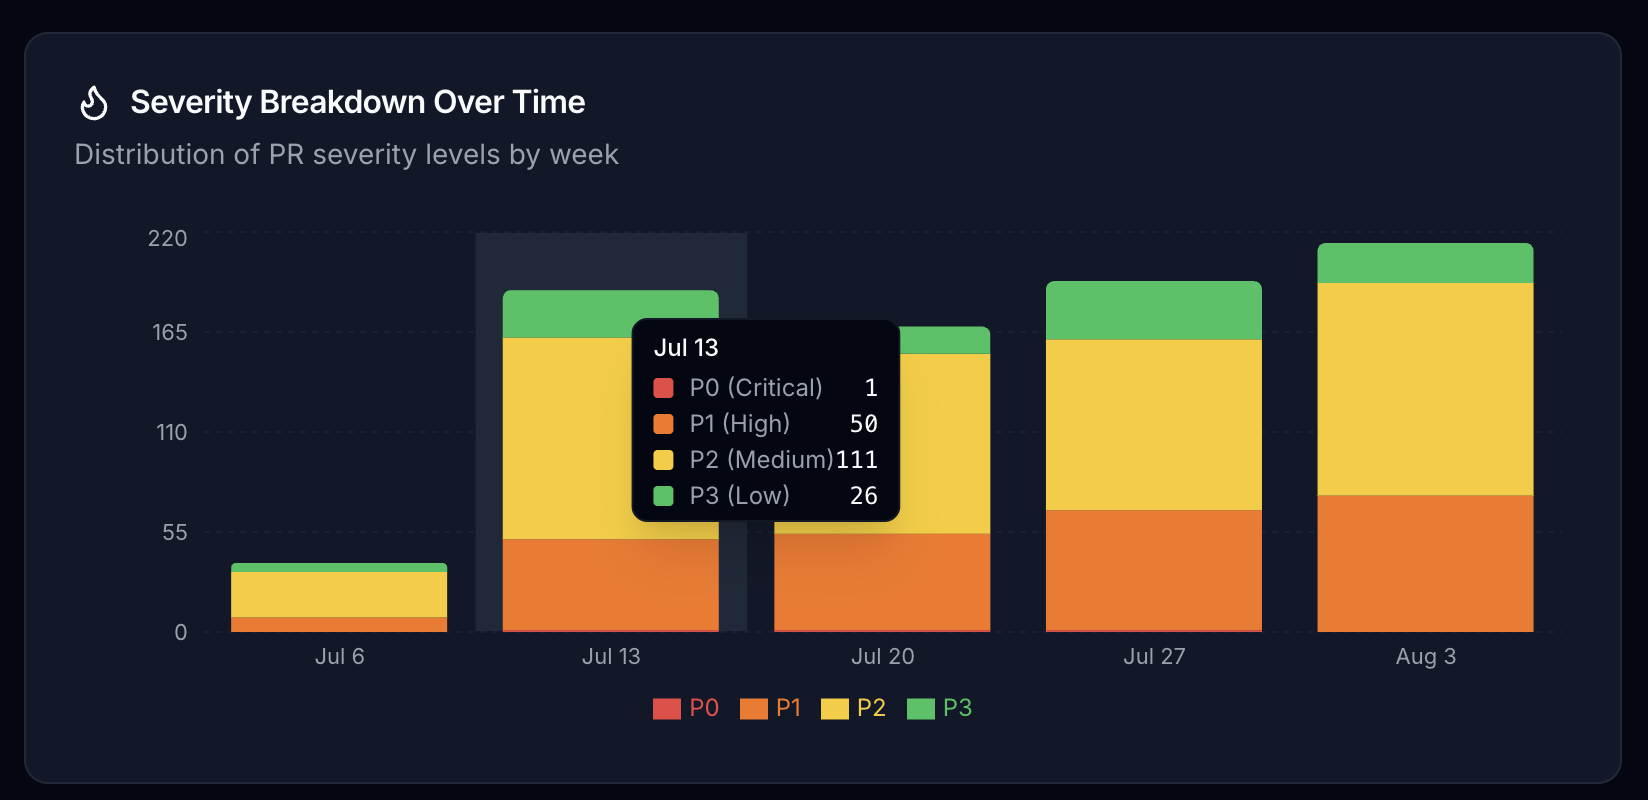
188 pull requests en une seule semaine. Les P2 en représentent 59 %, c’est à quoi ressemble une semaine d’ingénierie normale partout. Maintenant, pondérez. Ces 111 P2 valent 2 220 points. Les 50 P1 valent 2 500. Moins de la moitié du nombre de pull requests porte plus de la moitié de la valeur de la semaine. Comptez les pull requests et vous concluez que la semaine tournait autour des P2. Pondérez-les et la semaine tournait autour de cinquante travaux précis, et vous pouvez nommer qui les a faits.
Deux personnes représentaient 58 % de la production, et j’avais l’ordre faux
Sept développeurs, 10 415 points. Le meilleur développeur en détient 3 530, 33,9 % de tout ce que l’équipe a produit en valeur. Les deux premiers détiennent 57,7 % à eux deux.
Une concentration comme celle-là signifie généralement que les deux premiers travaillent sur les composants au multiplicateur le plus élevé, ce qui est exactement ce que nous leur avons demandé de faire. Le chiffre décrit où la valeur atterrit, et je n’en tirerais aucune conclusion sur les cinq autres.
C’est l’ordre qui a cassé ma prédiction.
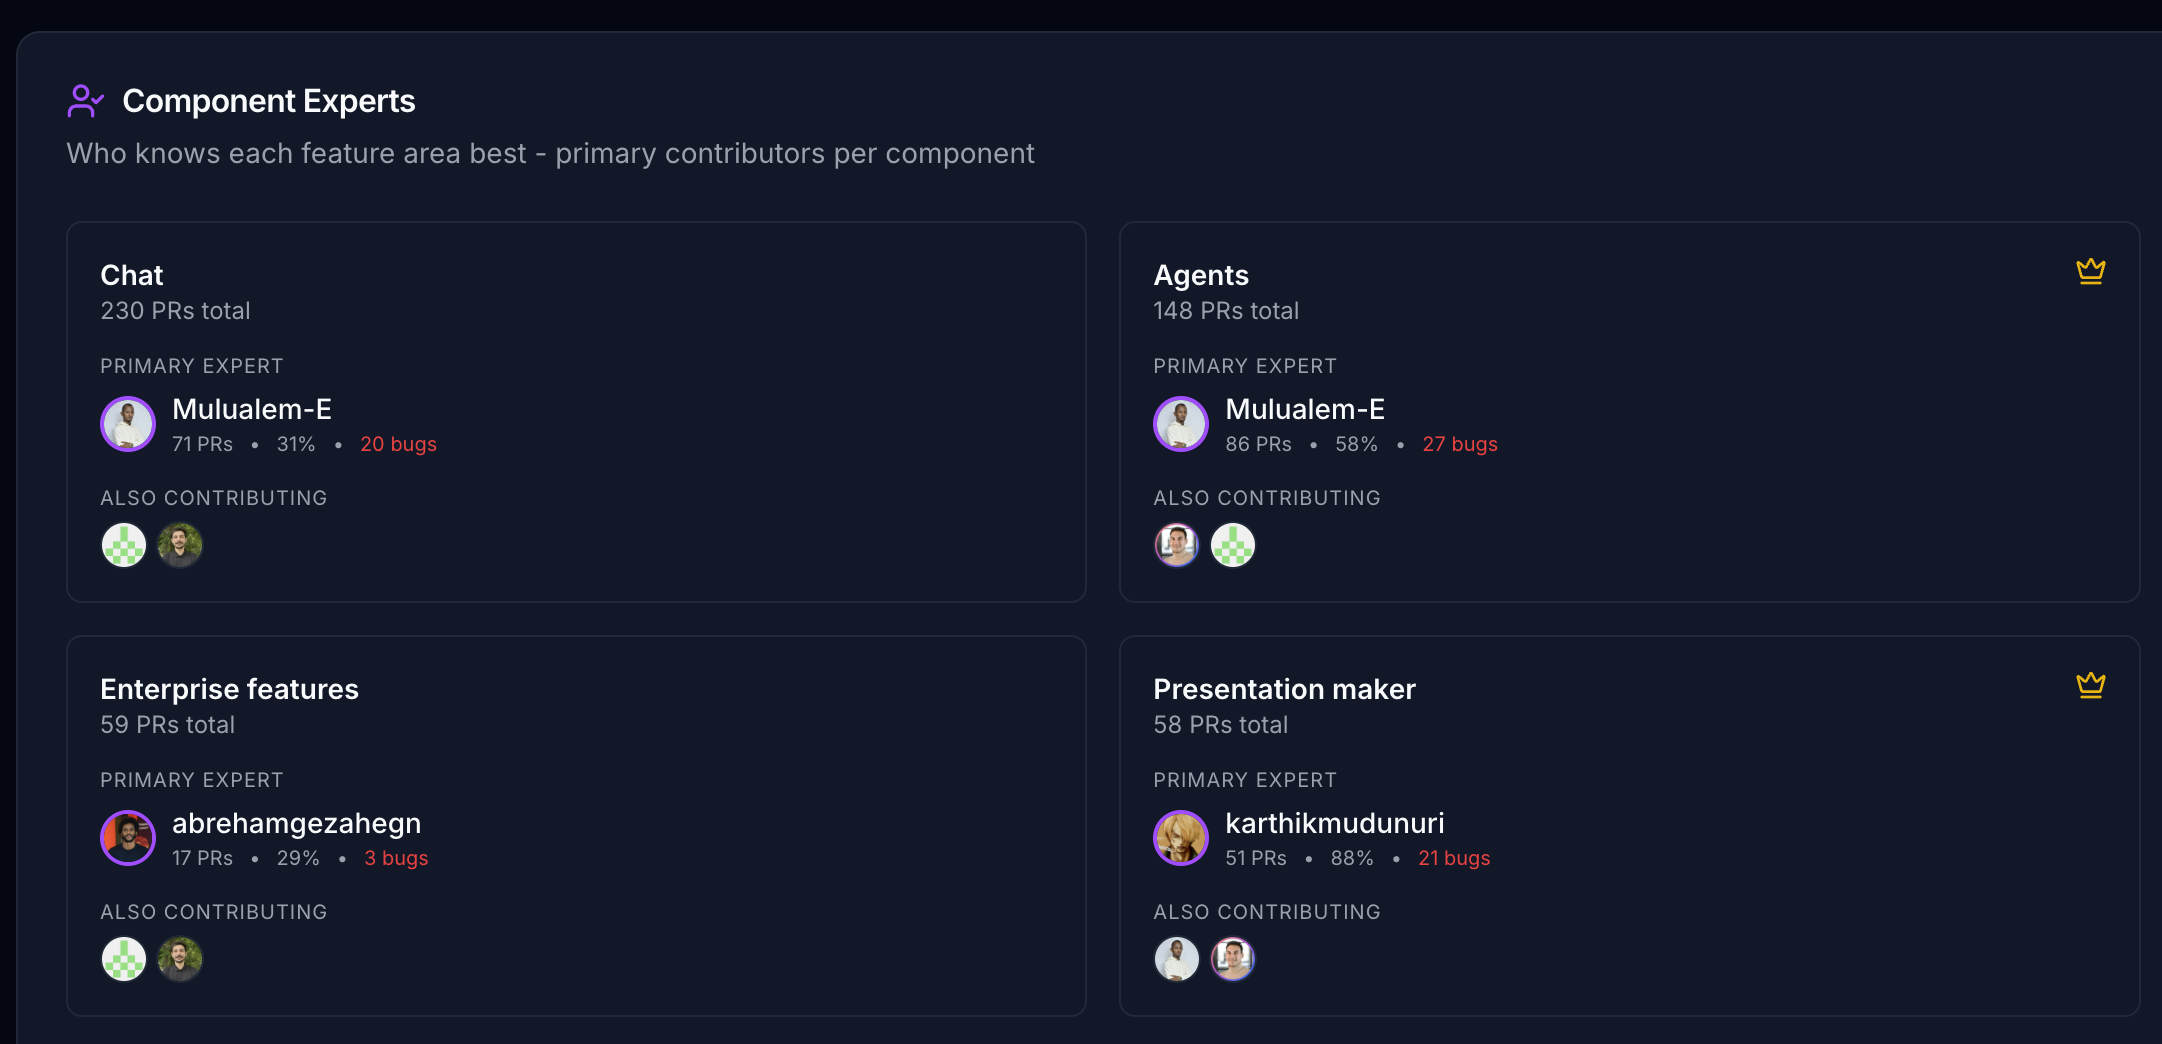
Mulualem-E est l’expert principal sur le chat, notre composant à 2,0x, avec 71 de ses 230 pull requests, et sur les agents, notre composant à 1,5x, avec 86 sur 148. Si vous m’aviez décrit ça et demandé qui domine le classement, je l’aurais nommé sans hésiter. Il est deuxième. La première place revient à tugberkayartextcortex, avec 31 pull requests P1 contre 12 pour Mulualem-E.
Le mélange de sévérité a battu la propriété des composants. Posséder la zone la plus importante du produit s’avère ne pas être la même chose que de livrer régulièrement des travaux à fort impact à l’intérieur, et jusqu’à ce que nous publiions ça, je n’aurais pas pu vous dire lequel des deux notre rémunération récompensait. Elle récompensait celui que j’avais remarqué par hasard. C’est la prime à l’ingénieur bruyant, prise en flagrant délit dans ma propre entreprise. Mon intuition avait les deux bonnes personnes et le mauvais ordre, et le mauvais ordre, c’est ce qu’est un bonus.
Payments est à 45 % de corrections de bugs et personne n’a eu à en débattre
Noter chaque pull request met aussi fin à l’habitude de débattre de la qualité à partir d’anecdotes.
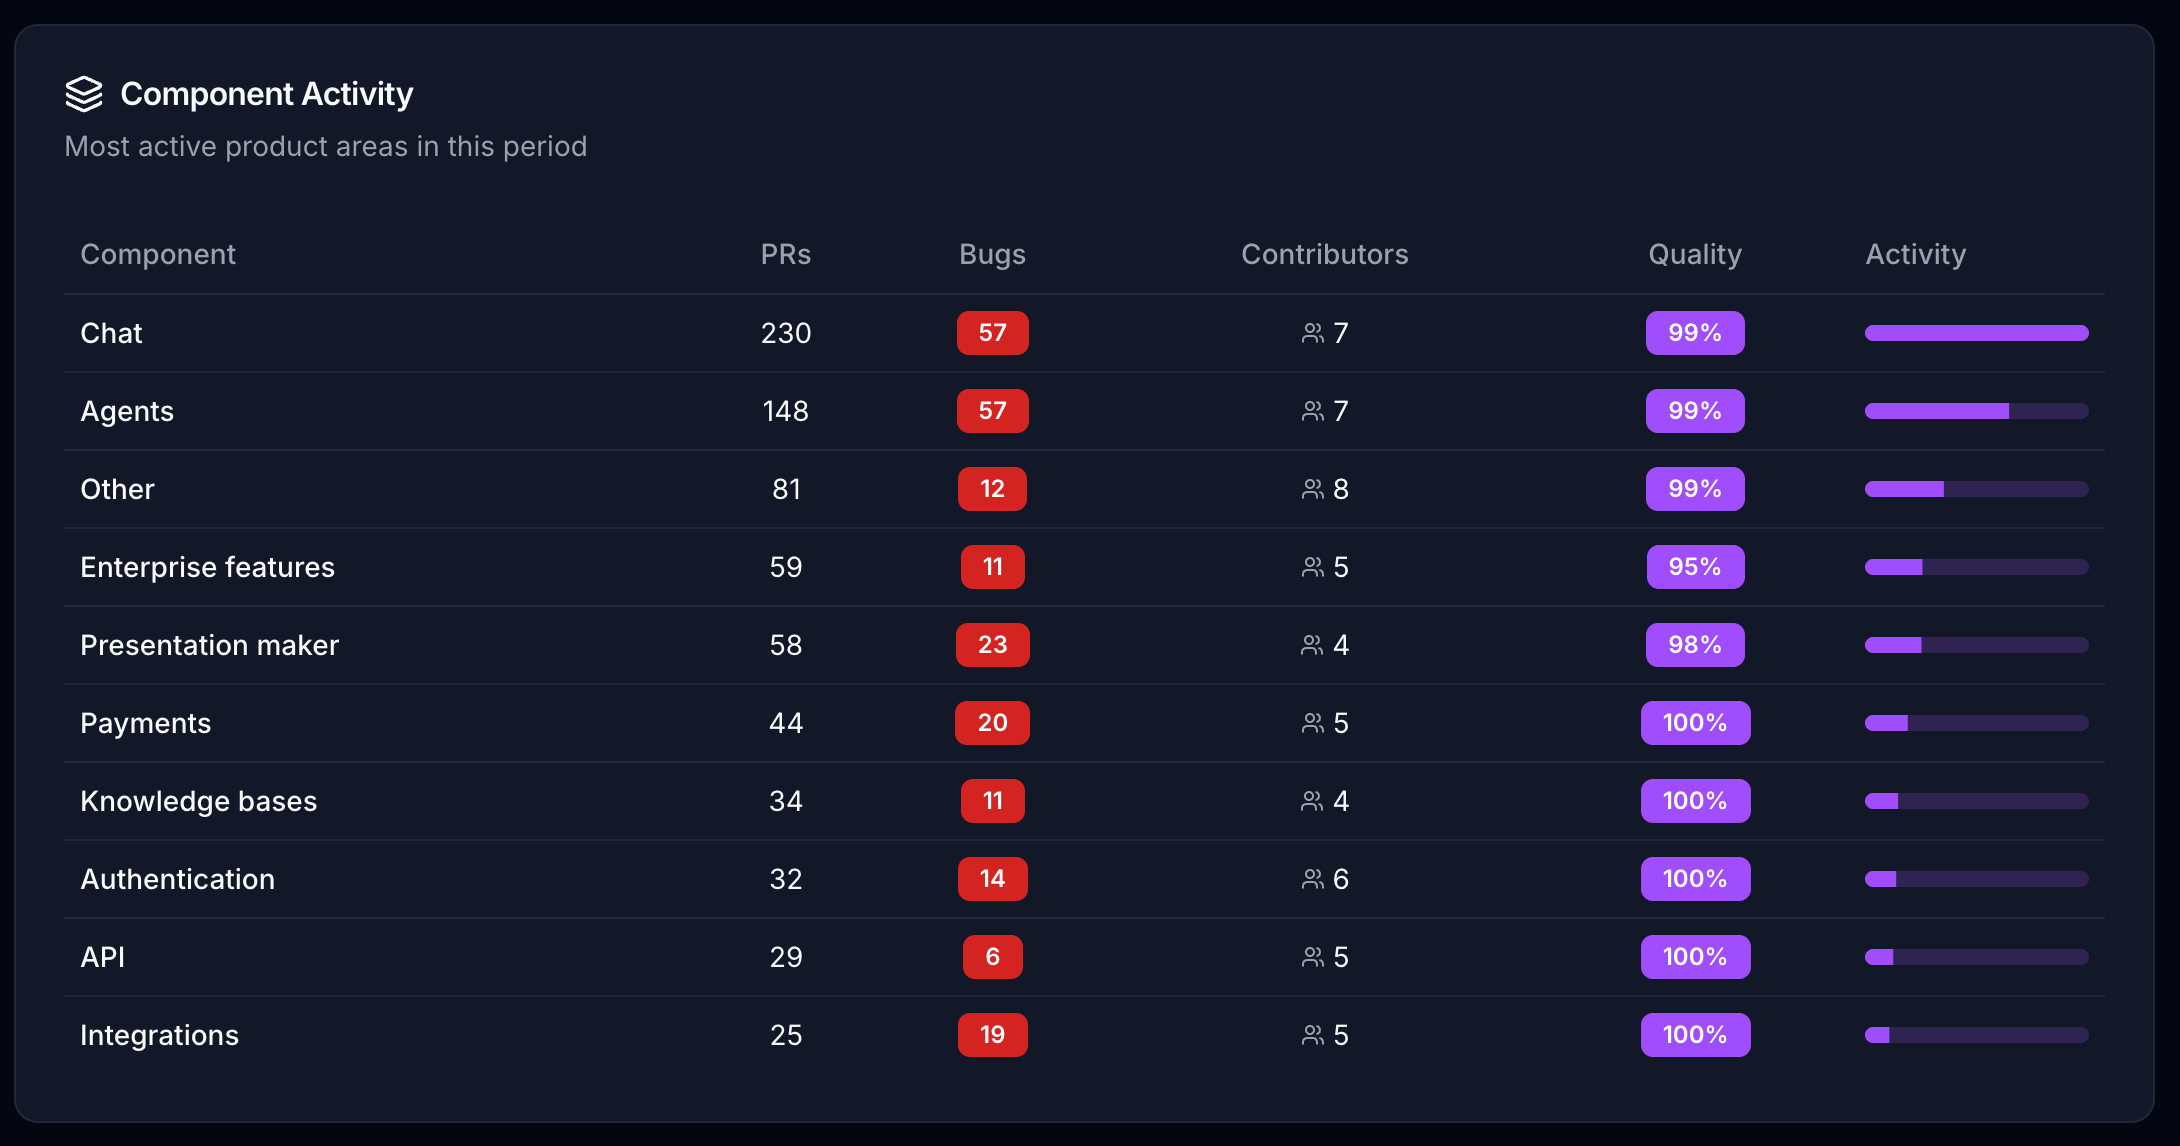
740 pull requests sur les dix composants les plus actifs, dont 230 corrections de bugs plutôt que du nouveau travail. Le chat à lui seul représente 230 pull requests, c’est à ça qu’un multiplicateur 2,0x ressemble quand il fonctionne. Ensuite, les paiements : 44 pull requests, 20 bugs, un taux de bugs de 45 % dans le composant qui touche à l’argent.
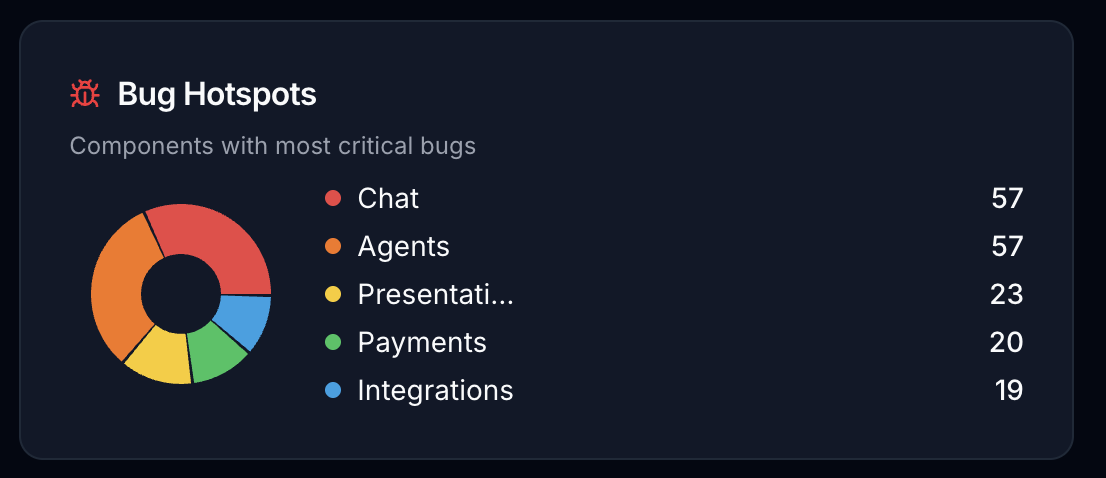
Chat et agents sont à égalité à 57 bugs chacun, mais le chat les a produits sur 230 pull requests et les agents sur 148. Même nombre de bugs, 55 % de travail en plus derrière l’un d’eux. C’est un signal sur les agents qu’aucune rétrospective n’allait faire remonter, parce que personne n’avait fusionné assez des deux pour le remarquer.
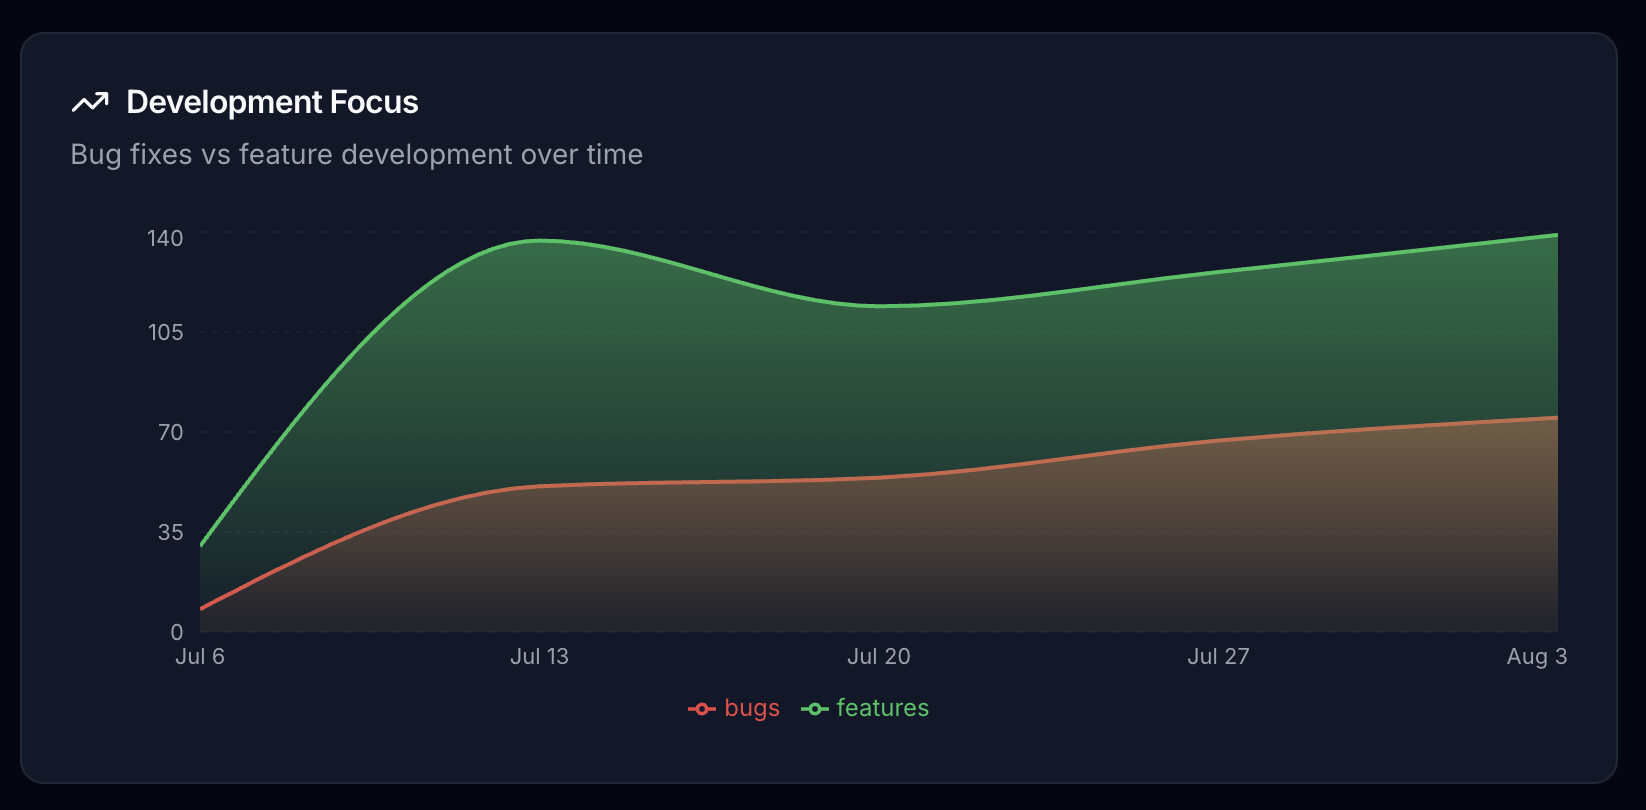
Les bugs et les fonctionnalités montent ensemble plutôt que de se compenser. Cinq semaines, c’est bien dans le bruit qu’un seul gros projet livré produirait, alors considérez ce graphique comme une description de la période et rien de plus.
Je n’ai pas de chiffre de progression, et vous ne devriez faire confiance à personne qui en ait un
Voici l’affirmation que je veux faire. Depuis que nous publions ce mensuel, le travail s’est déplacé vers les composants que nous avions marqués comme importants, parce que les ingénieurs veulent le score.
Je ne mets pas de pourcentage dessus. Nous avons activé ça en cours de route. Il n’y avait pas de référence ni de dépôt témoin, et nous n’avons jamais convenu à l’avance de ce que « déplacé » voudrait dire. Les multiplicateurs ont bougé pendant la période. L’effectif aussi. Tout chiffre que je publierais serait un chiffre que j’aurais choisi après avoir vu les données, ce qui en fait de la décoration.
Ce qui a changé, c’est l’argument. Les gens ont arrêté de demander si leur travail était apprécié et ont commencé à demander pourquoi un composant était noté 1,0x. C’est une meilleure bataille à mener, et c’est la seule chose pour laquelle j’aurais payé à elle seule.
Notre propre outil n’est pas propre non plus, et l’arête la plus tranchante est celle-ci : une pull request qui obtient zéro ne vous dit pas quel critère d’éligibilité s’est refermé dessus. Ratez le lien vers l’issue ou les tests et le score est zéro, quelle que soit la sévérité, et la personne qui a le plus à contester se retrouve avec le moins d’éléments pour contester. Nous corrigeons ça avant tout le reste de la liste.
Pointez-le vers la roadmap, puis donnez la règle aux gens
Dépouillez un organigramme de son autorité et ce qui reste en dessous est une table de routage. Elle transporte « ce qui compte ce trimestre » vers l’extérieur, depuis les personnes qui l’ont décidé, et « qui a fait quoi » vers l’intérieur, et elle fait les deux lentement, avec de la distorsion à chaque saut. Tout ce que vous n’aimez pas dans la politique d’entreprise est un artefact de compression de ce routage. Les managers ont été le seul matériel disponible pour ce travail.
Ils ne sont plus le seul matériel disponible, maintenant. Un modèle qui lit chaque diff, plus une table de multiplicateurs, fait le routage vers l’extérieur en un saut et le routage vers l’intérieur en une requête. C’est ça, l’organisation pull, et je veux être précis sur ses limites. Rien n’est aplati. La direction fixe toujours les multiplicateurs, donc la stratégie est toujours décidée dans une pièce par quelques personnes, et tout ce qui change, c’est le trajet hors de cette pièce. Ce qui reste pour les humains, c’est la partie qui a toujours été le travail et qui n’a jamais eu le temps : décider ce que devraient être les multiplicateurs, et rester avec les personnes que ces décisions ont déplacées.
La politique ne disparaît pas. Elle se déplace. Elle passe de « est-ce que mon manager se souvient de mon trimestre » à « pourquoi mon composant est noté 1,0x alors que la roadmap le qualifie de core », et cette deuxième bataille porte sur la stratégie réelle de l’entreprise, menée en public, dans une table que tout le monde peut lire. Je préfère avoir cette bataille chaque mois plutôt que celle actuelle, tenue une fois par an, en privé, par quelqu’un qui reconstruit onze mois de mémoire.
Quelqu’un va mal gérer ça. Quelqu’un va mettre un tableau de scores sur un mur, sans explications d’éligibilité et sans trace d’override, et virer le décile inférieur, et ce sera imputé au modèle plutôt qu’à la personne qui a choisi les multiplicateurs.
Alors mesurez-moi avec le même instrument. Si vous mettez en place quelque chose comme ça, publiez la table des multiplicateurs, pour que les gens contestent la stratégie plutôt que le score. Publiez la ventilation par pull request, pour que quiconque a obtenu zéro puisse voir quelle porte s’est refermée sur lui et faire appel. Publiez le journal des overrides, parce qu’un nombre qu’un humain a modifié à la main est le seul nombre qui vaille la peine d’être audité. Nous publions le premier. Nous faisons le troisième mal. Nous ne publions pas le deuxième du tout, et c’est celui-là qui décide si une chose comme ça est un outil de gestion ou juste une façon plus rapide d’être injuste.
GitRank est sur gitrank.dev et est sous licence CC BY-NC 4.0. La notation sur le chemin de production tourne sur Claude Haiku 4.5 à température 0,3. Tous les chiffres ci-dessus proviennent de notre propre dépôt de plateforme entre le 6 juillet et le 3 août 2026, taille d’échantillon : une entreprise et sept développeurs, ce qui est une description de nous et non un benchmark de quoi que ce soit.