Maschinell übersetzt. Zum englischen Original: Your performance review is a memory test →
Frag jeden Engineering-Manager, wer sein bester Engineer ist. Die Antwort kommt, bevor du die Frage zu Ende gestellt hast, ohne Zögern und ohne »lass mich kurz etwas nachschauen«. Er weiß es. Er hat es immer gewusst.
Jetzt bittest du ihn, die Arbeit zu zeigen.
Du bekommst eine Geschichte. Meistens eine gute, über einen Vorfall, den jemand um 2 Uhr nachts behandelt hat, oder ein Refactoring, das ein Quartal freigeräumt hat. Was du nicht bekommst, ist eine Zahl, ein Vergleich oder irgendein Bericht über die vier Engineers, bei deren Arbeit der Manager nicht im Raum war. Diese Sicherheit entsteht aus Erinnerung, und Erinnerung ist eine Funktion der Nähe.
Hier ist die These. Engineering-Performance wird aus dem Gedächtnis heraus bewertet, das Gedächtnis belohnt Sichtbarkeit statt Wert, und die Arbeit, die du eigentlich von Leuten willst, steht in einer Roadmap, die nie mit dem verbunden ist, wofür du sie bewertest. Diese beiden Dokumente haben bei fast jedem Unternehmen, das ich gesehen habe, nichts miteinander zu tun, auch bei meinem nicht.
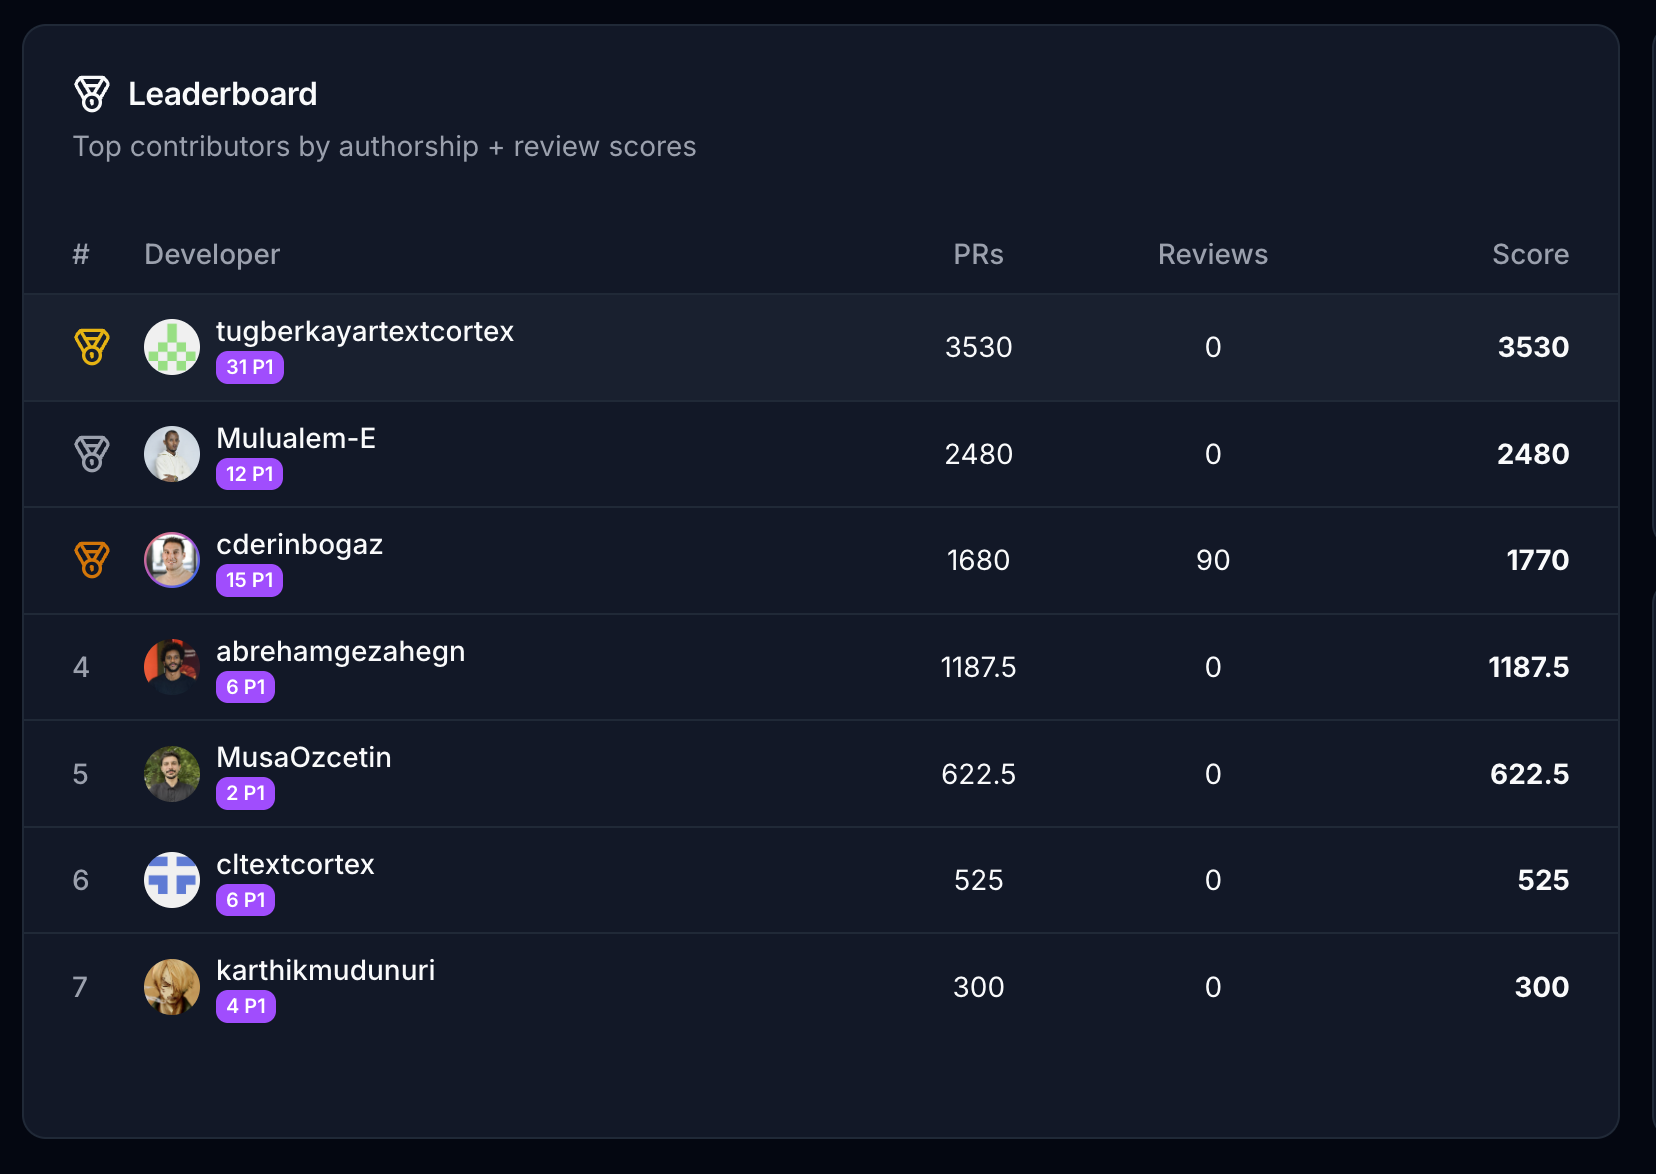
Also haben wir sie verbunden. Jeder gemergte Pull Request wird von einem Modell gelesen, bekommt einen Schweregrad zugewiesen und wird damit multipliziert, wie sehr unsere Roadmap die Komponente gewichtet, die er berührt hat. Das Ergebnis ist ein monatliches Leaderboard, und es speist Bonusentscheidungen. Hier ist unseres.
Die gängige Weisheit sagt, das lässt sich nicht messen, und die gängige Weisheit ist ein Achselzucken
Die Standardposition zur Messung individueller Leistung ist: Du darfst es nicht, weil jeder Proxy eine Falle ist. Lines of Code belohnen Aufblähung. Die Anzahl der Commits belohnt Splitting. Geschlossene Tickets belohnen den, der sich zuerst die kleinen schnappt. Story Points sind eine Verhandlung, die vor Arbeitsbeginn geführt wird. Selbst die guten Frameworks sind bewusst auf Team-Ebene angesiedelt: DORA misst vier Dinge an einer Delivery-Pipeline und sagt nichts über Menschen, und die Autoren sagen das ausdrücklich.
Das alles ist richtig, und nichts davon ist eine Antwort. Das Ranking passiert trotzdem, jedes Jahr, zur Vergütungszeit, in einem Raum, aus dem Gedächtnis, gewichtet danach, neben wem die Person in diesem Raum saß. Sich zu weigern zu messen, kauft dir ein Ranking ohne Audit-Trail und ohne Einspruchsmöglichkeit.
Nenn es die Loud-Engineer-Prämie: die Lücke zwischen deiner Bewertung und deiner tatsächlichen Leistung, vollständig erklärt durch deine Distanz zu dem, der dein Review schreibt. Bitte irgendeinen Menschen, die technischen Beiträge von fünfzehn Leuten über ein Jahr zu vergleichen, nur mit dem, was ihm zufällig aufgefallen ist, und genau das kommt dabei heraus. Jeder von uns würde das produzieren.
Diese Prämie war bis vor etwa zwei Jahren unvermeidbar, weil das Rohmaterial für eine bessere Antwort ein Haufen Diffs war, den niemand Zeit hatte zu lesen. Diese Einschränkung ist weg. Ein Modell kann jeden Diff in deinem Repository jeden Monat lesen, für weniger als die Kosten des Meetings, in dem du gerade rätst. Sie zu lesen ist der einfache Teil. Zu entscheiden, was das Gelesene wert ist, ist das eigentliche Problem, und das ist keine technische Frage.
Die gesamte Formel passt in eine Zeile
Hier ist sie, vollständig, aus dem Scoring-Pfad in GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0Ich habe das für den Blog nicht vereinfacht. Es ist die Zeile, wie sie läuft, ohne versteckte Regression, ohne gelernte Gewichtung, ohne Reputations-Term und ohne Anpassung für Betriebszugehörigkeit. Schweregrad mal Wichtigkeit, oder null.
Der Schweregrad ist eine feste Leiter, einmal festgelegt und für alle sichtbar, die bewertet werden.
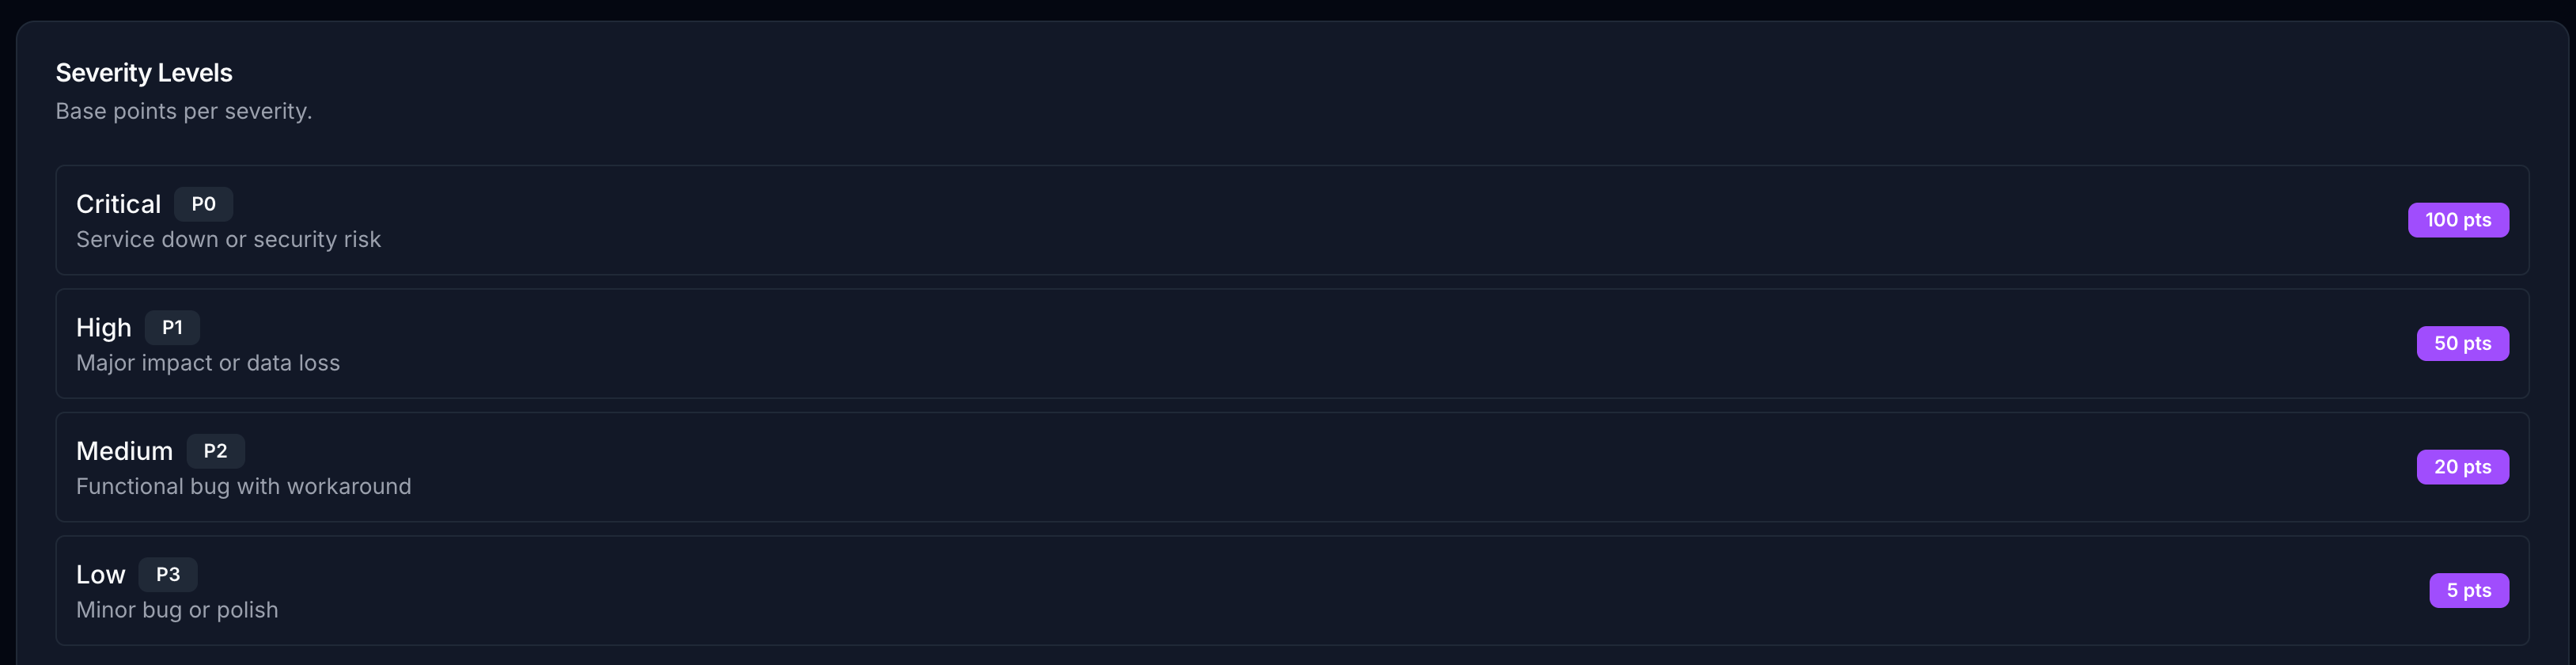
Ein kritischer Fix ist zwanzig mit niedriger Priorität wert. Dieses Verhältnis ist eine Policy-Aussage, und wir haben sie aufgeschrieben, statt sie in jemandes Kopf zu lassen.
Wichtigkeit ist die Hälfte, die zählt. Jede Komponente trägt einen Multiplikator, und der Multiplikator ist das, was das Produkt in diesem Quartal braucht.
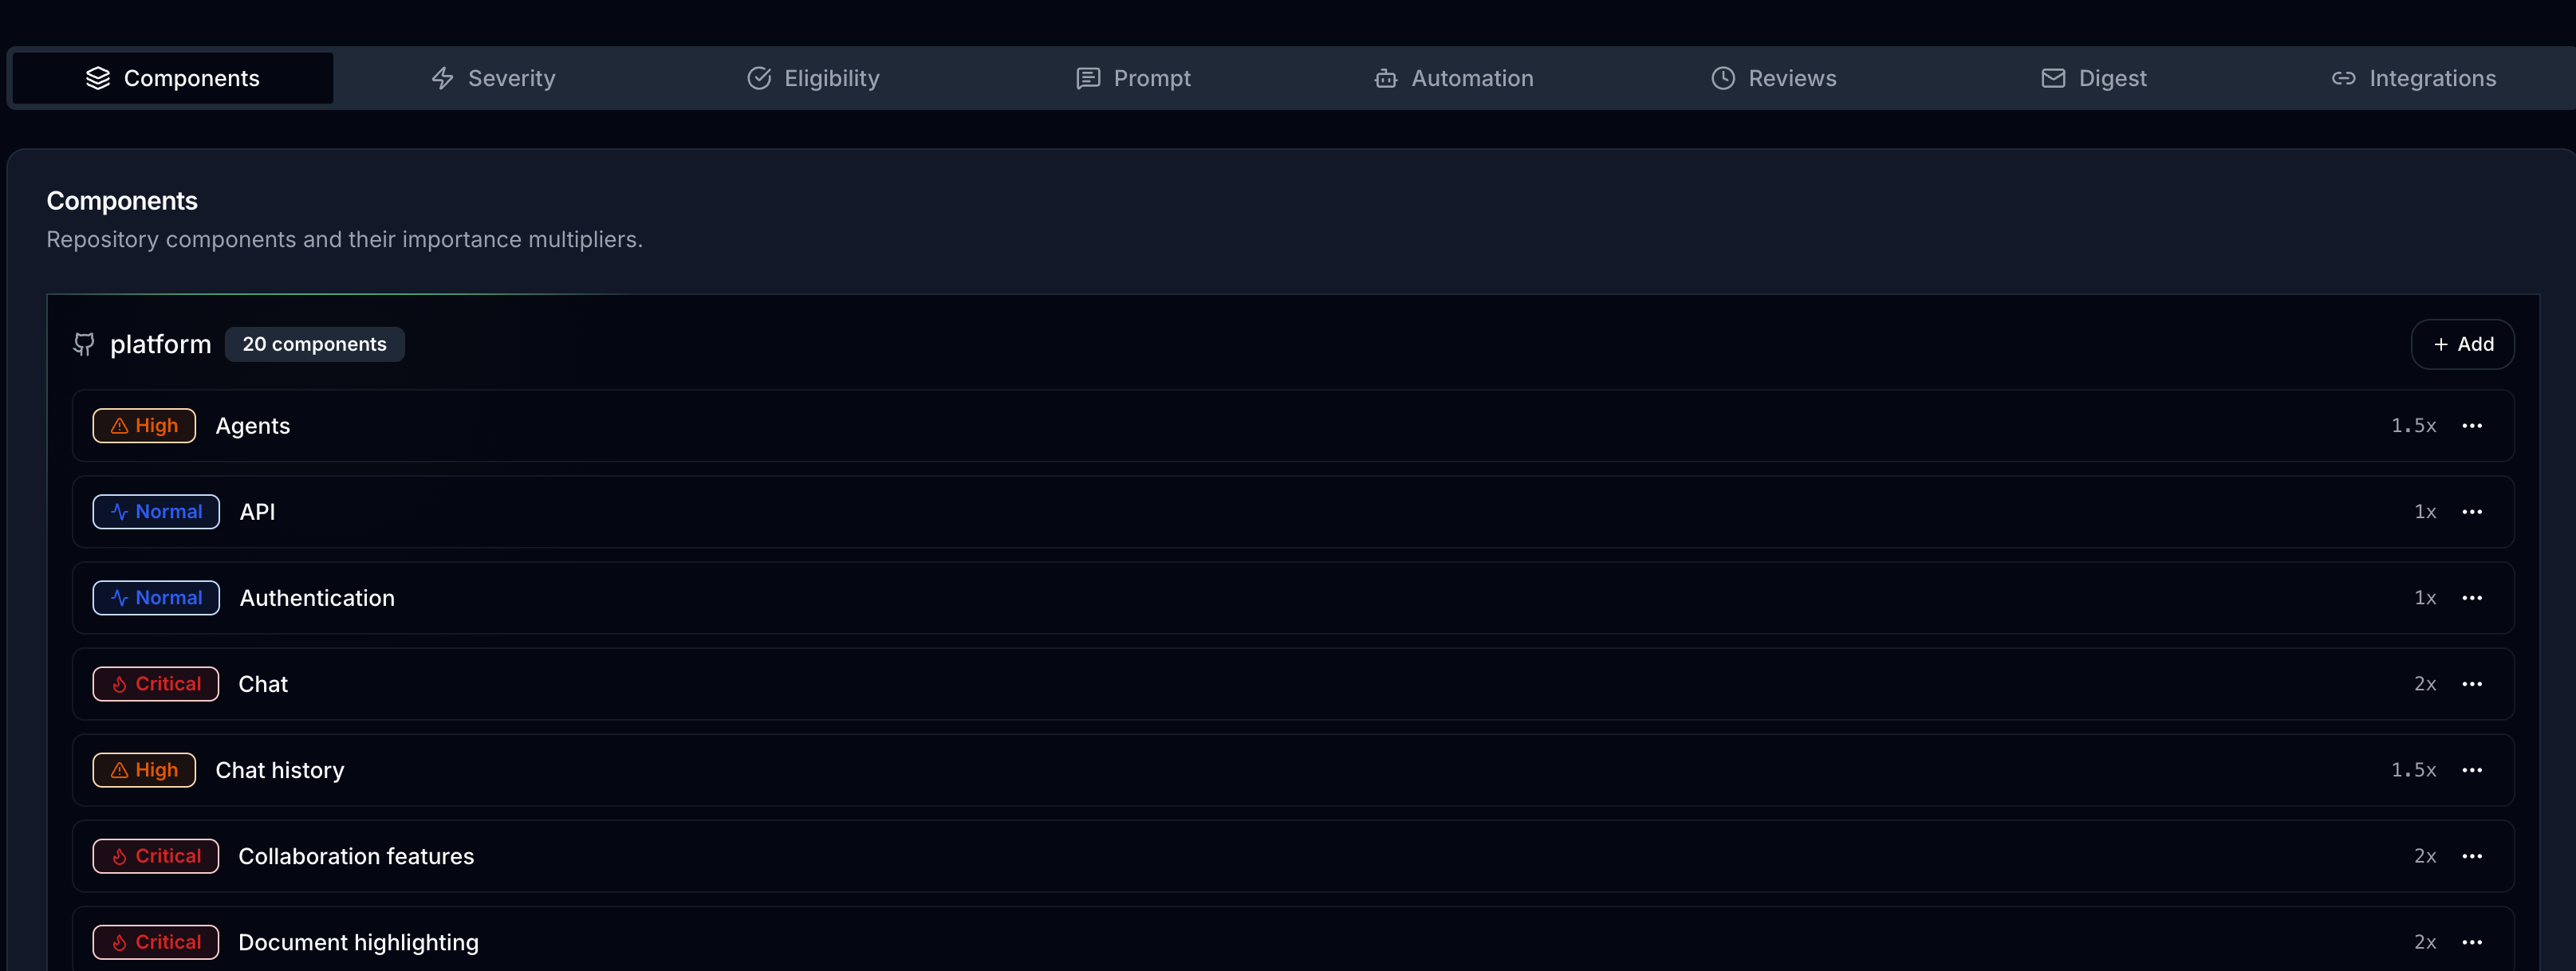
Chat ist 2,0x, weil Chat das ist, worauf wir das Produkt setzen. Authentication ist 1,0x, weil es funktioniert und wir möchten, dass es ruhig weiter funktioniert. Das sind Produktentscheidungen, und die Multiplikator-Tabelle ist der Ort, wo sie in ein Feld getippt werden, das auszahlt.
Das Strategiedokument und der Input für die Vergütung wurden dasselbe Dokument. Das ist der entscheidende Schritt. Das Modell ist die Infrastruktur und das Leaderboard ist eine Darstellung davon, und wenn sich die Roadmap im Oktober ändert, dann ändert sich der Anreiz im Oktober, statt in einem Review-Zyklus vierzehn Monate später.
Lass mich das ausbuchstabieren, weil das der Teil ist, den Leute überspringen. Vierzig kluge Leute, die jeweils lokal und ehrlich optimieren, produzieren ein Quartal Arbeit, das sich nicht zu dem summiert, was das Unternehmen wollte. Niemand in diesem Bild ist faul, und genau das macht es schwer. Middle Management existiert hauptsächlich, um das zu beheben, trägt Strategie in Gesprächen von Schreibtisch zu Schreibtisch und verliert bei jedem Hop an Genauigkeit. Eine Multiplikator-Tabelle macht dasselbe Routing in einem Hop, und im Oktober sagt sie immer noch genau das, was du im Januar hineingetippt hast.
Joi Ito hat den Unterschied bereits benannt. Eines der neun Prinzipien in Whiplash, geschrieben mit Jeff Howe im Jahr 2016, ist Pull statt Push: Man zieht sich aus dem Netzwerk, was man braucht, anstatt alles auf Vorrat zu halten. Ito beschrieb Ressourcen. Richtung verhält sich genauso. Eine Push-Organisation hortet die Strategie in einer Management-Ebene und gibt sie in Gesprächen weiter, weshalb sie spät und verlustbehaftet an den Rand des Unternehmens gelangt. Eine Pull-Organisation veröffentlicht die Strategie als Preisliste und lässt die Leute sich daraus nehmen, was sie brauchen. Die Multiplikatorentabelle ist die Preisliste.
Ein kritischer Fix im Chat ist vierzig Polier-Commits in der API wert
Wenn man die beiden Teile zusammenführt, ist die Spreizung gravierend. Ein P0 im Chat ergibt 100 Basis mal 2,0, also 200 Punkte. Ein P3 in der API ergibt 5. Vierzig zu eins – das ist die Kluft zwischen dem wertvollsten Pull Request, den man hier mergen kann, und dem geringsten.
Dieses Verhältnis ist bewusst drastisch und bewirkt, was sanfte Anreize nie schaffen. Niemand organisiert seine Woche neu wegen eines 15%-Unterschieds. Aber wegen eines 40-fachen Unterschieds organisiert man seine Woche definitiv neu.
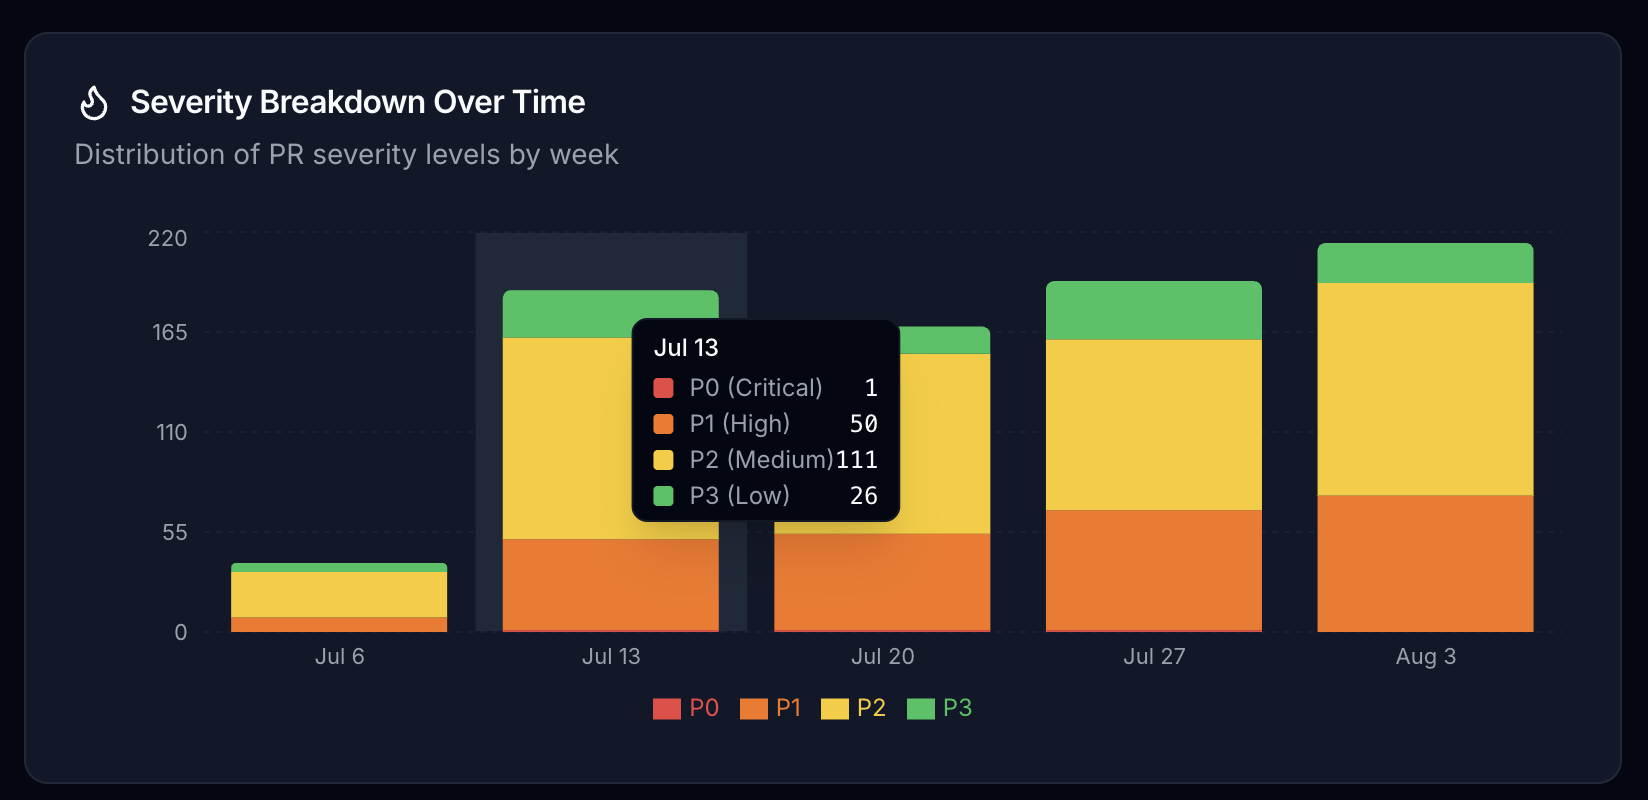
188 Pull Requests in einer einzigen Woche. P2 macht 59% davon aus, so sieht eine normale Engineering-Woche überall aus. Nun gewichten wir das. Diese 111 P2s sind 2.220 Punkte wert. Die 50 P1s sind 2.500 wert. Weniger als halb so viele Pull Requests tragen mehr als die Hälfte des Wochenwerts. Zählt man Pull Requests, kommt man zu dem Schluss, dass die Woche von P2s geprägt war. Gewichtet man sie, war die Woche von fünfzig bestimmten Arbeitspaketen geprägt, und man kann benennen, wer sie gemacht hat.
Zwei Personen erbrachten 58% der Leistung, und ich hatte die Reihenfolge falsch
Sieben Entwickler, 10.415 Punkte. Der beste Entwickler hält 3.530 davon, 33,9% von allem, was das Team wertmäßig produziert hat. Die besten zwei halten zusammen 57,7%.
Eine solche Konzentration bedeutet normalerweise, dass die besten zwei an den Komponenten mit dem höchsten Multiplikator arbeiten, genau das haben wir sie gebeten zu tun. Die Zahl beschreibt, wo der Wert ankommt, und ich würde nichts über die anderen fünf hineininterpretieren.
Die Reihenfolge ist das, was meine Vorhersage zunichte machte.
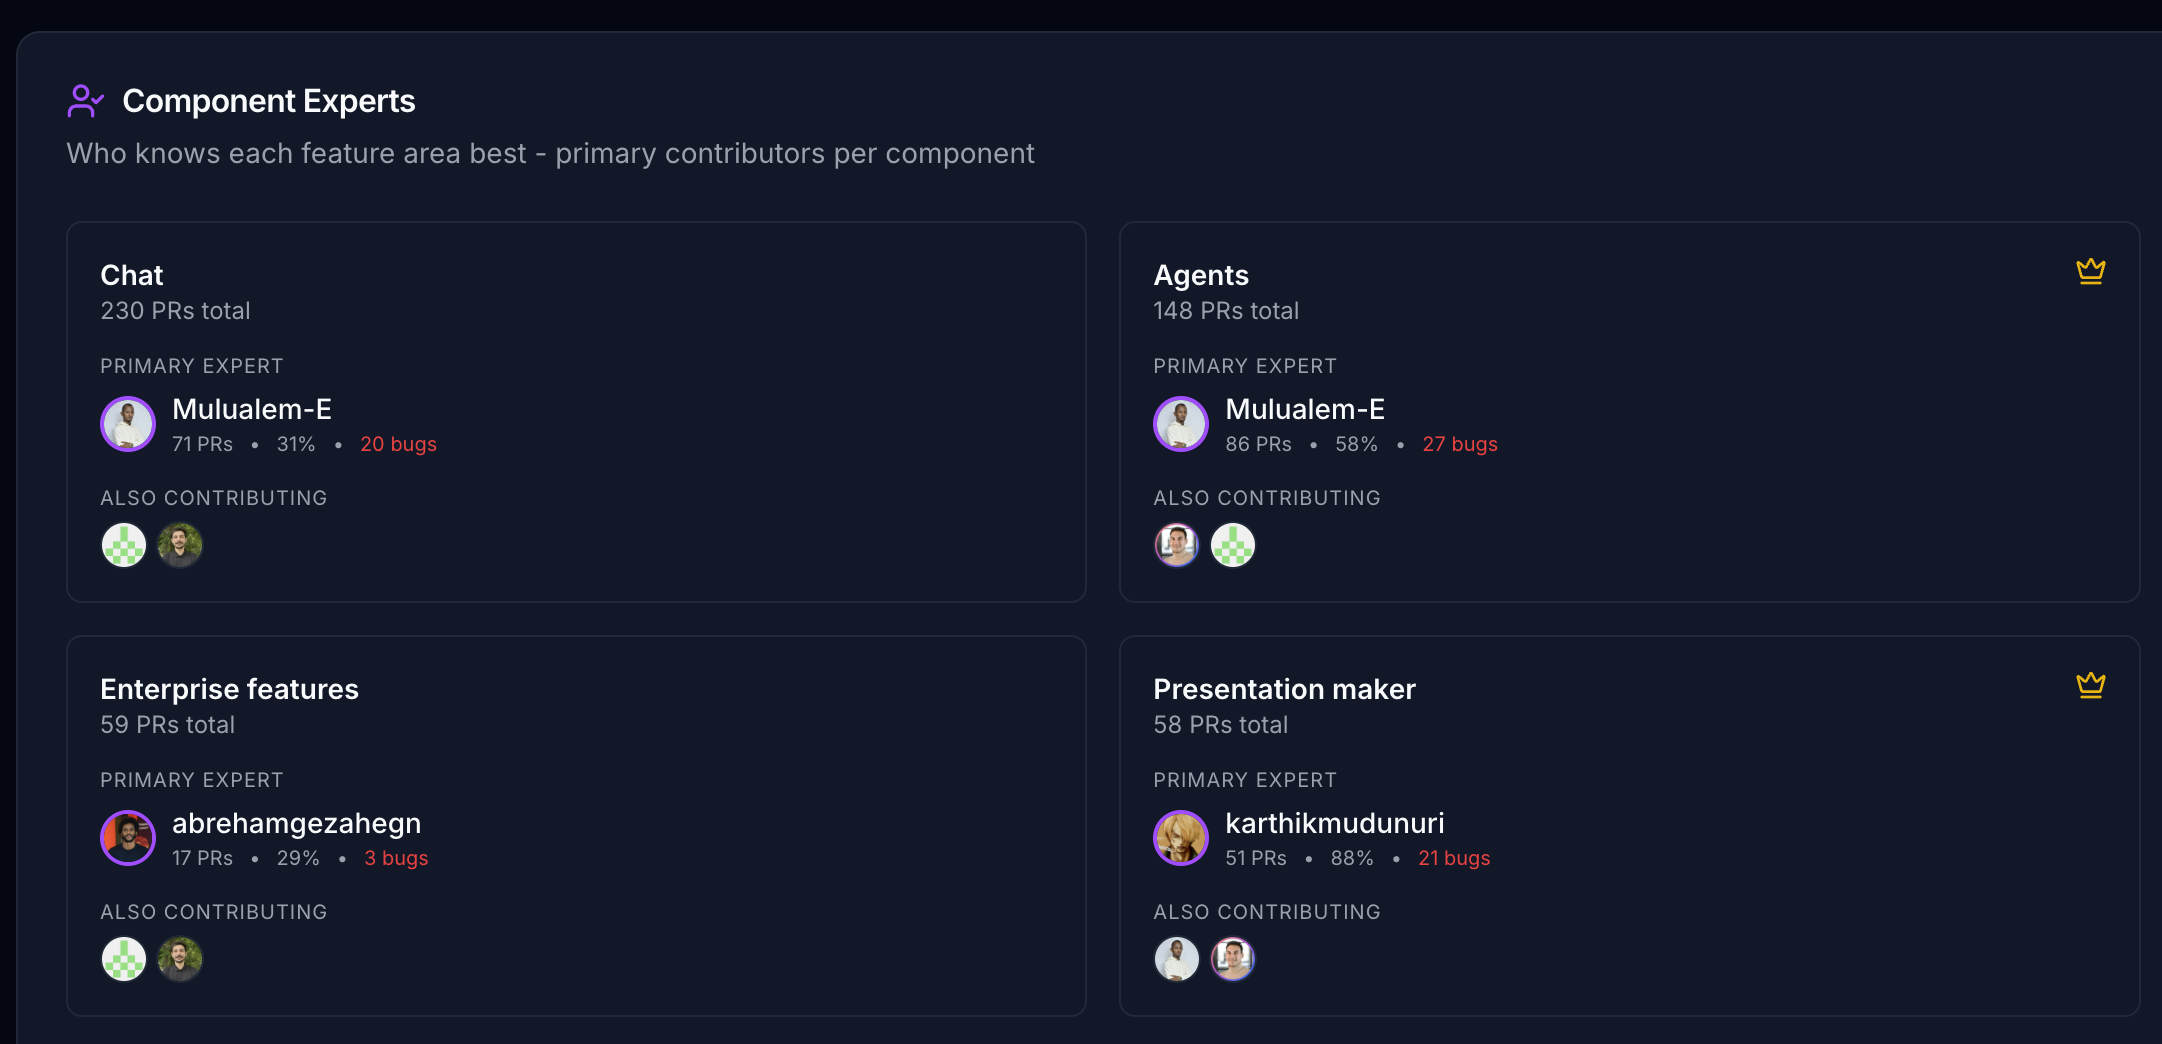
Mulualem-E ist der Hauptexperte für Chat, unsere 2,0x-Komponente, mit 71 von 230 Pull Requests, und für Agents, unsere 1,5x-Komponente, mit 86 von 148. Hätte man mir das beschrieben und gefragt, wer die Rangliste anführt, hätte ich ohne Zögern ihn genannt. Er ist Zweiter. Der Spitzenplatz geht an tugberkayartextcortex, mit 31 P1-Pull-Requests gegenüber Mulualem-Es 12.
Die Schweregrad-Mischung schlug die Komponenten-Zugehörigkeit. Das wichtigste Bereich des Produkts zu besitzen ist offenbar nicht dasselbe wie wiederholt wirkungsvolle Arbeit darin zu landen, und bis wir das veröffentlichten, hätte ich nicht sagen können, welche der beiden unsere Vergütung belohnte. Sie belohnte diejenige, die ich zufällig bemerkt hatte. Das ist die Prämie für den lauten Ingenieur, in meinem eigenen Unternehmen erwischt. Meine Intuition hatte die richtigen zwei Personen und die falsche Reihenfolge, und die falsche Reihenfolge ist das, was ein Bonus ist.
Payments besteht zu 45% aus Bugfixes, und niemand musste darüber streiten
Die Bewertung jedes Pull Requests beendet auch die Gewohnheit, anhand von Anekdoten über Qualität zu streiten.
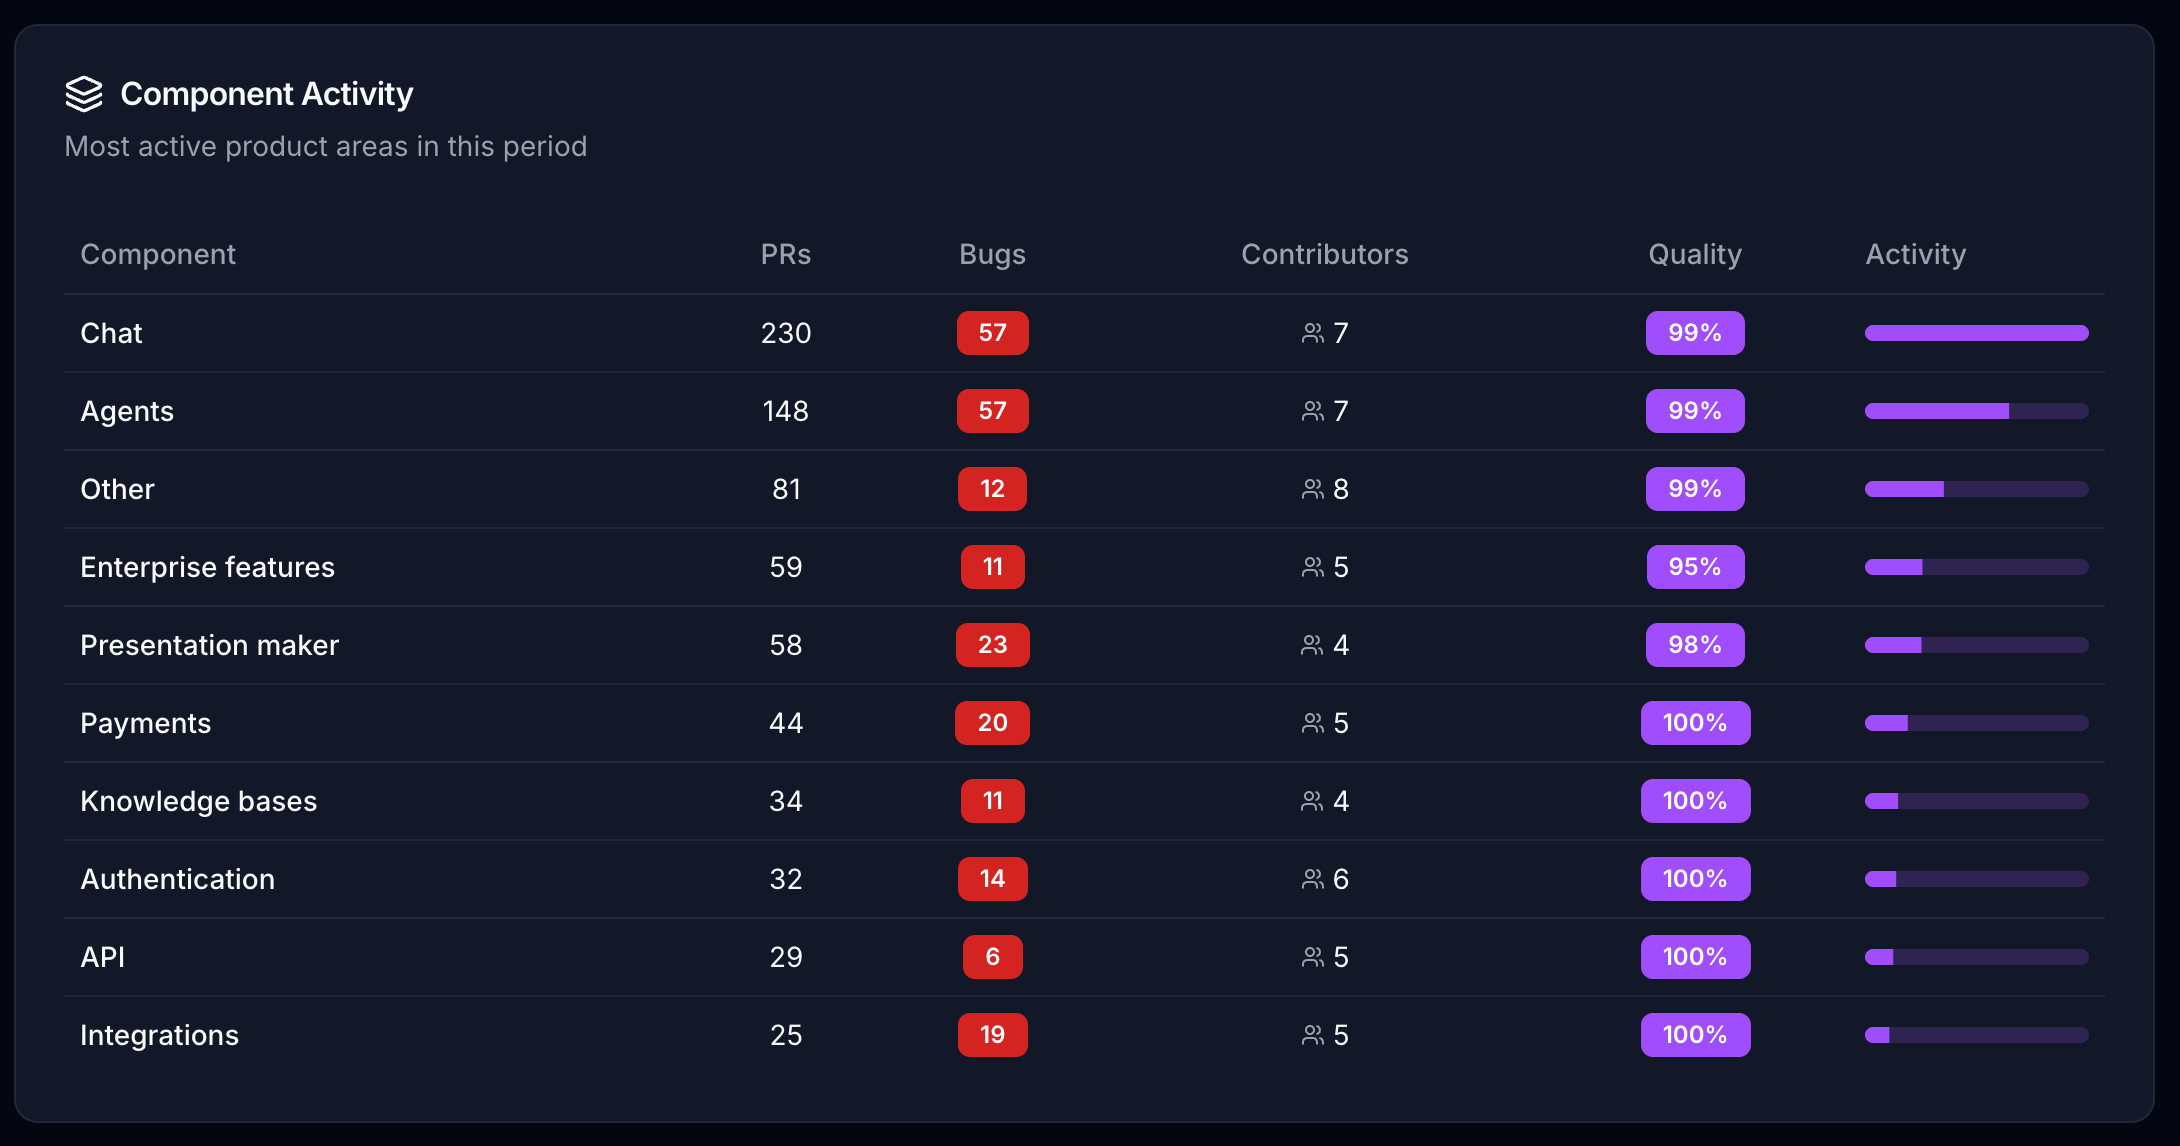
740 Pull Requests über die zehn aktivsten Komponenten, davon 230 Bugfixes statt neuer Arbeit. Chat allein hat 230 Pull Requests, so sieht ein 2,0x-Multiplikator aus, wenn er funktioniert. Dann Payments: 44 Pull Requests, 20 Bugs, eine Bugrate von 45% in der Komponente, die mit Geld zu tun hat.
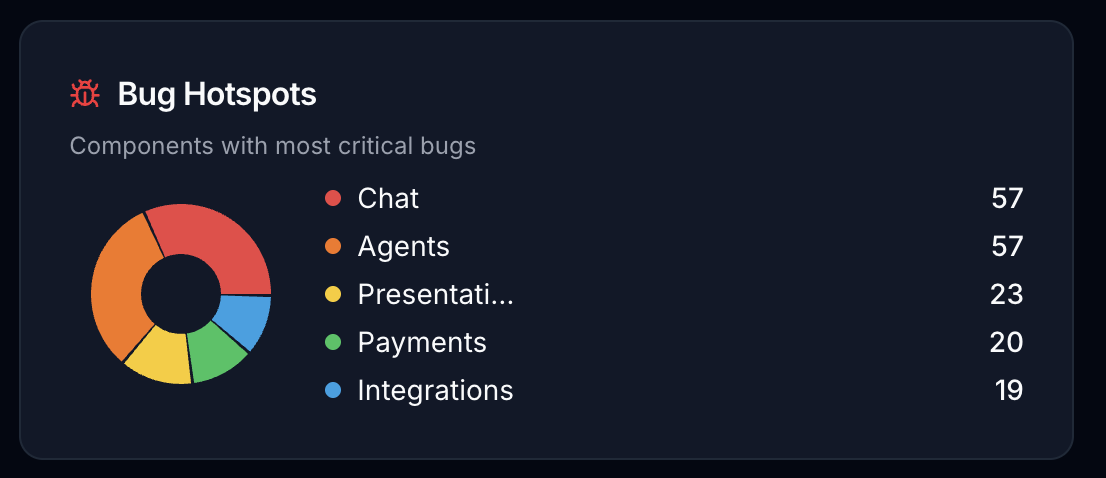
Chat und Agents liegen mit je 57 Bugs gleichauf, aber Chat produzierte diese über 230 Pull Requests und Agents über 148. Gleiche Buganzahl, 55% mehr Arbeit hinter einer von ihnen. Das ist ein Signal über Agents, das keine Retrospektive aufgedeckt hätte, weil niemand genug von beiden gemergt hat, um es zu bemerken.
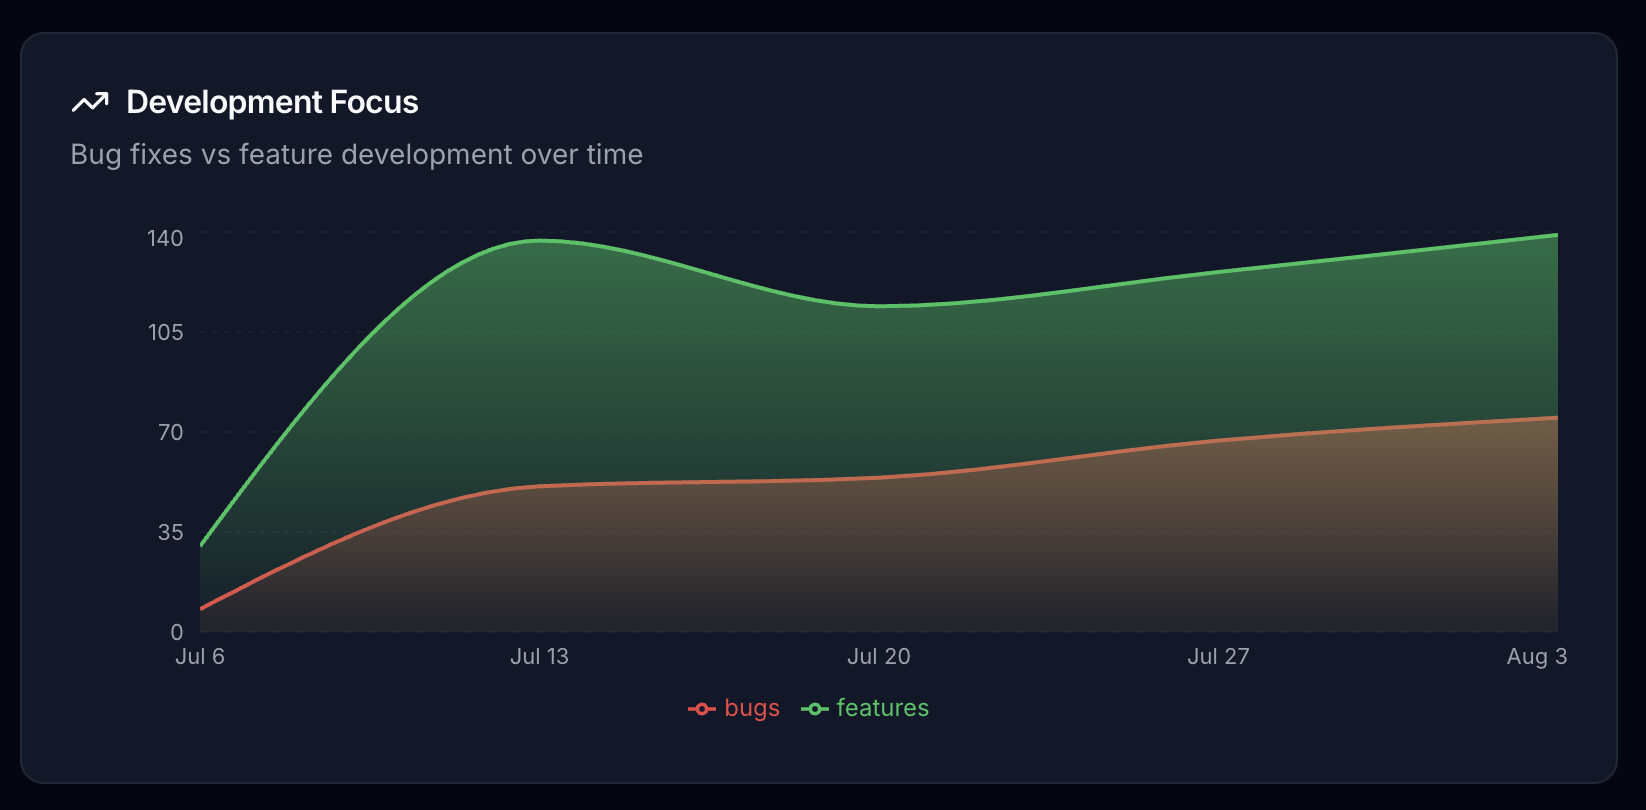
Bugs und Features steigen gemeinsam, statt sich abzuwechseln. Fünf Wochen liegen deutlich innerhalb des Rauschens, das ein einzelnes großes Projekt erzeugen würde, das landet. Behandeln Sie das Diagramm also als Beschreibung des Zeitraums und nichts weiter.
Ich habe keine Uplift-Zahl, und du solltest niemandem trauen, der eine hat
Hier ist die Behauptung, die ich aufstellen möchte. Seit wir das monatlich veröffentlichen, hat sich die Arbeit hin zu den Komponenten verschoben, die wir als wichtig markiert haben, weil Ingenieure den Score wollen.
Ich setze keine Prozentzahl darauf. Wir haben das mitten im Betrieb eingeschaltet. Es gab keine Baseline und kein Kontroll-Repository, und wir haben nie im Voraus definiert, was „verschoben“ bedeuten würde. Die Multiplikatoren haben sich im Zeitraum verändert. Ebenso der Personalbestand. Jede Zahl, die ich veröffentlicht hätte, wäre eine gewesen, die ich nach dem Ansehen der Daten ausgewählt hätte – das macht sie zur Deko.
Was sich geändert hat, ist das Argument. Die Leute haben aufgehört zu fragen, ob ihre Arbeit geschätzt wird, und angefangen zu fragen, warum eine Komponente mit 1,0x bewertet ist. Das ist der bessere Streit, den man führen kann, und es ist das Einzige, wofür ich allein schon bezahlt hätte.
Unser eigenes Tool ist auch nicht sauber, und die schärfste Kante ist diese: Ein Pull Request mit null Punkten sagt dir nicht, welches Eignungskriterium ihn ausgeschlossen hat. Fehlt der Issue-Link oder die Tests, ist der Score null, unabhängig von der Schwere – und die Person mit dem meisten Diskussionsbedarf bekommt am wenigsten Argumentationsmaterial in die Hand. Das beheben wir, bevor wir irgendetwas anderes auf der Liste anfassen.
Richte es auf die Roadmap aus, dann gib den Leuten den Maßstab in die Hand
Zieh die Autorität aus einem Organigramm, und was darunter übrig bleibt, ist eine Routing-Tabelle. Sie trägt „was in diesem Quartal zählt“ von den Leuten, die es entschieden haben, nach außen und „wer was getan hat“ wieder nach innen – und sie macht beides langsam und mit Verzerrung an jedem Hop. Alles, was du an Unternehmenspolitik nicht magst, ist ein Kompressionsartefakt dieses Routings. Manager waren die einzige verfügbare Hardware für diesen Job.
Sie sind jetzt nicht mehr die einzige verfügbare Hardware. Ein Modell, das jeden Diff liest, plus eine Tabelle mit Multiplikatoren, erledigt das Routing nach außen in einem Hop und das Routing nach innen in einer Query. Das ist die Pull-Organisation, und ich möchte bei ihren Grenzen präzise sein. Es wird nichts eingeebnet. Die Führung setzt weiterhin die Multiplikatoren, die Strategie wird also weiterhin in einem Raum von wenigen Leuten entschieden, und alles, was sich ändert, ist der Weg aus diesem Raum hinaus. Was für Menschen übrig bleibt, ist der Teil, der immer der Job war und nie Zeit hatte: zu entscheiden, was die Multiplikatoren sein sollten, und bei den Leuten zu sitzen, die diese Entscheidungen bewegt hat.
Die Politik verschwindet nicht. Sie zieht um. Sie zieht um von „erinnert sich mein Manager an mein Quartal“ zu „warum ist meine Komponente mit 1,0x bewertet, wenn die Roadmap sie als Kern bezeichnet“ – und dieser zweite Streit dreht sich um die tatsächliche Strategie des Unternehmens, geführt in der Öffentlichkeit, in einer Tabelle, die jeder lesen kann. Ich hätte lieber jeden Monat diesen Streit als den aktuellen, einmal im Jahr, privat, von jemandem, der elf Monate aus dem Gedächtnis rekonstruiert.
Jemand wird das schlecht betreiben. Jemand wird eine Anzeigetafel an die Wand hängen, ohne Eignungserklärungen und ohne Override-Protokoll, und das unterste Dezil feuern – und es wird dem Modell angelastet werden, statt der Person, die die Multiplikatoren gewählt hat.
Also messt mich mit demselben Instrument. Wenn ihr so etwas betreibt, veröffentlicht die Multiplikator-Tabelle, damit die Leute mit der Strategie streiten statt mit dem Score. Veröffentlicht die Aufschlüsselung pro Pull Request, damit jeder, der null Punkte hat, sehen kann, welches Tor ihn ausgeschlossen hat, und Einspruch einlegen kann. Veröffentlicht das Override-Protokoll, denn eine Zahl, die ein Mensch von Hand geändert hat, ist die einzige Zahl, die sich zu prüfen lohnt. Wir veröffentlichen das Erste. Das Dritte machen wir schlecht. Das Zweite veröffentlichen wir gar nicht – und genau das entscheidet, ob so etwas ein Management-Werkzeug ist oder nur ein schnellerer Weg, unfair zu sein.
GitRank ist unter gitrank.dev verfügbar und unter CC BY-NC 4.0 lizenziert. Die Bewertung im Produktivbetrieb läuft auf Claude Haiku 4.5 bei Temperatur 0.3. Alle Zahlen oben stammen aus unserem eigenen Plattform-Repository zwischen dem 6. Juli und dem 3. August 2026, Stichprobengröße ein Unternehmen und sieben Entwickler – das ist eine Beschreibung von uns und kein Benchmark für irgendetwas.