Machinaal vertaald. Lees het Engelse origineel: Your performance review is a memory test →
Vraag een willekeurige engineering manager wie hun beste engineer is. Het antwoord komt voordat je de vraag af hebt, zonder aarzeling en zonder ‘laat me eerst even iets checken.’ Ze weten het. Ze hebben het altijd geweten.
Vraag ze nu om het werk te laten zien.
Je krijgt een verhaal. Meestal een goed verhaal, over een incident dat iemand om 2 uur ’s nachts afhandelde, of een refactor die een kwartaal deblokkeerde. Wat je niet krijgt is een getal, een vergelijking, of enig verslag van de vier engineers wier werk de manager niet van nabij had meegemaakt. Dat vertrouwen is opgebouwd uit herinnering, en herinnering is een functie van nabijheid.
Hier is de stelling. Engineeringprestaties worden beoordeeld vanuit het geheugen, geheugen beloont zichtbaarheid in plaats van waarde, en het werk dat je mensen eigenlijk wilt laten doen staat in een roadmap die nooit verbonden is met waar je ze op beoordeelt. Die twee documenten hebben niets met elkaar te maken bij bijna elk bedrijf dat ik heb gezien, het mijne inclusief.
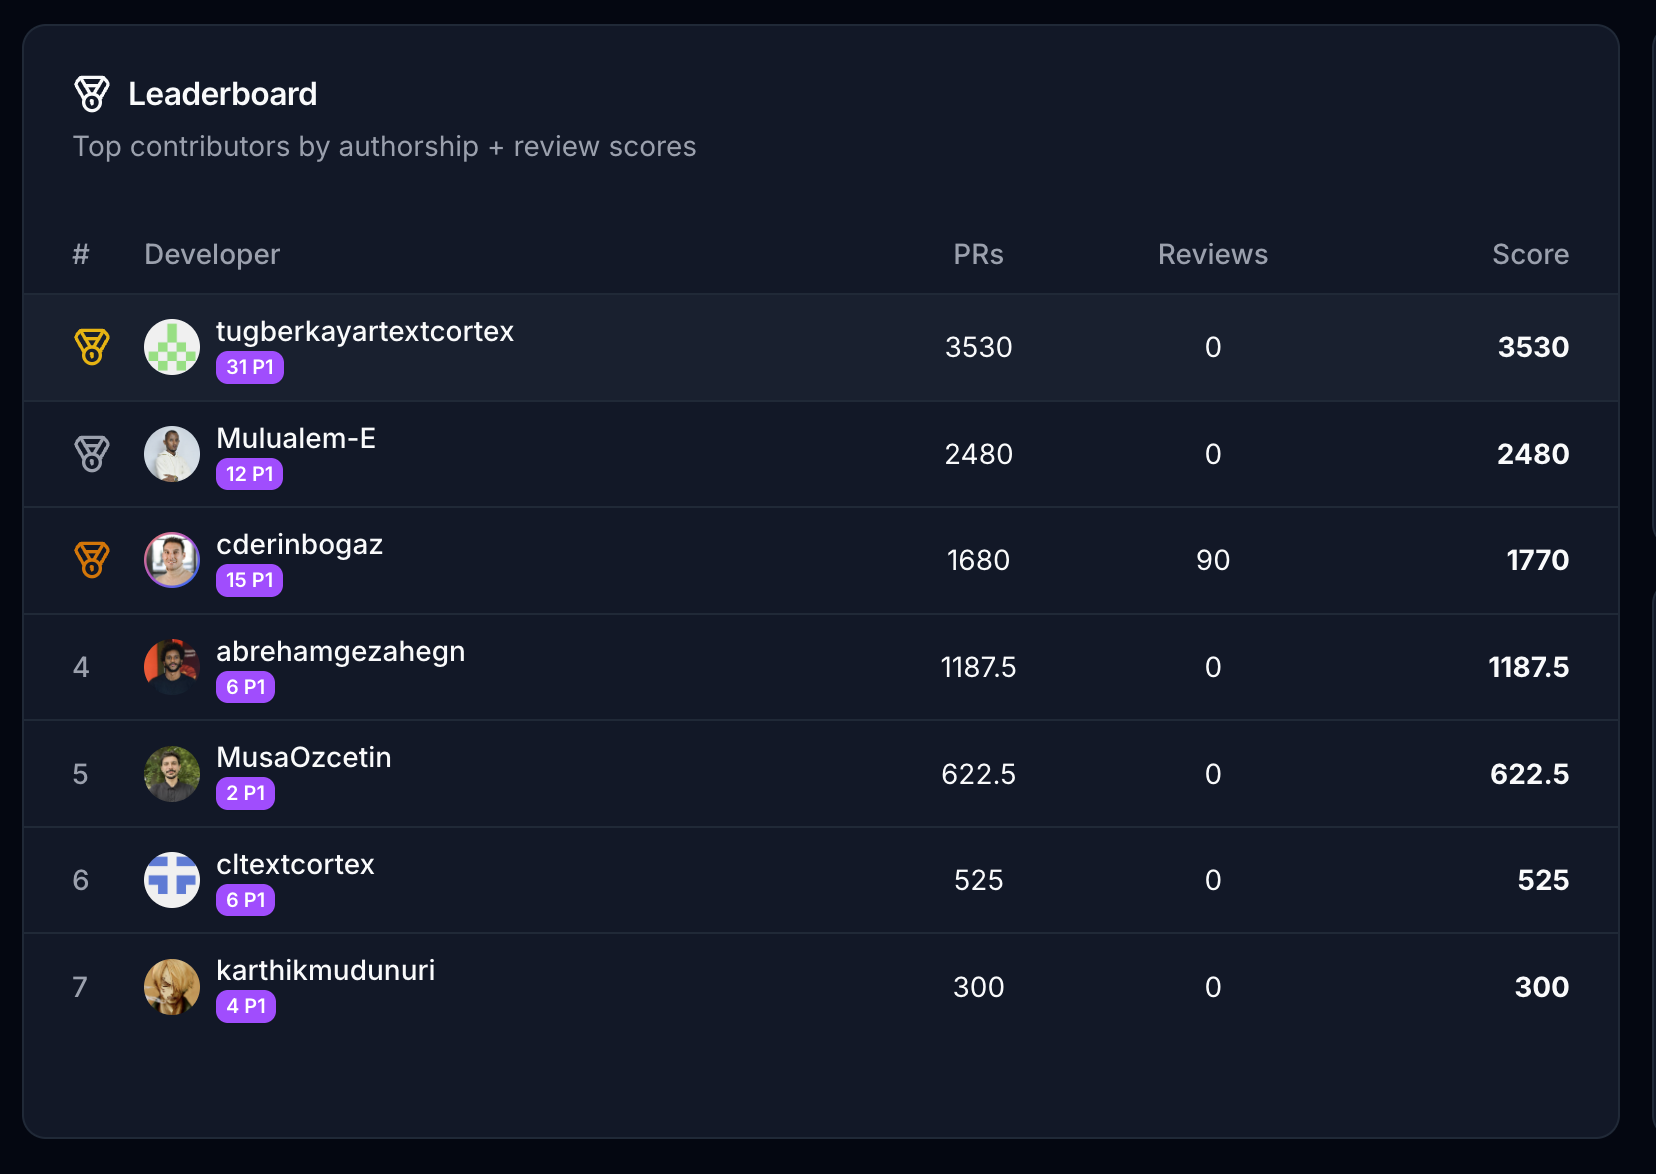
Dus wij hebben ze verbonden. Elke gemergde pull request wordt gelezen door een model, krijgt een severity toegewezen, en wordt vermenigvuldigd met hoeveel onze roadmap om het component geeft dat het aanraakte. Het resultaat is een maandelijkse leaderboard, en het voedt bonusbeslissingen. Hier is de onze.
De heersende wijsheid is dat dit niet te meten valt, en de heersende wijsheid is een schouderophalen
Het standpunt over het meten van individuele output is dat je het niet moet doen, omdat elke proxy een valstrik is. Het aantal regels code beloont opgeblazenheid. Commit-aantal beloont opsplitsen. Gesloten tickets belonen wie de kleine eerst pakt. Story points zijn een onderhandeling die plaatsvindt voordat het werk begint. Zelfs de goede frameworks zijn bewust op teamniveau: DORA meet vier dingen over een delivery pipeline en zegt niets over mensen, waar de auteurs expliciet over zijn.
Dat klopt allemaal, en geen ervan is een antwoord. De ranking gebeurt toch, elk jaar, bij de compensatieronde, in een kamer, uit het geheugen, gewogen door wie er naast die persoon in de kamer zat. Weigeren te meten levert je een ranking op zonder audittrail en zonder beroepsmogelijkheid.
Noem het de loud engineer premium: de kloof tussen hoe goed je wordt beoordeeld en hoe goed je presteerde, volledig verklaard door je afstand tot degene die je beoordeling schrijft. Vraag een willekeurig mens om de technische bijdragen van vijftien mensen over een jaar te vergelijken met niets anders dan wat hun toevallig was opgevallen, en dit is wat eruit komt. Ieder van ons zou het produceren.
Die premie was onvermijdelijk tot ongeveer twee jaar geleden, omdat het ruwe materiaal voor een beter antwoord een stapel diffs was die niemand tijd had om te lezen. Die beperking is verdwenen. Een model kan elke diff in je repository elke maand lezen voor minder dan de kosten van de vergadering waarin je nu gokt. Ze lezen is het makkelijke deel. Bepalen wat het lezen waard is, is het hele probleem, en dat is geen technische vraag.
De hele formule past op één regel
Hier is hij, volledig, uit het scorepad in GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0Ik heb dat niet vereenvoudigd voor de blog. Het is de regel zoals die draait, zonder verborgen regressie, geen geleerde weging, geen reputatieterm en geen anciënniteitscorrectie. Severity maal importance, of nul.
Severity is een vaste ladder, eenmalig vastgesteld en zichtbaar voor iedereen die gescoord wordt.
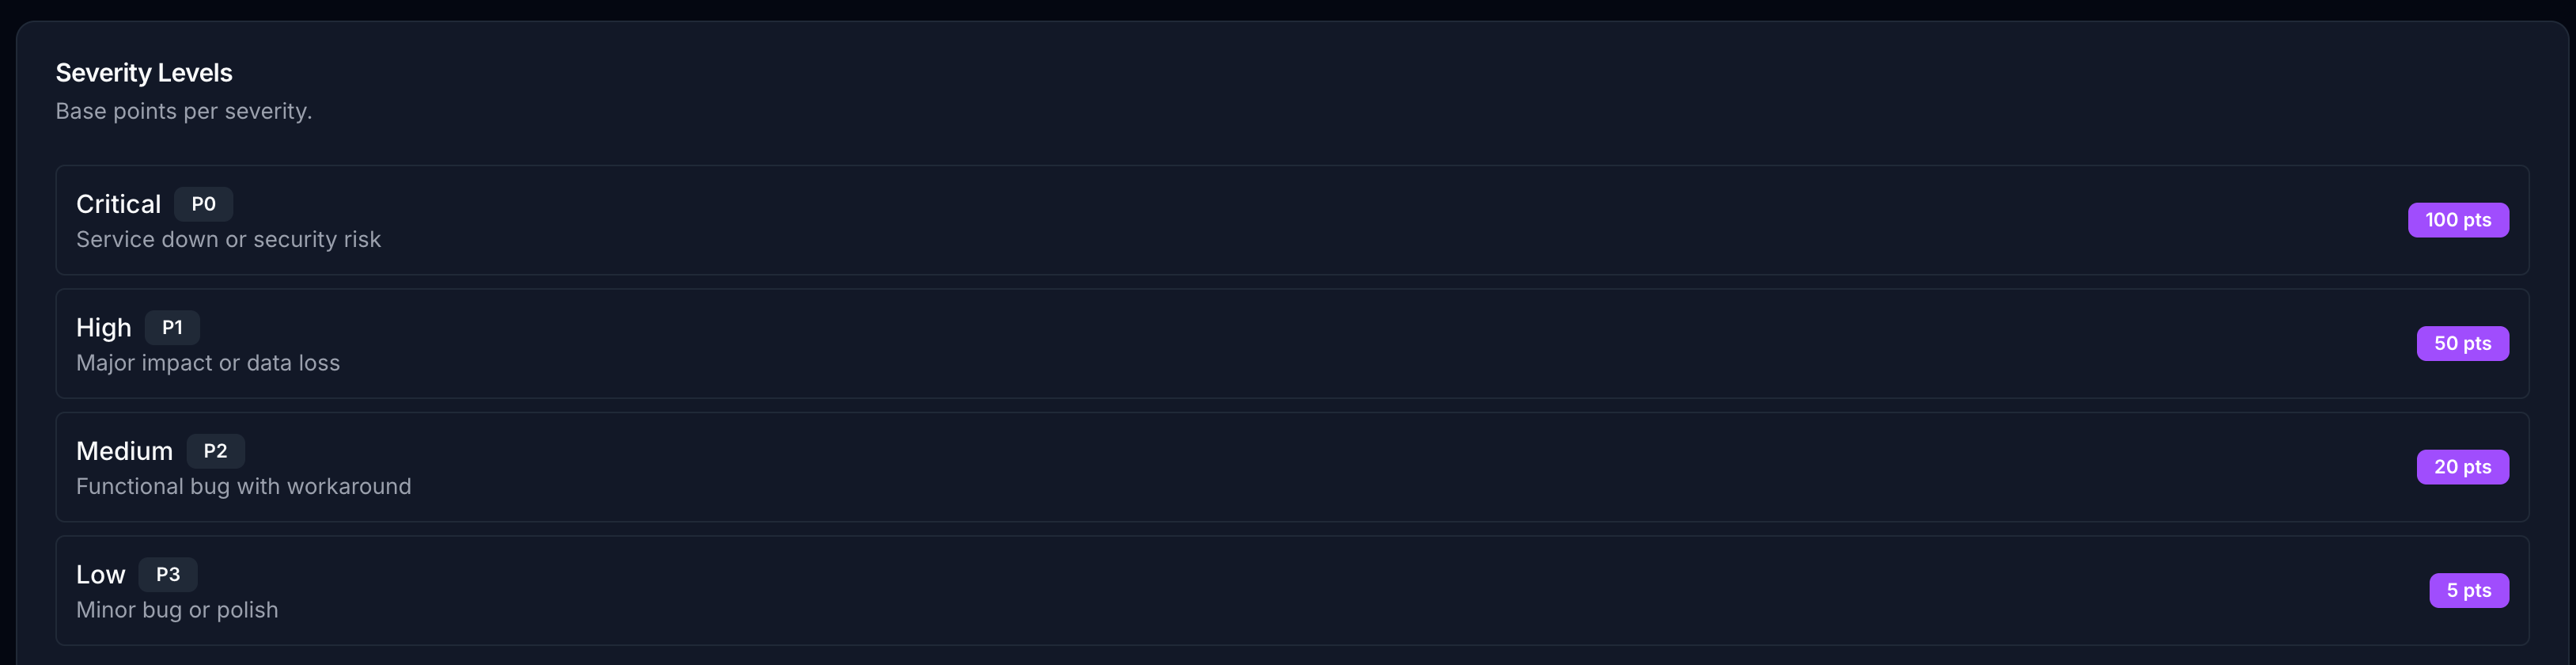
Een kritieke fix is twintig laagprioritaire waard. Die verhouding is een beleidsuitspraak, en we hebben die opgeschreven in plaats van die in iemands hoofd te laten.
Importance is de helft die ertoe doet. Elk component draagt een multiplier, en de multiplier is wat het product dit kwartaal nodig heeft.
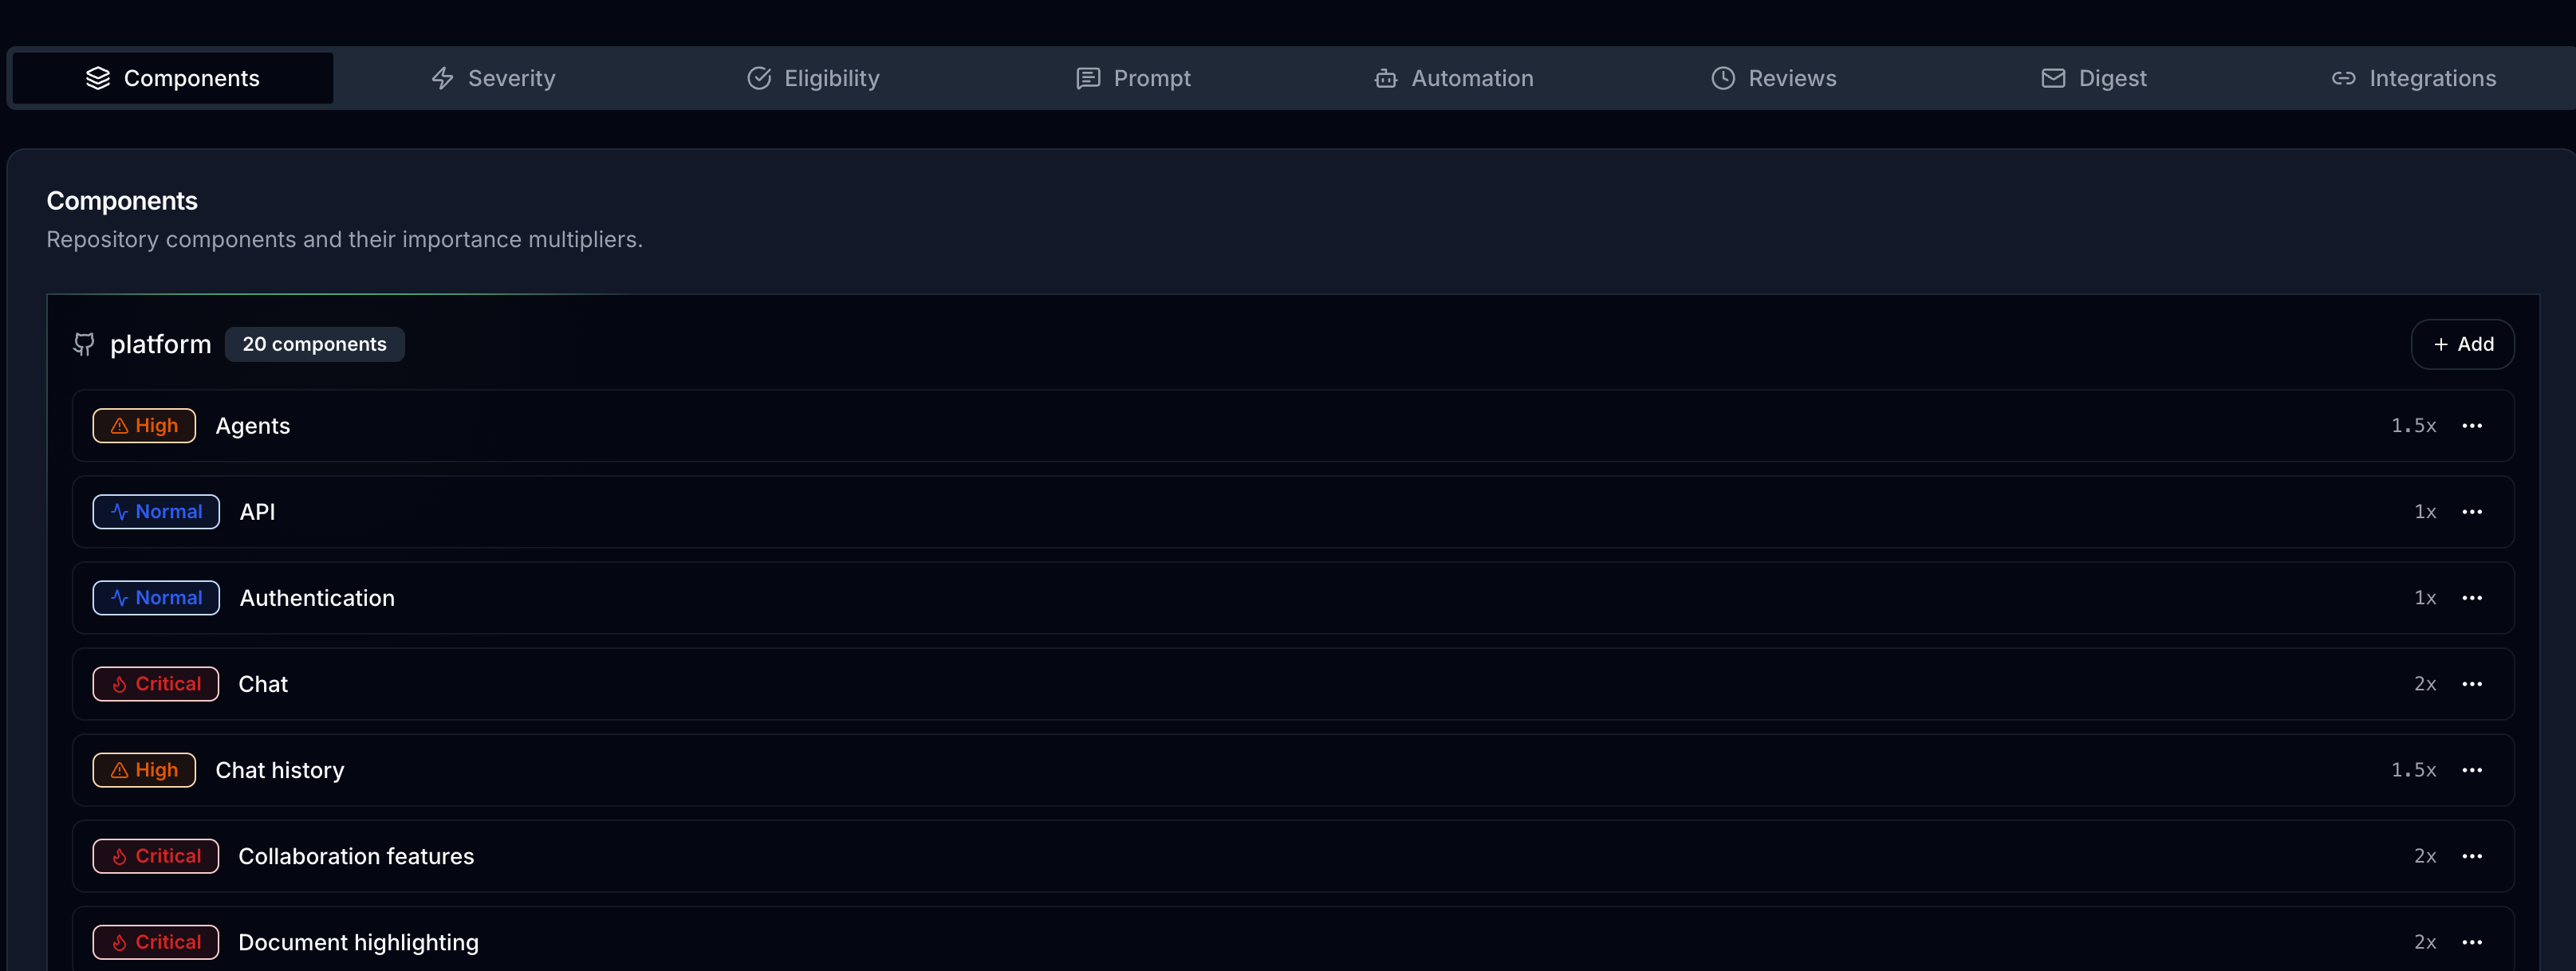
Chat is 2,0x omdat chat is waar we het product op inzetten. Authentication is 1,0x omdat het werkt en we willen dat het rustig blijft werken. Dat zijn productbeslissingen, en de multipliertabel is waar ze worden overgetypt in een veld dat betaalt.
Het strategiedocument en de compensatie-input werden hetzelfde document. Dat is de zet. Het model is de infrastructuur en de leaderboard is een weergave ervan, en als de roadmap in oktober verandert, verandert de incentive in oktober, in plaats van bij een reviewcyclus veertien maanden later.
Laat me dit uitspellen, omdat dit het deel is dat mensen overslaan. Veertig slimme mensen, elk lokaal en eerlijk optimaliserend, produceren een kwartaal werk dat niet optelt tot wat het bedrijf zei te willen. Niemand in dat beeld is lui, en dat is wat het moeilijk maakt. Middle management bestaat grotendeels om dat te fixen, strategie ronddragend in gesprekken, bureau voor bureau, met verlies van getrouwheid bij elke hop. Een multipliertabel doet dezelfde routing in één hop, en in oktober staat er nog precies in wat je er in januari in typte.
Joi Ito heeft het verschil al benoemd. Een van de negen principes in Whiplash, geschreven met Jeff Howe in 2016, is pull over push: je trekt uit het netwerk wat je nodig hebt in plaats van alles op voorraad te houden. Ito beschreef resources. Richting gedraagt zich hetzelfde. Een push-organisatie stapelt de strategie op in een managementlaag en deelt die uit in gesprekken, waardoor die laat en met verlies de rand van het bedrijf bereikt. Een pull-organisatie publiceert de strategie als een prijslijst en laat mensen eruit halen wat ze nodig hebben. De multiplier-tabel is de prijslijst.
Een kritieke fix in chat is veertig polish-commits in de API waard
Voer de twee helften samen uit en de spreiding is fors. Een P0 in chat scoort 100 basis keer 2,0, dus 200 punten. Een P3 in de API scoort 5. Veertig tegen één, dat is de kloof tussen de meest waardevolle pull request die je hier kunt mergen en de minst waardevolle.
Die verhouding is bewust heftig, en doet wat zachte prikkels nooit voor elkaar krijgen. Niemand herorganiseert zijn week om een verschil van 15%. Mensen herorganiseren hun week absoluut om een verschil van 40x.
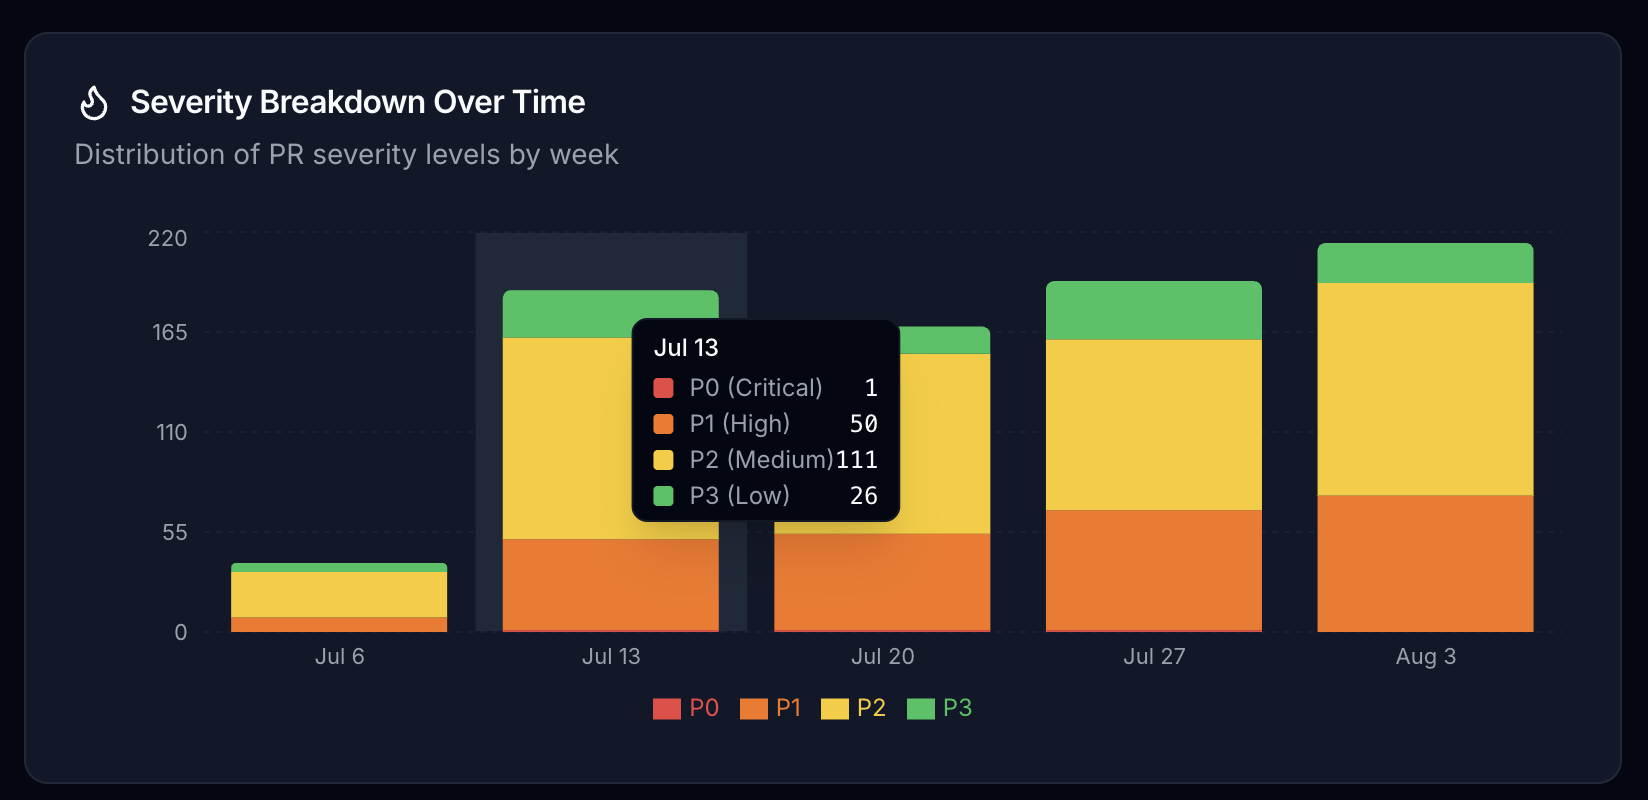
188 pull requests in één week. P2 is 59% daarvan, en zo ziet een normale engineeringweek er overal uit. Weeg het nu. Die 111 P2’s zijn 2.220 punten waard. De 50 P1’s zijn 2.500 waard. Minder dan half zoveel pull requests dragen meer dan de helft van de waarde van de week. Tel je pull requests, dan concludeer je dat de week om P2’s draaide. Weeg je ze, dan draaide de week om vijftig specifieke stukken werk, en kun je benoemen wie ze deed.
Twee mensen waren 58% van de output, en ik had de volgorde verkeerd
Zeven developers, 10.415 punten. De topdeveloper heeft er 3.530, 33,9% van alles wat het team aan waarde produceerde. De top twee houdt samen 57,7%.
Zo’n concentratie betekent meestal dat de top twee aan de componenten met de hoogste multiplier werkt, en dat is precies wat we ze vroegen te doen. Het getal beschrijft waar waarde terechtkomt, en ik zou er niets uit afleiden over de andere vijf.
De volgorde is wat mijn voorspelling brak.
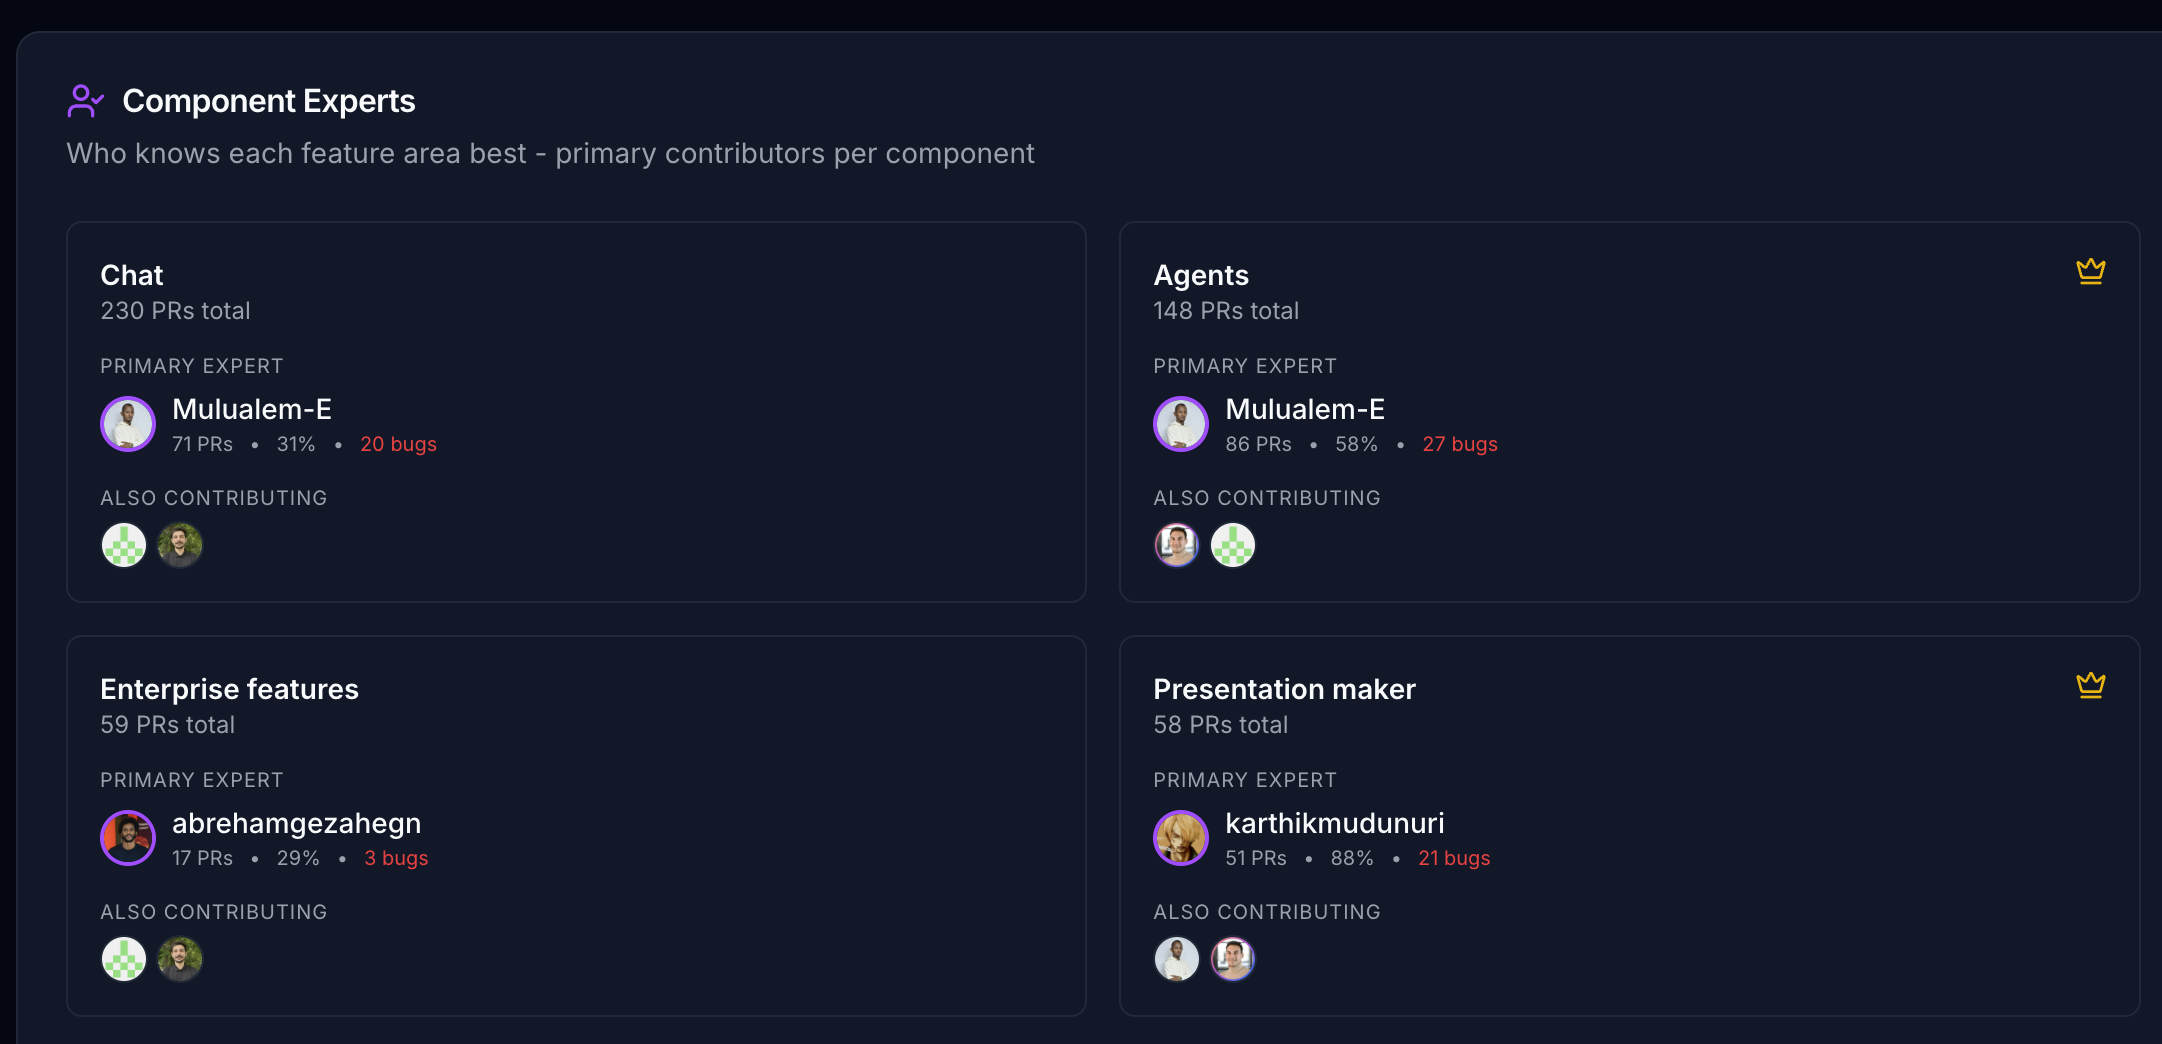
Mulualem-E is de primaire expert op chat, ons 2,0x-component, met 71 van de 230 pull requests, en op agents, ons 1,5x-component, met 86 van de 148. Als je me dat had beschreven en gevraagd wie bovenaan het leaderboard staat, had ik zonder aarzelen hem gezegd. Hij is tweede. De eerste plek gaat naar tugberkayartextcortex, met 31 P1-pull requests tegen Mulualem-E’s 12.
De ernstmix versloeg componentownership. Het bezitten van het belangrijkste gebied van het product blijkt niet hetzelfde te zijn als herhaaldelijk hoog-impact werk daarbinnen opleveren, en tot we dit publiceerden had ik je niet kunnen vertellen welke van de twee onze beloning bekroonde. Het bekroonde degene die ik toevallig had opgemerkt. Dat is de luidruchtige-engineer-premie, betrapt in mijn eigen bedrijf. Mijn intuïtie had de juiste twee mensen en de verkeerde volgorde, en de verkeerde volgorde is wat een bonus is.
Payments is 45% bugfixes en niemand hoefde erover te discussiëren
Elke pull request scoren maakt ook een einde aan de gewoonte om vanuit anekdotes over kwaliteit te discussiëren.
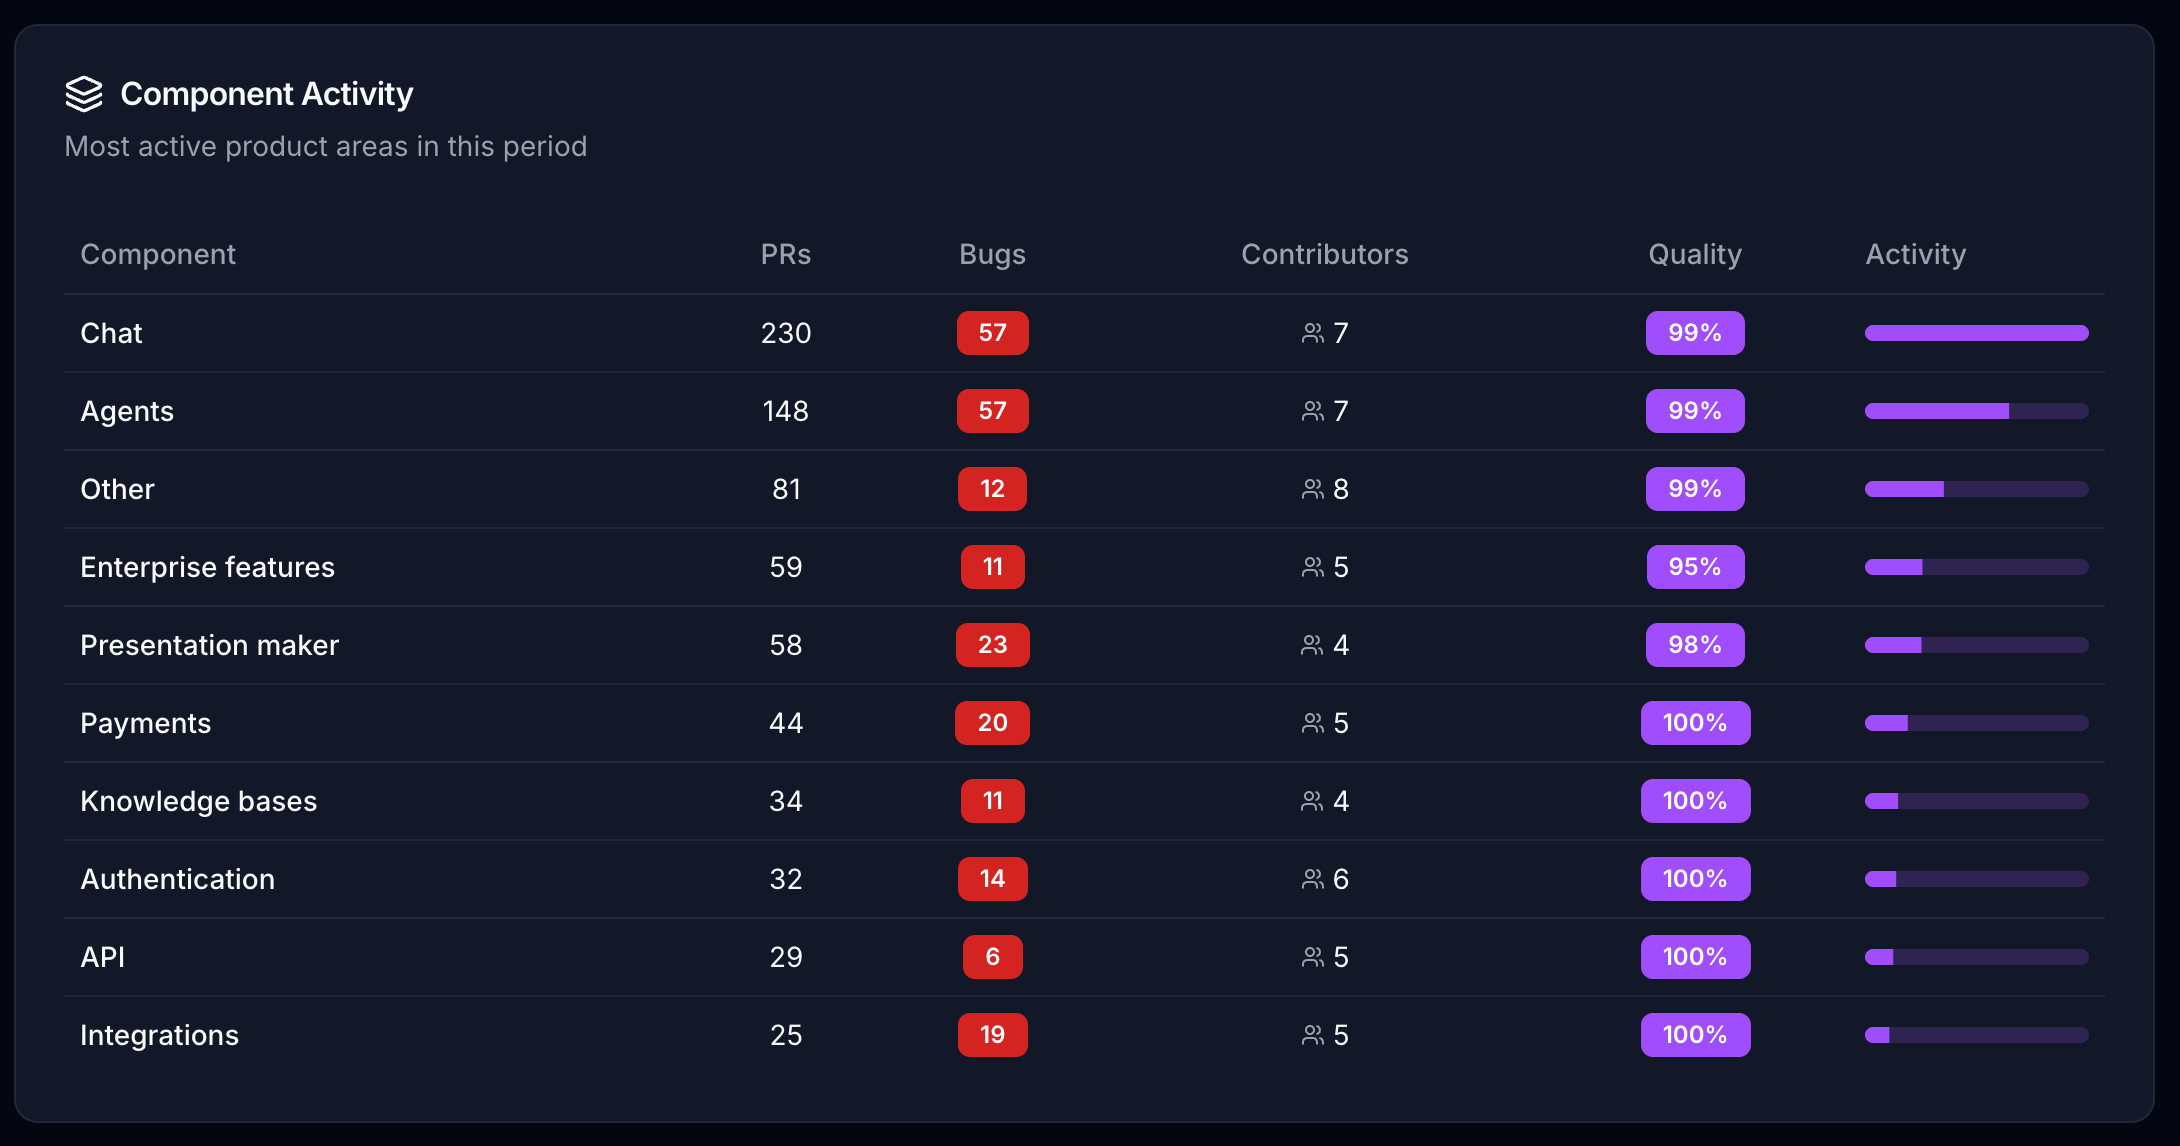
740 pull requests over de tien drukste componenten, waarvan 230 bugfixes in plaats van nieuw werk. Chat alleen al is 230 pull requests, en zo ziet een 2,0x-multiplier eruit als hij werkt. Dan payments: 44 pull requests, 20 bugs, een bugpercentage van 45% in het component dat met geld te maken heeft.
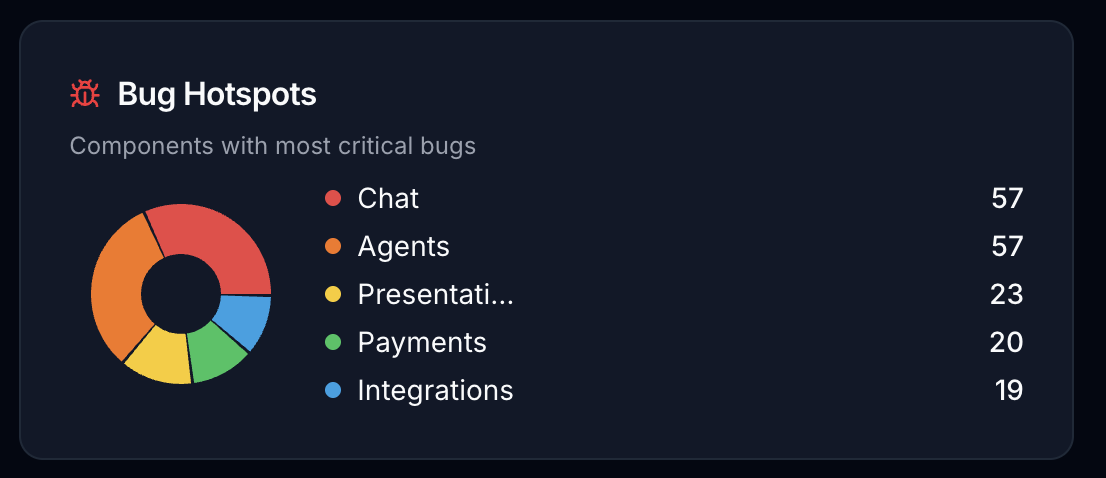
Chat en agents staan gelijk op 57 bugs elk, maar chat produceerde die over 230 pull requests en agents over 148. Hetzelfde aantal bugs, 55% meer werk achter een van beide. Dat is een signaal over agents dat geen retrospective boven water zou halen, omdat niemand genoeg van beide had gemerged om het op te merken.
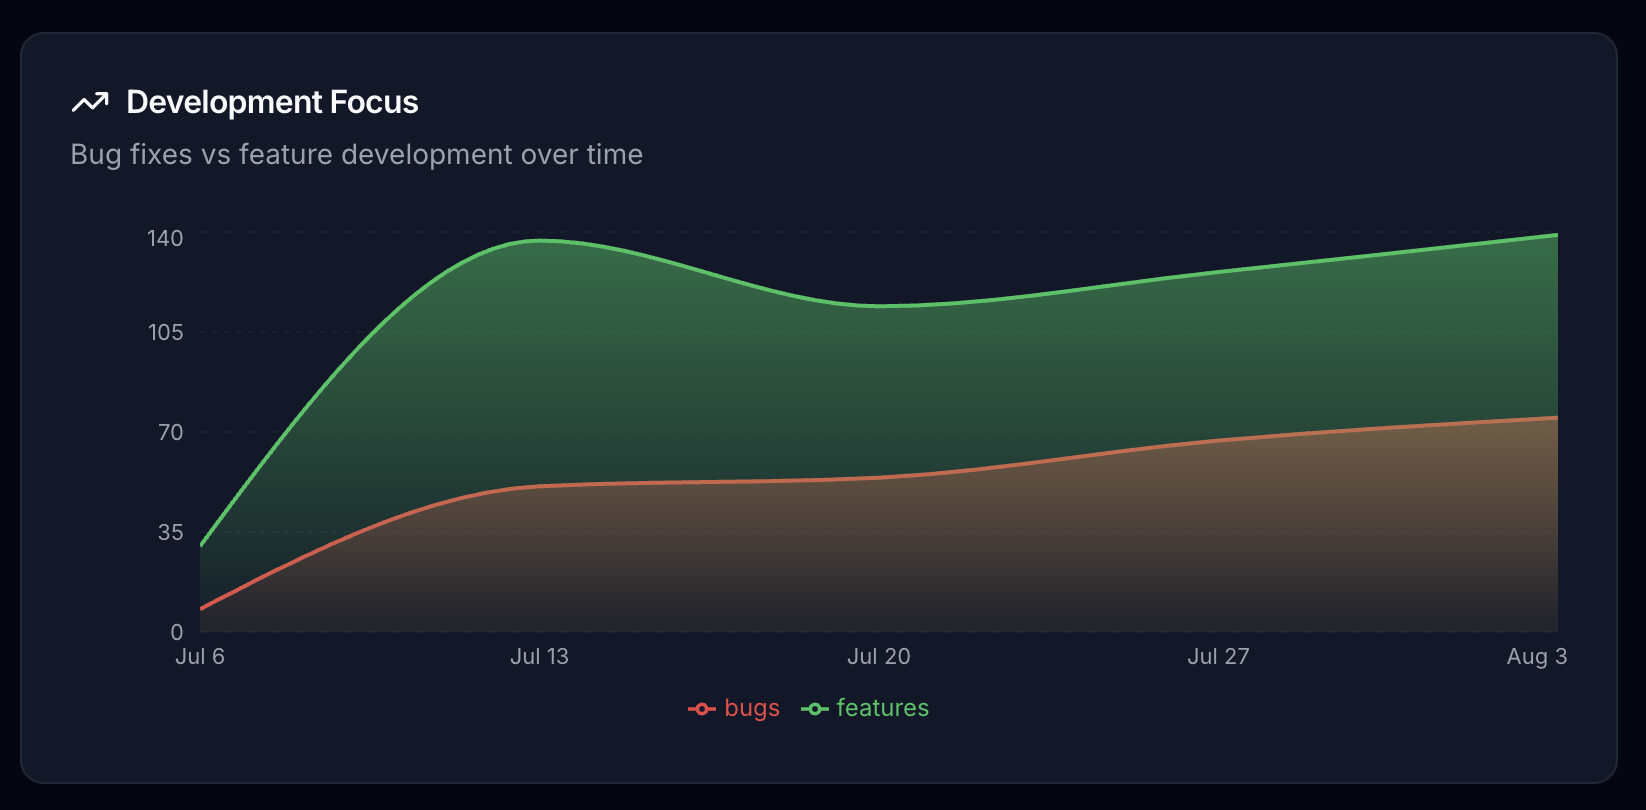
Bugs en features stijgen samen in plaats van elkaar af te wisselen. Vijf weken zit ruim binnen de ruis die één groot project dat landt zou produceren, dus behandel die grafiek als een beschrijving van de periode en niets meer.
Ik heb geen stijgingscijfer, en je moet niemand vertrouwen die dat wel heeft
Dit is de bewering die ik wil doen. Sinds we dit maandelijks publiceren, is het werk verschoven naar de componenten die we als belangrijk markeerden, omdat engineers de score willen.
Ik plak er geen percentage op. We hebben dit halverwege ingeschakeld. Er was geen nulmeting en geen controle-repository, en we hebben nooit van tevoren afgesproken wat “verschoven” zou betekenen. De multipliers zijn in die periode veranderd. Het personeelsbestand ook. Elk cijfer dat ik zou publiceren, zou er een zijn die ik achteraf heb gekozen, nadat ik de data had gezien. Dat maakt het decoratie.
Wat veranderd is, is het gesprek. Mensen stopten met vragen of hun werk gewaardeerd werd en begonnen te vragen waarom een component op 1.0x stond. Dat is een beter gevecht om te voeren, en het is het enige waarvoor ik op zichzelf al had willen betalen.
Ons eigen instrument is ook niet schoon, en de scherpste rand is dit: een pull request dat nul scoort, vertelt je niet welk toelatingscriterium erop is dichtgeslagen. Mis je de issue-link of de tests, dan is de score nul, ongeacht de ernst, en krijgt degene met de meeste reden om te discussiëren het minste materiaal om mee te discussiëren. Dat lossen we op vóór al het andere op de lijst.
Richt het op de roadmap en geef mensen dan de liniaal
Strip het gezag van een organigram en wat eronder overblijft is een routeringstabel. Die draagt “wat er dit kwartaal toe doet” naar buiten, van de mensen die het besloten, en “wie wat deed” weer naar binnen, en doet beide langzaam en met vervorming op elke hop. Alles wat je verafschuwt aan bedrijfspolitiek is een compressie-artefact van die routering. Managers waren de enige beschikbare hardware voor die klus.
Dat is nu niet meer de enige beschikbare hardware. Een model dat elke diff leest, plus een tabel met multipliers, doet de uitgaande routering in één hop en de inkomende routering in een query. Dat is de pull-organisatie, en ik wil precies zijn over de grenzen ervan. Er wordt niets platgeslagen. Leiderschap stelt nog steeds de multipliers, dus de strategie wordt nog steeds in één ruimte besloten door een paar mensen, en alles wat verandert is de reis uit die ruimte. Wat overblijft voor mensen is het deel dat altijd al de klus was en nooit tijd kreeg: beslissen wat de multipliers zouden moeten zijn, en bij de mensen zitten die door die beslissingen geraakt worden.
De politiek verdwijnt niet. Die verplaatst zich. Van “herinnert mijn manager zich mijn kwartaal” naar “waarom staat mijn component op 1.0x terwijl de roadmap het kern noemt”, en dat tweede gevecht gaat over de werkelijke strategie van het bedrijf, gevoerd in het openbaar, in een tabel die iedereen kan lezen. Ik zou dat gevecht liever elke maand voeren dan het huidige, dat één keer per jaar plaatsvindt, in beslotenheid, door iemand die elf maanden uit het geheugen reconstrueert.
Iemand gaat dit slecht uitvoeren. Iemand gaat een scorebord aan de muur hangen zonder uitleg over toelatingscriteria en zonder override-register, en de onderste deciel ontslaan, en het zal aan het model worden toegeschreven in plaats van aan de persoon die de multipliers koos.
Dus meet mij met hetzelfde instrument. Als je zoiets draait, publiceer dan de multiplier-tabel, zodat mensen discussiëren met de strategie in plaats van met de score. Publiceer de uitsplitsing per pull request, zodat iedereen die nul scoorde kan zien welke poort op hen is dichtgeslagen en ertegen in beroep kan gaan. Publiceer het override-logboek, want een getal dat een mens met de hand heeft gewijzigd, is het enige getal dat de moeite van het controleren waard is. Wij publiceren het eerste. Het derde doen we slecht. Het tweede publiceren we helemaal niet, en dat is het onderdeel dat bepaalt of zoiets een managementinstrument is of gewoon een snellere manier om oneerlijk te zijn.
GitRank staat op gitrank.dev en is gelicenseerd onder CC BY-NC 4.0. Scoring op het productiepad draait op Claude Haiku 4.5 bij temperatuur 0.3. Alle cijfers hierboven komen uit onze eigen platform-repository tussen 6 juli en 3 augustus 2026, steekproefomvang één bedrijf en zeven ontwikkelaars, wat een beschrijving van ons is en geen benchmark van wat dan ook.