Traducción automática. Leer el original en inglés: Our LLM router runs at 30 ms p50 on an €84/month Hetzner server, no GPU →
Hace dos días publiqué un benchmark que mostraba que las alternativas abiertas a Jev pierden contra un “medium” fijo en el código. Jev envió el 84,5% de 563 prompts reales al nivel de modelo correcto. Laya y Von, los modelos abiertos, llegaron como mucho al 61,6%.
Luego intentamos comprar Jev y no pudimos. TextCortex vende a empresas europeas, y cuando lo miramos en septiembre de 2026 no había ningún despliegue de Jev en la UE que comprar. Un router lee cada prompt que escribe un cliente, así que tiene que ejecutarse donde los datos del cliente tienen permitido ir.
Así que cogí el modelo que perdió y le hice fine-tuning. El resultado es Raya, un router de 300 millones de parámetros que saca un 81% en el mismo benchmark. Ahora corre en nuestro clúster de producción sobre una CPU en Falkenstein, Alemania, con una latencia mediana de 30 ms, en un servidor Hetzner que cuesta 84 € al mes y que ya estaba en nuestra factura.
El mejor router no tenía región en la UE, así que hicimos fine-tuning del que perdió.
Laya es un modelo de decisión con licencia Apache-2.0: un encoder mmBERT con una pequeña cabeza que puntúa cada opción de una pregunta tipo test. Habla la misma API que Jev. Recién descargado, enrutaba peor que una constante.
Dos anotadores ciegos, Claude Opus y Claude Sonnet, habían etiquetado prompts de WildChat con la misma rúbrica escrita. Raya se entrena con sus etiquetas como objetivos suaves, 50/50 donde no coincidieron, más prompts difíciles sintéticos en los 14 idiomas y algunos datos de enrutado internos. Los 563 prompts de prueba vienen de shards de WildChat que el entrenamiento nunca tocó.
El entrenamiento tardó unos seis minutos en una sola NVIDIA RTX A6000.
Seis minutos en una GPU le dieron a Laya entre 25 y 34 puntos.
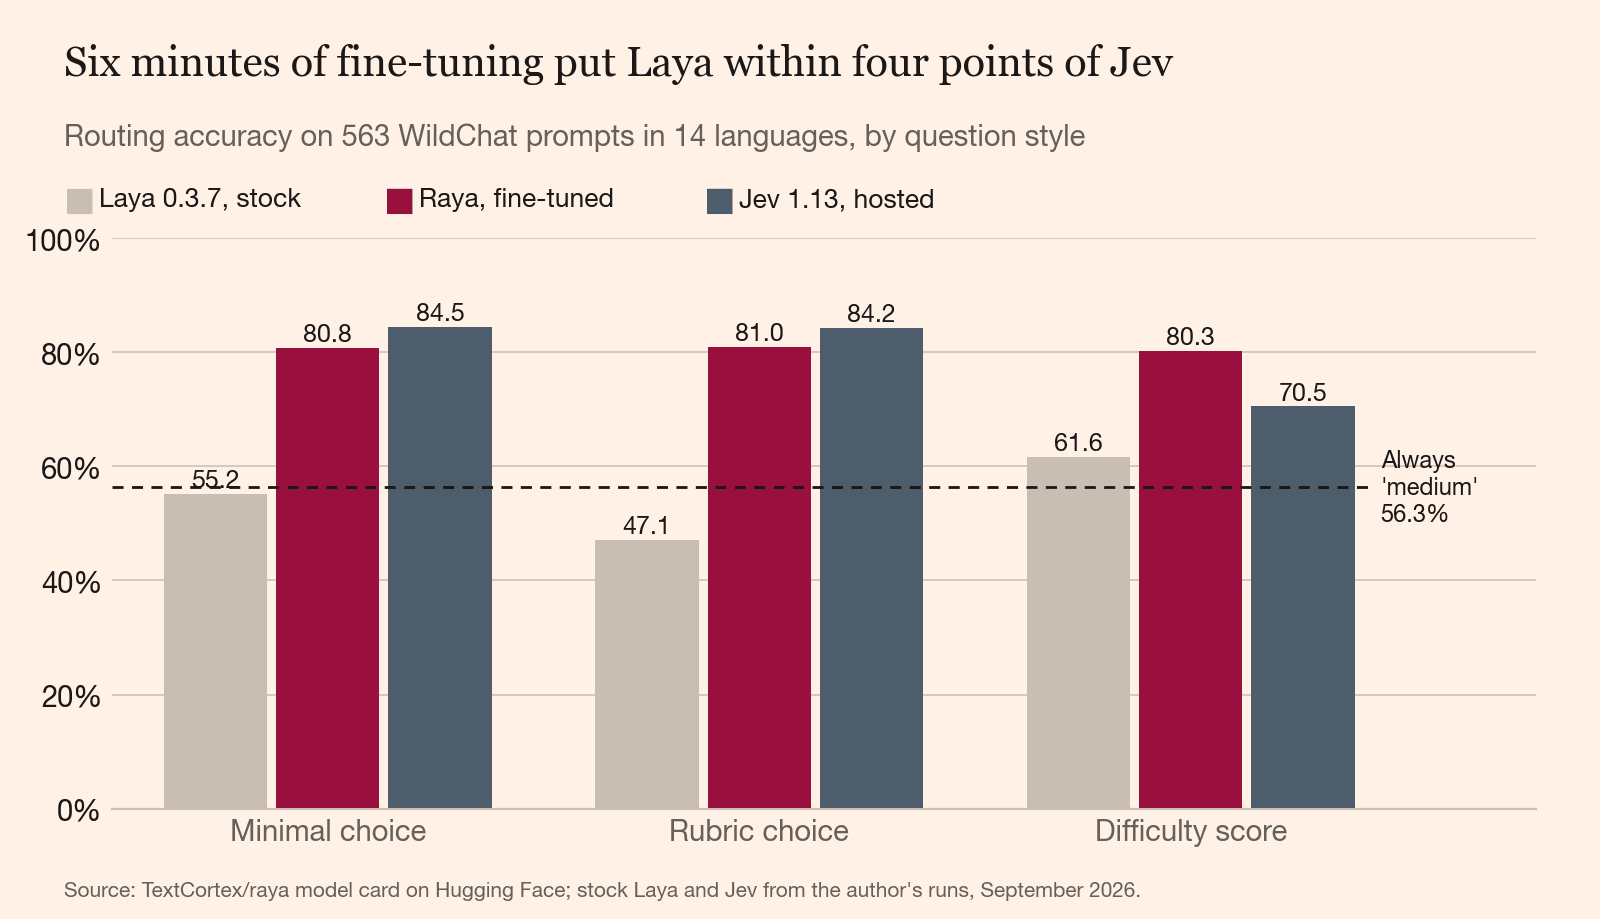
Raya saca entre un 80% y un 81% en los tres estilos de pregunta. En la puntuación de dificultad supera a Jev por diez puntos (80,3% frente a 70,5%, McNemar p < 0,001). En las dos preguntas tipo test Jev sigue por delante por tres o cuatro puntos. Esa diferencia no es significativa con este tamaño de muestra (p = 0,07 y 0,13), pero aparece en ambas, y yo apostaría a que es real.
Ahora la concesión, y es grande. Raya aprendió de los mismos dos anotadores que escribieron las etiquetas de referencia. Jev nunca las vio. Parte del 81% de Raya es ventaja de jugar en casa, y no puedo decirte cuánta. Los anotadores solo coinciden entre sí el 78% de las veces, así que Raya ha tocado el techo de lo que estas etiquetas pueden medir.
Raya también es más débil justo donde Jev es más fuerte. En la pregunta mínima saca un 67% en turco frente al 82% de Jev, y un 76% en portugués frente al 90%. Igual que Jev, envía a frontier solo 7 de los 21 prompts frontier.
Un clasificador de 300M de parámetros no pinta nada en una GPU.
La model card de Raya cita 17 ms en GPU. Una GPU entera para un pequeño forward pass por prompt es mucho hardware, así que exporté Raya a ONNX Runtime y probé cinco variantes en dos CPU: un Intel i9-13900, que tiene instrucciones int8 VNNI, y un AMD EPYC 7502P, que no las tiene.
| Archivo | Tamaño | Precisión | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
|---|---|---|---|---|
| fp32 | 1,23 GB | 81,2% | 38 / 297 ms | 60 / 487 ms |
| int8 por bloques | 0,89 GB | 81,5% | 34 / 282 ms | 127 / 975 ms |
| int8 por tensor | 0,92 GB | 79,0% | 24 / 200 ms | inutilizable |
| Referencia PyTorch | 81,0% | 42 / 421 ms | 89 / 526 ms |
El archivo más rápido pierde dos puntos y medio de precisión, lo que en un router significa prompts reales enviados al modelo equivocado. En el EPYC, el int8 por tensor se desbordó y la precisión cayó a entre el 54% y el 80% según la configuración.
El int8 por bloques en el chip con VNNI conservó hasta el último punto de precisión. Ese es el que desplegamos. Dieciséis hilos fueron más lentos que ocho en las dos CPU, así que cada pod recibe ocho.
Pasar a int8 en una CPU con VNNI bajó el p95 de 1.066 ms a 228 ms.
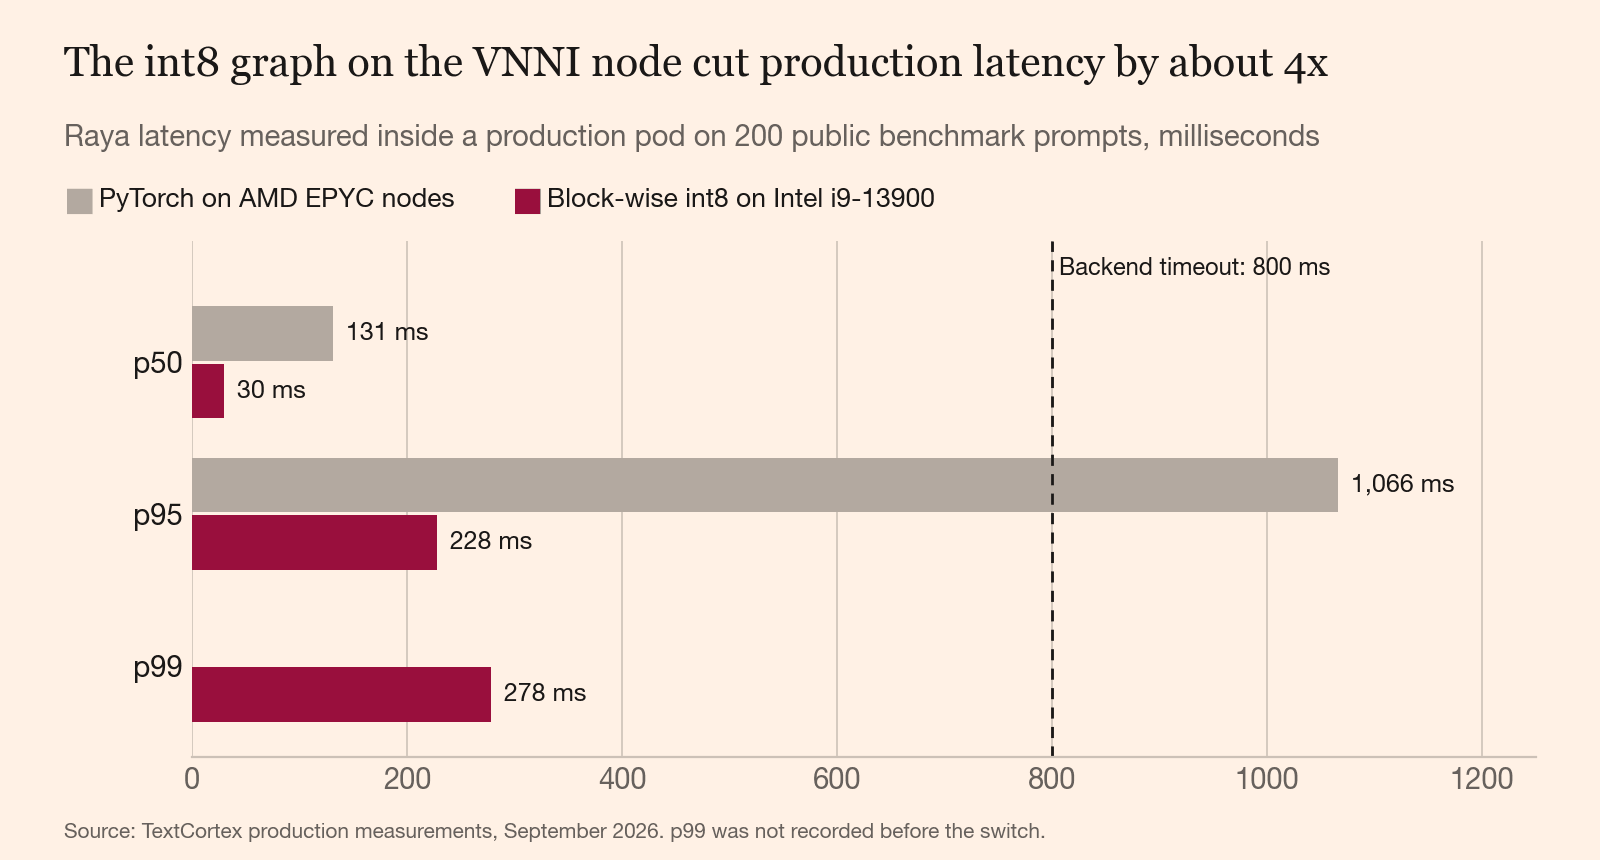
El primer despliegue en producción ejecutaba PyTorch en nuestros nodos EPYC. Su p95 era de 1.066 ms, por encima de los 800 ms que el backend espera antes de dar por perdido al router. Más de una petición de cada veinte habría superado el timeout.
Después del cambio, medido dentro de un pod de producción: 30 ms p50, 228 ms p95, 278 ms p99. Cada pod atiende entre 16 y 18 peticiones por segundo, frente a unas 4 antes. La imagen pasó de 4,0 GB a 1,0 GB. La precisión en el benchmark es del 81,5%, frente al 81,0% del original en PyTorch.
La aritmética int8 depende de la CPU, así que la imagen se comprueba a sí misma. El build verifica el SHA-256 del archivo del modelo. Cada pod se niega a arrancar en una CPU sin VNNI y compara sus respuestas con la referencia de PyTorch antes de aceptar tráfico.
El servidor cuesta 84 € al mes y ya estaba en la factura.
Nuestro clúster corre sobre el Kubernetes gestionado de Cloudfleet, con servidores dedicados de Hetzner como nodos. El nodo de Raya tiene la misma especificación que el EX101 de Hetzner: un i9-13900, 64 GB de memoria ECC y dos discos NVMe de 1,92 TB. Hetzner lo anuncia a 84 € al mes más 39 € de alta, sin IVA (septiembre de 2026). Cloudfleet cobra por vCPU aparte, de 2,45 € a 7,25 € al mes según el plan.
No compramos nada para Raya. El nodo ejecutaba otras cargas con el 22% de su CPU reservada. Con los pods de Raya está al 86%. El router nos costó capacidad ociosa en una máquina que ya estábamos pagando.
El techo, como estimación: dos pods de producción atienden unas 32 peticiones por segundo, o aproximadamente 83 millones de decisiones de enrutado en un mes de 30 días. Si le cargas a Raya el servidor entero, sale a más o menos 1 € por millón de decisiones a plena carga, sin IVA ni la tarifa de Cloudfleet. Con el tráfico real, lo que cuenta son los 84 € fijos.
Todo depende de un solo servidor.
Solo un nodo de nuestro clúster tiene VNNI, así que los dos pods de producción están fijados a él. Si ese servidor muere, los pods se quedan en pending y Auto envía todos los prompts a medium. Es el router constante del primer artículo. El chat sigue funcionando hasta que el nodo vuelve.
El nodo además está lleno. Con el 86% reservado no cabe un tercer pod, así que pasar de unas 32 peticiones por segundo implica alquilar un segundo servidor con VNNI. Con ocho peticiones simultáneas por pod, el p95 sube a unos 1,2 segundos, por encima del timeout de 800 ms, y el exceso cae a medium. El tráfico actual de Auto está muy lejos de eso.
Y mientras escribo esto, ninguna petición de cliente llega a Raya. El smoke test enruta correctamente los tres niveles en staging y en producción. El cambio del backend que lo llama sigue en revisión.
Un modelo abierto al que le haces fine-tuning le gana a uno que solo descargas.
Laya de serie perdió contra una constante. Seis minutos de entrenamiento con nuestras propias etiquetas cerraron la mayor parte de la distancia con un modelo alojado, y un servidor con CPU de 84 € cerró la de latencia.
Jev sigue siendo mejor en las preguntas de elección. Tampoco tiene despliegue en la UE. Para una empresa europea, un router tres puntos peor que corre en Falkenstein le gana a uno mejor que corre en algún sitio al que no podemos enviar el prompt.
Raya es público bajo Apache-2.0, con los archivos ONNX, sus checksums y los resultados brutos del benchmark en su model card. Ejecútalo con tus propios prompts contra return "medium". Si no lo supera por diez puntos con tu tráfico, dímelo y también lo publicaré.