Tradotto automaticamente. Leggi l’originale in inglese: Your performance review is a memory test →
Chiedete a qualsiasi engineering manager chi sia il suo miglior ingegnere. La risposta arriva prima che abbiate finito la domanda, senza esitazione e senza “fammi prima controllare qualcosa”. Lo sanno. Lo hanno sempre saputo.
Ora chiedete loro di mostrare il lavoro.
Otterrete una storia. Una bella storia, di solito, su un incidente gestito da qualcuno alle 2 di notte, o un refactor che ha sbloccato un trimestre. Quello che non otterrete è un numero, un confronto, o un resoconto dei quattro ingegneri il cui lavoro il manager non era in stanza a vedere. Quella sicurezza è costruita sul ricordo, e il ricordo è funzione della prossimità.
Ecco la tesi. La performance ingegneristica viene giudicata dalla memoria, la memoria premia la visibilità piuttosto che il valore, e il lavoro che volete davvero che le persone facciano è scritto in una roadmap che non è mai collegata alla cosa su cui li valutate. Quei due documenti non hanno nulla a che fare l’uno con l’altro in quasi ogni azienda che ho visto, inclusa la mia.
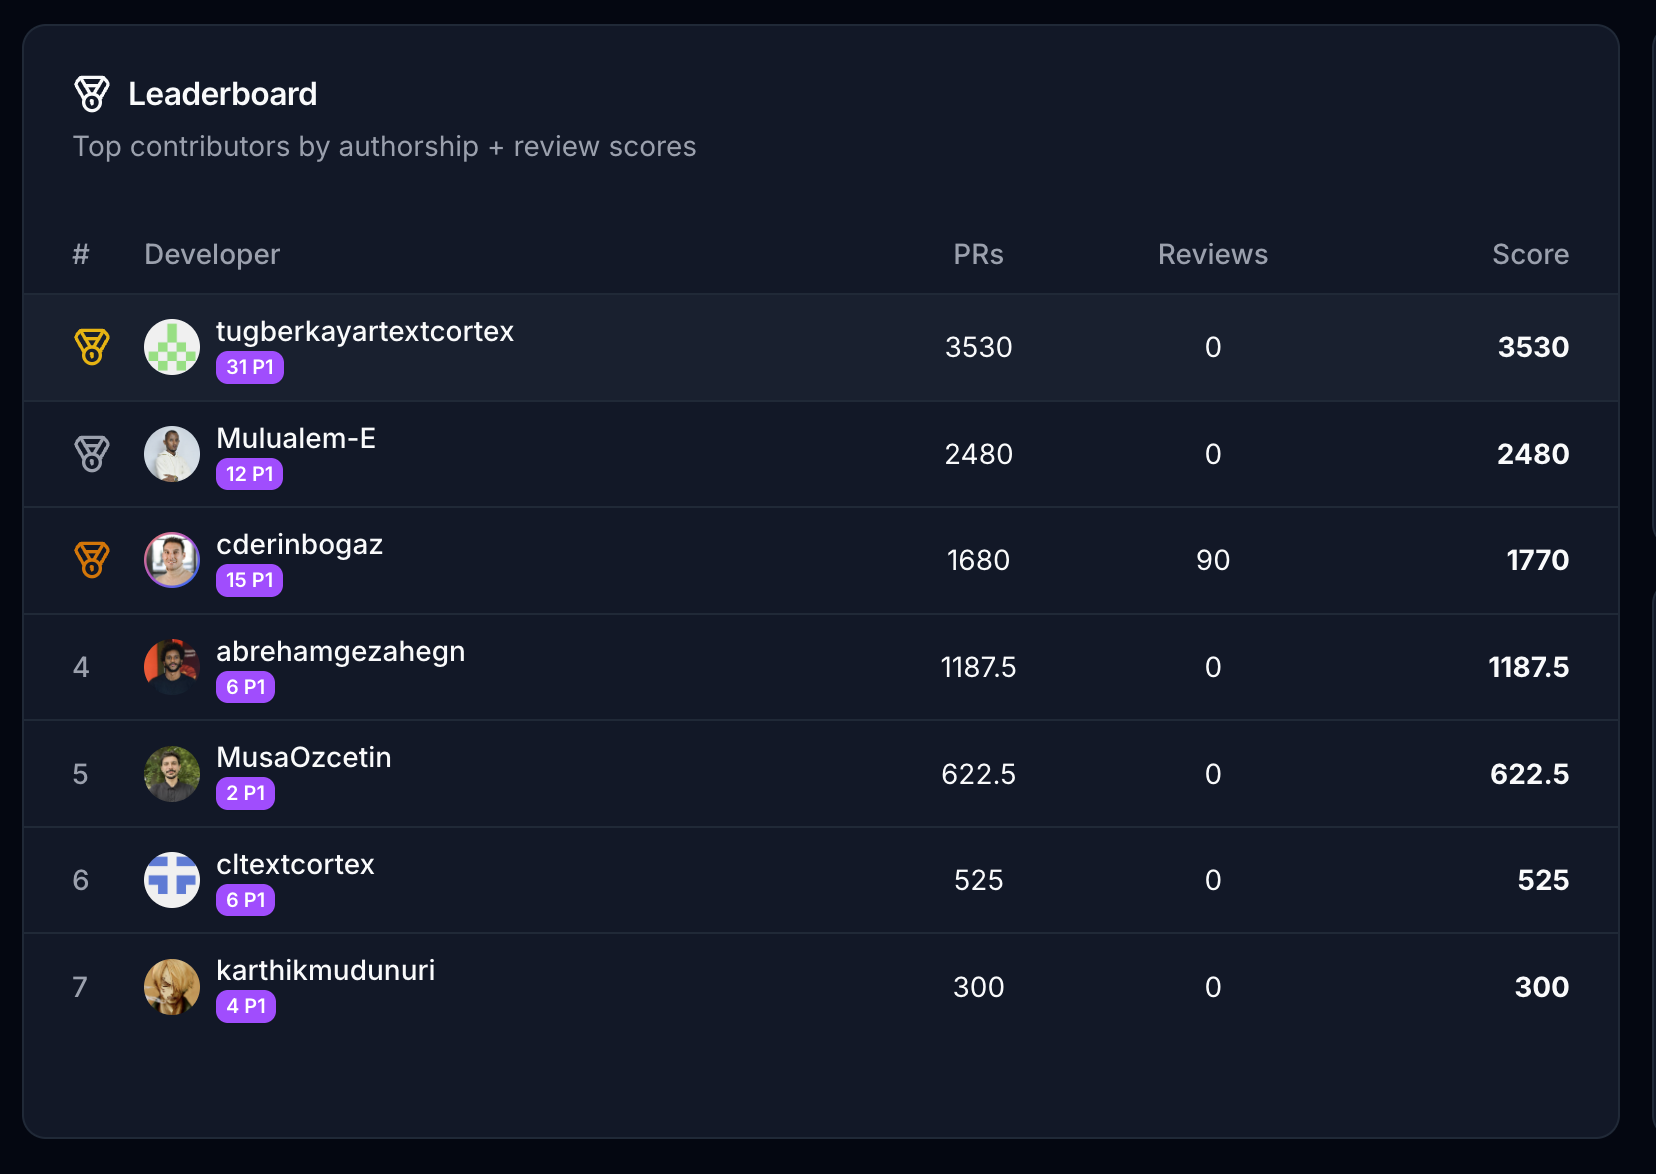
Quindi li abbiamo collegati. Ogni pull request mergiata viene letta da un modello, riceve una severità, e viene moltiplicata per quanto la nostra roadmap tiene al componente che ha toccato. Il risultato è una leaderboard mensile, che alimenta le decisioni sui bonus. Ecco la nostra.
La saggezza comune dice che questo non si può misurare, e la saggezza comune è un’alzata di spalle
La posizione standard sulla misurazione del contributo individuale è che non si deve, perché ogni proxy è una trappola. Le righe di codice premiano il gonfiore. Il numero di commit premia lo spezzettamento. I ticket chiusi premiano chi si accaparra prima quelli piccoli. Gli story point sono una negoziazione che avviene prima che il lavoro inizi. Anche i framework buoni sono deliberatamente a livello di team: DORA misura quattro cose su una pipeline di delivery e non dice nulla sulle persone, e i suoi autori lo dichiarano esplicitamente.
Tutto questo è corretto, e nessuna di queste è una risposta. La classifica avviene comunque, ogni anno, al momento della retribuzione, in una stanza, dalla memoria, pesata da chi sedeva accanto alla persona in quella stanza. Rifiutarsi di misurare vi compra una classifica senza traccia di audit e senza appello.
Chiamatelo loud engineer premium: il divario tra quanto siete valutati e quanto avete performato, spiegato interamente dalla vostra distanza da chi scrive la vostra review. Chiedete a qualsiasi essere umano di confrontare i contributi tecnici di quindici persone nell’arco di un anno usando solo ciò che gli è capitato di notare, ed è questo che ne esce. Chiunque di noi lo produrrebbe.
Quel premio era inevitabile fino a circa due anni fa, perché la materia prima per una risposta migliore era una pila di diff che nessuno aveva tempo di leggere. Quel vincolo è sparito. Un modello può leggere ogni diff del vostro repository ogni mese per meno del costo della riunione in cui attualmente tirate a indovinare. Leggerli è la parte facile. Decidere quanto vale la lettura è tutto il problema, e non è una questione tecnica.
L’intera formula sta in una riga
Eccola, per intero, dal percorso di scoring in GitRank:
final_score = is_eligible ? severity_base_points × component_multiplier : 0Non l’ho semplificata per il blog. È la riga così come viene eseguita, senza regressione nascosta, senza pesi appresi, senza termine di reputazione e senza aggiustamento per l’anzianità. Severità per importanza, o zero.
La severità è una scala fissa, impostata una volta e visibile a tutti quelli che vengono valutati.
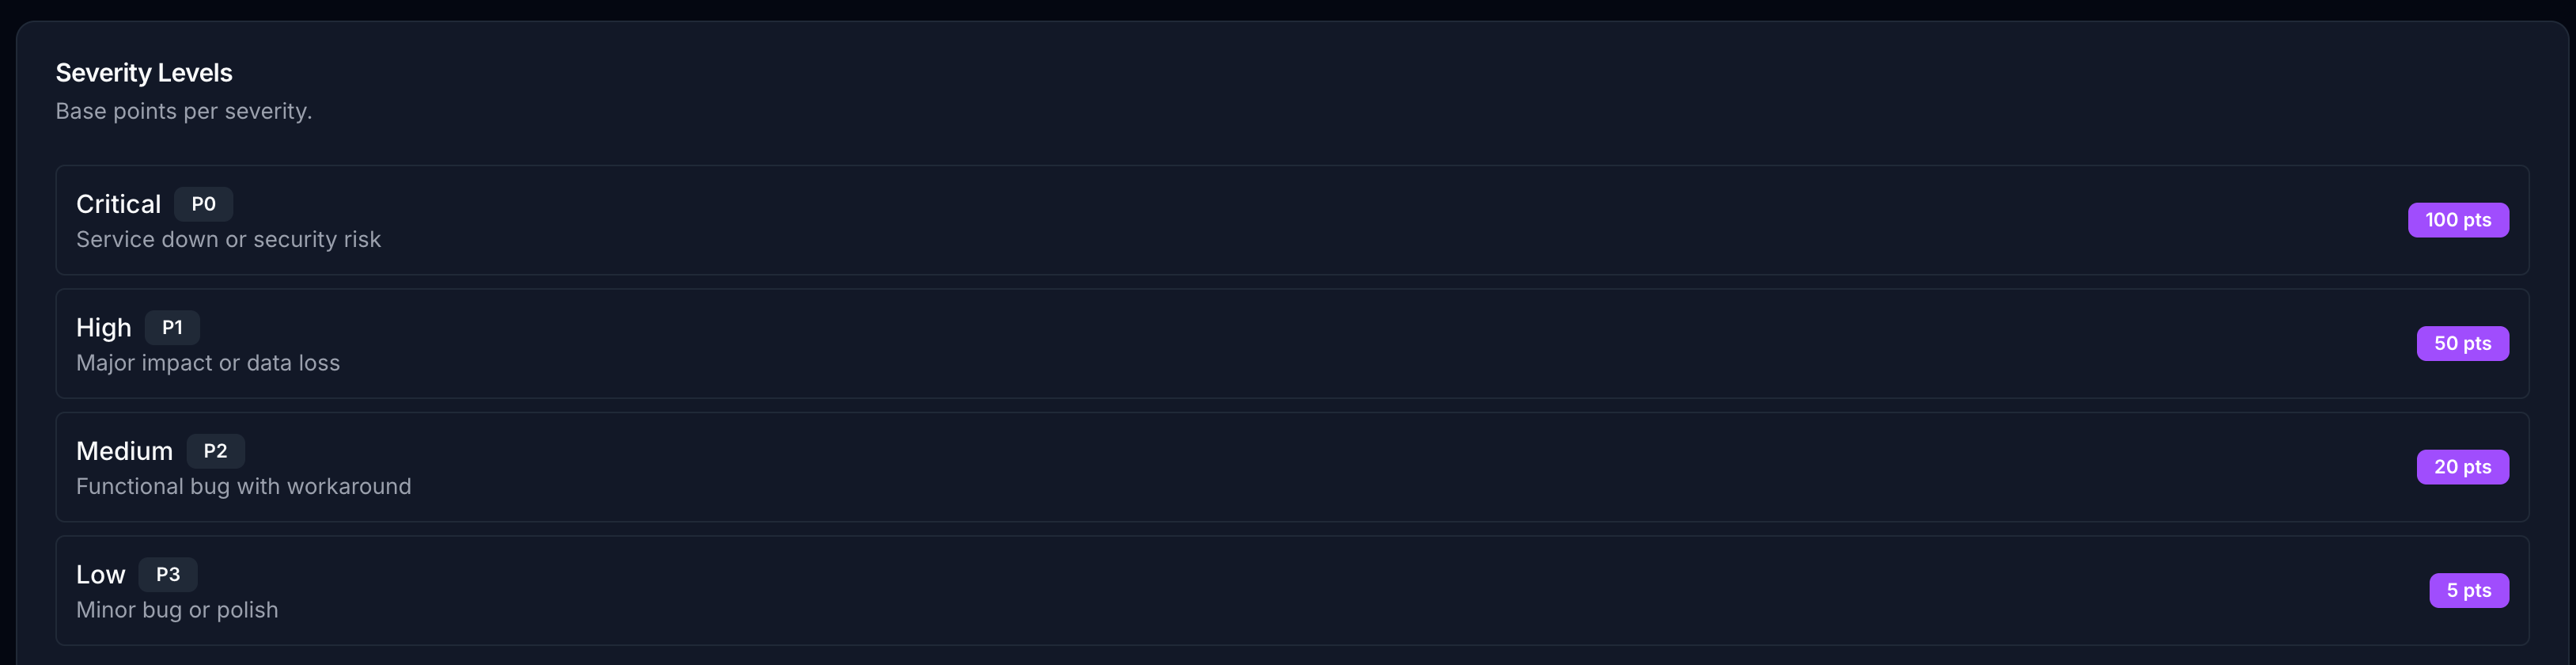
Un fix critico vale venti fix a bassa priorità. Quel rapporto è una dichiarazione di policy, e l’abbiamo scritta invece di lasciarla nella testa di qualcuno.
L’importanza è la metà che conta. Ogni componente porta un moltiplicatore, e il moltiplicatore è quello che il prodotto serve in questo trimestre.
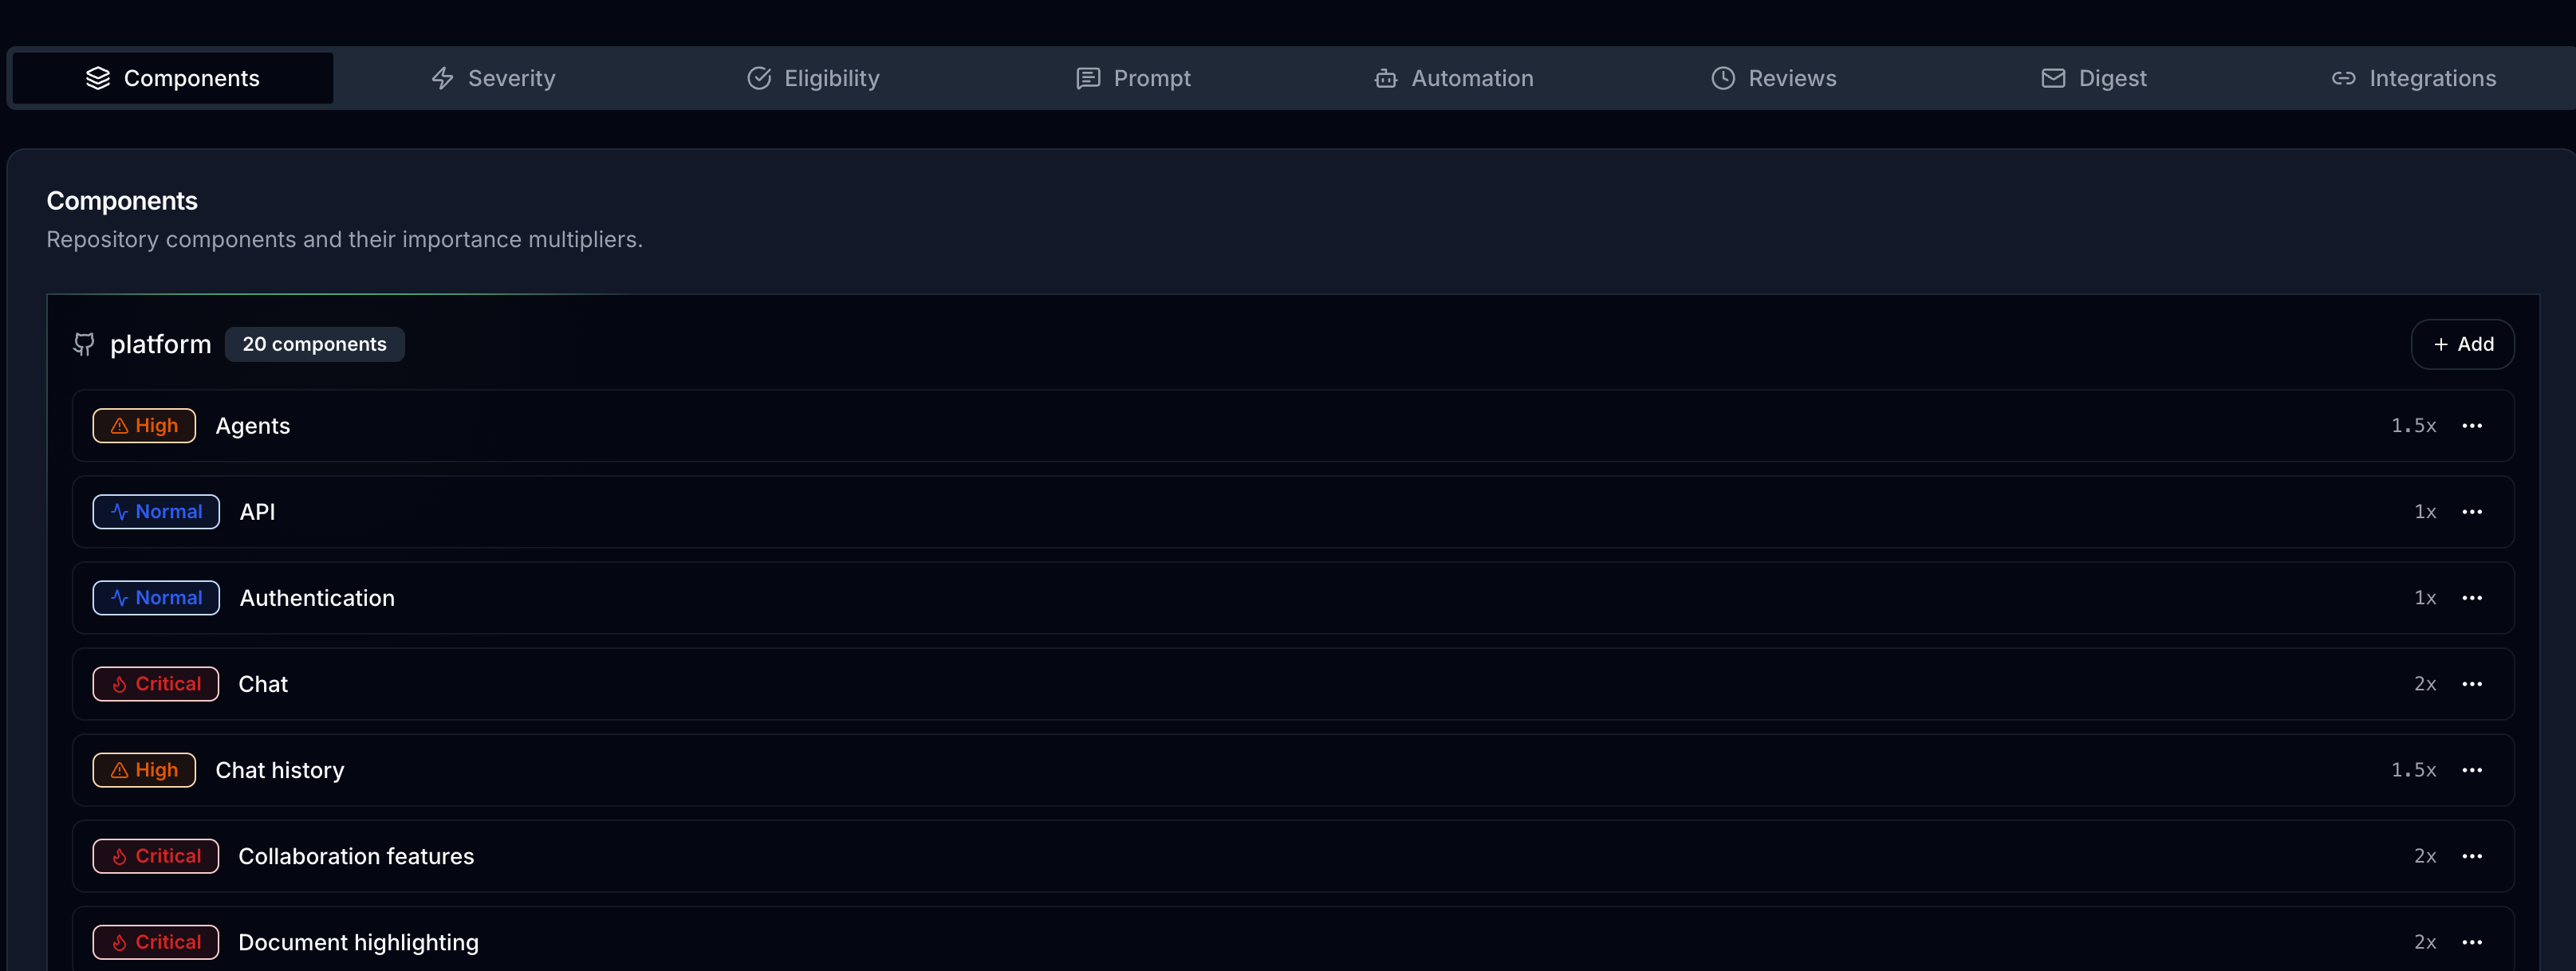
Chat è 2.0x perché chat è ciò su cui stiamo puntando il prodotto. Authentication è 1.0x perché funziona e vorremmo che continuasse a funzionare in silenzio. Quelle sono decisioni di prodotto, e la tabella dei moltiplicatori è il punto in cui vengono riscritte in un campo che paga.
Il documento di strategia e l’input per la retribuzione sono diventati lo stesso documento. Questa è la mossa. Il modello è infrastruttura e la leaderboard è una sua resa, e se la roadmap cambia a ottobre allora l’incentivo cambia a ottobre, invece che in un ciclo di review a quattordici mesi di distanza.
Lasciatemi spiegare questo punto, perché è la parte che la gente salta. Quaranta persone intelligenti, ognuna che ottimizza localmente e onestamente, produrranno un trimestre di lavoro che non somma alla cosa che l’azienda ha detto di volere. Nessuno in quel quadro è pigro, ed è questo che lo rende difficile. Il middle management esiste in gran parte per risolverlo, portando la strategia in giro in conversazioni, una scrivania alla volta, perdendo fedeltà a ogni passaggio. Una tabella di moltiplicatori fa lo stesso routing in un solo passaggio, e a ottobre dice ancora esattamente quello che ci avete digitato a gennaio.
Joi Ito aveva già dato un nome a questa differenza. Uno dei nove principi di Whiplash, scritto con Jeff Howe nel 2016, è pull over push: si tira dalla rete ciò che serve quando serve invece di tenere tutto in magazzino. Ito descriveva le risorse. La direzione si comporta allo stesso modo. Un’organizzazione push accumula la strategia in un livello di management e la distribuisce nelle conversazioni, ed è per questo che arriva ai margini dell’azienda in ritardo e con perdite. Un’organizzazione pull pubblica la strategia come un listino prezzi e lascia che le persone ne prendano ciò che serve. La tabella dei moltiplicatori è il listino prezzi.
Una fix critica in chat vale quaranta commit di rifinitura nell’API
Unisci le due metà e il divario è notevole. Una P0 in chat vale 100 base per 2.0, quindi 200 punti. Una P3 nell’API vale 5. Quaranta a uno, che è il divario tra la pull request più preziosa che puoi mergiare qui e la meno preziosa.
Quel rapporto è deliberatamente violento, e fa ciò che gli incentivi gentili non riescono mai a fare. Nessuno riorganizza la propria settimana attorno a una differenza del 15%. Le persone riorganizzano eccome la propria settimana attorno a una differenza di 40x.
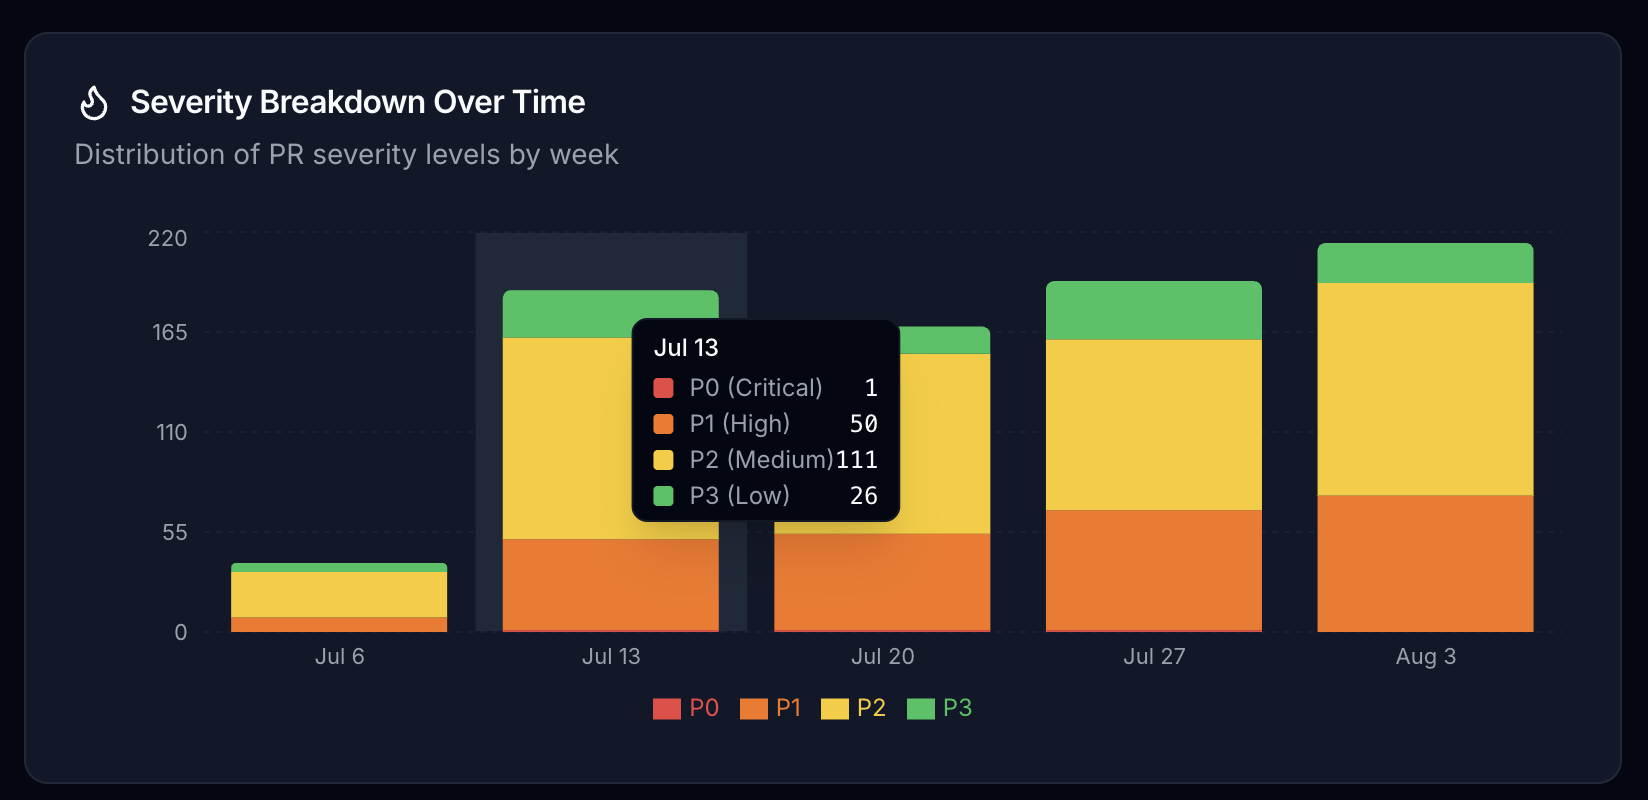
188 pull request in una sola settimana. Le P2 sono il 59% del totale, che è ciò a cui assomiglia una normale settimana di engineering ovunque. Ora pesale. Quelle 111 P2 valgono 2.220 punti. Le 50 P1 valgono 2.500. Meno della metà delle pull request porta più della metà del valore della settimana. Conta le pull request e concludi che la settimana era fatta di P2. Se le pesi, la settimana era fatta di cinquanta specifici pezzi di lavoro, e puoi dire chi li ha fatti.
Due persone erano il 58% della produzione, e avevo l’ordine sbagliato
Sette sviluppatori, 10.415 punti. Il primo sviluppatore ne detiene 3.530, il 33,9% di tutto ciò che il team ha prodotto in termini di valore. I primi due ne detengono il 57,7% in totale.
Una concentrazione del genere di solito significa che i primi due stanno lavorando sui componenti con il moltiplicatore più alto, che è esattamente ciò che abbiamo chiesto loro di fare. Il numero descrive dove sta atterrando il valore, e non ci leggerei nulla riguardo agli altri cinque.
L’ordinamento è ciò che ha mandato in frantumi la mia previsione.
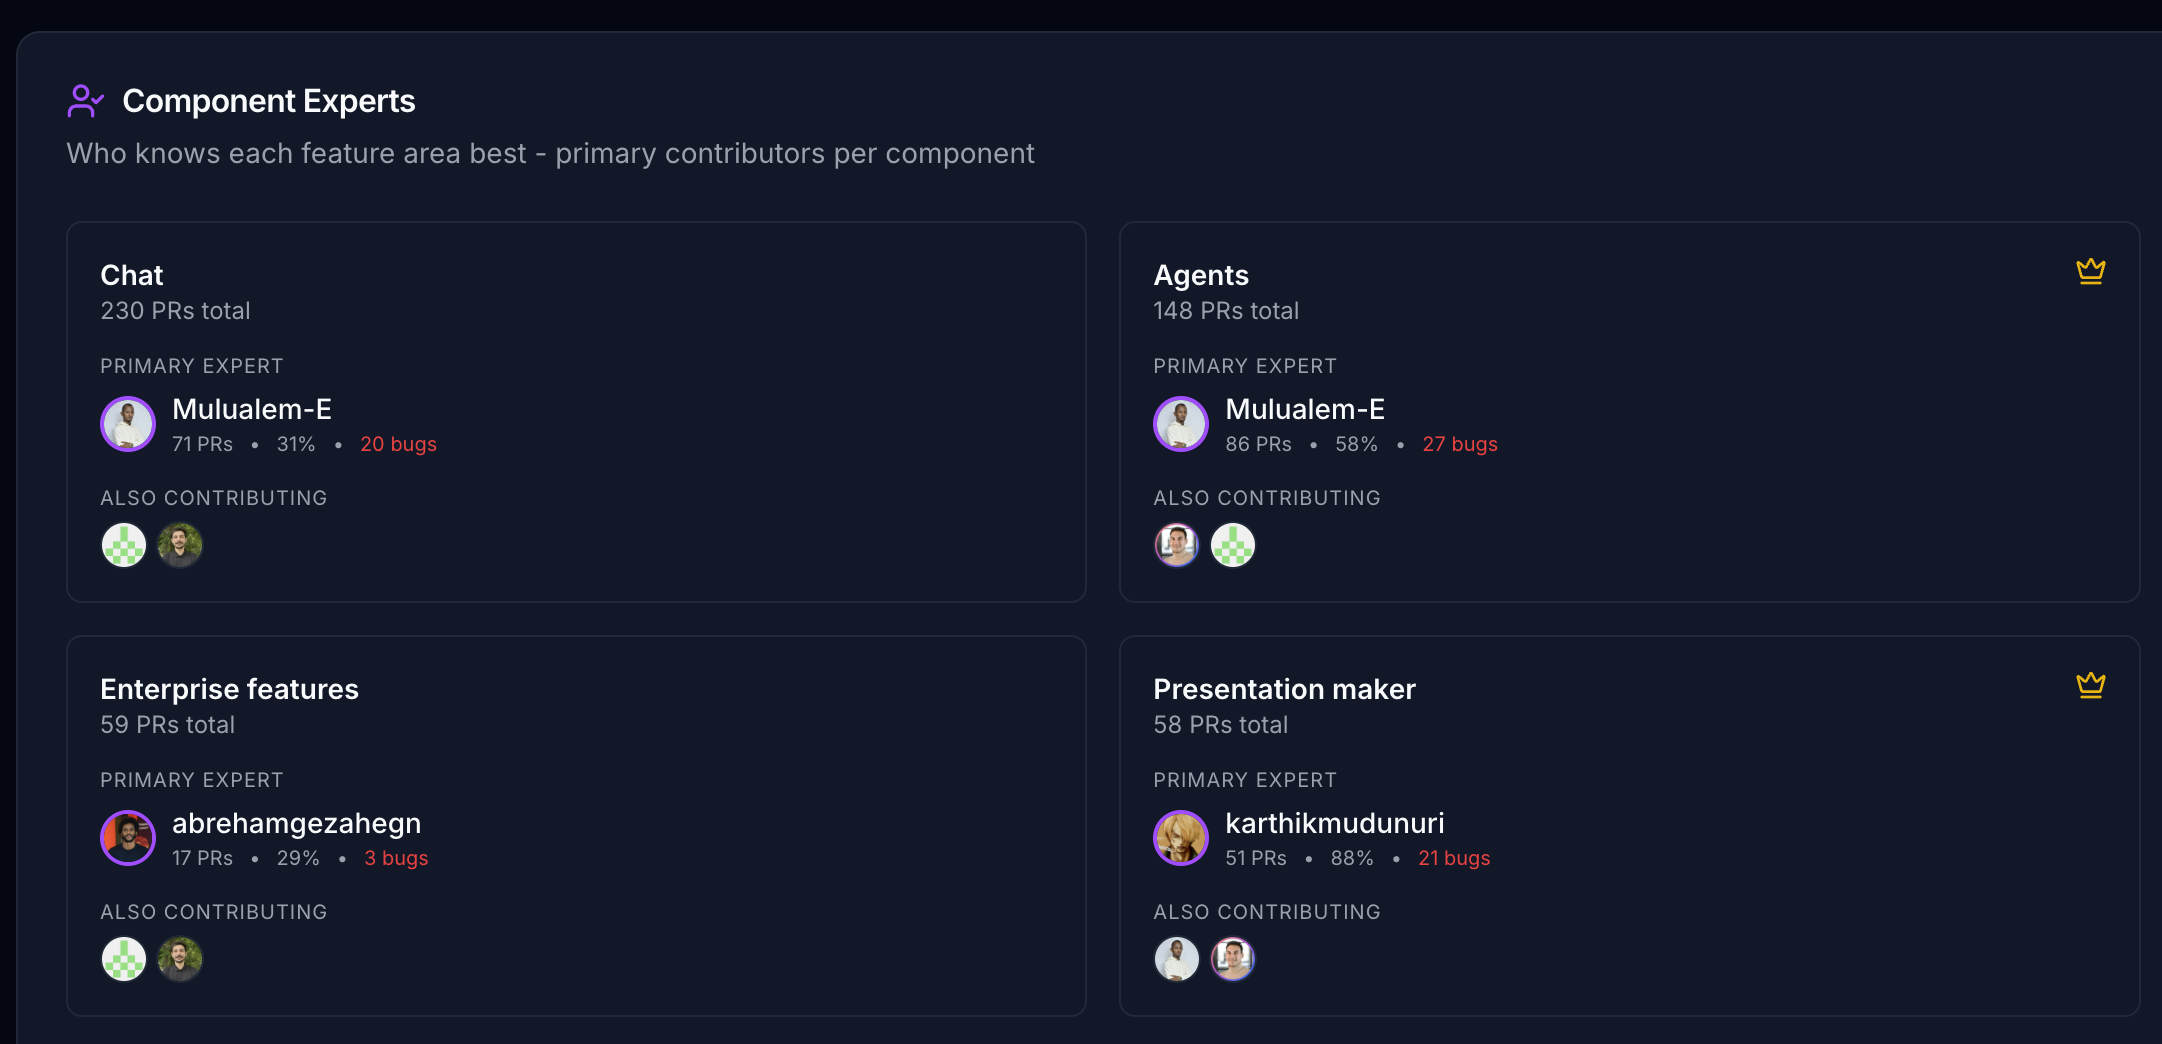
Mulualem-E è l’esperto principale su chat, il nostro componente da 2.0x, con 71 delle sue 230 pull request, e su agents, il nostro componente da 1.5x, con 86 delle 148. Se mi avessi descritto questa situazione e mi avessi chiesto chi è in cima alla leaderboard, avrei detto lui senza esitare. È secondo. Il primo posto va a tugberkayartextcortex, con 31 pull request P1 contro le 12 di Mulualem-E.
Il mix di severità ha battuto la proprietà dei componenti. Possedere l’area più importante del prodotto si rivela non essere la stessa cosa che portare a termine ripetutamente lavoro ad alto impatto al suo interno, e finché non abbiamo pubblicato questo non avrei saputo dire quale dei due la nostra compensazione stesse premiando. Premiava quello che mi era capitato di notare. Questo è il premio per l’ingegnere rumoroso, colto nella mia stessa azienda. La mia intuizione aveva le due persone giuste e l’ordine sbagliato, e l’ordine sbagliato è ciò che un bonus premia.
Payments è al 45% di bug fix e nessuno ha dovuto discuterne
Assegnare un punteggio a ogni pull request mette anche fine all’abitudine di discutere della qualità partendo da aneddoti.
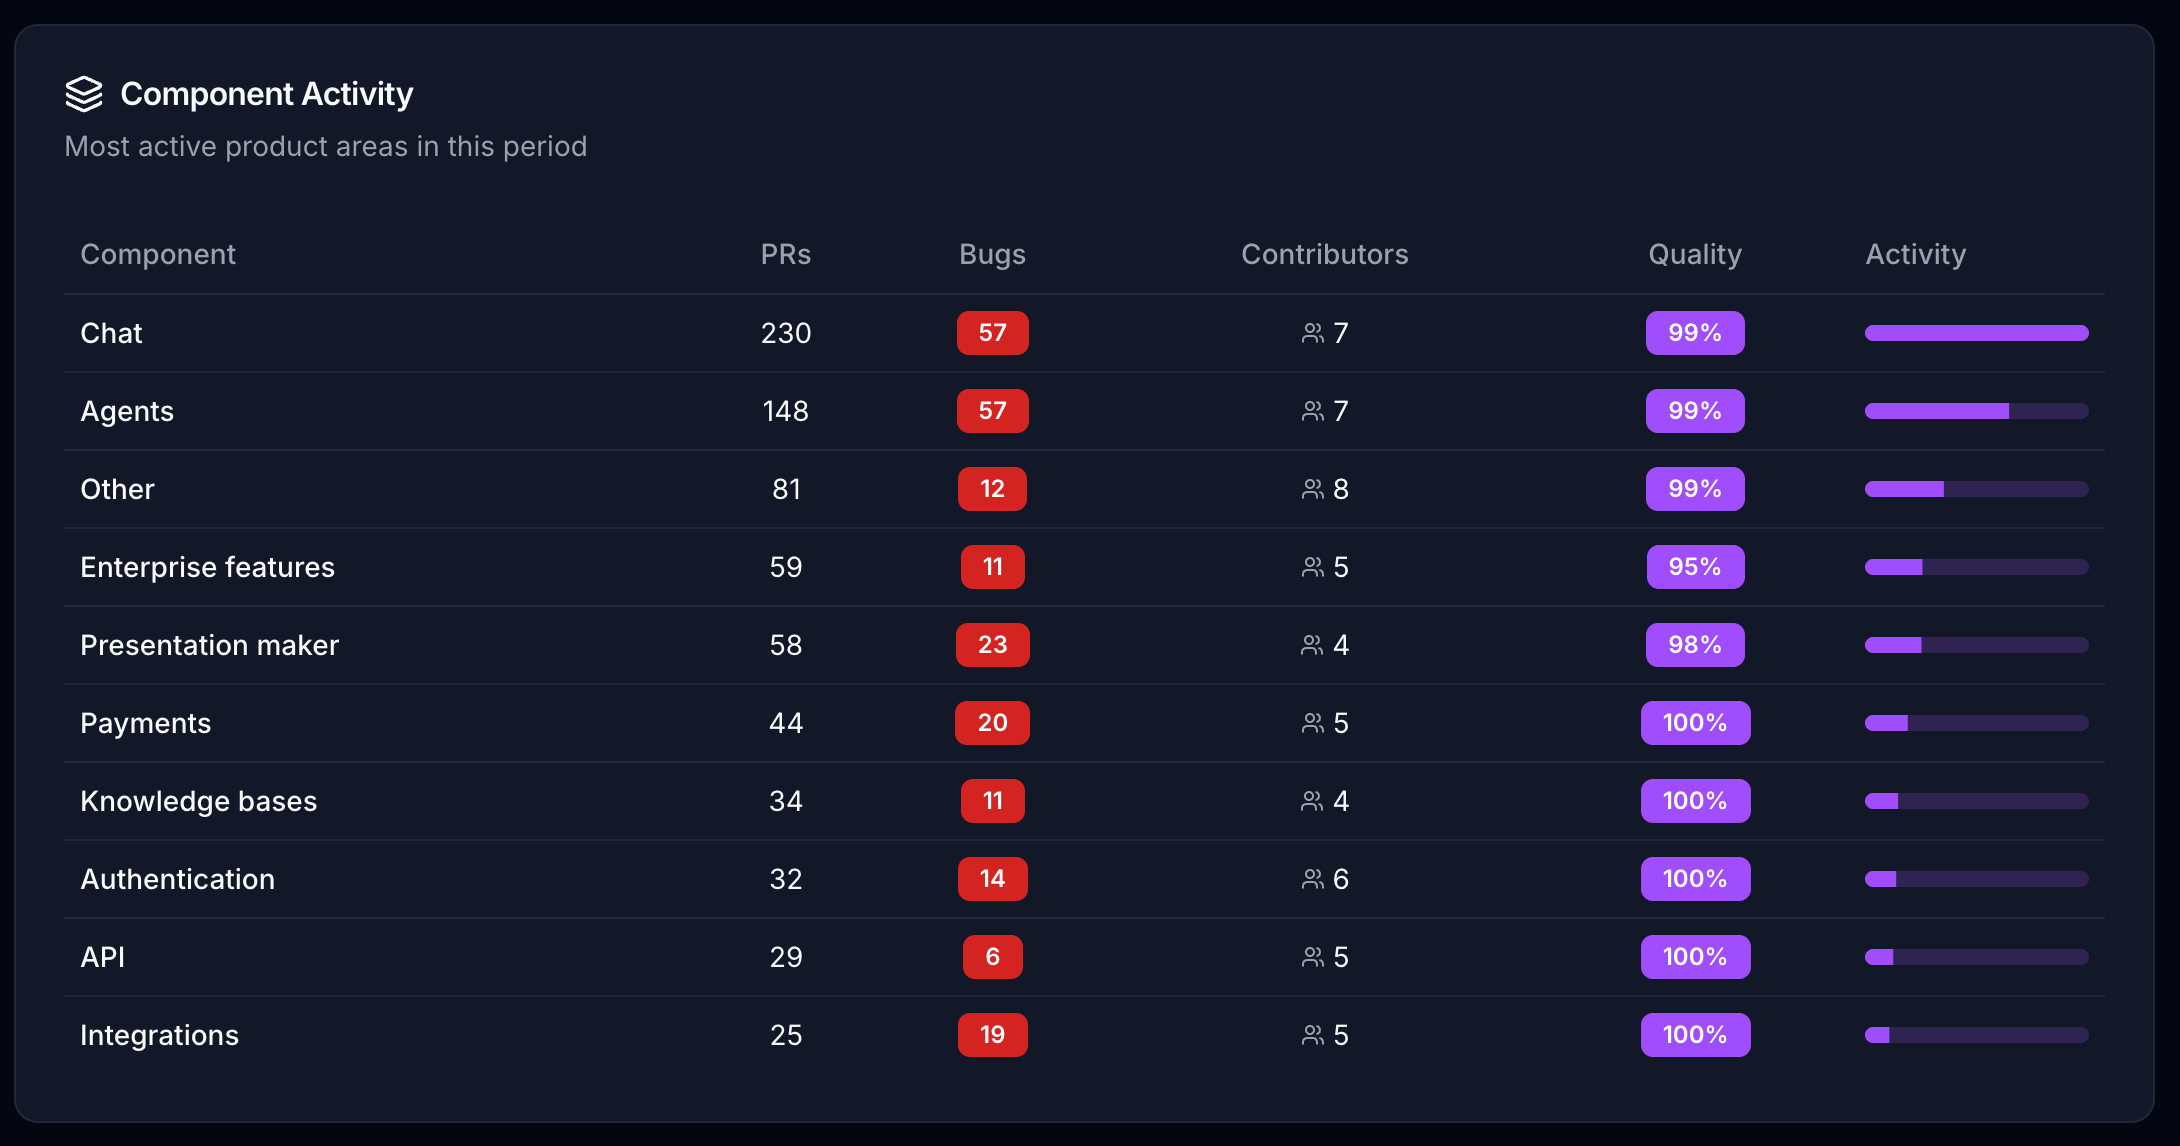
740 pull request nei dieci componenti più trafficati, 230 delle quali bug fix piuttosto che nuovo lavoro. La sola chat è 230 pull request, che è ciò a cui assomiglia un moltiplicatore da 2.0x quando funziona. Poi payments: 44 pull request, 20 bug, un tasso di bug del 45% nel componente che tocca il denaro.
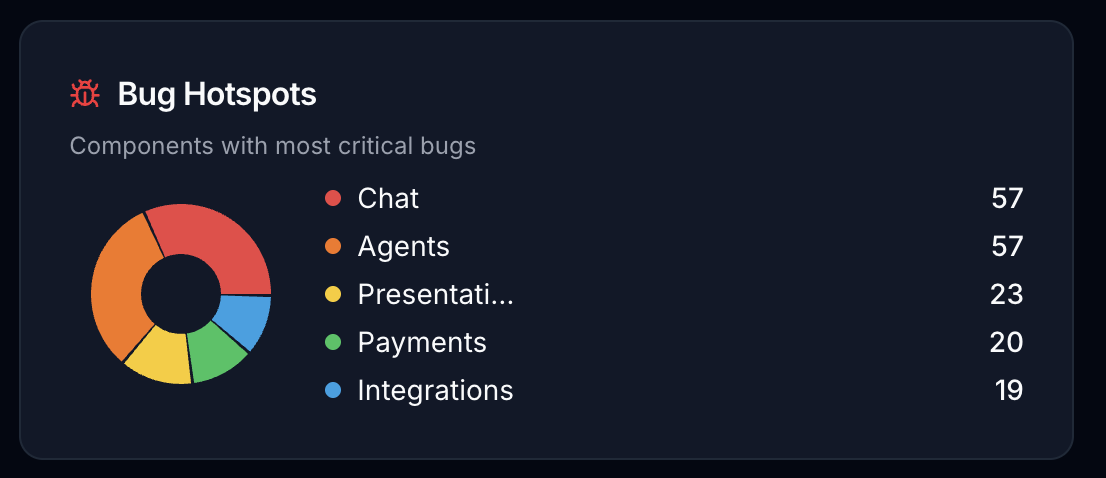
Chat e agents sono pari a 57 bug ciascuno, ma chat li ha prodotti in 230 pull request e agents in 148. Stesso numero di bug, il 55% di lavoro in più dietro uno dei due. Questo è un segnale su agents che nessuna retrospettiva avrebbe fatto emergere, perché nessuno aveva mergiato abbastanza di entrambi per accorgersene.
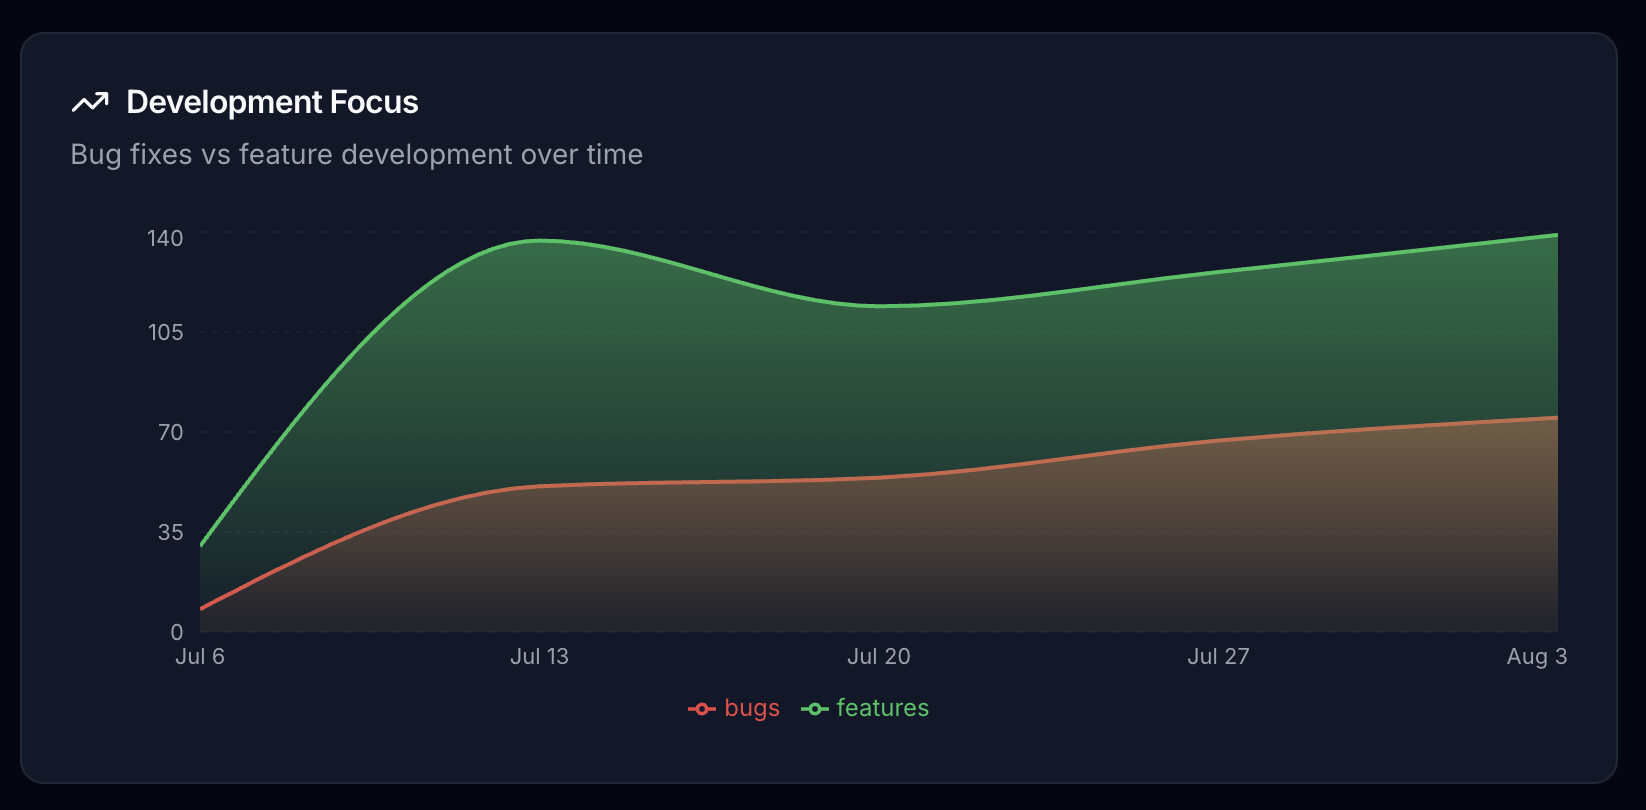
Bug e funzionalità salgono insieme invece di compensarsi. Cinque settimane sono ben dentro il rumore che produrrebbe l’arrivo di un singolo grande progetto, quindi tratta quel grafico come una descrizione del periodo e niente di più.
Non ho un numero di impatto, e non dovreste fidarvi di chi ce l’ha
Ecco l’affermazione che vorrei fare. Da quando pubblichiamo questo ogni mese, il lavoro si è spostato verso i componenti che abbiamo marcato come importanti, perché gli ingegneri vogliono il punteggio.
Non ci metto una percentuale sopra. L’abbiamo attivato in corso d’opera. Non c’era una baseline né un repository di controllo, e non abbiamo mai concordato in anticipo cosa significasse “spostato”. I moltiplicatori sono cambiati durante il periodo. Anche l’organico. Qualsiasi numero pubblicassi sarebbe uno scelto dopo aver visto i dati, il che lo rende decorazione.
Quello che è cambiato è la discussione. Le persone hanno smesso di chiedersi se il loro lavoro fosse apprezzato e hanno iniziato a chiedere perché un componente fosse valutato 1.0x. È una battaglia migliore da avere, ed è l’unica cosa per cui avrei pagato da sola.
Anche il nostro strumento non è pulito, e il lato più tagliente è questo: una pull request che ottiene zero non ti dice quale criterio di ammissibilità si è chiuso su di essa. Manca il link all’issue o i test e il punteggio è zero indipendentemente dalla gravità, e la persona che ha più di cui discutere riceve il minimo con cui discutere. Stiamo sistemando questo prima di qualsiasi altra cosa nella lista.
Puntalo sulla roadmap, poi consegna alle persone il righello
Togli l’autorità da un organigramma e ciò che resta sotto è una tabella di routing. Porta “cosa conta questo trimestre” verso l’esterno dalle persone che lo hanno deciso, e “chi ha fatto cosa” verso l’interno, e fa entrambe le cose lentamente e con distorsione a ogni salto. Tutto ciò che non ti piace della politica aziendale è un artefatto di compressione di quel routing. I manager sono stati l’unico hardware disponibile per il lavoro.
Non sono più l’unico hardware disponibile ora. Un modello che legge ogni diff, più una tabella di moltiplicatori, fa il routing verso l’esterno in un salto e quello verso l’interno in una query. Questa è l’organizzazione pull, e voglio essere preciso sui suoi limiti. Niente viene appiattito. La leadership imposta ancora i moltiplicatori, quindi la strategia è ancora decisa in una stanza da poche persone, e tutto ciò che cambia è il viaggio fuori da quella stanza. Ciò che resta per gli umani è la parte che è sempre stata il lavoro e non ha mai avuto tempo: decidere quali dovrebbero essere i moltiplicatori, e stare con le persone che quelle decisioni hanno toccato.
La politica non scompare. Si sposta. Si sposta da “il mio manager si ricorda del mio trimestre” a “perché il mio componente è valutato 1.0x quando la roadmap lo chiama core”, e quella seconda battaglia riguarda la strategia reale dell’azienda, condotta in pubblico, in una tabella che chiunque può leggere. Preferirei avere quella battaglia ogni mese piuttosto che quella attuale, tenuta una volta all’anno, in privato, da qualcuno che ricostruisce undici mesi dalla memoria.
Qualcuno gestirà questo male. Qualcuno metterà un tabellone su un muro senza spiegazioni di ammissibilità e senza traccia di override e licenzierà il decile inferiore, e la colpa sarà data al modello piuttosto che alla persona che ha scelto i moltiplicatori.
Quindi misuratemi con lo stesso strumento. Se gestisci qualcosa del genere, pubblica la tabella dei moltiplicatori, così le persone discutono con la strategia piuttosto che con il punteggio. Pubblica la ripartizione per pull request, così chiunque abbia ottenuto zero può vedere quale cancello si è chiuso su di loro e fare appello. Pubblica il log degli override, perché un numero che un umano ha cambiato a mano è l’unico numero che vale la pena di verificare. Pubblichiamo il primo. Facciamo il terzo male. Non pubblichiamo affatto il secondo, ed è quello che decide se una cosa del genere è uno strumento di gestione o solo un modo più veloce per essere ingiusti.
GitRank è su gitrank.dev ed è concesso in licenza CC BY-NC 4.0. Lo scoring sul percorso di produzione gira su Claude Haiku 4.5 a temperatura 0.3. Tutte le cifre sopra provengono dal nostro repository di piattaforma tra il 6 luglio e il 3 agosto 2026, dimensione del campione un’azienda e sette sviluppatori, che è una descrizione di noi e non un benchmark di nulla.