Tradução automática. Ler o original em inglês: Our LLM router runs at 30 ms p50 on an €84/month Hetzner server, no GPU →
Há dois dias publiquei um benchmark que mostrava que as alternativas abertas ao Jev perdem contra um “medium” fixo no código. O Jev encaminhou 84,5% de 563 prompts reais para o tier de modelo certo. Laya e Von, os modelos abertos, chegaram no máximo a 61,6%.
Depois tentámos comprar o Jev e não conseguimos. A TextCortex vende a empresas europeias, e quando olhámos, em setembro de 2026, não havia nenhum deployment do Jev na UE para comprar. Um router lê cada prompt que um cliente escreve, por isso tem de correr onde os dados do cliente estão autorizados a ir.
Então peguei no modelo que perdeu e fiz-lhe fine-tuning. O resultado é o Raya, um router de 300 milhões de parâmetros que faz 81% no mesmo benchmark. Corre agora no nosso cluster de produção num CPU em Falkenstein, na Alemanha, com 30 ms de latência mediana, num servidor Hetzner que custa 84 € por mês e que já estava na nossa fatura.
O melhor router não tinha região na UE, por isso fizemos fine-tuning ao que perdeu.
O Laya é um modelo de decisão Apache-2.0: um encoder mmBERT com uma pequena cabeça que pontua cada opção de uma pergunta de escolha múltipla. Fala a mesma API que o Jev. Tal como vem de origem, encaminhava pior do que uma constante.
Dois anotadores cegos, Claude Opus e Claude Sonnet, tinham etiquetado prompts do WildChat com a mesma rubrica escrita. O Raya treina com as etiquetas deles como soft targets, 50/50 onde discordaram, mais prompts difíceis sintéticos nas 14 línguas e alguns dados internos de encaminhamento. Os 563 prompts de teste vêm de shards do WildChat em que o treino nunca tocou.
O treino levou cerca de seis minutos numa única NVIDIA RTX A6000.
Seis minutos numa GPU deram ao Laya 25 a 34 pontos.
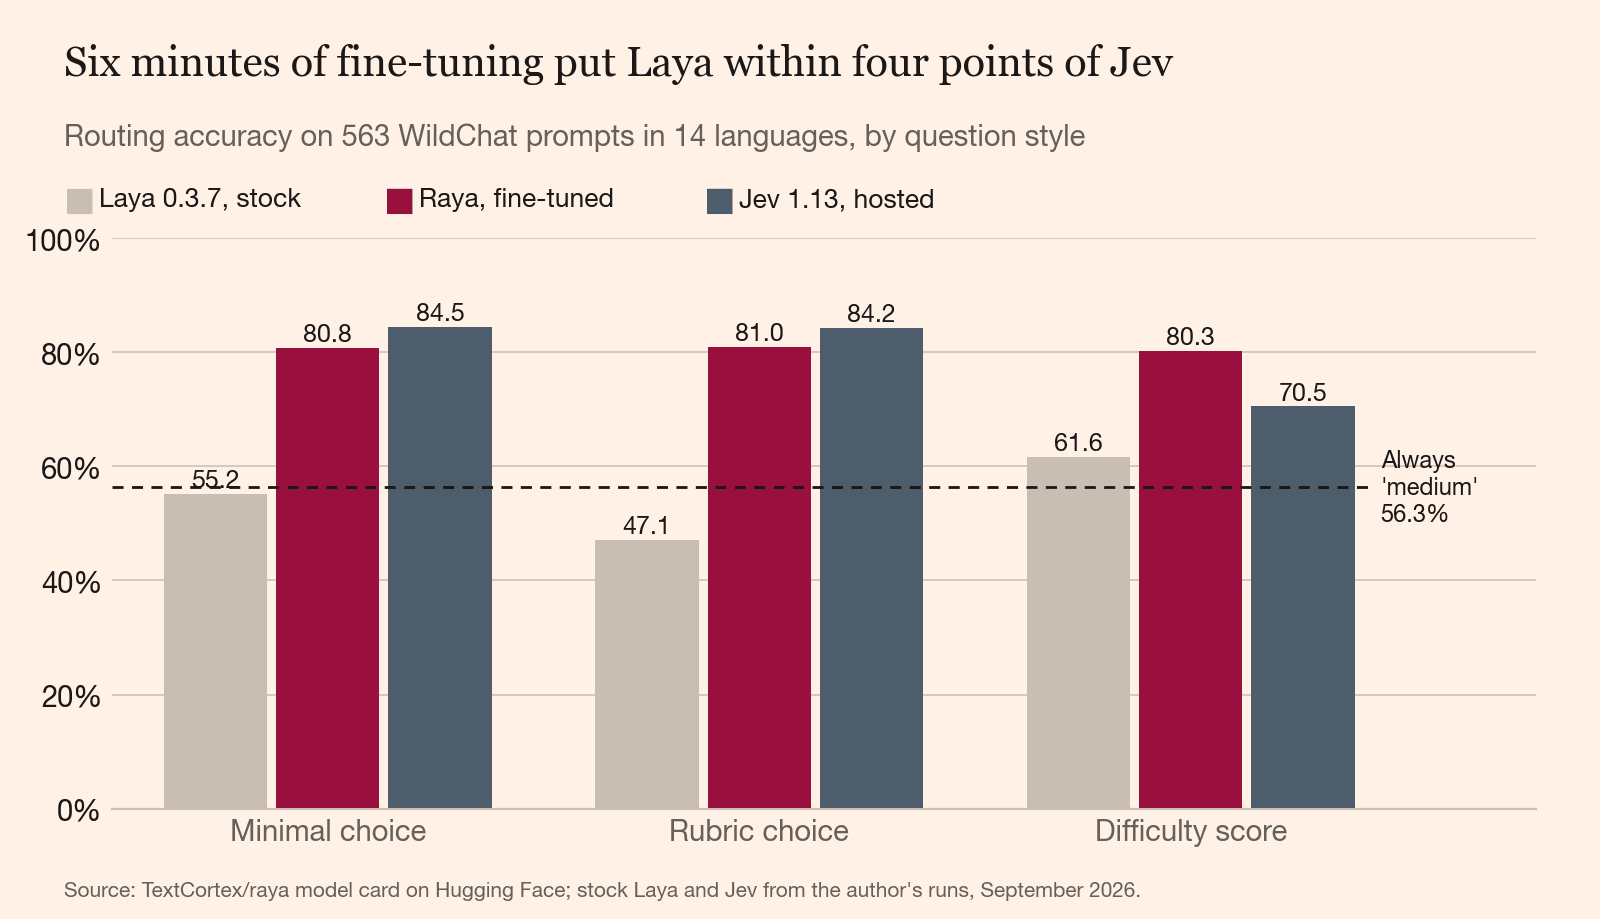
O Raya faz 80 a 81% nos três estilos de pergunta. Na pontuação de dificuldade bate o Jev por dez pontos (80,3% contra 70,5%, McNemar p < 0,001). Nas duas perguntas de escolha múltipla o Jev continua à frente por três a quatro pontos. Essa diferença não é significativa com este tamanho de amostra (p = 0,07 e 0,13), mas aparece nas duas, e eu apostaria que é real.
Agora a concessão, e é grande. O Raya aprendeu com os mesmos dois anotadores que escreveram as etiquetas de referência. O Jev nunca as viu. Parte dos 81% do Raya é vantagem de jogar em casa, e não lhe sei dizer quanto. Os anotadores só concordam entre si em 78% das vezes, por isso o Raya bateu no teto do que estas etiquetas conseguem medir.
O Raya também é mais fraco onde o Jev é mais forte. Na pergunta mínima faz 67% em turco contra 82% do Jev, e 76% em português contra 90%. Tal como o Jev, só manda 7 dos 21 prompts frontier para frontier.
Um classificador de 300M parâmetros não tem nada que fazer numa GPU.
O model card do Raya indica 17 ms numa GPU. Uma GPU inteira para uma pequena forward pass por prompt é muito hardware, por isso exportei o Raya para ONNX Runtime e testei cinco variantes em dois CPUs: um Intel i9-13900, que tem instruções int8 VNNI, e um AMD EPYC 7502P, que não tem.
| Ficheiro | Tamanho | Precisão | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
|---|---|---|---|---|
| fp32 | 1,23 GB | 81,2% | 38 / 297 ms | 60 / 487 ms |
| int8 por blocos | 0,89 GB | 81,5% | 34 / 282 ms | 127 / 975 ms |
| int8 por tensor | 0,92 GB | 79,0% | 24 / 200 ms | inutilizável |
| Referência PyTorch | 81,0% | 42 / 421 ms | 89 / 526 ms |
O ficheiro mais rápido perde dois pontos e meio de precisão, o que num router significa prompts reais enviados para o modelo errado. No EPYC, o int8 por tensor entrou em overflow e a precisão caiu para entre 54% e 80%, consoante as definições.
O int8 por blocos no chip com VNNI manteve todos os pontos de precisão. É esse que pomos em produção. Dezasseis threads foram mais lentas do que oito nos dois CPUs, por isso cada pod fica com oito.
Passar para int8 num CPU com VNNI cortou o p95 de 1.066 ms para 228 ms.
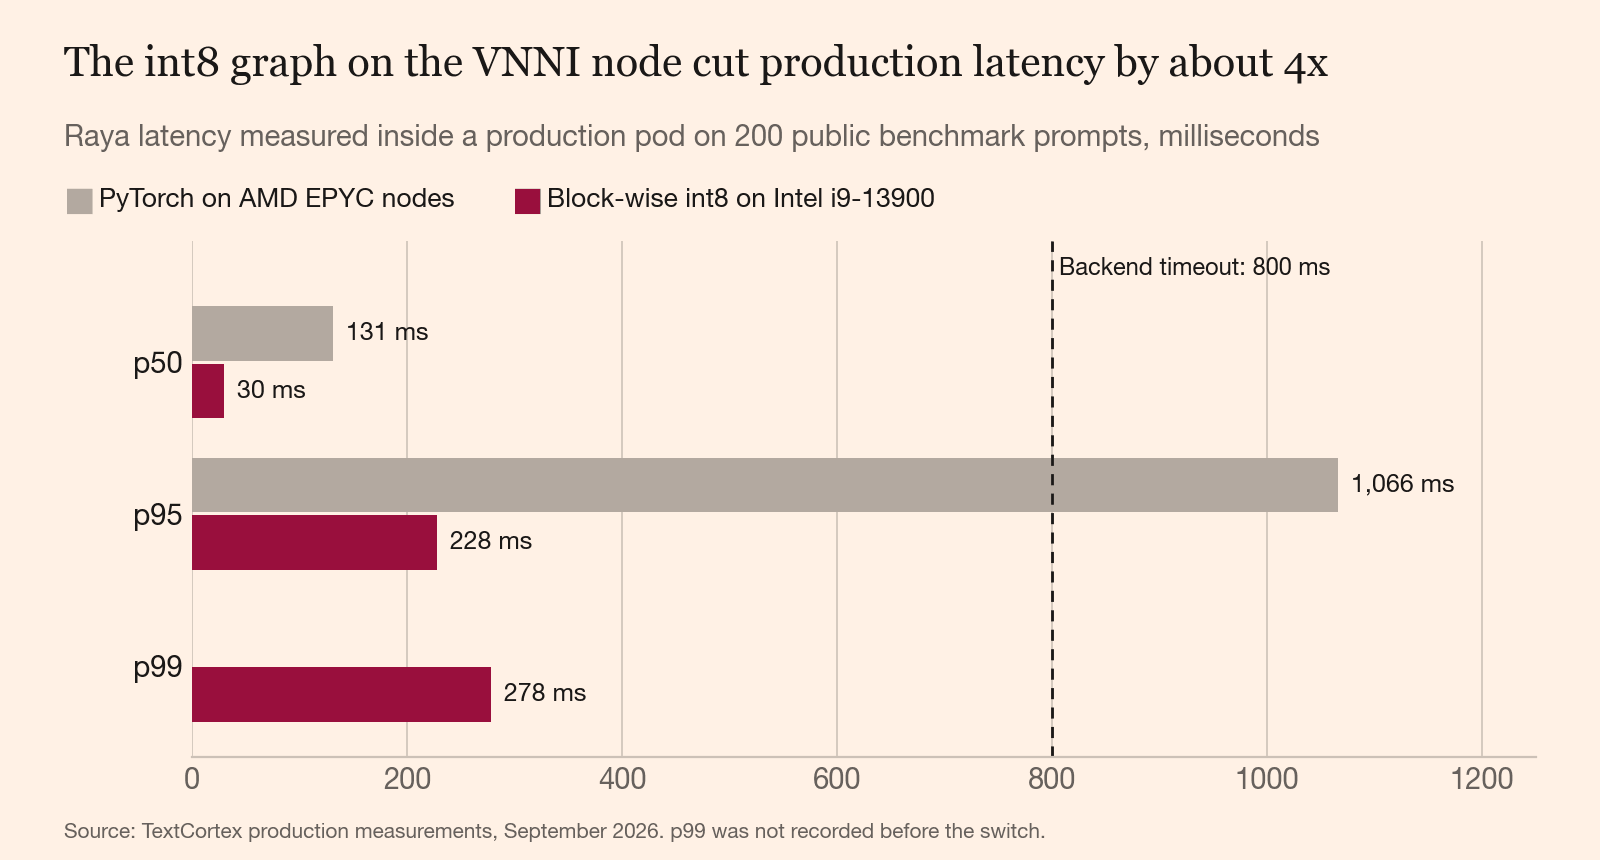
O primeiro deployment em produção corria PyTorch nos nossos nós EPYC. O p95 era de 1.066 ms, acima dos 800 ms que o backend espera antes de desistir do router. Mais de um pedido em cada vinte teria dado timeout.
Depois da mudança, medido dentro de um pod de produção: 30 ms p50, 228 ms p95, 278 ms p99. Cada pod aguenta 16 a 18 pedidos por segundo, contra cerca de 4 antes. A imagem passou de 4,0 GB para 1,0 GB. A precisão no benchmark é de 81,5%, contra 81,0% do original em PyTorch.
A numérica int8 depende do CPU, por isso a imagem verifica-se a si própria. O build confirma o SHA-256 do ficheiro do modelo. Cada pod recusa arrancar num CPU sem VNNI e compara as suas respostas com a referência PyTorch antes de receber tráfego.
O servidor custa 84 € por mês e já estava na fatura.
O nosso cluster corre no Kubernetes gerido da Cloudfleet, com servidores dedicados Hetzner como nós. O nó do Raya tem a mesma especificação que o EX101 da Hetzner: um i9-13900, 64 GB de memória ECC, dois discos NVMe de 1,92 TB. A Hetzner anuncia-o a 84 € por mês mais uma taxa de instalação de 39 €, antes de IVA (setembro de 2026). A Cloudfleet cobra por vCPU por cima disso, de 2,45 € a 7,25 € por mês consoante o plano.
Não comprámos nada para o Raya. O nó corria outras cargas com 22% do CPU reservado. Com os pods do Raya está em 86%. O router custou-nos capacidade parada numa máquina que já estávamos a pagar.
O limite, como estimativa: dois pods de produção aguentam cerca de 32 pedidos por segundo, ou aproximadamente 83 milhões de decisões de encaminhamento num mês de 30 dias. Se imputar ao Raya o servidor inteiro, dá cerca de 1 € por milhão de decisões a carga máxima, antes de IVA e da taxa da Cloudfleet. Com o tráfego real, o que conta são os 84 € fixos.
Tudo depende de um único servidor.
Só um nó do nosso cluster tem VNNI, por isso os dois pods de produção estão presos a ele. Se esse servidor morrer, os pods ficam pendentes e o Auto manda todos os prompts para medium. É o router constante do primeiro artigo. O chat continua a funcionar até o nó voltar.
O nó também está cheio. Com 86% reservado não há espaço para um terceiro pod, por isso passar de cerca de 32 pedidos por segundo obriga a alugar um segundo servidor com VNNI. Com oito pedidos simultâneos por pod, o p95 sobe para cerca de 1,2 segundos, acima do timeout de 800 ms, e o excedente cai para medium. O tráfego atual do Auto está muito longe disso.
E, enquanto escrevo isto, nenhum pedido de cliente chega ao Raya. O smoke test encaminha corretamente os três tiers em staging e em produção. A alteração no backend que o chama ainda está em revisão.
Um modelo aberto que você afina bate um modelo aberto que você descarrega.
O Laya de origem perdeu contra uma constante. Seis minutos de treino com as nossas próprias etiquetas fecharam a maior parte da distância para um modelo alojado, e um servidor CPU de 84 € fechou a distância na latência.
O Jev continua a ser melhor nas perguntas de escolha. Também não tem deployment na UE. Para uma empresa europeia, um router três pontos pior que corre em Falkenstein bate um que é melhor e corre num sítio para onde não podemos mandar o prompt.
O Raya é público sob Apache-2.0, com os ficheiros ONNX, os respetivos checksums e os resultados brutos do benchmark no seu model card. Corra-o nos seus próprios prompts contra return "medium". Se não o conseguir bater por dez pontos no seu tráfego, diga-me, e também publico isso.