Tłumaczenie maszynowe. Przeczytaj angielski oryginał: Per-seat billing turns a 60¢ code review into $4 →
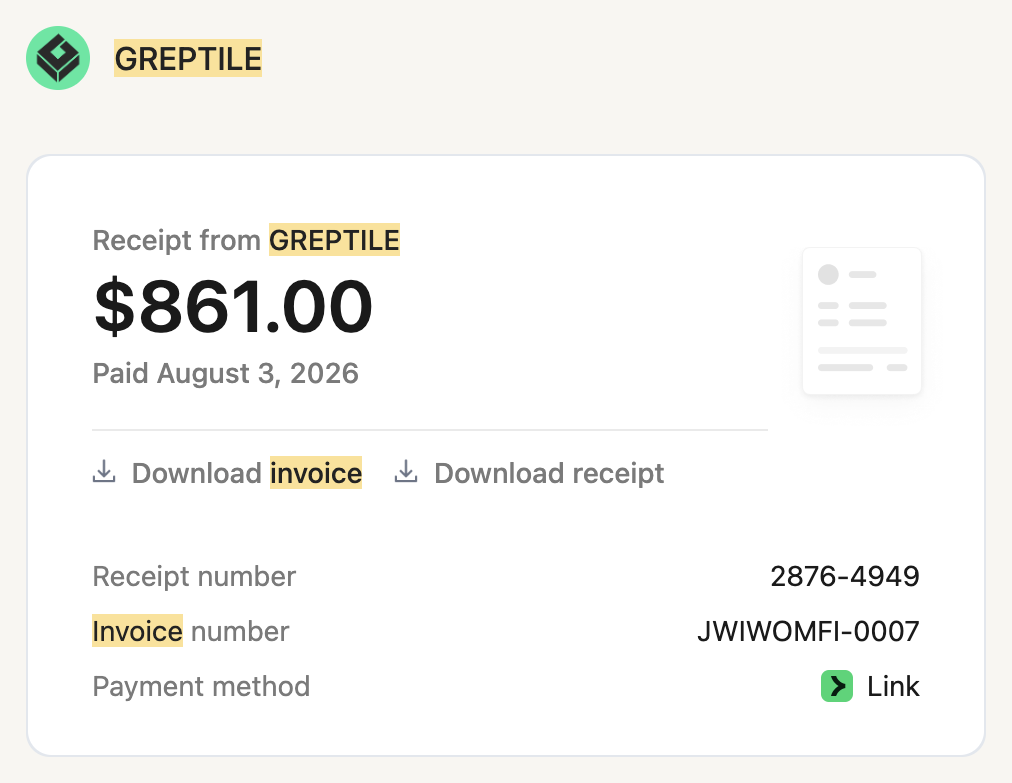
Zrób dzielenie na swoim rachunku za review kodu przez AI. Weź to, co zapłaciłeś w zeszłym miesiącu, i podziel przez liczbę pull requestów, które to narzędzie faktycznie przejrzało. Cena katalogowa to inna liczba i to tę zapamiętałeś. Wykonałem to dzielenie dla naszego zespołu i dostałem wynik tak odległy od strony z cenami, że założyłem, iż popełniłem błąd.
Arytmetyka była w porządku. Kupowałem produkt tak, jak jest sprzedawany, i używałem go tak, jak faktycznie pracujemy, a to okazują się dwa różne produkty.
Oto teza, a wszystko po tym jest jej dowodem. Review kodu przez AI jest sprzedawane per developer, a konsumowane per pull request. Te dwie liczby nie mają ze sobą nic wspólnego, a luka między nimi to miejsce, gdzie trafiają twoje pieniądze. Osobno, i co gorsza, narzędzie, za które płaciliśmy, przeczytało diff z sześcioma prawdziwymi defektami i znalazło jeden.
Zastąpiliśmy je czymś, co zbudowaliśmy sami. Pokażę wam rachunki za oba twierdzenia, włącznie z częściami, które źle o nas świadczą.
Sześć defektów weszło. Wyszedł jeden.
Pull request dotyczył refaktoru autosave w naszej platformie. Zwykły, średniej wielkości, taki, który otwiera się we wtorek i nikt przez niego nie traci snu. Greptile go przejrzał, zostawił dwa komentarze i poszedł dalej.
Potem jeden z naszych inżynierów przeszedł przez diff ręcznie i rozstrzygnął go porządnie, spisując każdy prawdziwy defekt bez patrzenia na to, które narzędzie co zgłosiło. Sześć defektów. Cztery z nich P1, takie, które psują dane użytkownika, a nie tylko kogoś irytują.
Autosave uzbrajał się ponownie w nieskończoność po normalizacji wartości. Nieudany zapis ponawiał się w nieskończonej pętli. Autosave nadpisywał to, co użytkownik aktywnie pisał w innej karcie. Promise zapisu był wyrzucany bez obsługi. Opuszczenie strony gubiło wszystko, co oczekiwało na zapis. Przycisk zapisu renderował się tylko wtedy, gdy kroku nie można było zapisać.
Jeden z tych sześciu został zgłoszony.
Żaden z tych sześciu nie trafił na produkcję, i chcę być precyzyjny co do tego, dlaczego. Inżynier usiadł i przeczytał diff linia po linii. Reviewer już przyszedł i poszedł. Płaciliśmy za siatkę bezpieczeństwa, która złapała jedną rzecz na sześć, a te pięć, które wypuściła, zostało złapane przez dokładnie tę czynność, którą ten produkt ma redukować.
Pewność w złą stronę jest gorsza niż milczenie
Było siódme znalezisko. Nie było prawdziwe.
Powiedziano nam: „nieudany autosave nie ma ponowienia“. Defekt siedzący w tej samej funkcji wskazywał w drugą stronę: nieudany autosave ponawiał się w nieskończoność. Narzędzie miało kierunek odwrócony.
Myślałem o tym więcej niż o pięciu chybieniach razem wziętych. Chybienie to cisza, a cisza jest do przeżycia, bo zakładasz, że twój reviewer nie jest wszechwiedzący. Inwersja jest gorsza niż cisza. Wysyła inżyniera do właściwego pliku w poszukiwaniu niewłaściwej rzeczy, a gdy nie znajduje rzeczy, której nigdy tam nie było, zamyka plik i oznacza jako przejrzany. Fałszywy raport zużywa twoją uwagę i zużywa ją dokładnie w miejscu, gdzie ukrywał się prawdziwy bug.
Jedno prawdziwe znalezisko. Jedno odwrócone znalezisko. Sześć defektów w diffie.
Jeden model to jedna martwa plama, a jej kształtu nigdy nie poznasz
Moja pierwsza reakcja była taka, że kupiliśmy złe narzędzie. Ta reakcja była błędna, a wyjście z niej zajęło mi więcej czasu, niż chciałbym przyznać.
Każdy model z najwyższej półki ma martwe plamy i żadne dwa modele nie mają tych samych. Każdy vendor dostarcza tę właściwość, bo taka jest natura tych systemów. Więc jeśli budujesz swój proces review na dokładnie jednym modelu, budujesz go na dokładnie jednym wzorcu ślepoty i nigdy nie poznasz kształtu tego wzorca, bo jedyny instrument, który mógłby ci go pokazać, to instrument, który jest ślepy.
Rozłóżmy to na czynniki. Kup najlepszy reviewer na rynku, a kupisz jeden wzorzec ślepoty w pełnej cenie. Review kodu działał w ogóle dlatego, że druga osoba patrzyła na diff. To był cały mechanizm, a my go porzuciliśmy w tygodniu, w którym go zautomatyzowaliśmy.
Więc zbudowaliśmy Juror. Kilka modeli z najwyższej półki reviewuje ten sam diff równolegle, każdy przez własny natywny harness agenta, każdy z możliwością przeszukania twojego repozytorium tak, jak zamierzył to jego vendor. Ich znaleziska się scalają, więc trzy prawie identyczne raporty o jednym defekcie lądują na pull requeście jako pojedynczy komentarz.
Uruchomiliśmy go na tym samym commicie.
| Reviewer | Znaleziono | Precyzja | Koszt | Czas |
|---|---|---|---|---|
| Greptile | 1 z 6 | 50% | nieujawnione | nieujawnione |
| Juror | 4 z 6 | 100% | 1,08 USD | 8m22s |
Tu jest część, w której przegrywamy
Juror przegapił dwa.
Greptile złapał wyrzucony promise zapisu, a my nie. Żadne narzędzie nie znalazło nieskończonej pętli ponawiania. Złóż oba reviewery razem, a dostaniesz pięć z sześciu, co jest lepsze niż którekolwiek z osobna, i nie zamierzam tego zakopać pod tabelą powyżej.
Mogłem wyciąć tę sekcję. Zostawiam ją, bo to jest sedno. Różne modele łapią różne rzeczy, a to, że model konkurenta znalazł coś, czego nasz nie znalazł, to najczystsza dostępna demonstracja, że uruchamianie pojedynczego reviewera to błąd. Dzień, w którym to przestanie się dziać, to dzień, w którym zacznę się martwić, że nasza ława przysięgłych skurczyła się do jednej opinii w czterech kapeluszach.
Twój rachunek zależy od liczby pracowników. Twoje review zależą od liczby merge’y.
Teraz rachunek, czyli moment, w którym przestaje chodzić o jeden pull request.
Plan Pro Greptile kosztuje 30 USD za miejsce miesięcznie, stan na sierpień 2026. W cenie jest 50 kredytów na miejsce, gdzie jeden kredyt kupuje standardowe review, a trzy głębsze, a dodatkowe kredyty kosztują 1 USD każdy.
Za recenzję to tanio. Mniej więcej sześćdziesiąt centów, jeśli wykorzystasz każdy przyznany kredyt. Chcę być tu całkowicie uczciwy: w przeliczeniu na jednostkę to mniej niż kosztowało nasze własne narzędzie na powyższym pull requeście. Mały zespół, który w pełni wykorzystuje swój limit, powinien kupić miejsca i nie będę udawał, że jest inaczej.
Nikt nie wykorzystuje w pełni swojego limitu.
Płacisz za developera. Recenzje zużywasz na pull request. Te dwie liczby przestają się ze sobą zgadzać w momencie, gdy liczba pracowników rośnie szybciej niż tempo mergowania, czyli od razu, w każdej organizacji inżynierskiej, jaka kiedykolwiek istniała. Dwudziestu inżynierów na Pro to 600 dolarów miesięcznie i tysiąc kredytów. Jeśli ten zespół zmerguje 150 pull requestów, czyli całkowicie normalny miesiąc, zapłacisz 4 dolary za recenzję i pozwolisz wygasnąć 850 kredytom.
Twoje wykorzystanie się zmieniło, a cena katalogowa nie, więc sześćdziesiąt centów zamieniło się w cztery dolary i nikt nie wysłał ci w tej sprawie e-maila.
Nazwij to podatkiem od miejsca: pieniądze wydane na licencję per deweloper za produkt zużywany per artefakt. Jest niewidoczny na stronie z cenami, skaluje się wraz z zatrudnianiem, a nie z użyciem, i jest największą pozycją w tym, co faktycznie płacisz.
Mogę ci powiedzieć, ile to kosztowało, bo drukujemy rachunek
Juror nie ma miejsc. Działa na twoim własnym runnerze GitHub Actions, wywołuje API modeli z twoimi własnymi kluczami, a rachunek to koszt inferencji i nic więcej. Ta recenzja PR-a z autosave, cztery prawdziwe defekty i zero fałszywych pozytywów, kosztowała 1,08 dolara i zajęła osiem minut i dwadzieścia dwie sekundy.
Mogę ci to podać co do centa, bo każda recenzja Jurora kończy się tabelą: każdy model, jego tokeny wejściowe, tokeny z cache, tokeny wyjściowe, dolary. Każda liczba jest oznaczona jako reported, gdy dostawca ją wyliczył, lub estimated, gdy wyprowadziliśmy ją z opublikowanych cen katalogowych. Gdy harness nie daje nam żadnej z tych opcji, wypisuje unknown, a suma jest oznaczona jako dolne ograniczenie. Nie zgadujemy i nie zaokrąglamy na swoją korzyść.
Teraz spójrz jeszcze raz na dwie komórki w tej tabeli, w których widnieje „not disclosed“. Szukałem tych liczb i nie są opublikowane nigdzie. Narzędzie nie mówi ci, ile kosztowała recenzja, bo nie musi. Kupiłeś miejsce. Ekonomika jednostkowa to sprawa sprzedawcy, a sprzedawca woli, żebyś dalej robił mnożenie po jego myśli.
Reviewer, który drukuje własny rachunek, to rzecz, której chciałem i której nie mogłem kupić za żadną cenę.
Czego nie zamierzam robić, to nazywać tego benchmarkiem
To jeden pull request.
Nasz własny protokół benchmarkowania mówi, że decyzja o zastąpieniu wymaga 20–30 rozstrzygniętych PR-ów obejmujących frontend, backend, migracje, współbieżność, kod wrażliwy na bezpieczeństwo oraz zarówno małe, jak i duże diffy. Mamy jeden. Leży w repozytorium z dołączonym ostrzeżeniem, że nie wolno go przedstawiać jako statystycznie wystarczającego dowodu na to, że którykolwiek z reviewerów może zastąpić drugiego, i nie zamierzam łamać własnego ostrzeżenia w poście na blogu o tym, jak starannie raportujemy liczby.
Cztery z sześciu przeciw jednemu z sześciu to jeden rozstrzygnięty przypadek. To sprawiło, że jestem skłonny uruchomić oba reviewery obok siebie i to cały ciężar, jaki może udźwignąć. Inny pull request, taki, który mocno opiera się na kontekście całego repozytorium, gdzie indeksowany reviewer powinien sobie dobrze radzić, mógłby prawdopodobnie odwrócić wynik. Jeśli tak się stanie, ten przypadek też trafia do korpusu.
Arytmetyka to część, która przetrwa próbkę o wielkości jeden. Trzydzieści dolarów za miejsce razy dwudziestu inżynierów to 600 dolarów, czy mi się to podoba, czy nie, a 150 recenzji przy tysiącu kredytów to 15% wykorzystania w dowolnym miesiącu, jaki zechcesz zmierzyć. Przeszliśmy na to ze względu na strukturę cenową, którą mogę obronić dzieleniem, i na jeden obiecujący przypadek. Twierdzenie o wydajności to to, na które nie zapracowaliśmy, więc go nie stawiam.
Zmierz nas
Nie wierz mi na słowo w żadnej z tych kwestii. Mam komercyjny interes w twoich wnioskach i powinieneś odpowiednio ważyć wszystko powyżej.
Uruchom oba reviewery w trybie shadow na własnym repozytorium. Pozwól im działać przez kilka tygodni, bez blokowania merge przez którykolwiek z nich. Potem weź wszystkie ustalenia, zdejmij etykiety, żeby nikt nie wiedział, które narzędzie co powiedziało, i pozwól senior engineerowi rozstrzygnąć je na zimno w konfrontacji z kodem. Policz, co każde z nich wychwyciło. Policz, co każde z nich zmyśliło.
Wydaliśmy narzędzia dokładnie do tego, bo sami ich potrzebowaliśmy:
npx juror-ai benchmark --file your-corpus.jsonRaportuje recall, precyzję, wskaźnik duplikatów, koszt i opóźnienie dla każdego reviewera, którego mu podasz, i wymienia każde przeoczenie z nazwy. Włącznie z naszymi.
Nie sądzę, żeby model miejsc przetrwał kontakt z kimkolwiek, kto zrobi to dzielenie. Przetrwa teraz, bo dzielenie jest lekko irytujące, a strona z cenami jest tak ułożona, żebyś sobie nim nie zawracał głowy. Ktoś w twojej organizacji w końcu wykona te obliczenia. Kiedy to zrobi, odpowiedź nie będzie brzmieć sześćdziesiąt centów.
Nawiasem mówiąc, ten pull request z autosave został zmergowany dziś rano. Wymagało to dwóch dodatkowych commitów: jednego, żeby zapisy nawigacji były single-flight, i jednego, żeby autosave zbiegał i zostawił buildera w spokoju. Dobre commity. Nic się nie pali.
Nikt nigdy nie pozna, że były konieczne, bo błędy wychwycone przed mergem nie pozostawiają śladu i nie generują raportu o incydencie. To jest część, która powinna cię niepokoić. Reviewer, który przeoczył pięć z nich, kosztuje tyle samo, niezależnie od tego, czy znajdzie sześć, czy zero, i nigdy ci nie powie, za który z tych dwóch miesięcy właśnie zapłaciłeś.
Juror jest open source na licencji MIT: github.com/juror-ai/juror. Cennik Greptile zacytowany z greptile.com/pricing według stanu na sierpień 2026.