Makine çevirisi. İngilizce aslını okuyun: Train your own Jev: an 11x faster System-1 model with almost free hosting →
Cuma günü, TextCortex’te her prompt için bir model katmanı seçen yönlendirici Raya hakkında yazdım. 563 prompt’luk benchmark’ımızda %81 alıyor ve Falkenstein’daki bir CPU’da 30 ms’de yanıt veriyor. O yazı nasıl yapılacağını anlatmıyordu.
Tarif artık açık: Raya’nın Hugging Face reposundaki
training/ klasöründe,
Apache-2.0 lisansıyla. Kararı tarif et, verini iki LLM’e etiketlet, eğit,
değerlendir, ONNX’e export et. Yazıldığı gibi çalıştığını kontrol etmek için bu
sabah etiketleme dışındaki her adımı bir Apple M4 dizüstünde çalıştırdım.
Eğitim 34 saniye, export 24 saniye sürdü.
İddiam şu: Bir frontier modele her istekte aynı soruyu, sabit bir cevap kümesiyle soruyorsan, o soru sahibi olduğun küçük bir sınıflandırıcıya aittir. Büyük modeli bir kez, öğretmen olarak kullan ve karar başına ona para ödemeyi bırak.
Aynı soruyu bir milyon kez cevaplasın diye bir LLM’e para ödüyorsun.
README sonuca System-1 model diyor, ben de bu terimi kullanmaya devam edeceğim. Bir System-1 model, bir girdi hakkında iyi tanımlanmış tek bir soruyu anında, eşik koyabileceğin olasılıklarla cevaplar. Bu prompt’u hangi model cevaplamalı? Bu ticket bir insana ihtiyaç duyuyor mu? Bu talep hangi ekibin? Yaklaşık 300 milyon parametreli, fine-tune edilmiş bir Laya encoder’ı; onlarca milisaniyede çalışıyor ve çağrı başına ücreti yok.
Bunlar için bir chat modeli çağırmak, postanı ayıklasın diye avukat tutmaya benzer: her zarf için bir fatura, her birinde bir bekleme ve postanın bir kopyası başkasının sunucusunda. Avrupalı bir şirket için bu son kısım konuşmayı bitirebilir: Raya’yı istediğimiz yönlendiricinin AB dağıtımı olmadığı için yaptık.
Beklemeyi ölçmek kolay. Raya production’da p50’de 30 ms’de yanıt veriyor. Raya’nın yerini aldığı barındırılan yönlendirici Jev’i ölçtüğümde çağrı başına yaklaşık 350 ms sürüyordu: Raya kabaca 11 kat daha hızlı. Zaten faturamızda olan aylık 84 €’luk bir Hetzner sunucusunda çalışıyor, yani barındırma bize yeni bir maliyet getirmedi.
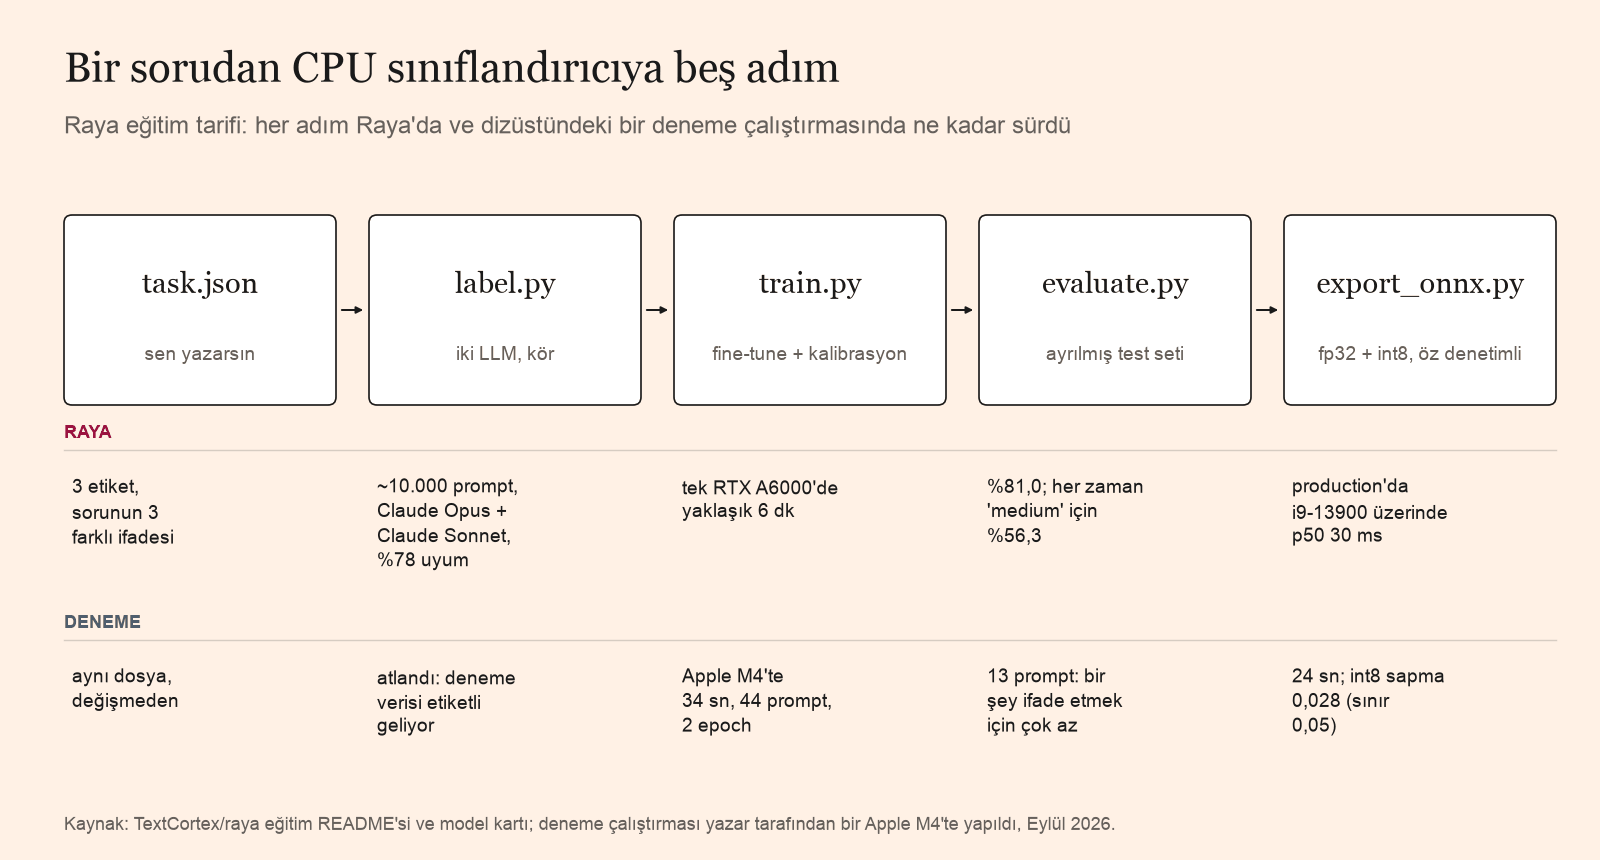
Bütün tarif dört script ve bir JSON dosyasından ibaret.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Bunlardan önce task.json dosyasını yazıyorsun: etiketler ve sorunun bir ya da
daha fazla ifade biçimi. Raya’da üç tane var: “Bu prompt’u bir modele
yönlendir”, her katman için bir rubrik içeren daha uzun bir versiyon ve 1’den
3’e bir zorluk puanı. Model her ifade biçimiyle, seçenekler her epoch’ta yeniden
karıştırılarak eğitiliyor, böylece kararın kendisini öğreniyor. Dosya ayrıca
etiketleyicilerin okuduğu rubriği de tutuyor ve
Raya’nınki
şablon olarak geliyor.
Anlaşamayan iki etiketleyici, kendinden emin görünen bir etiketleyiciden daha değerlidir.
Muhtemelen elinde girdiler var ama etiket yok. label.py her girdiyi aynı
rubrikle, ayrı ayrı iki ya da daha fazla LLM’e gönderiyor. Raya’nın yaklaşık
10.000 etiketi, birbirini görmeyen Claude Opus ve Claude Sonnet’ten geldi.
Anthropic’inki, OpenRouter, vLLM ve Ollama dahil, OpenAI uyumlu her endpoint
çalışıyor.
Etiketleyicilerin anlaştığı yerde temiz bir etiket alıyorsun. Anlaşamadıkları
yerde satır iki oyu da tutuyor ve train.py 50/50 bir hedef öğreniyor. İki
güçlü modelin bölündüğü bir prompt için dürüst cevap bu. Orada kesin bir etiket
dayatmak, modele yazı turayı bir gerçekmiş gibi öğretir.
Script ayrıca etiketleyicilerin ne sıklıkla anlaştığını da yazdırıyor. O sayıyı not al. Modelinin bu etiketlere karşı alabileceği skorun kabaca tavanı o. Raya için %78’di. Etiketleyicilerin zamanın %75’inde anlaşıyor ve modelin %90 alıyorsa, model bir etiketleyicinin alışkanlıklarını öğrenmiştir ve çözüm daha sıkı bir rubrik.
Hacim konusunda README, ilk model için gerçekten hizmet verdiğin dillerde 1.000
ile 5.000 arası gerçek girdi öneriyor. Sınıfları dengesiz bırak; train.py
nadir etiketleri kendisi ağırlıklandırıyor. Hiçbir şeyin üzerinde eğitilmediği
ya da doğrulanmadığı bir test seti ayır.
GPU işin ucuz kısmı.
Raya, 48 GB’lık tek bir RTX A6000 üzerinde yaklaşık altı dakikada eğitildi. Benim M4’ümde 40 deneme eğitim satırı üzerinde iki epoch 22 saniye sürdü, model yüklemeyle birlikte 34.
Bellekten tasarruf etmek için token embedding tablosunu donduruyor, validasyonda en iyi epoch’u seçiyor, ardından her soru için bir sıcaklık (temperature) ayarlıyor; böylece 0,9’luk bir olasılık on seferin yaklaşık dokuzunda doğru çıkıyor. Daha sonra bir eşiğe göre hareket edebilmeni sağlayan şey bu kalibrasyon, örneğin bir prompt’u yalnızca 0,6’nın üstündeyse frontier katmanına göndermek.
Varsayılan başlangıç noktası Laya’nın çok dilli mmBERT-base modeli. Bunun yerine
Raya’yı kendi yönlendirme trafiğine uyarlamak için --base TextCortex/raya ver.
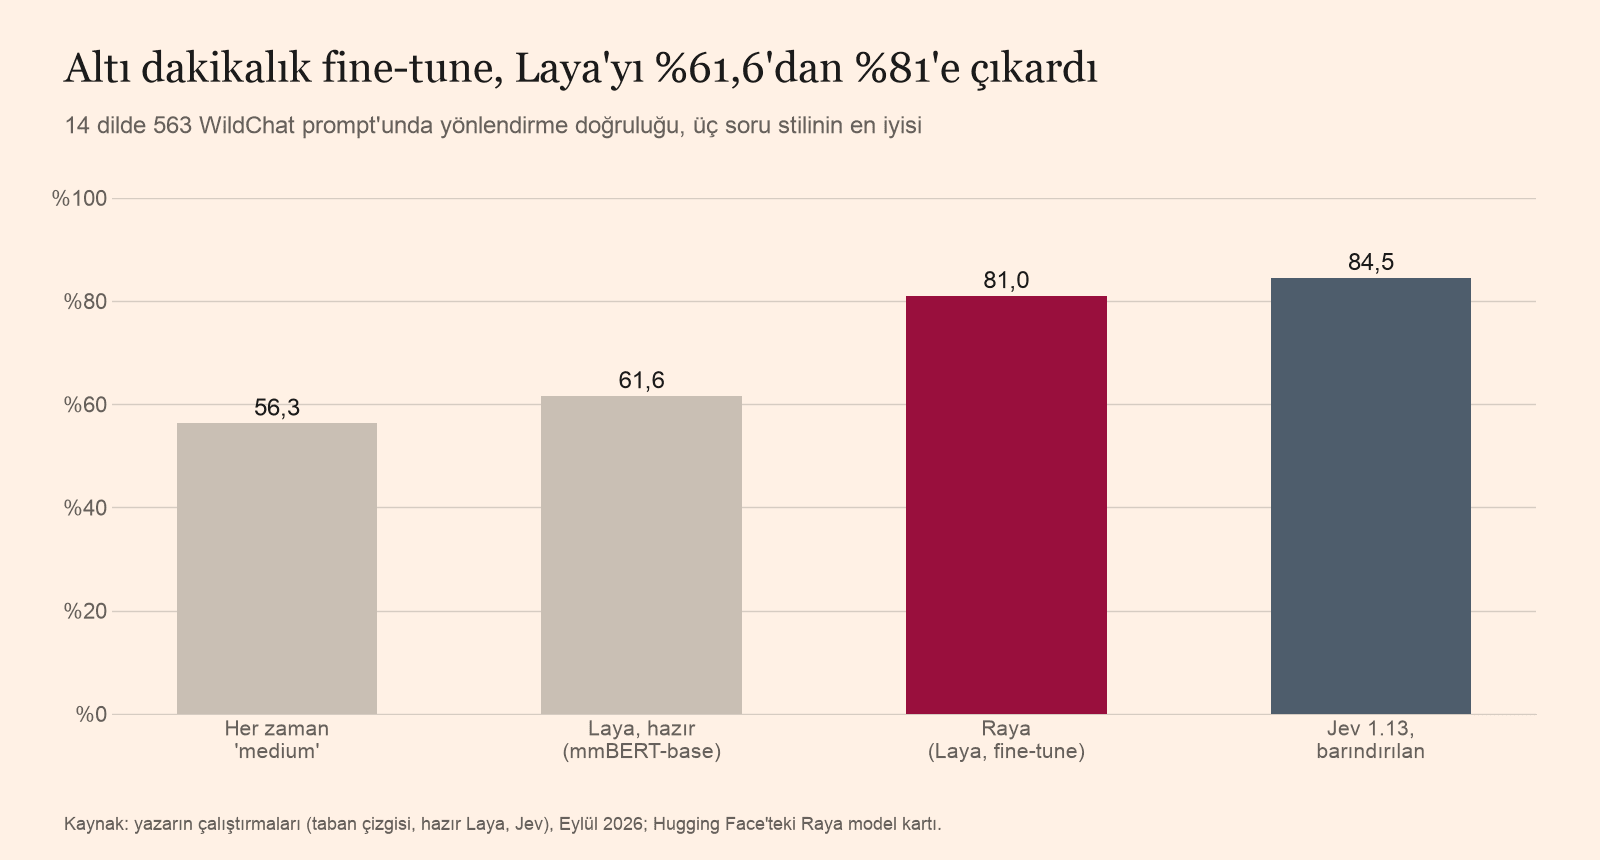
Altı dakikalık GPU süresi Laya’yı %61,6’dan %81’e, yani Jev’in üç buçuk puan gerisine çıkardı. Öğleden sonran etiketlere gidiyor.
Deneme verisi yalnızca tesisatın çalıştığını kanıtlıyor, başka bir şeyi değil.
Klasörde eğitim için 44, test için 13 elle yazılmış yönlendirme prompt’u var.
README beş dakika vaat ediyor. Sabitlenmiş sürümlerle, kurulum hariç, eğitim ve
export bir dakikadan kısa sürdü. README’deki örnek çağrı “Prove that √2 is irrational.”
prompt’unu 0,52 ile frontier_model’e yönlendirdi.
Ardından evaluate.py deneme modeline kısa ifade biçiminde %46,2, rubrikli
ifade biçiminde %84,6 ve zorluk puanında %69,2 verdi. Kısa ifade biçimi 13
prompt’un 12’sini medium’a gönderdi. On üç prompt bu sayıları gürültüden ayırt
edemez ve 44 eğitim satırı, README’nin deyişiyle, “işe yarar bir model eğitmek
için fazlasıyla küçük”.
evaluate.py’nin yaptığı işe yarar şey, ilk olarak şu satırı yazdırmaktı:
13 rows with a gold label; always answering 'small_model' scores 38.5%Bu sabit baseline. İlk benchmark’ta,
hazır Laya üç soru stilinin ikisinde return "medium"’a yenildi.
Her değerlendirme, hiçbir şey yapmayan modelin skoruyla açılmalı.
Bir kez export et, sonra gerçekten kiralayacağın CPU’da ölç.
export_onnx.py bir fp32 dosyası ve bir blok bazlı int8 dosyası yazıyor, sonra
ikisini de test verin üzerinde PyTorch’a karşı kontrol ediyor. Herhangi bir
seçim değişirse ya da olasılıklar fp32 için 0,001’den, int8 için 0,05’ten fazla
saparsa export başarısız oluyor. Benim deneme modelimde bu değerler 0,00000 ve
0,02790 çıktı.
Hangi dosyayı yayına alacağın silikona bağlı. Önceki yazının ölçtüğü gibi, blok bazlı int8 Raya’nın doğruluğunu korudu ve VNNI komutlarına sahip bir i9-13900’de en hızlı çalıştı, ama bunlara sahip olmayan bir EPYC 7502P’de fp32’nin iki katından fazla sürdü. Seçmeden önce kendi donanımında ölç.
Büyük modeli bir kez kirala, sonra karar başına ona para ödemeyi bırak.
Frontier model sektörü her çağrıyı fiyatlandırıyor, bu yüzden her çağrı bir frontier modelin işi gibi görünüyor. Sabit bir listeden cevap seçen her çağrı bir sınıflandırmadır ve akıl yürütme diye faturalandırılır. Etiketler yazıldıktan sonra LLM, 300M’lik bir encoder’ın zaten parasını ödediğin donanımda 30 ms’de vardığı bir karara pahalı bir yoldan varmanın yolu.
Sana borçlu olduğum bir sınır var. Raya’nın eğitim verisi yayımlanmadı, yani bu klasörle kendi Raya’nı yapabilirsin ama bizimkini yeniden üretemezsin. Ayrıca Raya, benchmark etiketlerini yazan aynı iki etiketleyiciden öğrendi ve bu da %81’ini olduğundan iyi gösteriyor.
O yüzden kendi trafiğinde ölç. evaluate.py’yi modelinin hiç görmediği bir
test setinde çalıştır. Sabit baseline’ı geniş bir farkla geçemiyorsa, başka
hiçbir şeye dokunmadan önce rubriği sıkılaştır. Tarif senin kararında başarısız
olursa, bana sayıları gönder, ben de yayımlayayım.