Tradotto automaticamente. Leggi l’originale in inglese: Train your own Jev: an 11x faster System-1 model with almost free hosting →
Venerdì ho scritto di Raya, il router che sceglie un tier di modello per ogni prompt in TextCortex. Fa l’81% sul nostro benchmark da 563 prompt e risponde in 30 ms su una CPU a Falkenstein. Quel post non diceva come costruirne uno.
Ora la ricetta è pubblica, nella
cartella training/
del repo Hugging Face di Raya, con licenza Apache-2.0. Descrivi la decisione, fai
etichettare i tuoi dati a due LLM, addestra, valuta, esporta in ONNX. Stamattina
ho eseguito ogni passaggio tranne l’etichettatura su un laptop Apple M4, per
verificare che funzioni come è scritto. L’addestramento ha richiesto 34 secondi e l’export 24.
Ecco la tesi. Se a ogni richiesta mandi a un modello frontier la stessa domanda con un insieme fisso di risposte, quella domanda va messa in un piccolo classificatore che possiedi tu. Usa il modello grande una volta sola, come insegnante, e smetti di pagarlo a ogni decisione.
Stai pagando un LLM per rispondere un milione di volte alla stessa domanda.
Il README chiama il risultato System-1 model, e terrò il termine. Un System-1 model risponde a una sola domanda ben definita su un input, all’istante, con probabilità su cui puoi mettere una soglia. Quale modello deve rispondere a questo prompt? Questo ticket ha bisogno di un umano? Quale team è responsabile di questa richiesta? È un encoder Laya con fine-tuning, di circa 300 milioni di parametri, gira in decine di millisecondi e non ha costi per chiamata.
Chiamare un modello di chat per queste cose è come assumere un avvocato per smistare la posta: una parcella per ogni busta, un’attesa per ciascuna e una copia della tua posta sul server di qualcun altro. Per un’azienda europea quest’ultimo punto può chiudere il discorso: abbiamo costruito Raya perché il router che volevamo non aveva un deployment nell’UE.
L’attesa è facile da misurare. In produzione Raya risponde in 30 ms al p50. Quando ho misurato Jev, il router in hosting che Raya sostituisce, impiegava circa 350 ms a chiamata: Raya è circa 11 volte più veloce. Gira su un server Hetzner da 84 € al mese che avevamo già in bolletta, quindi l’hosting non ci è costato nulla in più.
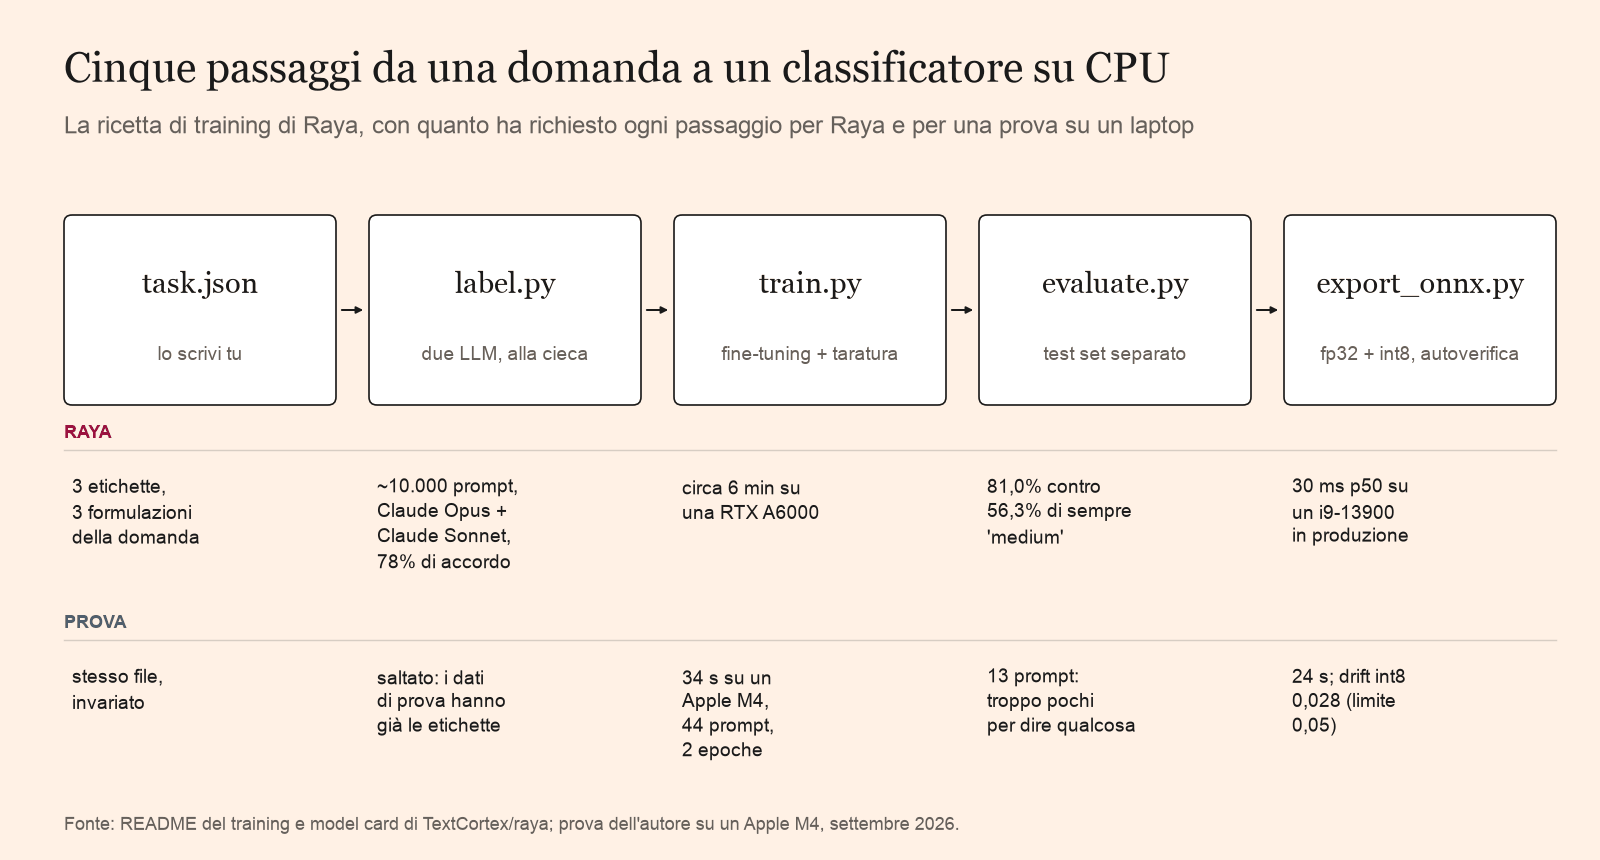
L’intera ricetta sono quattro script e un file JSON.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Prima di tutto questo scrivi task.json: le etichette e una o più
formulazioni della domanda. Raya ne ha tre: “Route this prompt to a model”,
una versione più lunga con una rubrica per ogni tier e un punteggio di
difficoltà da 1 a 3. Il modello si addestra su tutte le formulazioni con le
opzioni rimescolate a ogni epoca, così impara la decisione in sé. Il file
contiene anche la rubrica che leggono gli annotatori, e
quella di Raya
è distribuita come template.
Due annotatori in disaccordo valgono più di uno che sembra sicuro.
Probabilmente hai gli input e non le etichette. label.py manda ogni input a
due o più LLM, separatamente, con la stessa rubrica. Le circa 10.000 etichette
di Raya vengono da Claude Opus e Claude Sonnet, alla cieca l’uno rispetto
all’altro. Va bene qualsiasi endpoint compatibile con OpenAI, compresi quello di
Anthropic, OpenRouter, vLLM e Ollama.
Dove gli annotatori sono d’accordo ottieni un’etichetta pulita. Dove non lo
sono, la riga conserva entrambi i voti e train.py impara un target 50/50. È
la risposta onesta per un prompt su cui due modelli forti si dividono. Forzare
un’etichetta netta lì insegna al modello un lancio di moneta come se fosse un
fatto.
Lo script stampa anche quanto spesso gli annotatori erano d’accordo. Segnati quel numero. È più o meno il tetto di quello che il tuo modello può ottenere contro queste etichette. Per Raya era il 78%. Se i tuoi annotatori sono d’accordo il 75% delle volte e il tuo modello fa il 90%, ha imparato le abitudini di un annotatore, e la soluzione è una rubrica più stretta.
Quanto al volume, il README indica da 1.000 a 5.000 input reali per un primo
modello, nelle lingue che servi davvero. Lascia le classi sbilanciate; train.py
pesa da solo le etichette rare. Tieni un test set
su cui niente si addestra o si valida mai.
La GPU è la parte economica.
Raya si è addestrato in circa sei minuti su una sola RTX A6000 da 48 GB. Sul mio M4 ha fatto due epoche sulle 40 righe di training di prova in 22 secondi, 34 con il caricamento del modello.
Congela la tabella degli embedding dei token per risparmiare memoria, sceglie la migliore epoca sulla validazione, poi stima una temperatura per ogni domanda in modo che una probabilità di 0,9 sia giusta circa nove volte su dieci. È questa calibrazione che ti permette poi di agire su una soglia, per esempio mandando un prompt al tier frontier solo sopra 0,6.
Il punto di partenza di default è mmBERT-base multilingue di Laya. Passa
--base TextCortex/raya per adattare invece Raya al tuo traffico di routing.
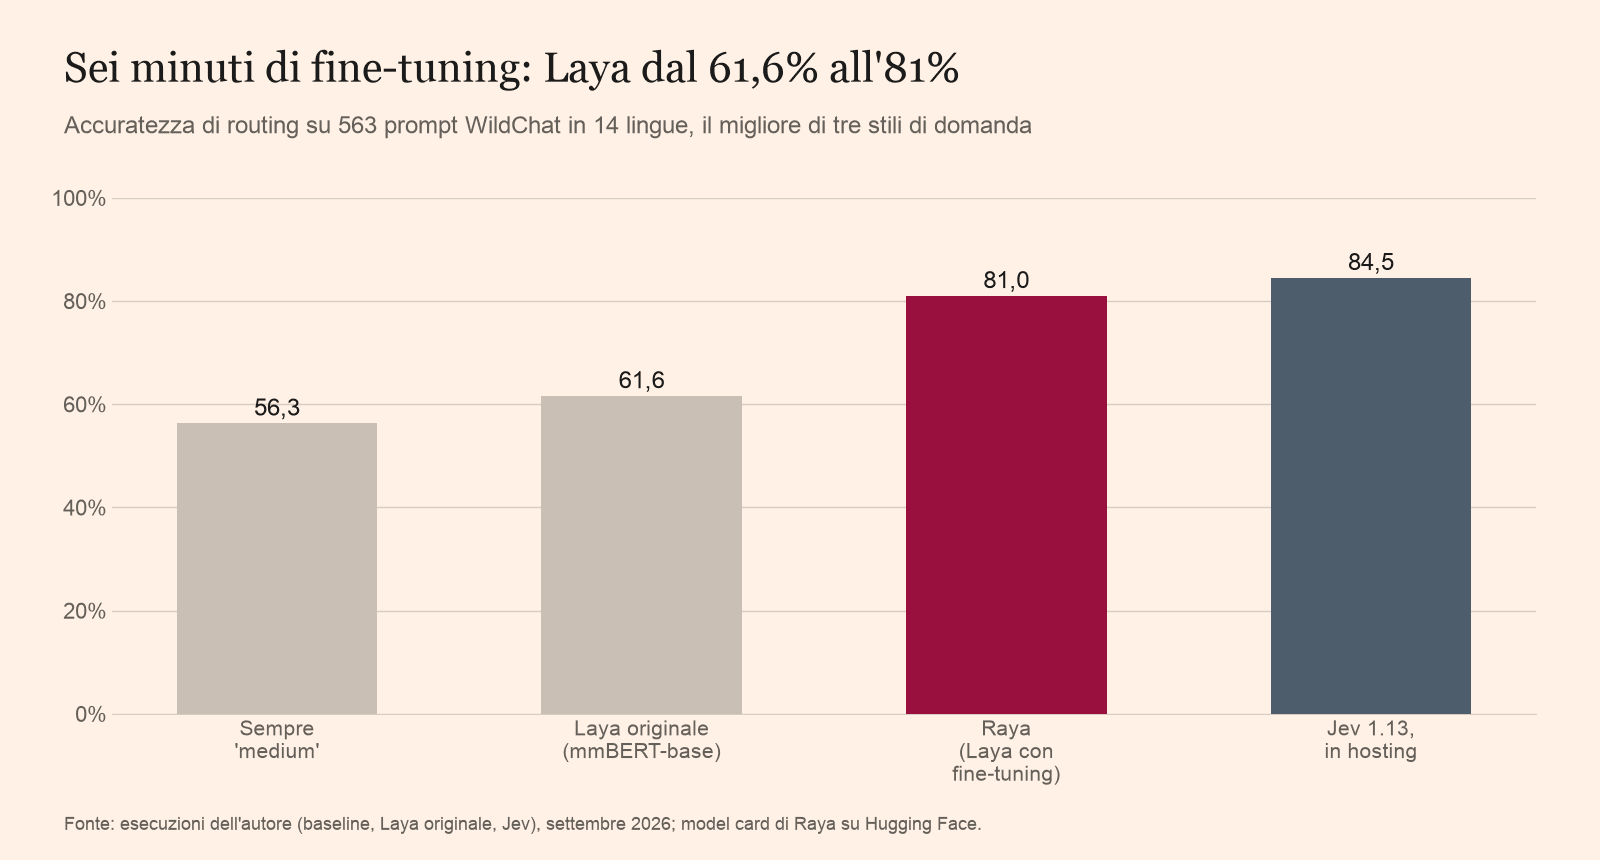
Sei minuti di GPU hanno portato Laya dal 61,6% all’81%, tre punti e mezzo sotto Jev. È sulle etichette che se ne va il tuo pomeriggio.
I dati di prova dimostrano che l’impianto funziona e nient’altro.
La cartella include 44 prompt di routing scritti a mano per il training e 13
per il test. Il README promette cinque minuti. Training ed export hanno richiesto
meno di un minuto, esclusa l’installazione, con le versioni fissate. La chiamata di esempio del README ha instradato “Prove that √2 is irrational.”
a frontier_model con 0,52.
Poi evaluate.py ha dato al modello di prova il 46,2% sulla formulazione breve,
l’84,6% su quella con la rubrica e il 69,2% sul punteggio di difficoltà. La
formulazione breve ha mandato 12 prompt su 13 a medium. Tredici prompt non
bastano a distinguere questi numeri dal rumore, e 44 righe di training sono,
con le parole del README, “decisamente troppo poche per addestrare un modello
utile”.
La cosa utile che ha fatto evaluate.py è stata stampare per prima questa riga:
13 rows with a gold label; always answering 'small_model' scores 38.5%Quella è la baseline costante. Nel
primo benchmark,
Laya originale perdeva contro return "medium" su due dei suoi tre stili di domanda.
Ogni valutazione dovrebbe aprirsi con il punteggio del modello che non fa niente.
Esporta una volta, poi misura sulla CPU che affitterai davvero.
export_onnx.py scrive un file fp32 e un file int8 a blocchi, poi li confronta
entrambi con PyTorch sui tuoi dati di test. L’export fallisce se cambia una
qualsiasi scelta o se le probabilità si discostano di più di 0,001 per fp32 o
0,05 per int8. Il mio modello di prova ha dato 0,00000 e 0,02790.
Quale file distribuire dipende dal silicio. Come ha misurato l’ultimo post, l’int8 a blocchi ha mantenuto l’accuratezza di Raya ed è stato il più veloce su un i9-13900 con istruzioni VNNI, ma ha impiegato più del doppio di fp32 su un EPYC 7502P che non le ha. Misura sul tuo hardware prima di scegliere.
Affitta il modello grande una volta, poi smetti di pagarlo a ogni decisione.
L’industria dei modelli frontier mette un prezzo su ogni chiamata, quindi ogni chiamata sembra un lavoro per un modello frontier. Ogni chiamata che sceglie da una lista fissa di risposte è una classificazione, fatturata come ragionamento. Una volta scritte le etichette, l’LLM è un modo costoso di arrivare a un verdetto che un encoder da 300M raggiunge in 30 ms su hardware che paghi già.
C’è un limite che ti devo dire. I dati di training di Raya non sono pubblicati, quindi con questa cartella puoi costruire il tuo Raya ma non puoi riprodurre il nostro. E Raya ha imparato dagli stessi due annotatori che hanno scritto le etichette del benchmark, il che gonfia il suo 81%.
Quindi misuralo sul tuo traffico. Esegui evaluate.py su un test set che il tuo
modello non ha mai visto. Se non supera la baseline costante con un ampio
margine, stringi la rubrica prima di toccare qualsiasi altra cosa. Se la ricetta
fallisce sulla tua decisione, mandami i numeri e li pubblicherò.