Tłumaczenie maszynowe. Przeczytaj angielski oryginał: Train your own Jev: an 11x faster System-1 model with almost free hosting →
W piątek pisałem o Rayi, routerze, który wybiera tier modelu dla każdego promptu w TextCortex. Ma 81% na naszym benchmarku z 563 promptami i odpowiada w 30 ms na CPU w Falkenstein. Tamten post nie mówił, jak taki zbudować.
Przepis jest teraz publiczny, w
folderze training/
repozytorium Rayi na Hugging Face, na licencji Apache-2.0. Opisz decyzję, niech dwa
LLM-y oznaczą twoje dane, trenuj, ewaluuj, eksportuj do ONNX. Dziś rano odpaliłem
każdy krok poza etykietowaniem na laptopie z Apple M4, żeby sprawdzić, czy działa tak,
jak jest opisane. Trening zajął 34 sekundy, a eksport 24.
Oto teza. Jeśli przy każdym zapytaniu wysyłasz modelowi frontier to samo pytanie ze stałym zestawem odpowiedzi, to pytanie powinno trafić do małego klasyfikatora, który należy do ciebie. Użyj dużego modelu raz, jako nauczyciela, i przestań płacić mu za każdą decyzję.
Płacisz LLM-owi za odpowiedź na to samo pytanie milion razy.
README nazywa wynik modelem System-1 i zostanę przy tym terminie. Model System-1 odpowiada na jedno dobrze zdefiniowane pytanie o dane wejściowe, od razu, z prawdopodobieństwami, na które możesz nałożyć próg. Który model powinien odpowiedzieć na ten prompt? Czy to zgłoszenie wymaga człowieka? Który zespół odpowiada za tę prośbę? To dostrojony enkoder Laya z około 300 milionami parametrów, działa w dziesiątkach milisekund i nie ma opłaty za wywołanie.
Wywoływanie do tego modelu czatowego to zatrudnianie prawnika do sortowania poczty: rachunek za każdą kopertę, czekanie na każdą i kopia twojej korespondencji na cudzym serwerze. Dla europejskiej firmy ta ostatnia część potrafi zakończyć rozmowę: zbudowaliśmy Rayę, bo router, którego chcieliśmy, nie miał wdrożenia w UE.
Czas oczekiwania łatwo zmierzyć. Raya odpowiada na produkcji w 30 ms przy p50. Kiedy zmierzyłem Jeva, hostowany router, który Raya zastępuje, potrzebował około 350 ms na wywołanie: Raya jest mniej więcej 11 razy szybsza. Działa na serwerze Hetzner za 84 € miesięcznie, który już był na naszym rachunku, więc hosting nie kosztował nas nic nowego.
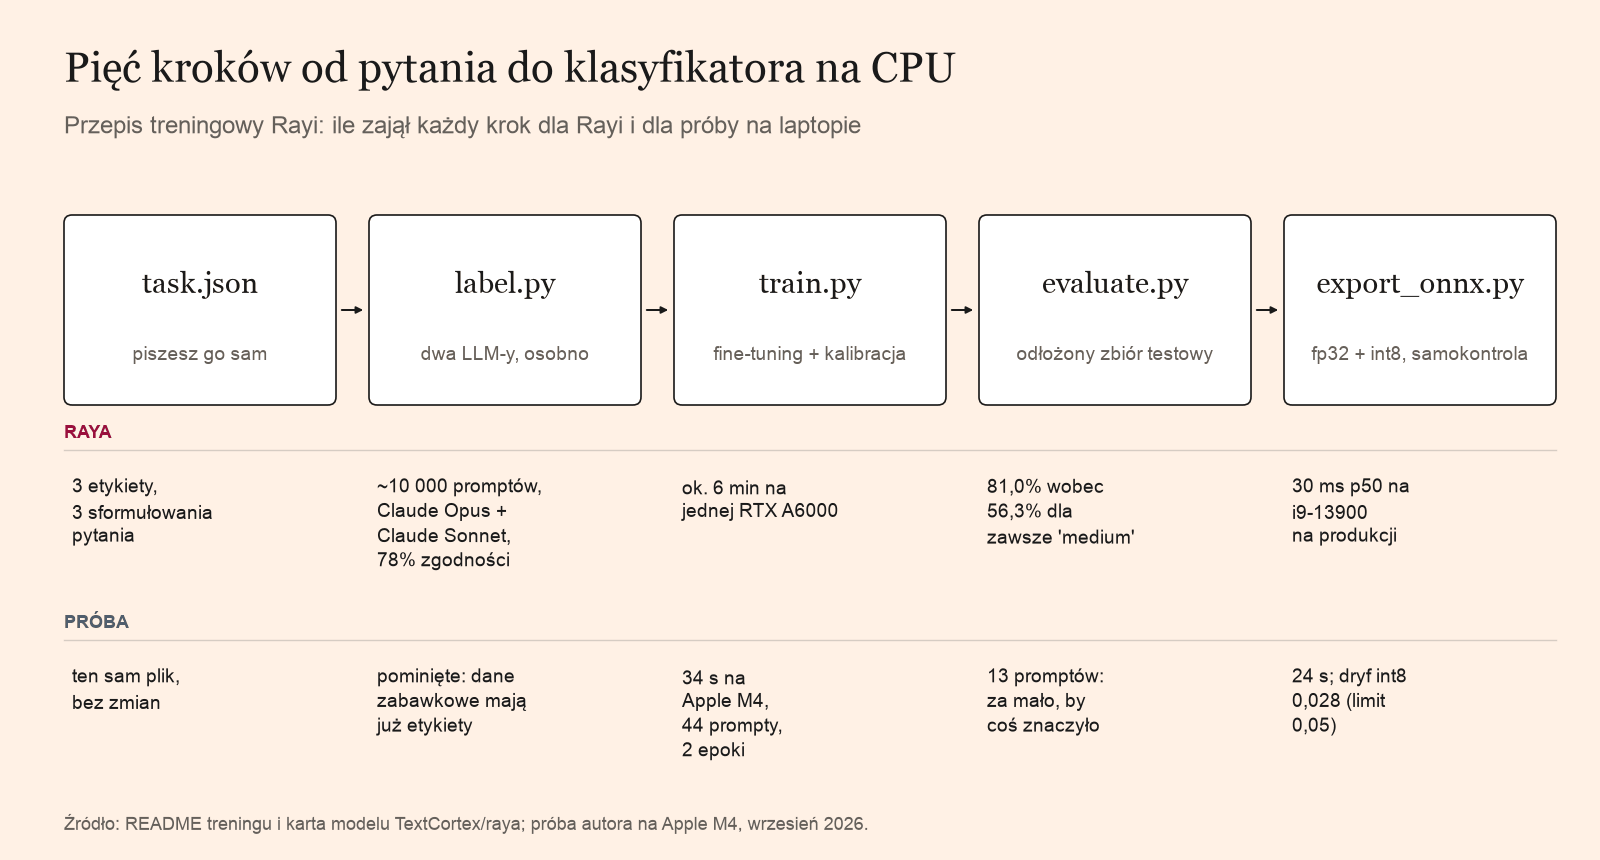
Cały przepis to cztery skrypty i jeden plik JSON.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Zanim cokolwiek z tego uruchomisz, piszesz task.json: etykiety i jedno lub więcej
sformułowań pytania. Raya ma trzy: „Route this prompt to a model”, dłuższą
wersję z rubryką dla każdego tieru oraz ocenę trudności od 1 do 3. Model
trenuje na każdym sformułowaniu, z opcjami przetasowanymi w każdej epoce, więc
uczy się samej decyzji. Plik zawiera też rubrykę, którą czytają anotatorzy,
a
rubryka Rayi
służy jako szablon.
Dwóch anotatorów, którzy się nie zgadzają, jest wartych więcej niż jeden pewny siebie.
Pewnie masz dane wejściowe, a nie masz etykiet. label.py wysyła każde wejście do dwóch lub
więcej LLM-ów, osobno, z tą samą rubryką. Mniej więcej 10 000 etykiet Rayi pochodzi
od Claude Opus i Claude Sonnet, które nie widziały nawzajem swoich odpowiedzi. Działa każdy
endpoint zgodny z OpenAI, w tym ten od Anthropic, OpenRouter, vLLM i Ollama.
Tam, gdzie anotatorzy się zgadzają, dostajesz czystą etykietę. Tam, gdzie się nie zgadzają, wiersz
zachowuje oba głosy, a train.py uczy się celu 50/50. To uczciwa
odpowiedź dla promptu, przy którym dwa mocne modele się dzielą. Wymuszenie tam twardej etykiety
uczy model rzutu monetą, jakby był faktem.
Skrypt wypisuje też, jak często anotatorzy się zgadzali. Zapisz tę liczbę. To mniej więcej sufit tego, co twój model może osiągnąć względem tych etykiet. Dla Rayi było to 78%. Jeśli twoi anotatorzy zgadzają się w 75% przypadków, a twój model ma 90%, nauczył się nawyków jednego anotatora, a naprawą jest ściślejsza rubryka.
Co do ilości, README mówi o 1000 do 5000 prawdziwych wejść na pierwszy model, w
językach, które faktycznie obsługujesz. Zostaw klasy niezbalansowane; train.py
sam waży rzadkie etykiety. Trzymaj zbiór testowy,
na którym nic nigdy nie trenuje ani się nie waliduje.
GPU to ta tania część.
Raya trenowała się około sześciu minut na jednej karcie RTX A6000 z 48 GB. Na moim M4 przeszła dwie epoki po 40 zabawkowych wierszach treningowych w 22 sekundy, 34 z ładowaniem modelu.
Zamraża tablicę embeddingów tokenów, żeby oszczędzić pamięć, wybiera najlepszą epokę na zbiorze walidacyjnym, a potem dopasowuje temperaturę dla każdego pytania, tak żeby prawdopodobieństwo 0,9 było trafne mniej więcej dziewięć razy na dziesięć. Ta kalibracja pozwala ci później działać na podstawie progu, na przykład wysyłać prompt do tieru frontier dopiero powyżej 0,6.
Domyślnym punktem startowym jest wielojęzyczny mmBERT-base, na którym stoi Laya. Podaj
--base TextCortex/raya, żeby zamiast tego dostosować Rayę do własnego ruchu routingowego.
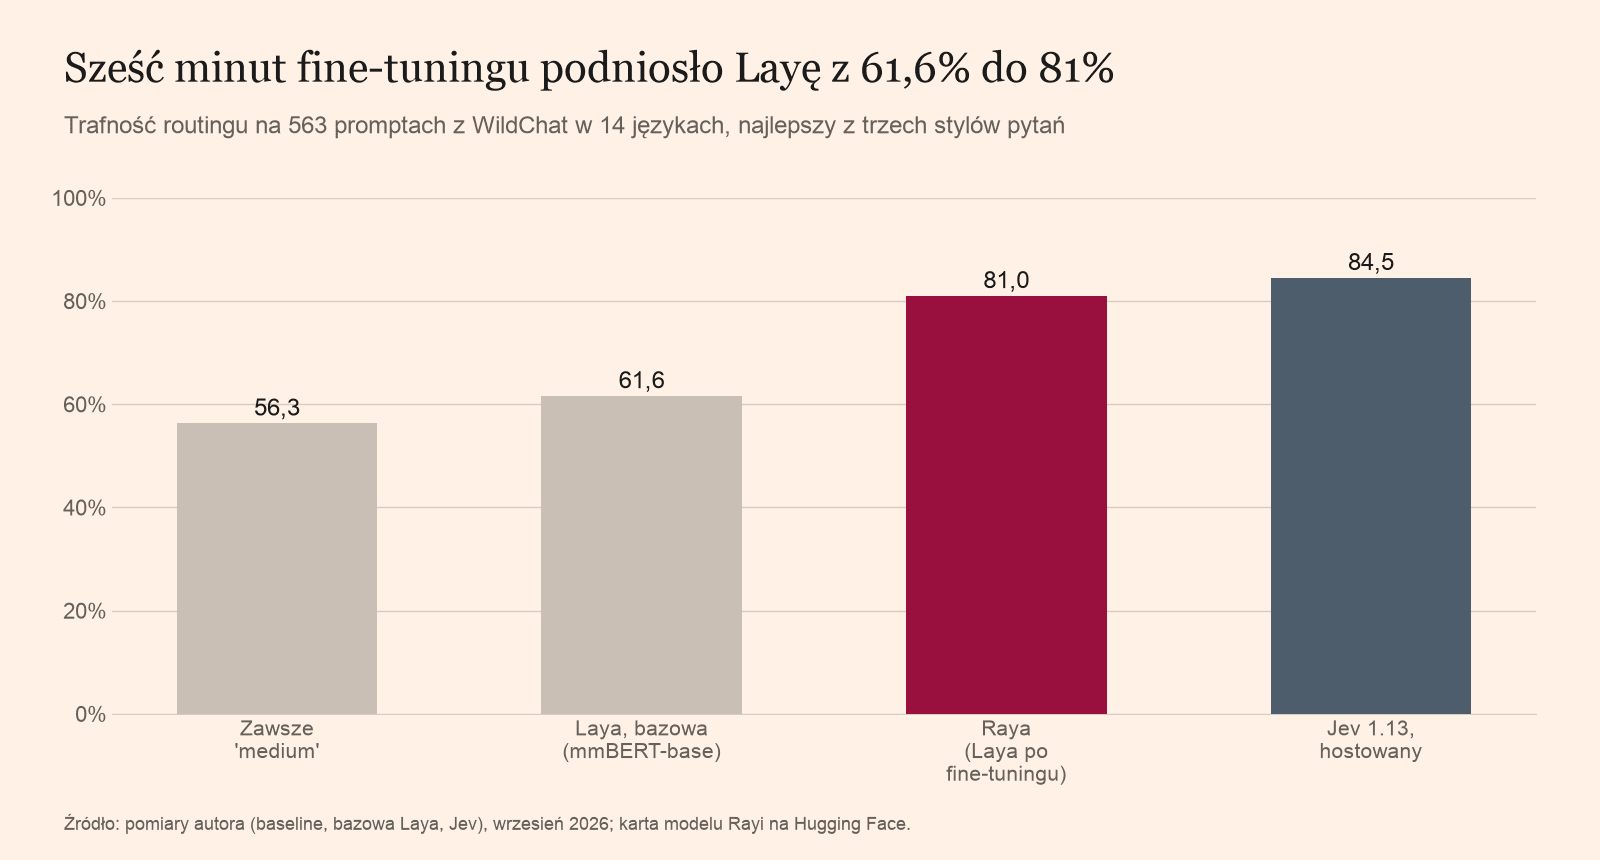
Sześć minut czasu GPU podniosło Layę z 61,6% do 81%, trzy i pół punktu za Jev. Twoje popołudnie pójdzie na etykiety.
Dane-zabawki dowodzą, że hydraulika działa, i niczego więcej.
Folder zawiera 44 ręcznie napisane prompty routingowe do treningu i 13 do
testów. README obiecuje pięć minut. Trening i eksport zajęły mniej niż
minutę, nie licząc instalacji, na przypiętych wersjach. Przykładowe wywołanie z README skierowało „Prove that √2 is irrational.”
do frontier_model z wynikiem 0,52.
evaluate.py ocenił potem model-zabawkę na 46,2% przy krótkim sformułowaniu, 84,6%
przy sformułowaniu z rubryką i 69,2% przy ocenie trudności. Krótkie sformułowanie
wysłało 12 z 13 promptów do medium. Trzynaście promptów nie oddzieli tych
liczb od szumu, a 44 wiersze treningowe to, słowami README, zbiór „o wiele za
mały, żeby wytrenować użyteczny model”.
Przydatne było to, że evaluate.py najpierw wypisał tę linię:
13 rows with a gold label; always answering 'small_model' scores 38.5%To stały punkt odniesienia. W
pierwszym benchmarku
bazowa Laya przegrała z return "medium" w dwóch z trzech stylów pytań.
Każda ewaluacja powinna zaczynać się od wyniku modelu, który nic nie robi.
Eksportuj raz, potem mierz na CPU, który naprawdę wynajmiesz.
export_onnx.py zapisuje plik fp32 i plik int8 kwantyzowany blokowo, a potem sprawdza
oba względem PyTorch na twoich danych testowych. Eksport się wywala, jeśli zmieni się jakikolwiek wybór
albo prawdopodobieństwa odjadą o więcej niż 0,001 dla fp32 lub 0,05 dla int8. Mój model-zabawka
wyszedł na 0,00000 i 0,02790.
Który plik wdrożyć, zależy od krzemu. Jak zmierzył ostatni post, blokowy int8 zachował trafność Rayi i działał najszybciej na i9-13900 z instrukcjami VNNI, ale na EPYC 7502P bez nich trwał ponad dwa razy dłużej niż fp32. Zmierz na własnym sprzęcie, zanim wybierzesz.
Wynajmij duży model raz, potem przestań płacić mu za każdą decyzję.
Branża modeli frontier wycenia każde wywołanie, więc każde wywołanie wygląda na zadanie dla modelu frontier. Każde wywołanie, które wybiera z ustalonej listy odpowiedzi, to klasyfikacja rozliczana jak rozumowanie. Kiedy etykiety są już napisane, LLM to drogi sposób na werdykt, do którego enkoder 300M dochodzi w 30 ms na sprzęcie, za który już płacisz.
Jest ograniczenie, które muszę ci wyznać. Dane treningowe Rayi nie są opublikowane, więc możesz zbudować własną Rayę z tym folderem, ale nie odtworzysz naszej. A Raya uczyła się od tych samych dwóch anotatorów, którzy napisali etykiety benchmarku, co pochlebia jej 81%.
Zmierz ją więc na własnym ruchu. Uruchom evaluate.py na zbiorze testowym, którego twój model
nigdy nie widział. Jeśli nie pokona wyraźnie stałego punktu odniesienia,
zaostrz rubrykę, zanim dotkniesz czegokolwiek innego. Jeśli przepis zawiedzie przy twojej
decyzji, wyślij mi liczby, a je opublikuję.