Makine çevirisi. İngilizce aslını okuyun: Our LLM router runs at 30 ms p50 on an €84/month Hetzner server, no GPU →
İki gün önce, Jev’in açık alternatiflerinin sabit kodlanmış bir “medium”a yenildiğini gösteren bir benchmark yayımladım. Jev, 563 gerçek prompt’un %84,5’ini doğru model katmanına yönlendirdi. Açık modeller Laya ve Von en iyi ihtimalle %61,6’da kaldı.
Sonra Jev’i satın almaya çalıştık ve alamadık. TextCortex Avrupalı şirketlere satış yapıyor ve Eylül 2026’da baktığımızda satın alınabilecek bir Jev AB dağıtımı yoktu. Bir yönlendirici, müşterinin yazdığı her prompt’u okur, dolayısıyla müşterinin verisinin gitmesine izin verilen yerde çalışmak zorundadır.
Ben de kaybeden modeli alıp fine-tune ettim. Sonuç, aynı benchmark’ta %81 alan 300 milyon parametreli bir yönlendirici olan Raya. Şu anda production cluster’ımızda, Almanya’nın Falkenstein kentinde bir CPU üzerinde, 30 ms medyan gecikmeyle çalışıyor; ayda 84 € tutan ve zaten faturamızda olan bir Hetzner sunucusunda.
En iyi yönlendiricinin AB bölgesi yoktu, biz de kaybedeni fine-tune ettik.
Laya, Apache-2.0 lisanslı bir karar modeli: çoktan seçmeli bir sorudaki her seçeneği puanlayan küçük bir kafaya sahip bir mmBERT encoder’ı. Jev ile aynı API’yi konuşuyor. Kutudan çıktığı hâliyle bir sabitten daha kötü yönlendiriyordu.
İki kör etiketleyici, Claude Opus ve Claude Sonnet, WildChat prompt’larını aynı yazılı rubrikle etiketlemişti. Raya bu etiketler üzerinde soft target olarak eğitiliyor (anlaşamadıkları yerde 50/50), buna 14 dilin hepsinde sentetik zor prompt’lar ve bir miktar şirket içi yönlendirme verisi ekleniyor. 563 test prompt’u, eğitimin hiç dokunmadığı WildChat parçalarından geliyor.
Eğitim tek bir NVIDIA RTX A6000 üzerinde yaklaşık altı dakika sürdü.
Tek GPU’da altı dakika, Laya’ya 25 ile 34 puan kazandırdı.
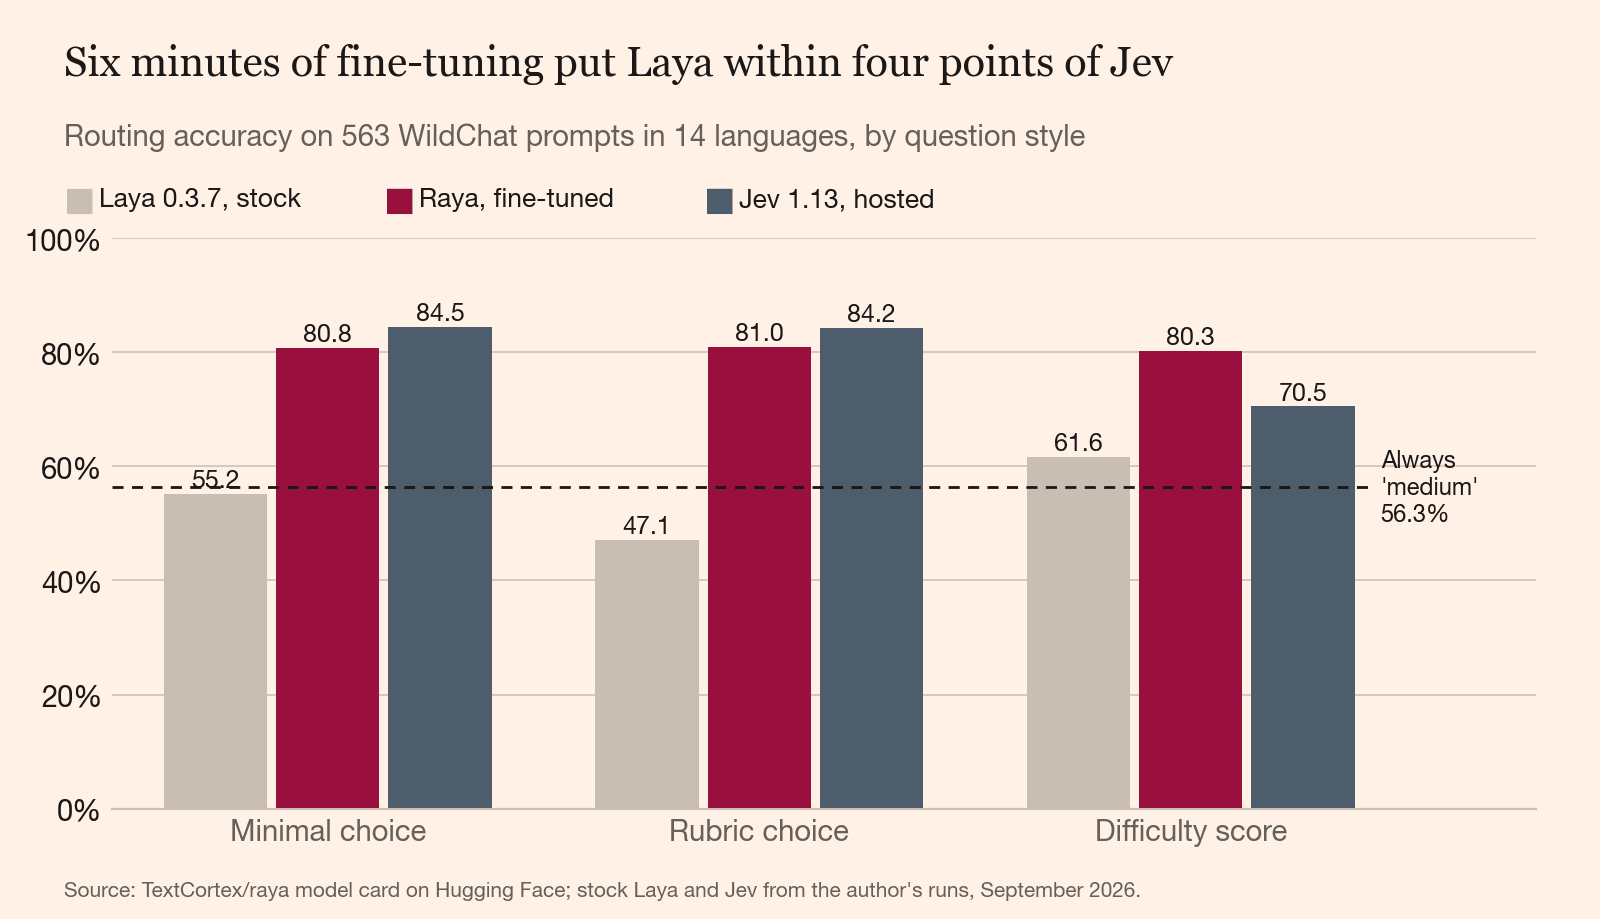
Raya üç soru stilinin hepsinde %80 ile %81 arasında alıyor. Zorluk puanında Jev’i on puan geçiyor (%70,5’e karşı %80,3, McNemar p < 0,001). İki çoktan seçmeli soruda Jev hâlâ üç dört puan önde. Bu örneklem büyüklüğünde bu fark anlamlı değil (p = 0,07 ve 0,13), ama ikisinde de ortaya çıkıyor ve gerçek olduğuna bahse girerim.
Şimdi itiraf etmem gereken kısım geliyor ve küçük bir şey değil. Raya, altın etiketleri yazan iki etiketleyiciden öğrendi. Jev onları hiç görmedi. Raya’nın %81’inin bir kısmı ev sahibi avantajı ve ne kadarı olduğunu söyleyemem. Etiketleyiciler birbirleriyle yalnızca %78 oranında anlaşıyor, yani Raya bu etiketlerin ölçebileceği tavana ulaştı.
Raya ayrıca Jev’in en güçlü olduğu yerde en zayıf. Minimal soruda Türkçede Jev’in %82’sine karşı %67, Portekizcede %90’a karşı %76 alıyor. Jev gibi, 21 frontier prompt’un yalnızca 7’sini frontier’a gönderiyor.
300M parametreli bir sınıflandırıcının GPU’da işi yok.
Raya’nın model kartı GPU’da 17 ms veriyor. Prompt başına tek bir küçük forward pass için koca bir GPU çok fazla donanım, bu yüzden Raya’yı ONNX Runtime’a export ettim ve beş varyantı iki CPU’da denedim: VNNI int8 komutlarına sahip bir Intel i9-13900 ve bunlara sahip olmayan bir AMD EPYC 7502P.
| Dosya | Boyut | Doğruluk | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
|---|---|---|---|---|
| fp32 | 1,23 GB | %81,2 | 38 / 297 ms | 60 / 487 ms |
| blok bazlı int8 | 0,89 GB | %81,5 | 34 / 282 ms | 127 / 975 ms |
| tensör bazlı int8 | 0,92 GB | %79,0 | 24 / 200 ms | kullanılamaz |
| PyTorch referansı | %81,0 | 42 / 421 ms | 89 / 526 ms |
En hızlı dosya iki buçuk puan doğruluk kaybediyor, bu da bir yönlendiricide yanlış modele gönderilen gerçek prompt’lar demek. EPYC’de tensör bazlı int8 taştı ve doğruluk ayarlara bağlı olarak %54 ile %80 arasına düştü.
VNNI çipinde blok bazlı int8 doğruluğun her puanını korudu. Production’da onu kullanıyoruz. On altı thread iki CPU’da da sekizden yavaştı, bu yüzden her pod sekiz alıyor.
VNNI CPU’da int8’e geçmek p95’i 1.066 ms’den 228 ms’ye indirdi.
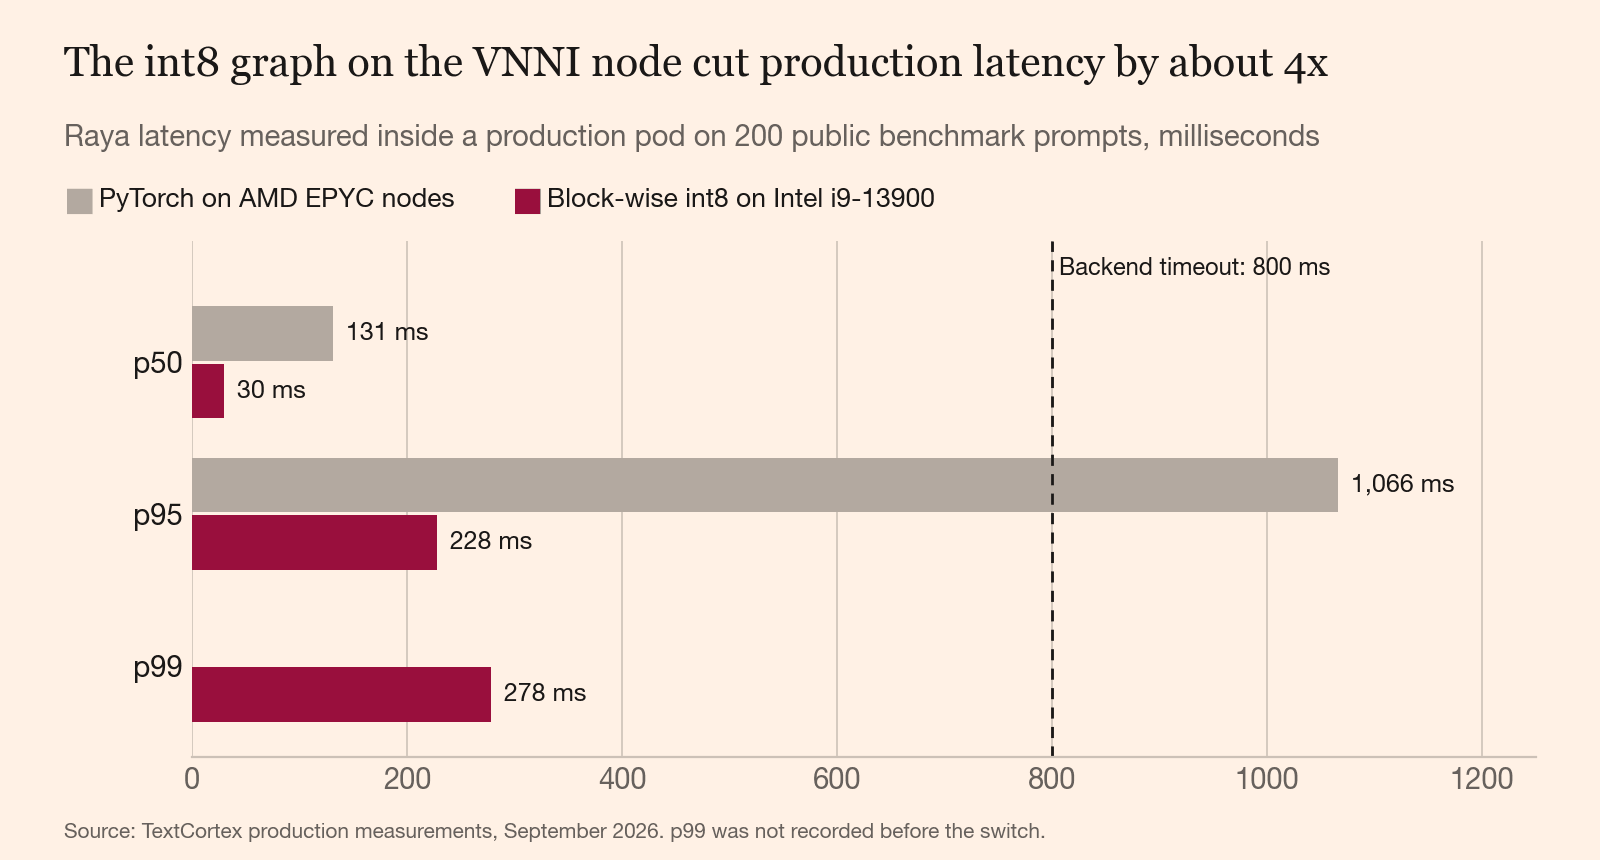
İlk production dağıtımı EPYC node’larımızda PyTorch çalıştırıyordu. p95’i 1.066 ms’ydi; backend’in yönlendiriciden vazgeçmeden önce beklediği 800 ms’nin üstünde. Yirmi istekten birden fazlası zaman aşımına uğrayacaktı.
Geçişten sonra, bir production pod’u içinde ölçülen değerler: 30 ms p50, 228 ms p95, 278 ms p99. Her pod saniyede 16 ile 18 istek karşılıyor, önceden yaklaşık 4’tü. İmaj 4,0 GB’tan 1,0 GB’a indi. Benchmark’taki doğruluk %81,5; PyTorch orijinalinde %81,0.
Int8 sayısal sonuçları CPU’ya bağlı, bu yüzden imaj kendini kontrol ediyor. Build, model dosyasının SHA-256’sını doğruluyor. Her pod VNNI olmayan bir CPU’da başlamayı reddediyor ve trafik almadan önce cevaplarını PyTorch referansıyla karşılaştırıyor.
Sunucu ayda 84 € tutuyor ve zaten faturadaydı.
Cluster’ımız Cloudfleet’in yönetilen Kubernetes’i üzerinde, node olarak Hetzner dedicated sunucularıyla çalışıyor. Raya’nın node’u Hetzner’in EX101’iyle aynı özelliklere sahip: bir i9-13900, 64 GB ECC bellek, iki adet 1,92 TB NVMe disk. Hetzner bunu KDV hariç ayda 84 € artı 39 € kurulum ücretiyle listeliyor (Eylül 2026). Cloudfleet bunun üstüne plana göre ayda 2,45 € ile 7,25 € arasında vCPU başına ücret alıyor.
Raya için hiçbir şey satın almadık. Node, CPU’sunun %22’si ayrılmış hâlde başka iş yükleri çalıştırıyordu. Raya’nın pod’larıyla %86’da. Yönlendirici bize, zaten parasını ödediğimiz bir makinedeki kullanılmayan kapasiteye mal oldu.
Tavan, bir tahmin olarak: iki production pod’u saniyede yaklaşık 32 istek karşılıyor, bu da 30 günlük bir ayda kabaca 83 milyon yönlendirme kararı demek. Sunucunun tamamını Raya’ya yazarsan, tam yükte KDV ve Cloudfleet ücreti hariç milyon karar başına yaklaşık 1 € ediyor. Gerçek trafikte önemli olan sabit 84 €.
Her şey tek bir sunucuya bağlı.
Cluster’ımızda VNNI’ya sahip tek bir node var, bu yüzden iki production pod’u da ona sabitlenmiş durumda. O sunucu ölürse pod’lar pending’de kalır ve Auto her prompt’u medium’a gönderir. Bu, ilk yazıdaki sabit yönlendirici. Node geri gelene kadar sohbet çalışmaya devam eder.
Node aynı zamanda dolu. %86 ayrılmışken üçüncü bir pod’a yer yok, yani saniyede yaklaşık 32 isteği aşmak ikinci bir VNNI sunucusu kiralamak demek. Pod başına sekiz eşzamanlı istekte p95 yaklaşık 1,2 saniyeye tırmanıyor, 800 ms zaman aşımını geçiyor ve taşan kısım medium’a düşüyor. Bugünkü Auto trafiği bunun yakınından bile geçmiyor.
Ve ben bunu yazarken hiçbir müşteri isteği Raya’ya ulaşmıyor. Smoke test, staging’de ve production’da üç katmanı da doğru yönlendiriyor. Onu çağıran backend değişikliği hâlâ incelemede.
Fine-tune ettiğin açık model, indirdiğin açık modeli yener.
Hazır Laya bir sabite yenildi. Kendi etiketlerimizle altı dakikalık eğitim, barındırılan bir modelle arasındaki farkın çoğunu kapattı ve 84 €’luk bir CPU sunucusu da gecikme farkını kapattı.
Jev seçim sorularında hâlâ daha iyi. Ayrıca AB dağıtımı yok. Avrupalı bir şirket için üç puan daha kötü olup Falkenstein’da çalışan bir yönlendirici, daha iyi olup prompt’u gönderemeyeceğimiz bir yerde çalışandan üstündür.
Raya, ONNX dosyaları, bunların checksum’ları ve ham benchmark sonuçlarıyla birlikte Apache-2.0 lisansıyla model kartında herkese açık. Kendi prompt’ların üzerinde return "medium"’a karşı çalıştır. Senin trafiğinde onu on puanla geçemiyorsa bana söyle, onu da yayımlayacağım.