Makine çevirisi. İngilizce aslını okuyun: Open source Jev alternatives sucks, here is the benchmark →
Model açılır menüsü olan her sohbet ürünü, kullanıcısının eline bir yönlendirme işi tutuşturur. Kullanıcı, sorusunun pahalı modeli mi yoksa ucuz modeli mi hak ettiğini tahmin etmek zorundadır ve çoğu insan bir kez seçip bir daha dokunmaz. Sonuçta “puppy love nedir?” için fazla, Bernoulli örnekleri üzerine bir ispat için az ödersin.
TextCortex’te kimse tahmin etmek zorunda kalmasın diye otomatik model seçimi geliştiriyoruz. Bir yönlendirici prompt’u okur ve onu hâlâ iyi cevaplayacak en ucuz katmanı seçer. Bunu kurmanın akla gelen ilk yolu, kendi donanımında çalışan küçük bir açık modeldir: çağrı başına ücret yok, çağrı başına yaklaşık 60 milisaniye ve prompt binadan hiç çıkmıyor. Sonunda oraya varacağımızı varsaymıştım.
Ben de ölçtüm. 14 dilde 563 gerçek chatbot prompt’unda, barındırılan model Jev bunların %84,5’ini doğru katmana yönlendirdi. Dizüstü bilgisayarımda çalışan açık modeller Laya ve Von en iyi hâllerinde %61,6 ve %58,8’de kaldı. Her prompt’a “medium” cevabı veren bir yönlendirici %56,3 alıyor. Buna sabit yönlendirici diyelim. Altı Laya ve Von çalıştırmasının dördü ona yenildi.
Yönlendirici, her prompt’tan önce sorulan tek bir çoktan seçmeli sorudur.
Üç sistem de aynı API’yi konuşuyor. Prompt’u, isimlendirilmiş seçenekleri ve her birini anlatan birer cümleyi içeren bir soruyla birlikte gönderiyorsun. Karşılığında seçenek başına bir olasılık alıyorsun.
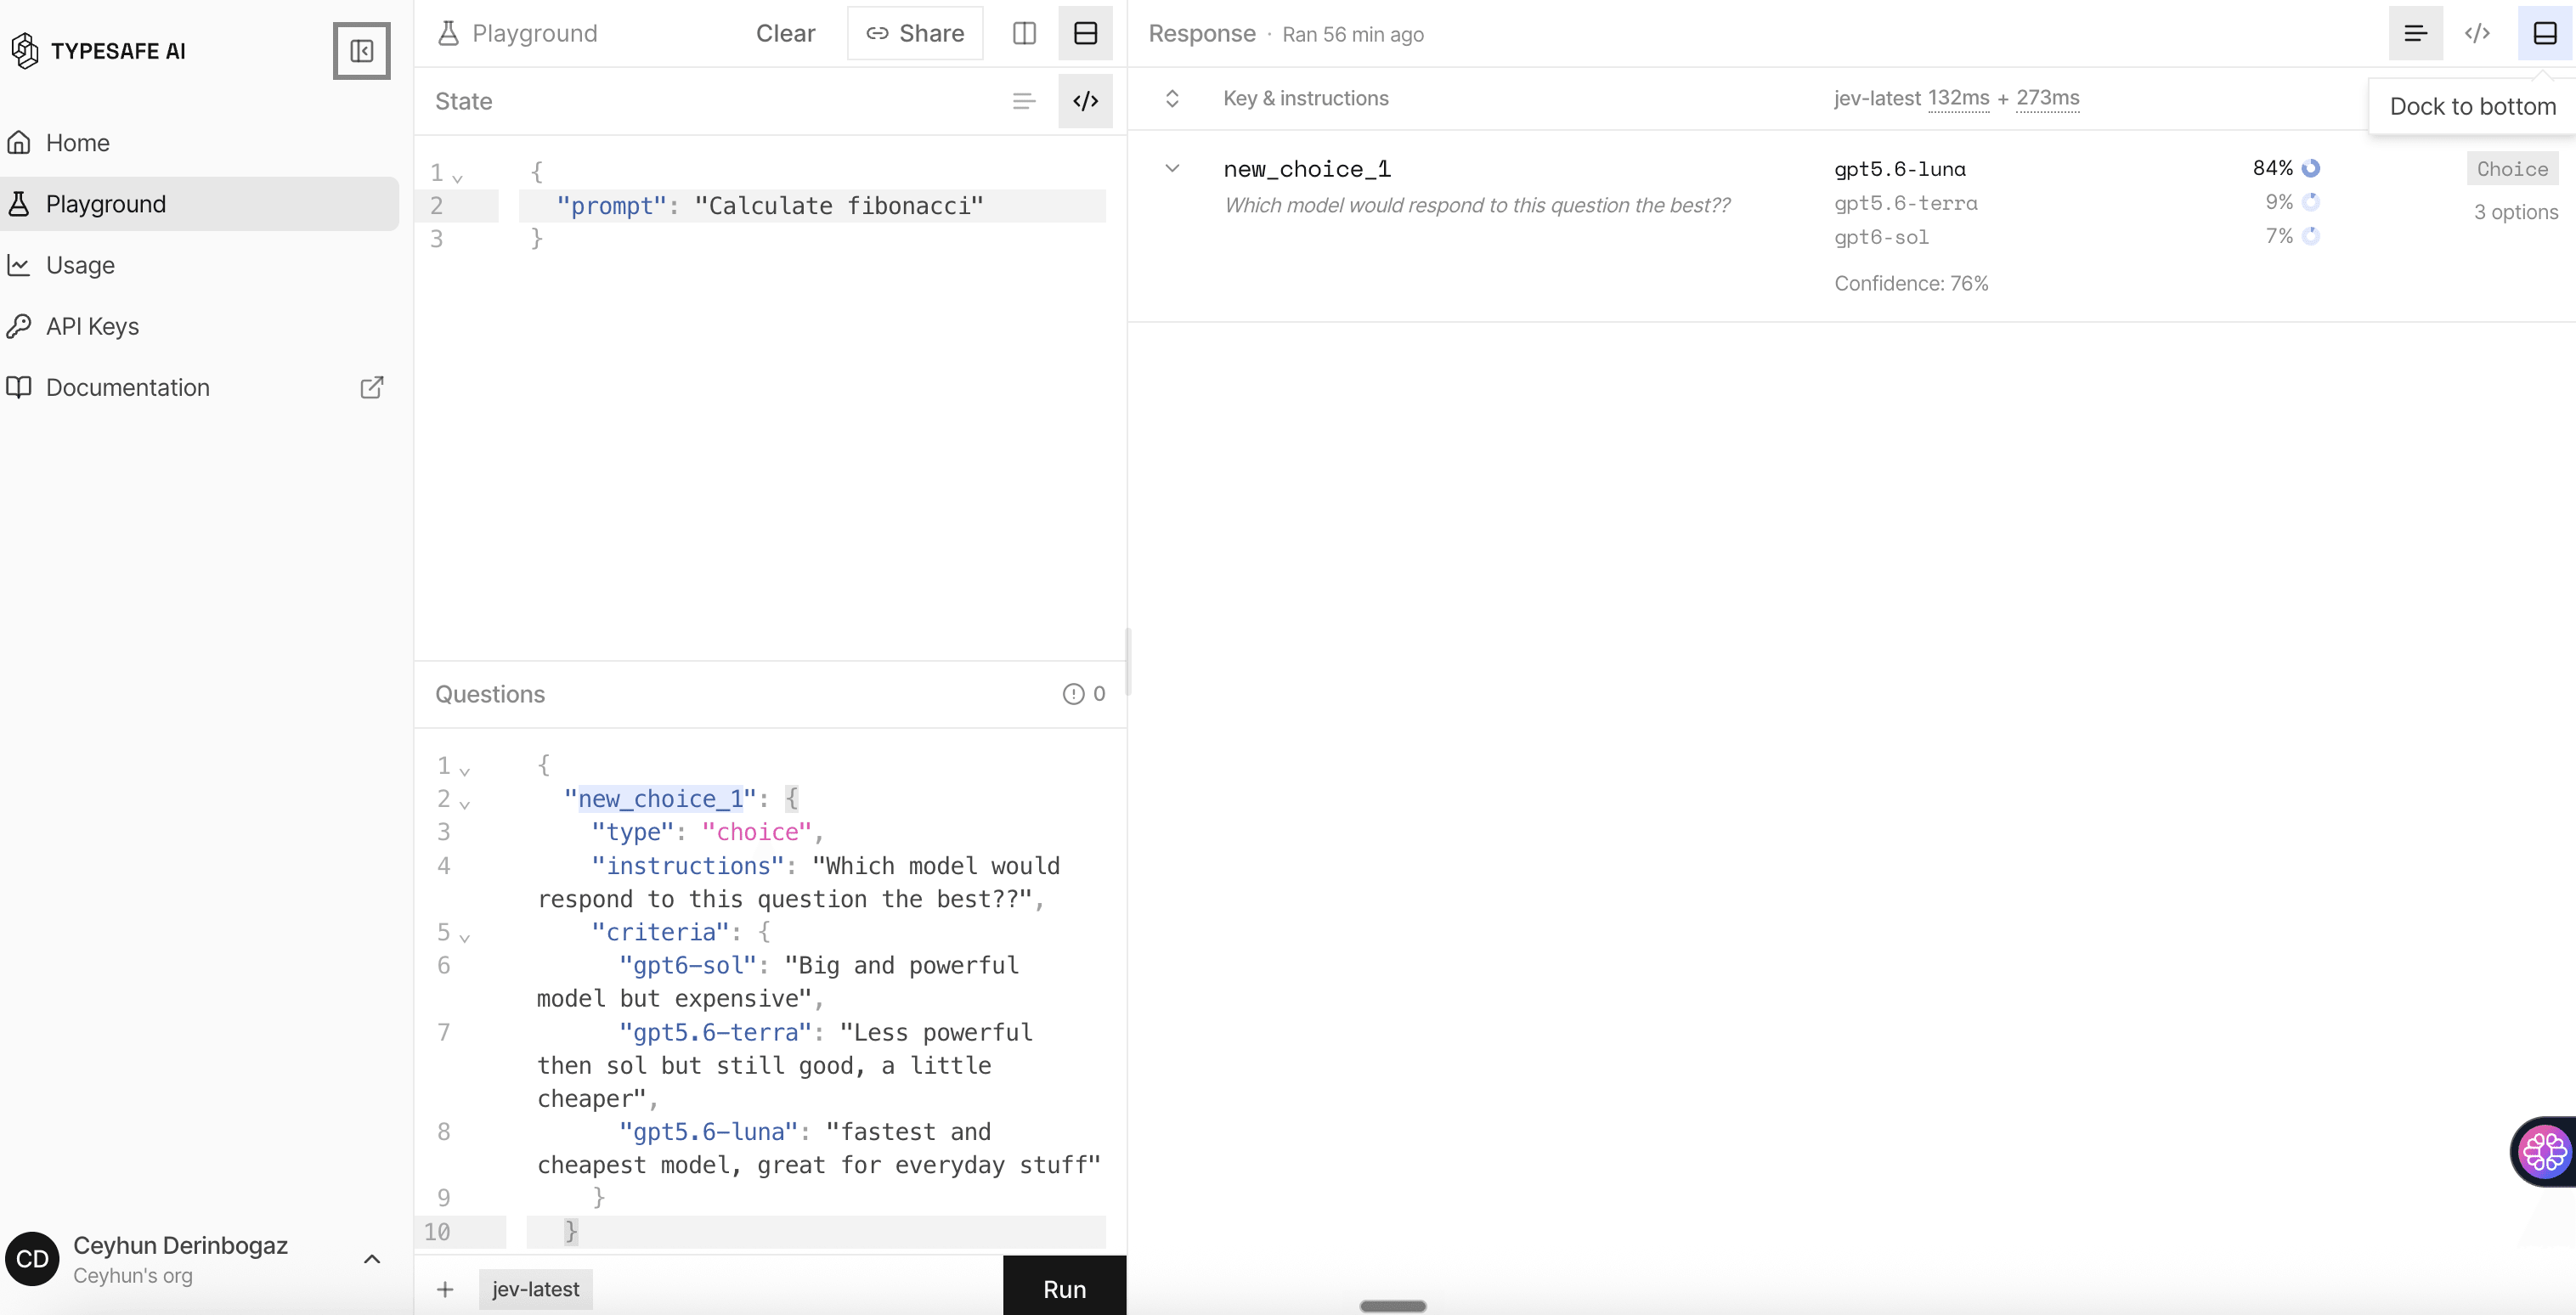
“Calculate fibonacci” ucuz katmana gider. Tabii ki. Üç yönlendiriciyi önce böyle prompt’larla test ettim ve o turu da Jev kazandı, ama bir yönlendirici için yazdığım prompt’lar zaten cevabını bildiğim prompt’lar. Neredeyse hiçbir şey kanıtlamadı.
Gerçek prompt’lar kullandım, çünkü benimkiler fazla kolaydı.
Prompt’lar, gerçek chatbot konuşmalarından oluşan açık bir veri seti olan WildChat-1M’den geliyor (ODC-BY lisansı, toksik olanlar ayıklanmış). İngilizce, Almanca, Fransızca, İspanyolca, İtalyanca, Portekizce, Felemenkçe, Lehçe, Türkçe, Rusça, Arapça, Çince, Japonca ve Korecenin her birinden 40 ilk mesaj aldım, ardından 168 daha uzun ya da daha teknik prompt ekledim, çünkü gerçek trafikte zor prompt neredeyse hiç yok.
Farklı modeller üzerinde çalışan iki kör etiketleyici, Claude Opus ve Claude Sonnet, 728 prompt’un hepsini small, medium ya da frontier olarak etiketledi. %77,5’inde anlaştılar (Cohen’s κ = 0,60). Anlaştıkları 563 prompt’u tuttum: 225 small, 317 medium, 21 frontier.
Her sistem prompt başına üç soruyu cevapladı; toplam 5.067 çağrı, sıfır kalıcı hata:
- S1, açıklamalı. “Onu hâlâ iyi cevaplayacak en ucuz katmanı seç,” her katman için örnek görevlerle.
- S2, minimal. “Basit,” “orta karmaşıklıkta” ve “çok zor istekler.”
- S3, puan. Katmanlara eşlenen üç seviyeli bir zorluk puanı.
Üç yönlendiricinin ikisi bir sabiti zar zor geçti.
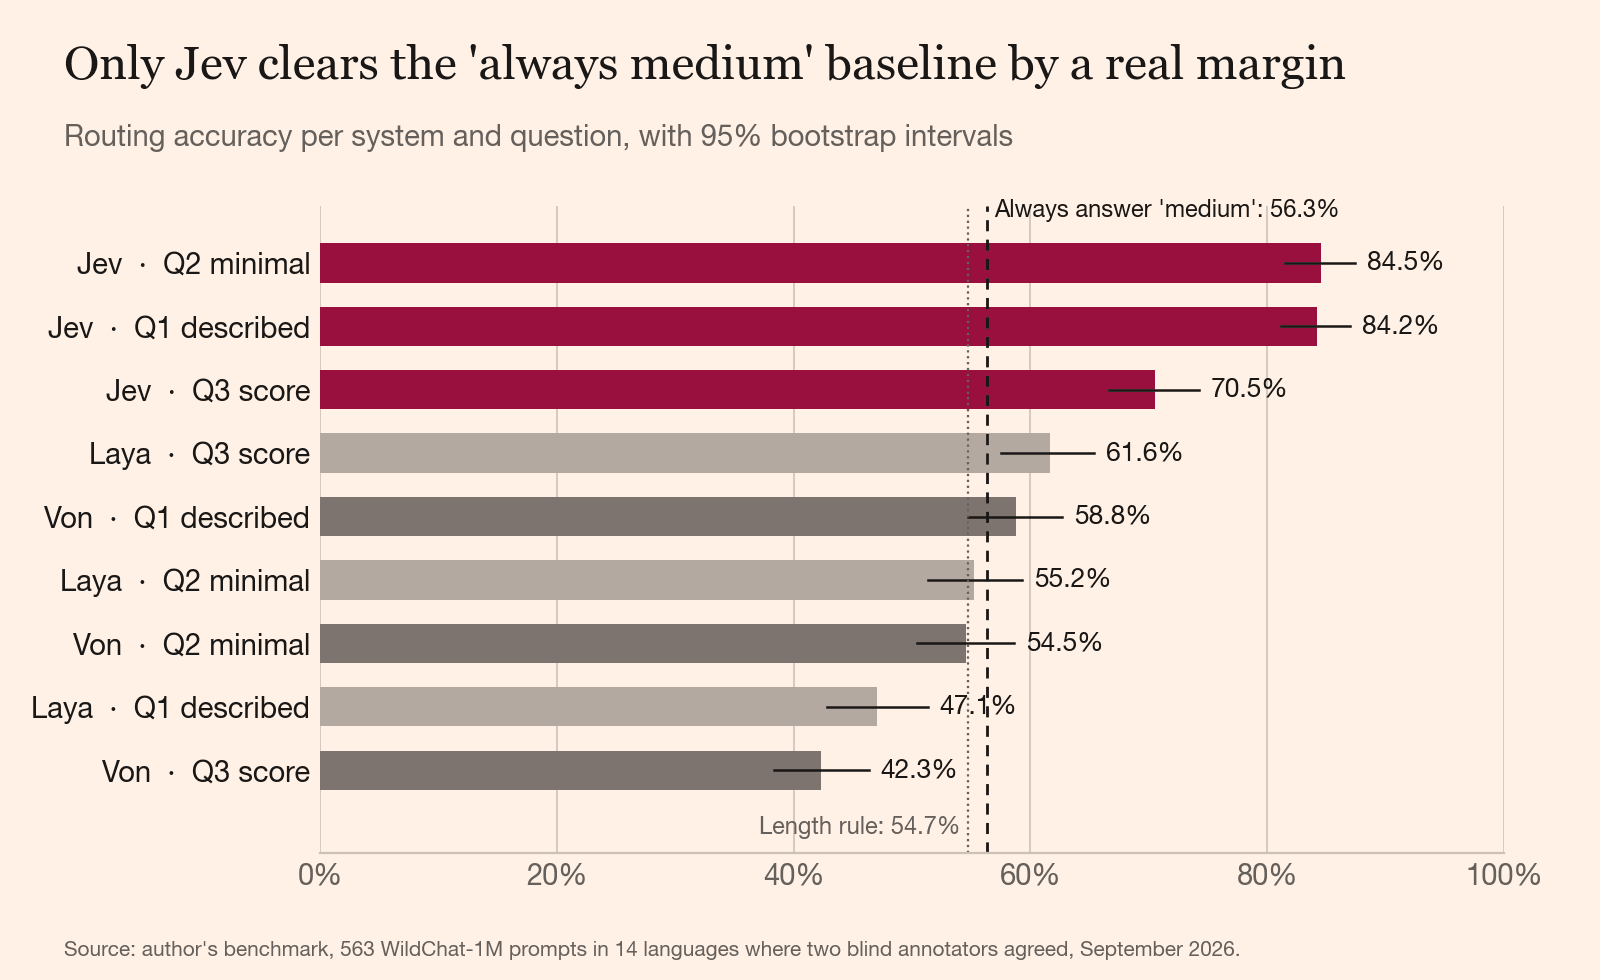
Jev iki üç kelimelik açıklamalarla %84,5, tam rubrikle %84,2 aldı. Bu fark gürültü, yani ekibimden kimsenin bir yönlendirme sorusu yazmak için prompt mühendisi olması gerekmiyor.
Laya’nın en iyi çalıştırması sabit yönlendiriciyi 5,3 puan geçti. Von’unki 2,5 puan geçti, ama %95 aralığı (%55 ile %63) sabiti hâlâ içeriyor. Yalnızca prompt uzunluğuna bakan bir kural %54,7 aldı; iki yerel çalıştırmanın üstünde ve iki çalıştırmanın daha bir puan yakınında.
return "medium"’a yenilen bir yönlendirici, yanına model indirmesi eklenmiş bir rastgele sayı üretecidir.
Yerel modeller “medium” diye tahmin edip buna karar diyor.
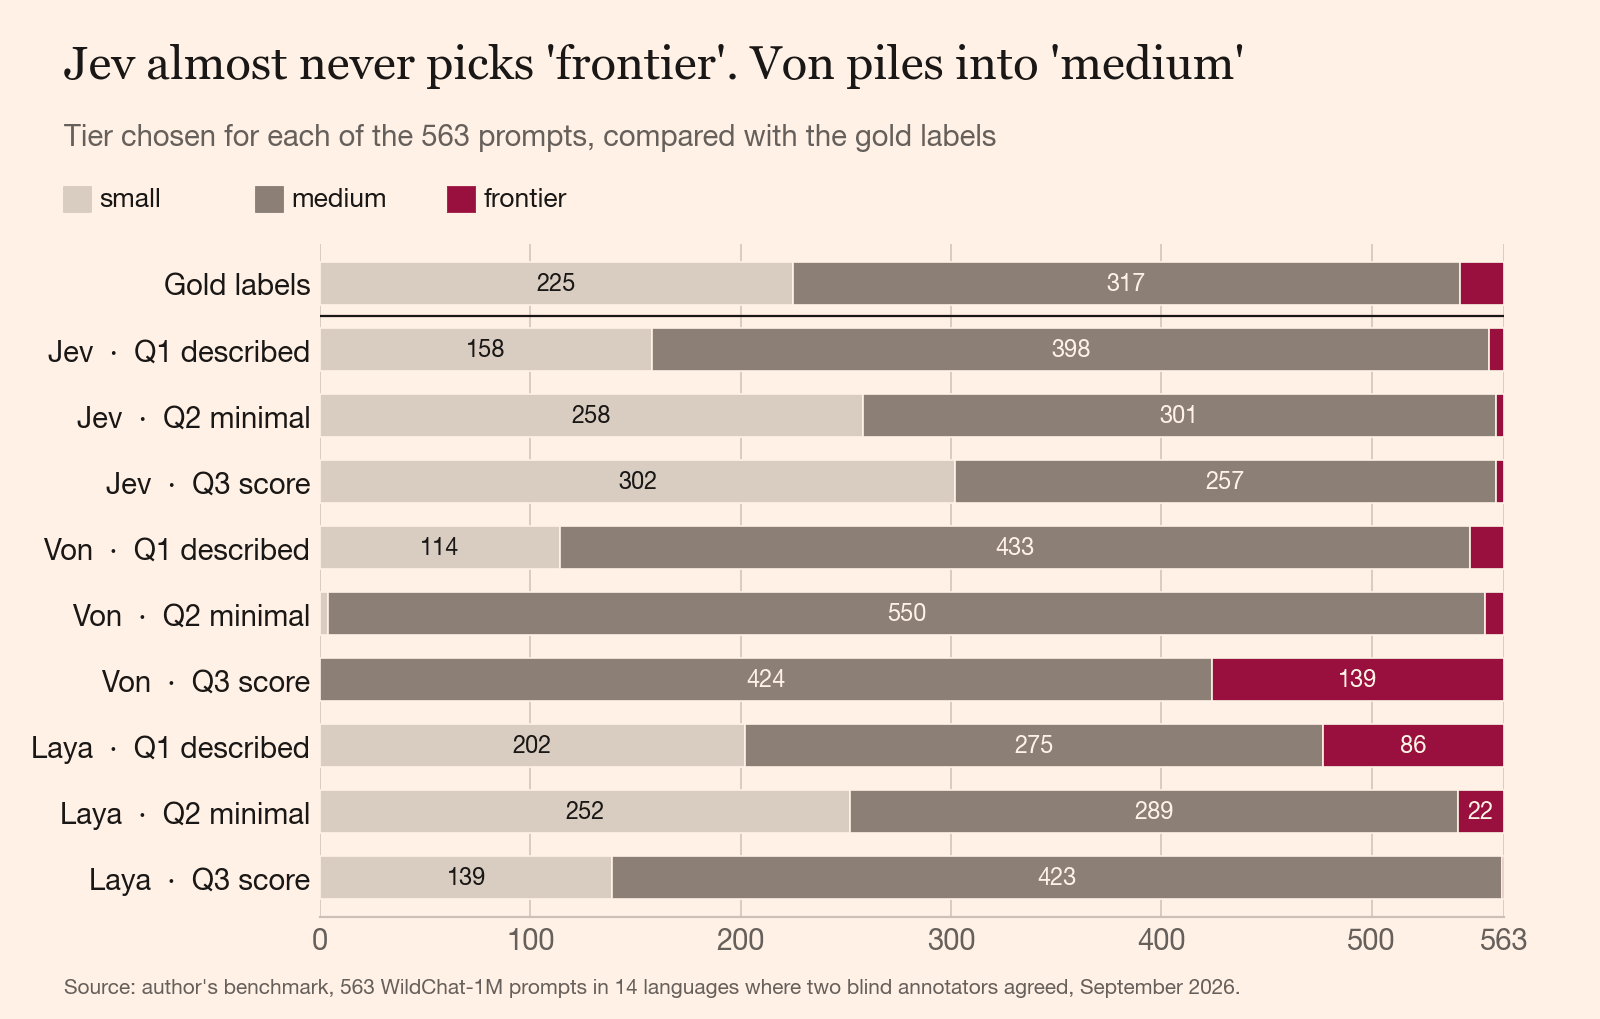
Von, S2’de 563 prompt’un 550’sine “medium” dedi. S3’te bir kez bile small demedi ve yeri frontier olan 21 prompt varken 139 prompt’u frontier’a gönderdi. Laya, S1’de 86 prompt’u frontier’a gönderdi ve yalnızca altısında haklıydı. Çok dilli checkpoint’i 1.689 çağrısının 1.329’unu karşıladı ve yine de Fransızcada %29 aldı.
Von ve Laya prompt’ların %55’ine kadarında fazla harcıyor.
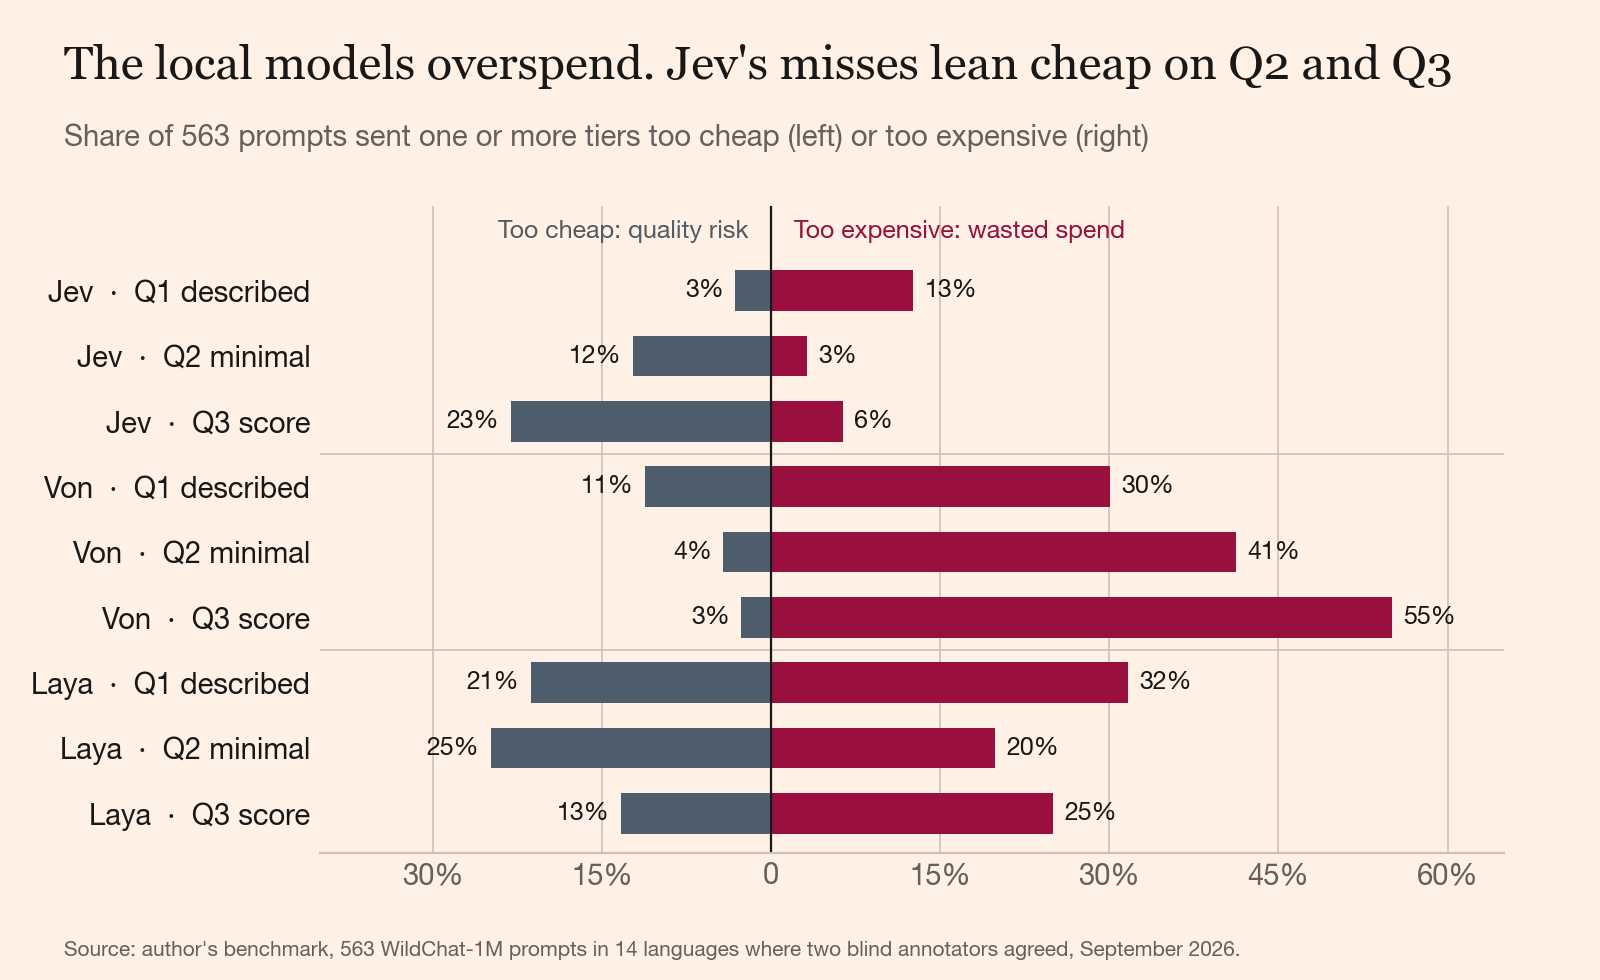
Von, S3’te tüm prompt’ların %55’ini ihtiyaç duyduklarından daha pahalı bir katmana gönderiyor. O yönlendirici, düşürmek için var olduğu faturayı yükseltiyor.
Jev, S2 ve S3’te ters yöne kayıyor ve hata başına bu daha kötü. Fazla pahalı bir cevabın maliyeti fiyat farkıdır. Gücü yetmeyen bir cevabın maliyeti ise zor bir soru sorup kendinden emin, yanlış bir yanıt alan bir kullanıcıdır. S2’de Jev’in hatalarından 51’i small’a gönderilen medium prompt’lardı. S3’te 113.
Dil Jev’i neredeyse hiç etkilemedi, diğerlerini ise çok etkiledi.
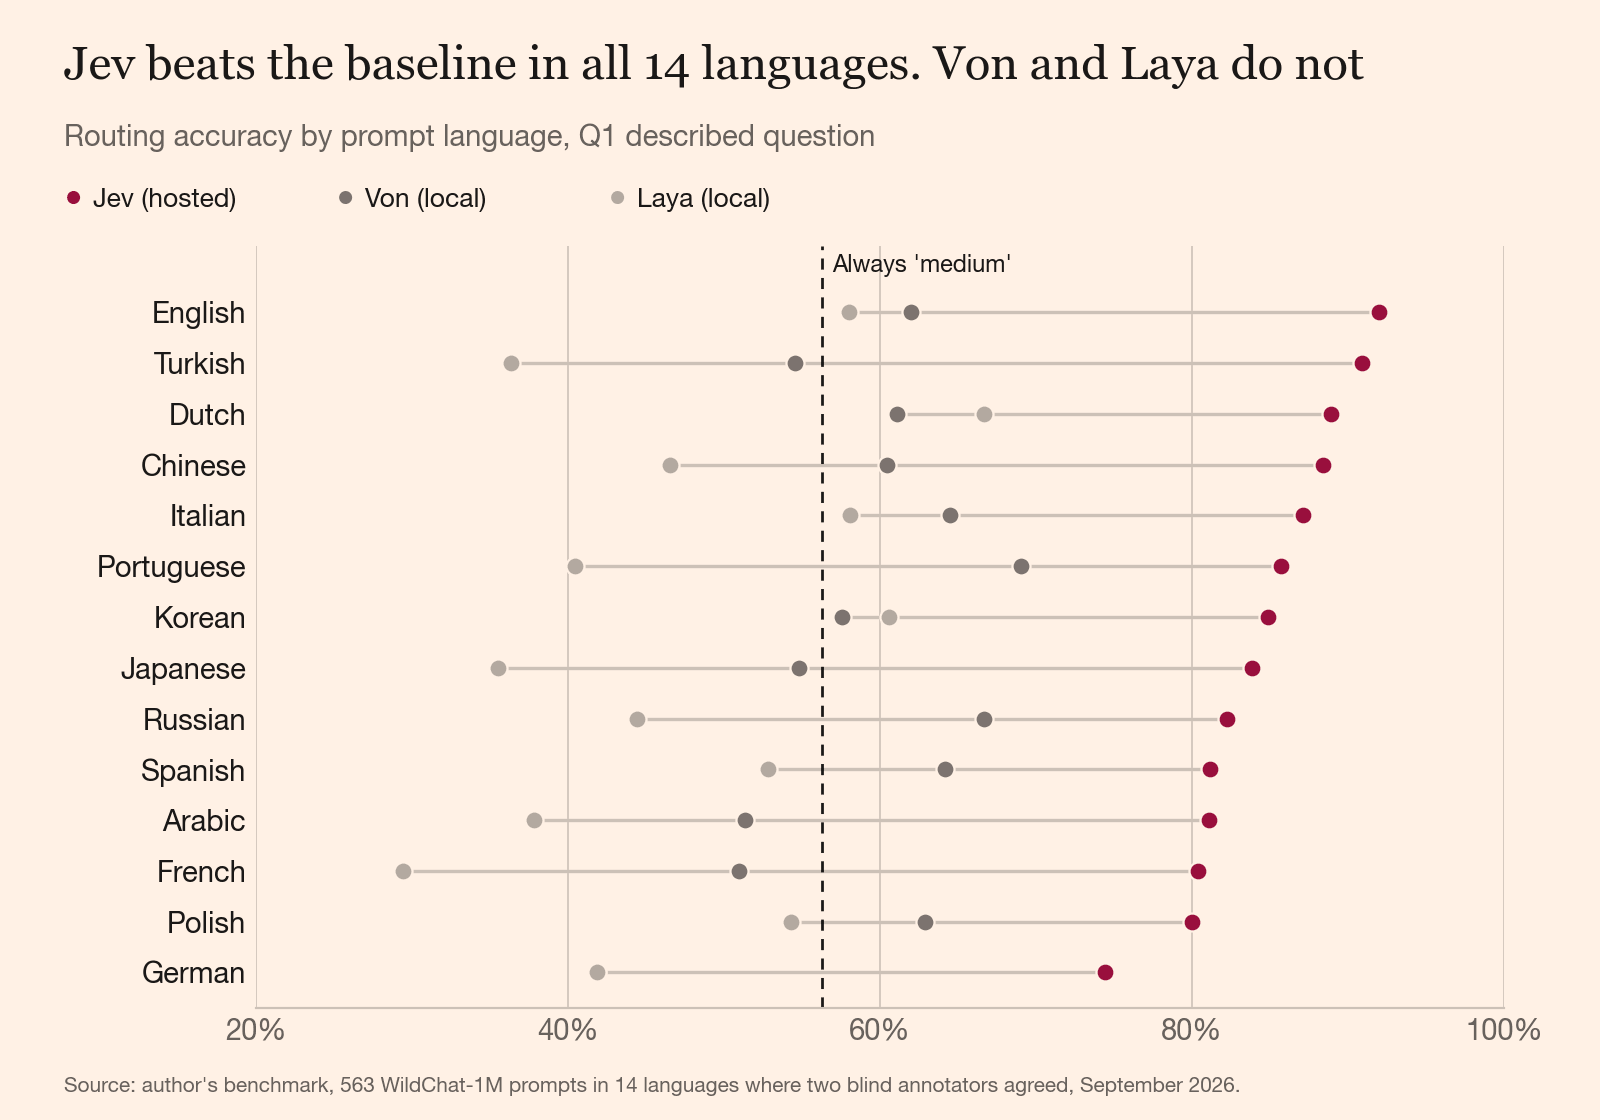
Jev %74 (Almanca) ile %92 (İngilizce) arasında kaldı ve Latin ve Latin olmayan alfabelerde aynı şekilde %84 aldı. Von Almancada %42’den Portekizcede %69’a, Laya Fransızcada %29’dan Felemenkçede %67’ye uzandı. Fransızcada üç prompt’tan birini bile doğru yönlendiremeyen bir yönlendirici Fransız müşterilerin yanına yaklaşamaz.
Jev en önemli prompt’ları kaçırıyor.
21 frontier prompt’un altısını Jev S1’de frontier’a, 15’ini medium’a gönderdi. S2’de üçünü gönderdi. Ucuza yönlendirmenin en çok zarar verdiği yer tam da burası: Türkçe bir istatistik problemi, Almanca yatırım karar kuralları, kuantum anahtar dağıtımı üzerine bir taslak. Yirmi bir küçük bir örneklem ve bunu ilk ben söylüyorum.
Jev’in olasılıkları işe yarıyor. Jev frontier’a 0,2’den fazla verdiğinde frontier’a yükselt; S1, 563 prompt’un yalnızca 18’ini yükselterek 21’in 14’ünü yakalıyor. Aynı eşikte S2 yedisini yakalıyor. 0,2’yi bu veriyi gördükten sonra seçtim, o yüzden ayarlanacak bir başlangıç noktası olarak gör.
Üç şey daha manşetin aleyhine işliyor:
- %84, Jev’i olduğundan iyi gösteriyor. Altın set, iki etiketleyicinin de üzerinde anlaştığı prompt’lar, yani daha kolay olanlar. Etiketleyiciler tüm sette yalnızca %77,5 oranında anlaştı, dolayısıyla bu katmanlarla herhangi bir yönlendirici için gerçekçi tavan %80 civarı.
- Bunlar yargıya dayalı etiketler. İki model, bir prompt’un hangi katmana ihtiyaç duyduğunu tahmin etti. Her katmanın gerçekte ne ürettiğini kimse kontrol etmedi.
- Jev daha yavaş. Dizüstü bilgisayarımdan medyan gecikme çağrı başına yaklaşık 330 ms’ydi, çoğu ağdan geliyor; yerel modellerde bu 56 ile 170 ms arasıydı.
Ucuz yönlendirici pahalı olanıdır.
Sonunda Jev’i kullanamadık: AB’de bir dağıtımı yok. Ben de Laya’yı kendi etiketlerimizle fine-tune ettim ve o yönlendirici artık Almanya’da tek bir CPU sunucusunda çalışıyor.
Yerel bir yönlendiricinin çağrı başına maliyeti sıfırdır. Ama Von’un S2’de yaptığı gibi trafiğinin %41’ini ihtiyaç duymadığı bir katmana gönderiyorsa, o çağrıların her birinde bunun bedelini ödersin ve bu maliyet okuduğum hiçbir model kartında yer almıyor.
O yüzden say. WildChat’i ya da kendi loglarını al, birkaç yüz prompt’u iki etiketleyiciyle etiketle, anlaşamadıklarını at ve yönlendiricini return "medium"’a karşı puanla. O çizgiyi on puanla geçemiyorsa elinde bir yönlendirici yok.
Sırada çalıştıracağımız daha iyi test sonuca dayalı: gerçek trafiği her katmandan geçir, cevabı yeterince iyi olan en ucuz katmanı kaydet ve yönlendiriciyi buna karşı puanla. Jev’in %84’ü orada dağılırsa, onu da yayımlayacağım.