Traduction automatique. Lire l’original en anglais: Train your own Jev: an 11x faster System-1 model with almost free hosting →
Vendredi, j’ai écrit sur Raya, le routeur qui choisit un niveau de modèle pour chaque prompt dans TextCortex. Il obtient 81 % sur notre benchmark de 563 prompts et répond en 30 ms sur un CPU à Falkenstein. Cet article ne disait pas comment en construire un.
La recette est désormais publique, dans le
dossier training/
du dépôt Hugging Face de Raya, sous licence Apache-2.0. Décrivez la décision, faites
étiqueter vos données par deux LLM, entraînez, évaluez, exportez vers ONNX. Ce matin, j’ai
exécuté chaque étape sauf l’étiquetage sur un portable Apple M4 pour vérifier qu’elle
fonctionne telle qu’elle est écrite. L’entraînement a pris 34 secondes et l’export 24.
Voici la thèse. Si vous envoyez à un modèle frontier la même question, avec un ensemble fixe de réponses, à chaque requête, cette question a sa place dans un petit classifieur qui vous appartient. Utilisez le gros modèle une seule fois, comme professeur, et arrêtez de le payer à chaque décision.
Vous payez un LLM pour répondre un million de fois à la même question.
Le README appelle le résultat un modèle System-1, et je garde le terme. Un modèle System-1 répond à une question bien définie sur une entrée, instantanément, avec des probabilités sur lesquelles vous pouvez poser un seuil. Quel modèle doit répondre à ce prompt ? Ce ticket a-t-il besoin d’un humain ? Quelle équipe est responsable de cette demande ? C’est un encodeur Laya fine-tuné d’environ 300 millions de paramètres, il tourne en quelques dizaines de millisecondes, et il n’a aucun coût par appel.
Appeler un modèle de chat pour ces questions, c’est engager un avocat pour trier votre courrier : une facture par enveloppe, une attente pour chacune, et une copie de votre courrier sur le serveur de quelqu’un d’autre. Pour une entreprise européenne, ce dernier point peut clore la discussion : nous avons construit Raya parce que le routeur que nous voulions n’avait aucun déploiement dans l’UE.
L’attente, elle, se mesure facilement. Raya répond en 30 ms au p50 en production. Quand j’ai mesuré Jev, le routeur hébergé que Raya remplace, il mettait environ 350 ms par appel : Raya est environ 11 fois plus rapide. Il tourne sur un serveur Hetzner à 84 € par mois qui figurait déjà sur notre facture, donc l’hébergement ne nous a rien coûté de plus.
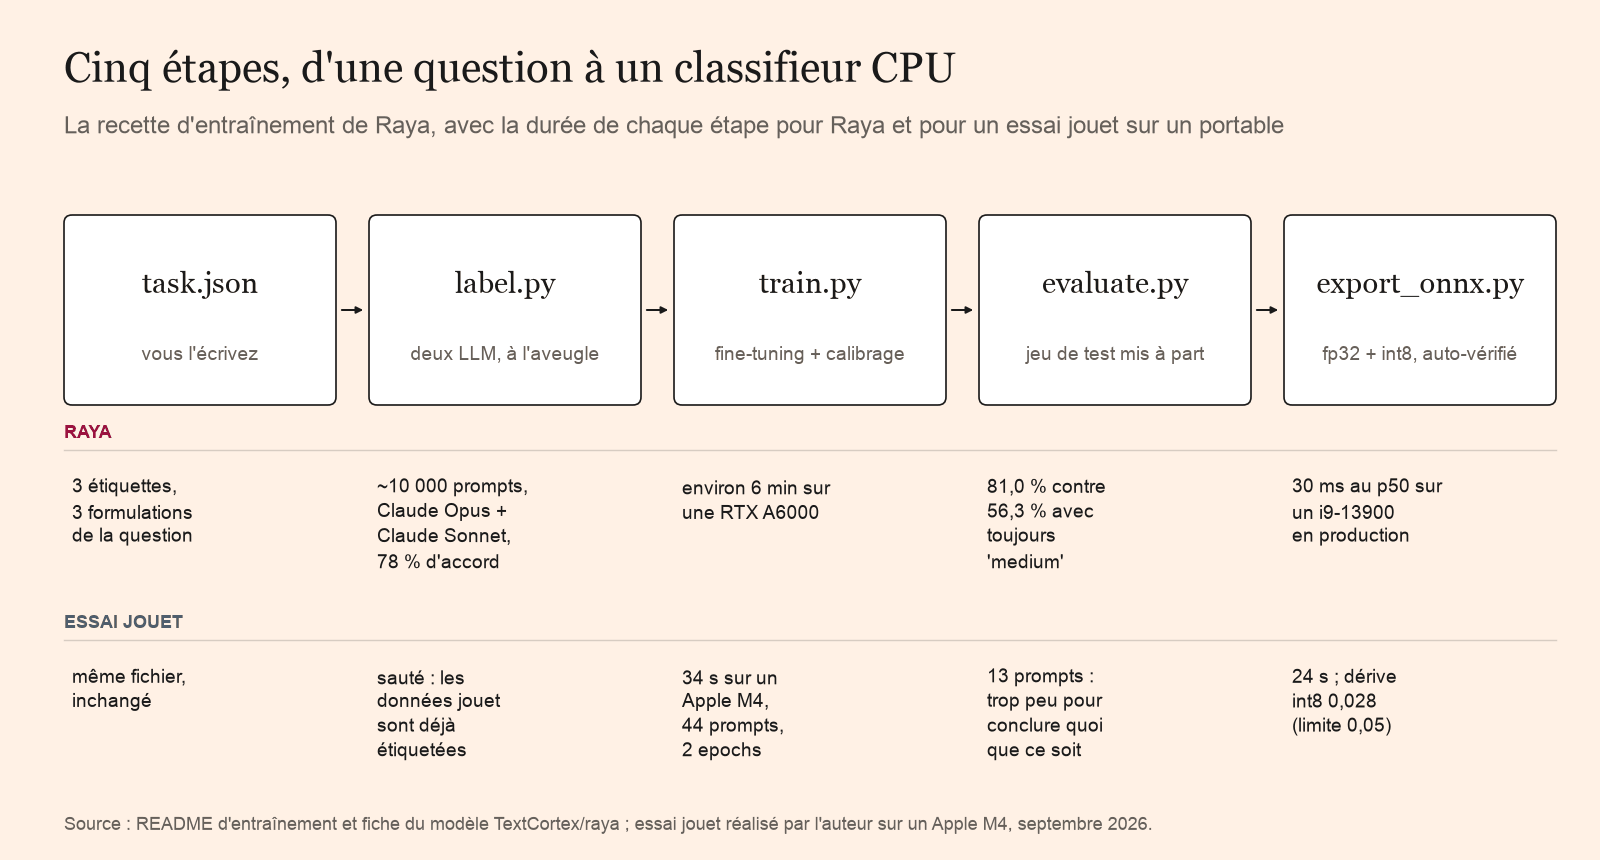
Toute la recette tient en quatre scripts et un fichier JSON.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Avant tout cela, vous écrivez task.json : les étiquettes, et une ou plusieurs
formulations de la question. Raya en a trois : « Route this prompt to a model », une
version plus longue avec une grille par niveau, et un score de difficulté de 1 à 3. Le
modèle s’entraîne sur chaque formulation avec les options remélangées à chaque epoch, il
apprend donc la décision elle-même. Le fichier contient aussi la grille que lisent les
annotateurs, et
celle de Raya
sert de modèle.
Deux annotateurs en désaccord valent mieux qu’un seul qui semble sûr de lui.
Vous avez probablement des entrées et aucune étiquette. label.py envoie chaque entrée à deux
LLM ou plus, séparément, avec la même grille. Les quelque 10 000 étiquettes de Raya viennent
de Claude Opus et Claude Sonnet, chacun à l’aveugle vis-à-vis de l’autre. N’importe quel endpoint
compatible OpenAI fonctionne, y compris ceux d’Anthropic, OpenRouter, vLLM et Ollama.
Là où les annotateurs sont d’accord, vous obtenez une étiquette propre. Là où ils divergent, la ligne
garde les deux votes et train.py apprend une cible 50/50. C’est la réponse honnête
pour un prompt sur lequel deux modèles solides se partagent. Imposer une étiquette ferme à cet endroit
apprend au modèle un pile ou face comme s’il s’agissait d’un fait.
Le script affiche aussi à quelle fréquence les annotateurs étaient d’accord. Notez ce chiffre. C’est à peu près le plafond de ce que votre modèle peut obtenir face à ces étiquettes. Pour Raya, il était de 78 %. Si vos annotateurs sont d’accord 75 % du temps et que votre modèle obtient 90 %, il a appris les habitudes d’un seul annotateur, et la solution est une grille plus stricte.
Côté volume, le README recommande 1 000 à 5 000 entrées réelles pour un premier modèle, dans
les langues que vous servez réellement. Laissez les classes déséquilibrées ; train.py
pondère lui-même les étiquettes rares. Gardez un jeu de test
sur lequel rien ne s’entraîne ni ne se valide jamais.
Le GPU est la partie bon marché.
Raya s’est entraîné en environ six minutes sur une seule RTX A6000 de 48 Go. Sur mon M4, il a fait deux epochs sur les 40 lignes d’entraînement jouets en 22 secondes, 34 avec le chargement du modèle.
Il gèle la table d’embeddings des tokens pour économiser de la mémoire, choisit la meilleure epoch sur la validation, puis ajuste une température par question pour qu’une probabilité de 0,9 soit juste environ neuf fois sur dix. C’est cette calibration qui vous permet ensuite d’agir sur un seuil, par exemple n’envoyer un prompt vers le niveau frontier qu’au-dessus de 0,6.
Le point de départ par défaut est mmBERT-base, l’encodeur multilingue de Laya. Passez
--base TextCortex/raya pour adapter plutôt Raya à votre propre trafic de routage.
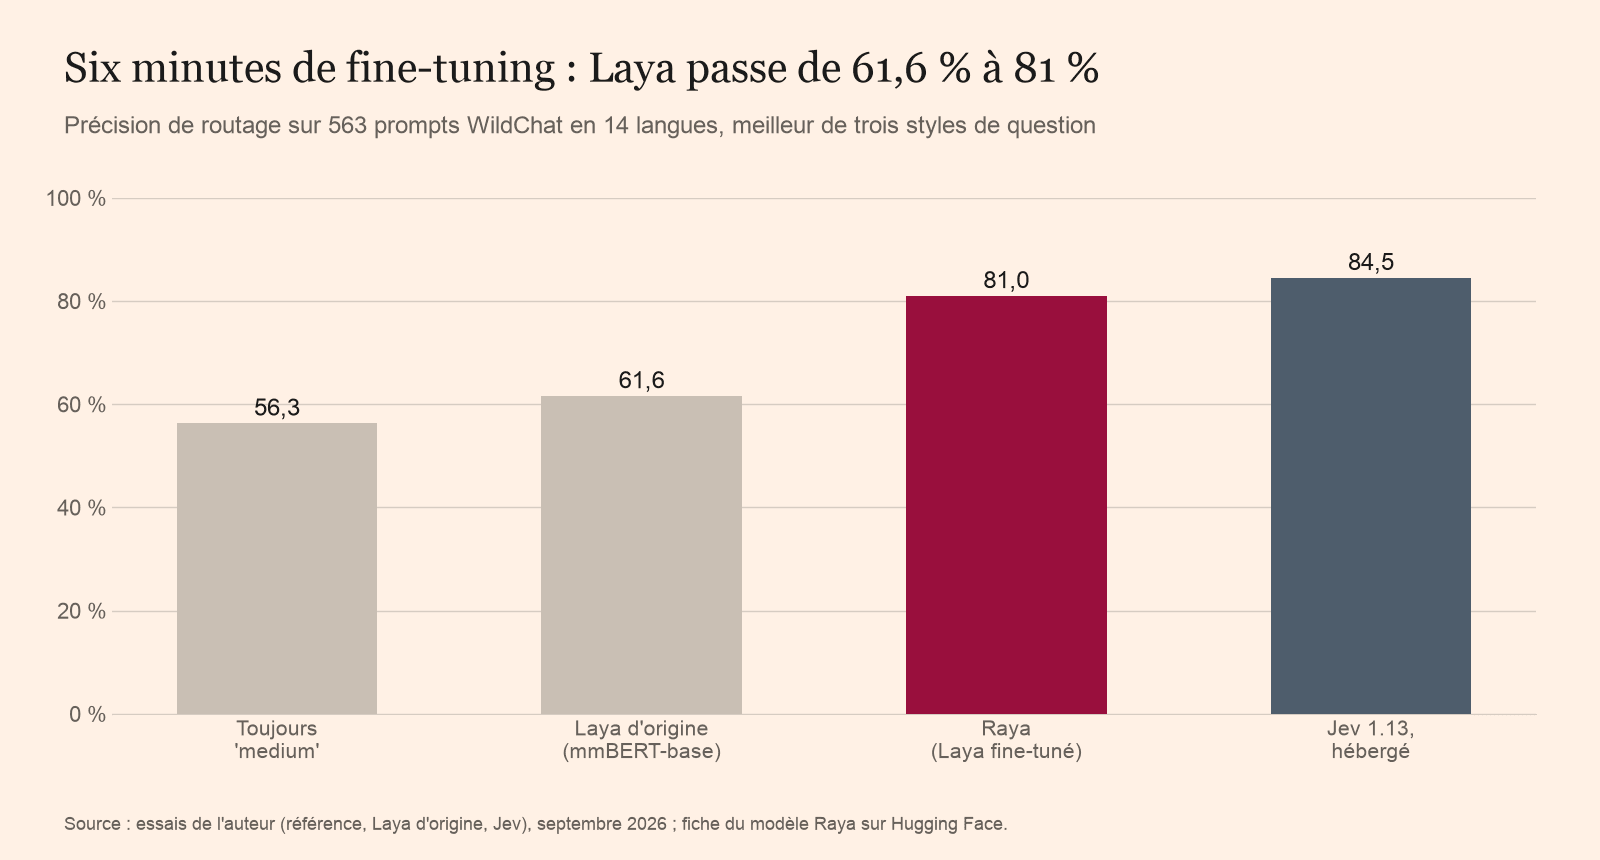
Six minutes de GPU ont fait passer Laya de 61,6 % à 81 %, à trois points et demi de Jev. C’est dans les étiquettes que passe votre après-midi.
Les données jouets prouvent que la tuyauterie fonctionne, et rien de plus.
Le dossier contient 44 prompts de routage écrits à la main pour l’entraînement et 13 pour
le test. Le README promet cinq minutes. L’entraînement et l’export ont pris moins d’une
minute, installation non comprise, avec les versions épinglées. L’appel d’exemple du README a routé « Prove that √2 is irrational. »
vers frontier_model à 0,52.
evaluate.py a ensuite noté le modèle jouet à 46,2 % sur la formulation courte, 84,6 %
sur la formulation avec grille et 69,2 % sur le score de difficulté. La formulation courte
a envoyé 12 des 13 prompts vers medium. Treize prompts ne permettent pas de distinguer ces
chiffres du bruit, et 44 lignes d’entraînement sont, selon les mots du README, « bien trop
peu pour entraîner un modèle utile ».
La chose utile qu’a faite evaluate.py, c’est d’afficher cette ligne en premier :
13 rows with a gold label; always answering 'small_model' scores 38.5%C’est la baseline constante. Dans le
premier benchmark,
Laya d’origine perdait face à return "medium" sur deux de ses trois styles de question.
Chaque évaluation devrait commencer par le score du modèle qui ne fait rien.
Exportez une fois, puis mesurez sur le CPU que vous allez vraiment louer.
export_onnx.py écrit un fichier fp32 et un fichier int8 par blocs, puis vérifie
les deux par rapport à PyTorch sur vos données de test. L’export échoue si un choix change
ou si les probabilités dérivent de plus de 0,001 pour le fp32 ou de 0,05 pour l’int8. Mon modèle
jouet est sorti à 0,00000 et 0,02790.
Le fichier à livrer dépend du silicium. Comme l’a mesuré l’article précédent, l’int8 par blocs a conservé la précision de Raya et tournait le plus vite sur un i9-13900 doté des instructions VNNI, mais prenait plus de deux fois plus de temps que le fp32 sur un EPYC 7502P qui ne les a pas. Mesurez sur votre propre matériel avant de choisir.
Louez le gros modèle une fois, puis arrêtez de le payer à chaque décision.
L’industrie des modèles frontier facture chaque appel, alors chaque appel ressemble à un travail pour un modèle frontier. Tout appel qui choisit dans une liste fixe de réponses est une classification, facturée comme du raisonnement. Une fois les étiquettes écrites, le LLM est un moyen coûteux d’atteindre un verdict qu’un encodeur de 300M atteint en 30 ms sur du matériel que vous payez déjà.
Il y a une limite que je vous dois. Les données d’entraînement de Raya ne sont pas publiées, donc vous pouvez construire votre propre Raya avec ce dossier, mais pas reproduire le nôtre. Et Raya a appris des deux mêmes annotateurs qui ont écrit les étiquettes du benchmark, ce qui flatte ses 81 %.
Alors mesurez-le sur votre propre trafic. Lancez evaluate.py sur un jeu de test que votre modèle
n’a jamais vu. S’il ne dépasse pas la baseline constante avec une large marge,
resserrez la grille avant de toucher à quoi que ce soit d’autre. Si la recette échoue sur votre
décision, envoyez-moi les chiffres et je les publierai.