Maschinell übersetzt. Zum englischen Original: Train your own Jev: an 11x faster System-1 model with almost free hosting →
Am Freitag habe ich über Raya geschrieben, den Router, der in TextCortex für jeden Prompt eine Modellstufe auswählt. Er erreicht 81 % auf unserem Benchmark mit 563 Prompts und antwortet in 30 ms auf einer CPU in Falkenstein. Wie man so einen baut, stand in dem Beitrag nicht.
Das Rezept ist jetzt öffentlich, im
Ordner training/
von Rayas Hugging-Face-Repo, unter Apache-2.0. Beschreib die Entscheidung, lass zwei
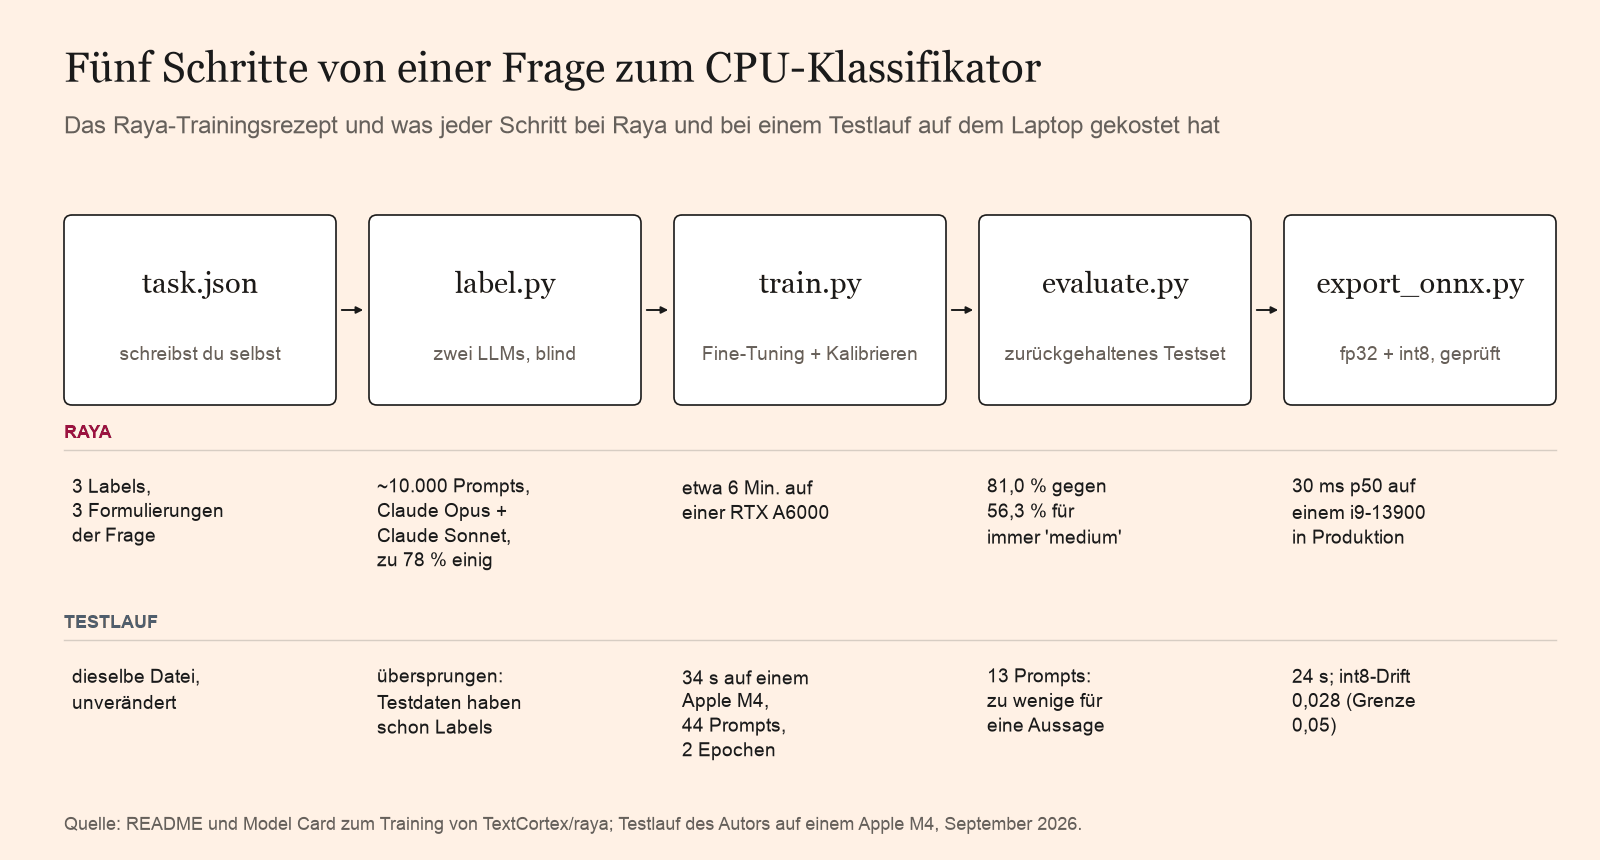
LLMs deine Daten labeln, trainiere, evaluiere, exportiere nach ONNX. Ich habe heute Morgen jeden Schritt außer
dem Labeln auf einem Apple-M4-Laptop laufen lassen, um zu prüfen, ob es so funktioniert, wie es
dasteht. Das Training dauerte 34 Sekunden, der Export 24.
Das ist die These. Wenn du einem Frontier-Modell bei jeder Anfrage dieselbe Frage mit einer festen Menge an Antworten schickst, gehört diese Frage in einen kleinen Klassifikator, der dir gehört. Nutz das große Modell einmal, als Lehrer, und hör auf, es pro Entscheidung zu bezahlen.
Du bezahlst ein LLM dafür, dieselbe Frage eine Million Mal zu beantworten.
Das README nennt das Ergebnis ein System-1-Modell, und ich bleibe bei dem Begriff. Ein System-1-Modell beantwortet eine klar definierte Frage über eine Eingabe, sofort, mit Wahrscheinlichkeiten, auf die du einen Schwellwert setzen kannst. Welches Modell soll diesen Prompt beantworten? Braucht dieses Ticket einen Menschen? Welches Team ist für diese Anfrage zuständig? Es ist ein per Fine-Tuning nachtrainierter Laya-Encoder mit etwa 300 Millionen Parametern, er läuft in einigen zehn Millisekunden, und er kostet keine Gebühr pro Aufruf.
Für so etwas ein Chat-Modell aufzurufen heißt, einen Anwalt zum Sortieren deiner Post anzustellen: eine Rechnung pro Umschlag, Warten bei jedem einzelnen und eine Kopie deiner Post auf dem Server von jemand anderem. Für ein europäisches Unternehmen kann dieser letzte Punkt das Gespräch beenden: Wir haben Raya gebaut, weil der Router, den wir wollten, kein EU-Deployment hatte.
Das Warten lässt sich leicht messen. Raya antwortet in Produktion in 30 ms beim p50. Als ich Jev gemessen habe, den gehosteten Router, den Raya ersetzt, brauchte er etwa 350 ms pro Aufruf: Raya ist ungefähr 11-mal schneller. Es läuft auf einem Hetzner-Server für 84 € im Monat, der ohnehin schon auf unserer Rechnung stand, also hat uns das Hosting nichts zusätzlich gekostet.
Das ganze Rezept besteht aus vier Skripten und einer JSON-Datei.
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
    --annotator <model-a> --annotator <model-b>@https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
Vor alldem schreibst du task.json: die Labels und eine oder mehrere
Formulierungen der Frage. Raya hat drei: „Route this prompt to a model“, eine
längere Version mit einer Rubrik pro Stufe und einen Schwierigkeitswert von 1 bis 3. Das
Modell trainiert auf jeder Formulierung, mit in jeder Epoche neu gemischten Optionen, und
lernt so die Entscheidung selbst. Die Datei enthält außerdem die Rubrik, die die Annotatoren
lesen, und
Rayas eigene
liegt als Vorlage bei.
Zwei Annotatoren, die sich uneinig sind, sind mehr wert als einer, der sicher klingt.
Wahrscheinlich hast du Eingaben und keine Labels. label.py schickt jede Eingabe an zwei oder
mehr LLMs, getrennt voneinander, mit derselben Rubrik. Rayas rund 10.000 Labels kamen
von Claude Opus und Claude Sonnet, blind füreinander. Jeder OpenAI-kompatible
Endpunkt funktioniert, darunter der von Anthropic, OpenRouter, vLLM und Ollama.
Wo die Annotatoren übereinstimmen, bekommst du ein sauberes Label. Wo sie sich uneinig sind, behält die Zeile
beide Stimmen, und train.py lernt ein 50/50-Ziel. Das ist die ehrliche
Antwort auf einen Prompt, bei dem sich zwei starke Modelle aufteilen. Wer dort ein hartes Label erzwingt,
bringt dem Modell einen Münzwurf bei, als wäre er eine Tatsache.
Das Skript gibt außerdem aus, wie oft die Annotatoren übereinstimmten. Schreib dir diese Zahl auf. Sie ist ungefähr die Obergrenze dessen, was dein Modell gegen diese Labels erreichen kann. Bei Raya waren es 78 %. Wenn deine Annotatoren zu 75 % übereinstimmen und dein Modell 90 % erreicht, hat es die Eigenheiten eines Annotators gelernt, und die Lösung ist eine engere Rubrik.
Zur Menge sagt das README 1.000 bis 5.000 echte Eingaben für ein erstes Modell, in
den Sprachen, die du tatsächlich bedienst. Lass die Klassen unausgewogen; train.py
gewichtet seltene Labels selbst. Halte ein Testset zurück,
auf dem nie etwas trainiert oder validiert wird.
Die GPU ist der billige Teil.
Raya hat auf einer einzigen RTX A6000 mit 48 GB etwa sechs Minuten trainiert. Auf meinem M4 liefen zwei Epochen über die 40 Test-Trainingszeilen in 22 Sekunden, 34 mit dem Laden des Modells.
Das Skript friert die Token-Embedding-Tabelle ein, um Speicher zu sparen, wählt die beste Epoche auf der Validierung aus und fittet dann pro Frage eine Temperatur, sodass eine Wahrscheinlichkeit von 0,9 in etwa neun von zehn Fällen stimmt. Diese Kalibrierung erlaubt dir, später auf einen Schwellwert hin zu handeln, etwa einen Prompt erst ab 0,6 an die Frontier-Stufe zu schicken.
Der Standard-Ausgangspunkt ist Layas mehrsprachiges mmBERT-base. Übergib
--base TextCortex/raya, um stattdessen Raya an deinen eigenen Routing-Traffic anzupassen.
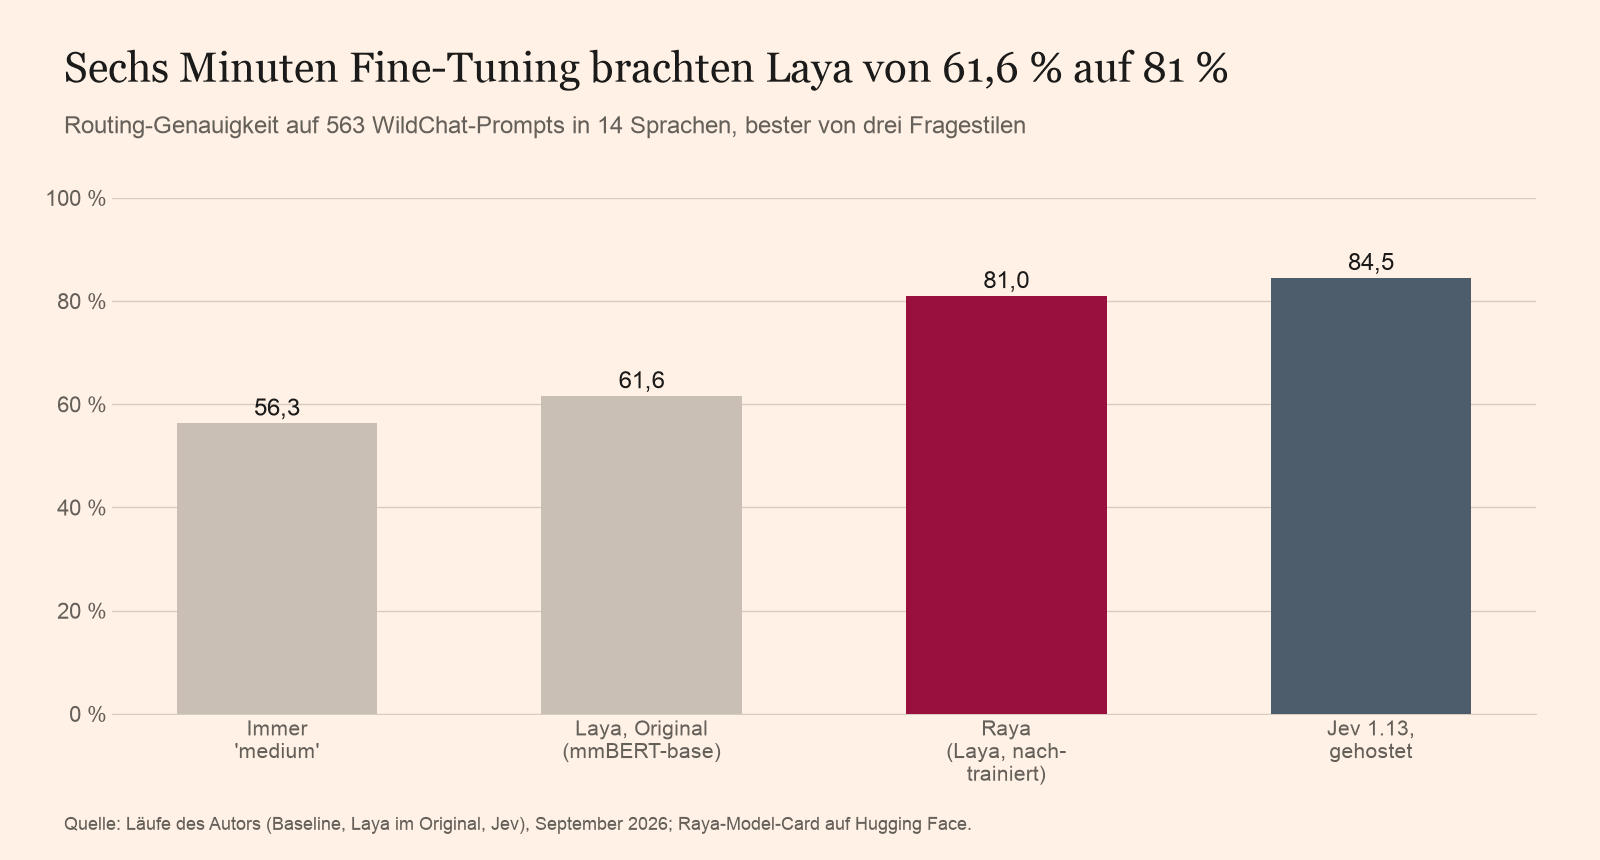
Sechs Minuten GPU-Zeit haben Laya von 61,6 % auf 81 % gebracht, dreieinhalb Punkte hinter Jev. In die Labels fließt dein Nachmittag.
Die Testdaten beweisen, dass die Leitungen dicht sind, und sonst nichts.
Der Ordner enthält 44 handgeschriebene Routing-Prompts fürs Training und 13 zum
Testen. Das README verspricht fünf Minuten. Training und Export dauerten mit den gepinnten Versionen weniger als
eine Minute, ohne die Installation. Der Beispielaufruf aus dem README routete „Prove that √2 is irrational.“
an frontier_model mit 0,52.
evaluate.py bewertete das Testmodell dann mit 46,2 % bei der kurzen Formulierung, 84,6 %
bei der Formulierung mit Rubrik und 69,2 % beim Schwierigkeitswert. Die kurze Formulierung
schickte 12 von 13 Prompts an medium. Dreizehn Prompts können diese
Zahlen nicht von Rauschen unterscheiden, und 44 Trainingszeilen sind, in den Worten des README, „viel zu
klein, um ein brauchbares Modell zu trainieren“.
Das Nützliche, was evaluate.py getan hat, war, zuerst diese Zeile auszugeben:
13 rows with a gold label; always answering 'small_model' scores 38.5%Das ist die konstante Baseline. Im
ersten Benchmark
hat Laya im Originalzustand bei zwei von drei Fragestilen gegen return "medium" verloren.
Jede Evaluation sollte mit dem Wert des Modells beginnen, das nichts tut.
Exportier einmal und miss dann auf der CPU, die du tatsächlich mieten wirst.
export_onnx.py schreibt eine fp32-Datei und eine blockweise int8-Datei und prüft dann
beide auf deinen Testdaten gegen PyTorch. Der Export schlägt fehl, wenn sich irgendeine Auswahl ändert
oder die Wahrscheinlichkeiten um mehr als 0,001 bei fp32 oder 0,05 bei int8 abweichen. Mein Testmodell
kam auf 0,00000 und 0,02790.
Welche Datei du auslieferst, hängt vom Silizium ab. Wie im letzten Beitrag gemessen, hat blockweises int8 Rayas Genauigkeit gehalten und lief auf einem i9-13900 mit VNNI-Instruktionen am schnellsten, brauchte aber auf einem EPYC 7502P ohne sie mehr als doppelt so lange wie fp32. Miss auf deiner eigenen Hardware, bevor du dich entscheidest.
Miete das große Modell einmal und hör dann auf, es pro Entscheidung zu bezahlen.
Die Frontier-Modell-Branche bepreist jeden Aufruf, also sieht jeder Aufruf wie ein Job für ein Frontier-Modell aus. Jeder Aufruf, der aus einer festen Liste von Antworten wählt, ist eine Klassifikation, abgerechnet als Reasoning. Sobald die Labels geschrieben sind, ist das LLM ein teurer Weg zu einem Urteil, zu dem ein 300M-Encoder in 30 ms auf Hardware kommt, die du ohnehin schon bezahlst.
Eine Einschränkung schulde ich dir. Rayas Trainingsdaten sind nicht veröffentlicht, du kannst mit diesem Ordner also deinen eigenen Raya bauen, unseren aber nicht reproduzieren. Und Raya hat von denselben zwei Annotatoren gelernt, die die Benchmark-Labels geschrieben haben, was seine 81 % schönt.
Miss es also auf deinem eigenen Traffic. Lass evaluate.py auf einem Testset laufen, das dein Modell
nie gesehen hat. Wenn es die konstante Baseline nicht deutlich übertrifft,
schärf die Rubrik nach, bevor du irgendetwas anderes anfasst. Wenn das Rezept bei deiner
Entscheidung versagt, schick mir die Zahlen, und ich veröffentliche sie.