Maschinell übersetzt. Zum englischen Original: Our LLM router runs at 30 ms p50 on an €84/month Hetzner server, no GPU →
Vor zwei Tagen habe ich einen Benchmark veröffentlicht, der zeigt, dass die offenen Alternativen zu Jev gegen ein fest verdrahtetes „medium“ verlieren. Jev routete 84,5 % von 563 echten Prompts auf die richtige Modellstufe. Laya und Von, die offenen Modelle, schafften bestenfalls 61,6 %.
Dann wollten wir Jev kaufen und konnten nicht. TextCortex verkauft an europäische Unternehmen, und als wir im September 2026 nachgesehen haben, gab es kein EU-Deployment von Jev zu kaufen. Ein Router liest jeden Prompt, den ein Kunde eintippt, also muss er dort laufen, wohin die Daten des Kunden gehen dürfen.
Also habe ich das Modell genommen, das verloren hatte, und es per Fine-Tuning nachtrainiert. Das Ergebnis ist Raya, ein Router mit 300 Millionen Parametern, der auf demselben Benchmark 81 % erreicht. Er läuft jetzt in unserem Produktionscluster auf einer CPU in Falkenstein mit 30 ms medianer Latenz, auf einem Hetzner-Server, der 84 € im Monat kostet und ohnehin schon auf unserer Rechnung stand.
Der beste Router hatte keine EU-Region, also haben wir den Verlierer nachtrainiert.
Laya ist ein Entscheidungsmodell unter Apache-2.0: ein mmBERT-Encoder mit einem kleinen Head, der jede Option einer Multiple-Choice-Frage bewertet. Es spricht dieselbe API wie Jev. Ab Werk routete es schlechter als eine Konstante.
Zwei blinde Annotatoren, Claude Opus und Claude Sonnet, hatten WildChat-Prompts nach derselben schriftlichen Rubrik gelabelt. Raya trainiert auf ihren Labels als Soft Targets, 50/50 wo sie sich uneinig waren, dazu synthetische schwere Prompts in allen 14 Sprachen und etwas hauseigene Routing-Daten. Die 563 Test-Prompts stammen aus WildChat-Shards, die das Training nie berührt hat.
Das Training dauerte etwa sechs Minuten auf einer NVIDIA RTX A6000.
Sechs Minuten auf einer GPU brachten Laya 25 bis 34 Punkte.
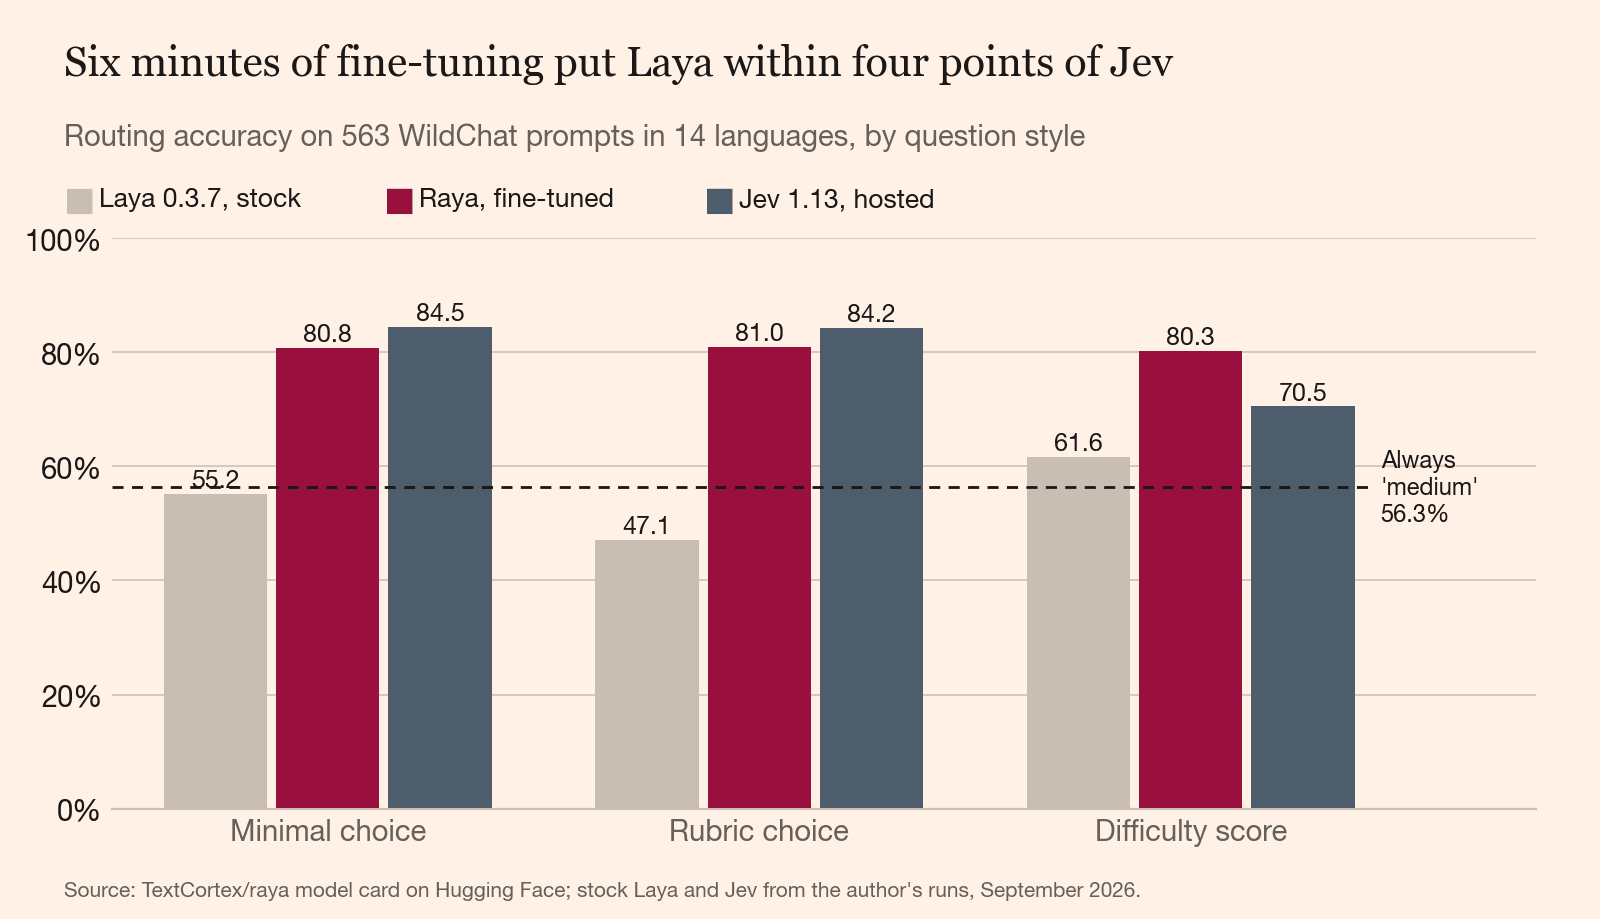
Raya erreicht bei allen drei Fragestilen 80 bis 81 %. Beim Schwierigkeitswert schlägt es Jev um zehn Punkte (80,3 % gegenüber 70,5 %, McNemar p < 0,001). Bei den beiden Multiple-Choice-Fragen liegt Jev noch drei bis vier Punkte vorn. Bei dieser Stichprobengröße ist der Abstand nicht signifikant (p = 0,07 und 0,13), aber er taucht bei beiden auf, und ich würde darauf wetten, dass er echt ist.
Jetzt das Zugeständnis, und es ist ein großes. Raya hat von denselben zwei Annotatoren gelernt, die die Gold-Labels geschrieben haben. Jev hat sie nie gesehen. Ein Teil von Rayas 81 % ist Heimvorteil, und ich kann dir nicht sagen, wie viel. Die Annotatoren stimmen untereinander nur in 78 % der Fälle überein, Raya ist also an der Decke dessen angekommen, was diese Labels messen können.
Raya ist außerdem genau dort am schwächsten, wo Jev am stärksten ist. Bei der minimalen Frage erreicht es auf Türkisch 67 % gegenüber Jevs 82 % und auf Portugiesisch 76 % gegenüber 90 %. Wie Jev schickt es nur 7 der 21 frontier-Prompts an frontier.
Ein Klassifikator mit 300M Parametern hat auf einer GPU nichts verloren.
Rayas Model Card nennt 17 ms auf einer GPU. Eine ganze GPU für einen kleinen Forward Pass pro Prompt ist eine Menge Hardware, also habe ich Raya nach ONNX Runtime exportiert und fünf Varianten auf zwei CPUs ausprobiert: einem Intel i9-13900, der VNNI-int8-Instruktionen hat, und einem AMD EPYC 7502P, der keine hat.
| Datei | Größe | Genauigkeit | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
|---|---|---|---|---|
| fp32 | 1,23 GB | 81,2 % | 38 / 297 ms | 60 / 487 ms |
| blockweises int8 | 0,89 GB | 81,5 % | 34 / 282 ms | 127 / 975 ms |
| int8 pro Tensor | 0,92 GB | 79,0 % | 24 / 200 ms | nicht brauchbar |
| PyTorch-Referenz | 81,0 % | 42 / 421 ms | 89 / 526 ms |
Die schnellste Datei verliert zweieinhalb Punkte Genauigkeit, und das heißt bei einem Router: echte Prompts landen beim falschen Modell. Auf dem EPYC lief int8 pro Tensor über, und die Genauigkeit fiel je nach Einstellung auf 54 % bis 80 %.
Blockweises int8 auf dem Chip mit VNNI hat jeden Punkt Genauigkeit gehalten. Diese Variante liefern wir aus. Sechzehn Threads waren auf beiden CPUs langsamer als acht, also bekommt jeder Pod acht.
Der Wechsel zu int8 auf einer VNNI-CPU hat p95 von 1.066 ms auf 228 ms gesenkt.
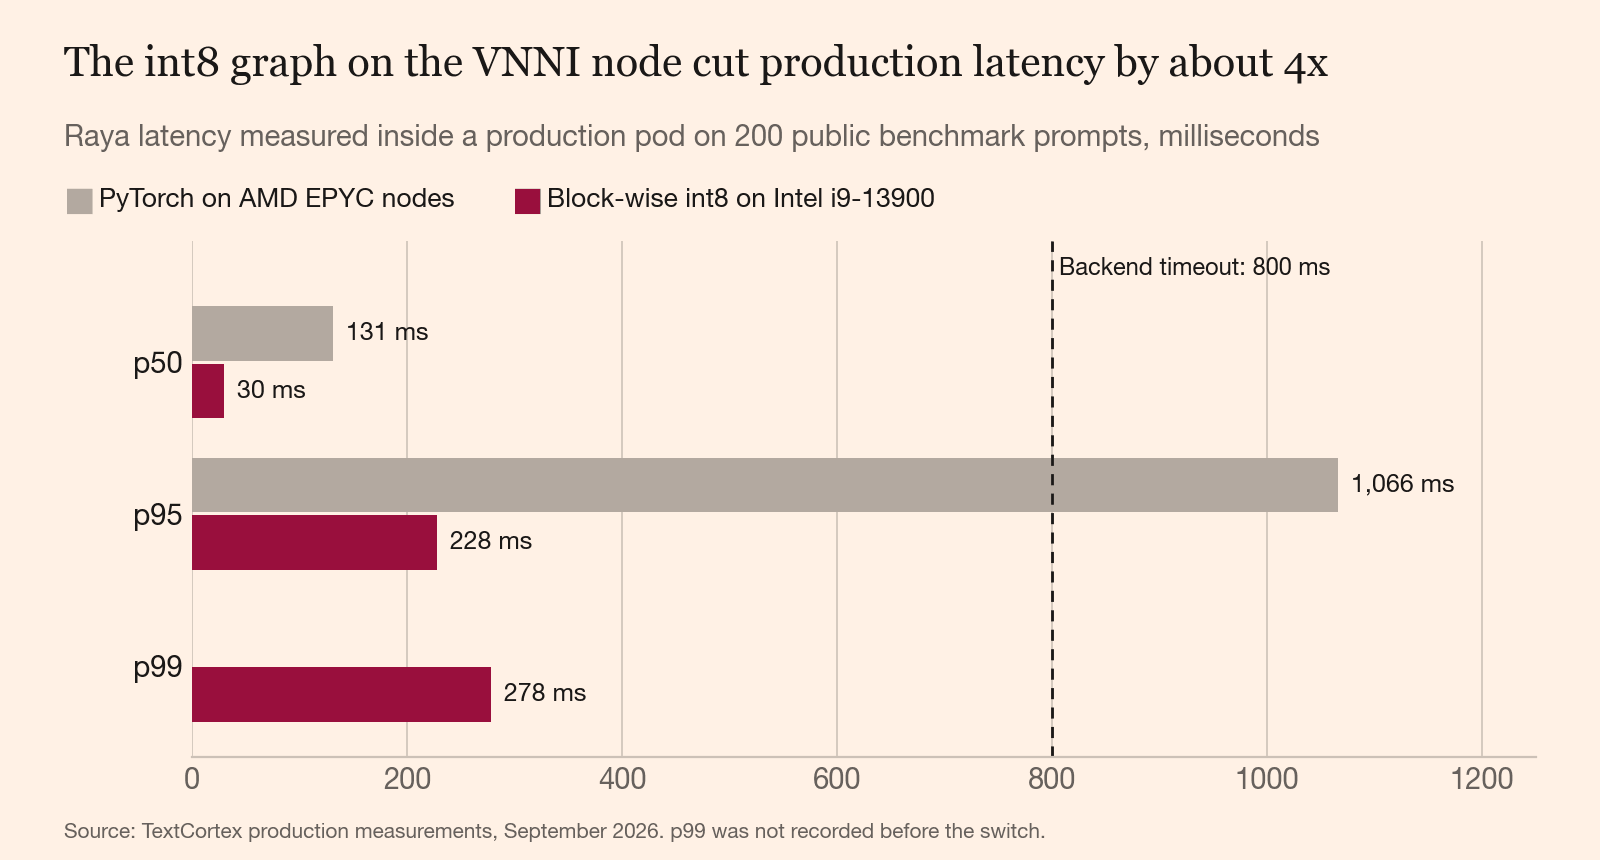
Das erste Produktions-Deployment lief mit PyTorch auf unseren EPYC-Nodes. Sein p95 lag bei 1.066 ms, über den 800 ms, die das Backend wartet, bevor es den Router aufgibt. Mehr als eine von zwanzig Anfragen wäre in den Timeout gelaufen.
Nach dem Wechsel, gemessen in einem Produktions-Pod: 30 ms p50, 228 ms p95, 278 ms p99. Jeder Pod schafft 16 bis 18 Anfragen pro Sekunde, vorher waren es etwa 4. Das Image schrumpfte von 4,0 GB auf 1,0 GB. Die Genauigkeit auf dem Benchmark liegt bei 81,5 %, gegenüber 81,0 % für das PyTorch-Original.
Int8-Arithmetik hängt von der CPU ab, also prüft sich das Image selbst. Der Build verifiziert den SHA-256 der Modelldatei. Jeder Pod verweigert den Start auf einer CPU ohne VNNI und vergleicht seine Antworten mit der PyTorch-Referenz, bevor er Traffic annimmt.
Der Server kostet 84 € im Monat und stand schon auf der Rechnung.
Unser Cluster läuft auf dem Managed Kubernetes von Cloudfleet, mit dedizierten Hetzner-Servern als Nodes. Rayas Node hat dieselbe Ausstattung wie Hetzners EX101: ein i9-13900, 64 GB ECC-Speicher, zwei NVMe-Laufwerke mit je 1,92 TB. Hetzner listet ihn für 84 € im Monat plus 39 € Einrichtungsgebühr, ohne Mehrwertsteuer (September 2026). Cloudfleet berechnet zusätzlich pro vCPU, je nach Tarif 2,45 € bis 7,25 € im Monat.
Wir haben für Raya nichts gekauft. Auf dem Node liefen andere Workloads, die 22 % seiner CPU reserviert hatten. Mit Rayas Pods sind es 86 %. Der Router hat uns ungenutzte Kapazität auf einer Maschine gekostet, für die wir ohnehin schon bezahlt haben.
Die Obergrenze, als Schätzung: Zwei Produktions-Pods schaffen etwa 32 Anfragen pro Sekunde, also rund 83 Millionen Routing-Entscheidungen in einem Monat mit 30 Tagen. Rechnet man Raya den ganzen Server an, sind das bei Volllast etwa 1 € pro Million Entscheidungen, ohne Mehrwertsteuer und Cloudfleets Gebühr. Beim echten Traffic zählen die festen 84 €.
Alles hängt an einem einzigen Server.
Nur ein Node in unserem Cluster hat VNNI, also sind beide Produktions-Pods an ihn gebunden. Fällt dieser Server aus, bleiben die Pods auf Pending, und Auto schickt jeden Prompt an medium. Das ist der konstante Router aus dem ersten Beitrag. Der Chat funktioniert weiter, bis der Node wieder da ist.
Der Node ist außerdem voll. Bei 86 % Reservierung ist kein Platz für einen dritten Pod, wer also über etwa 32 Anfragen pro Sekunde hinaus will, muss einen zweiten VNNI-Server mieten. Bei acht gleichzeitigen Anfragen pro Pod klettert p95 auf etwa 1,2 Sekunden, über das Timeout von 800 ms, und der Überlauf fällt auf medium zurück. Der heutige Auto-Traffic ist davon weit entfernt.
Und während ich das schreibe, erreicht keine einzige Kundenanfrage Raya. Der Smoke-Test routet alle drei Stufen in Staging und Produktion korrekt. Die Backend-Änderung, die Raya aufruft, ist noch im Review.
Ein offenes Modell, das du selbst nachtrainierst, schlägt eines, das du nur herunterlädst.
Laya im Originalzustand hat gegen eine Konstante verloren. Sechs Minuten Training auf unseren eigenen Labels haben den Großteil des Abstands zu einem gehosteten Modell geschlossen, und ein CPU-Server für 84 € hat die Latenzlücke geschlossen.
Jev ist bei den Auswahlfragen immer noch besser. Es hat auch kein EU-Deployment. Für ein europäisches Unternehmen schlägt ein Router, der drei Punkte schlechter ist und in Falkenstein läuft, einen besseren, der irgendwo läuft, wohin wir den Prompt nicht schicken dürfen.
Raya ist öffentlich unter Apache-2.0 verfügbar, mit den ONNX-Dateien, ihren Prüfsummen und den rohen Benchmark-Ergebnissen auf seiner Model Card. Lass es auf deinen eigenen Prompts gegen return "medium" laufen. Wenn es das auf deinem Traffic nicht um zehn Punkte schlägt, sag mir Bescheid, und ich veröffentliche das auch.