Tradotto automaticamente. Leggi l’originale in inglese: Our LLM router runs at 30 ms p50 on an €84/month Hetzner server, no GPU →
Due giorni fa ho pubblicato un benchmark che mostrava come le alternative open a Jev perdano contro un “medium” scritto nel codice. Jev ha mandato al tier di modello giusto l’84,5% di 563 prompt reali. Laya e Von, i modelli open, si sono fermati al 61,6% nel migliore dei casi.
Poi abbiamo provato a comprare Jev e non ci siamo riusciti. TextCortex vende ad aziende europee, e quando abbiamo controllato, a settembre 2026, non esisteva un deployment di Jev nell’UE da comprare. Un router legge ogni prompt che un cliente scrive, quindi deve girare dove i dati del cliente hanno il permesso di andare.
Così ho preso il modello che aveva perso e ne ho fatto il fine-tuning. Il risultato è Raya, un router da 300 milioni di parametri che ottiene l’81% sullo stesso benchmark. Ora gira nel nostro cluster di produzione su una CPU a Falkenstein, in Germania, con una latenza mediana di 30 ms, su un server Hetzner che costa 84 € al mese ed era già nella nostra bolletta.
Il router migliore non aveva una regione UE, quindi abbiamo fatto il fine-tuning di quello che aveva perso.
Laya è un modello decisionale Apache-2.0: un encoder mmBERT con una piccola testa che assegna un punteggio a ogni opzione di una domanda a scelta multipla. Parla la stessa API di Jev. Così com’era, instradava peggio di una costante.
Due annotatori alla cieca, Claude Opus e Claude Sonnet, avevano etichettato prompt di WildChat con la stessa rubrica scritta. Raya si addestra sulle loro etichette come target soft, 50/50 dove non erano d’accordo, più prompt difficili sintetici in tutte e 14 le lingue e un po’ di dati di routing interni. I 563 prompt di test vengono da shard di WildChat che l’addestramento non ha mai toccato.
L’addestramento ha richiesto circa sei minuti su una sola NVIDIA RTX A6000.
Sei minuti su una GPU hanno fatto guadagnare a Laya da 25 a 34 punti.
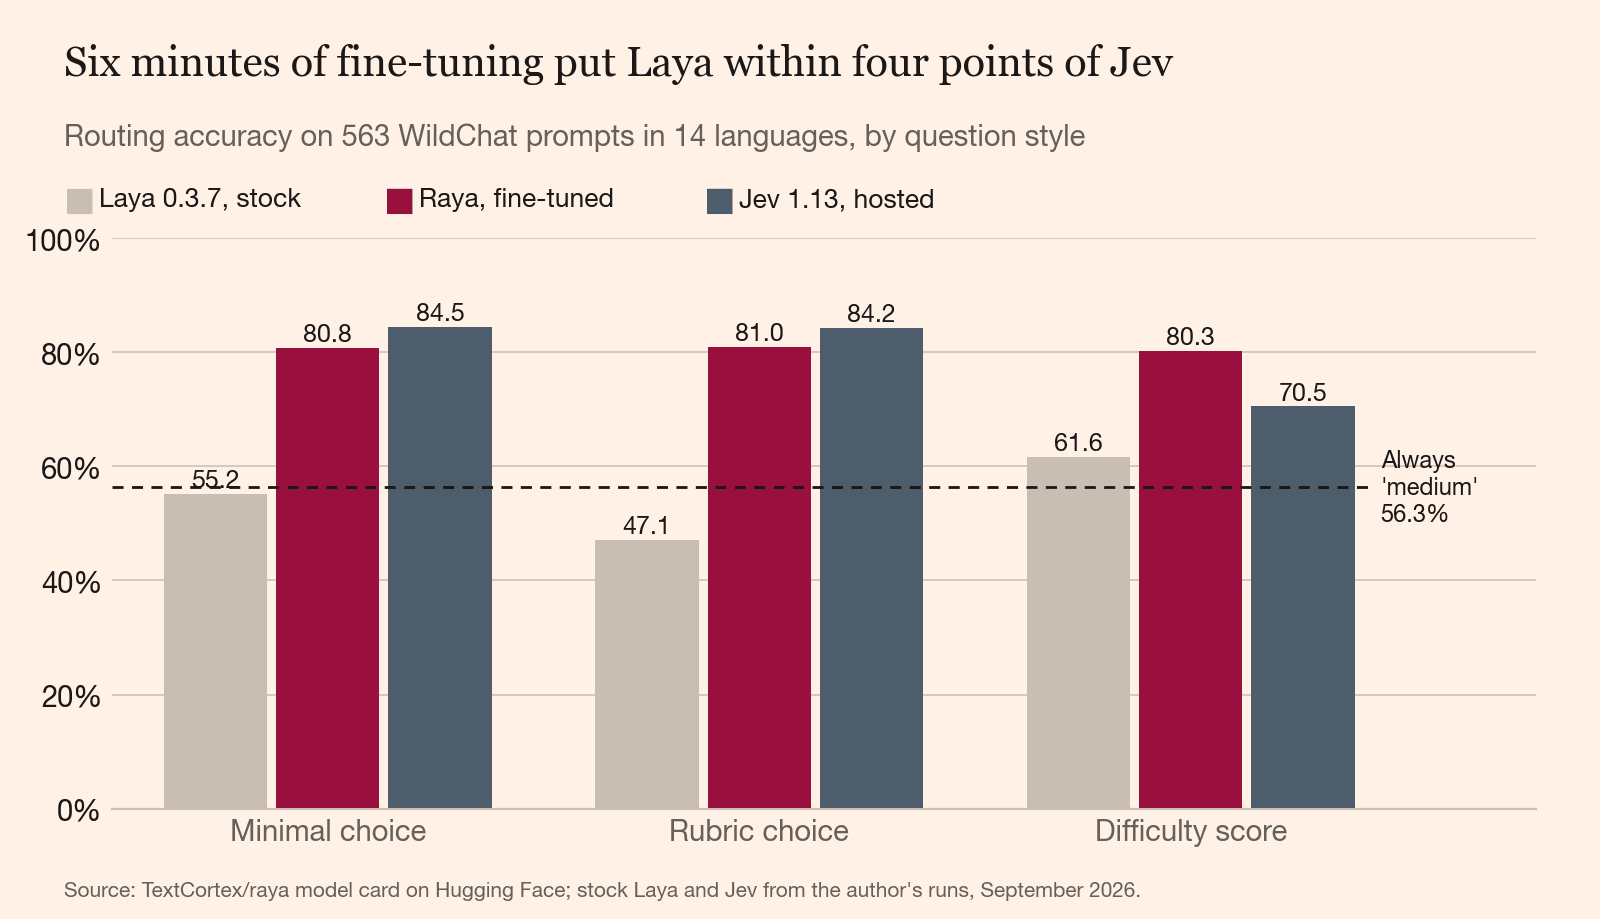
Raya fa tra l’80 e l’81% con tutti e tre gli stili di domanda. Sul punteggio di difficoltà batte Jev di dieci punti (80,3% contro 70,5%, McNemar p < 0,001). Sulle due domande a scelta multipla Jev è ancora avanti di tre o quattro punti. Con questo campione la differenza non è significativa (p = 0,07 e 0,13), ma compare su entrambe, e scommetterei che è reale.
Ora la concessione, ed è grossa. Raya ha imparato dagli stessi due annotatori che hanno scritto le etichette gold. Jev non le ha mai viste. Una parte dell’81% di Raya è fattore campo, e non so dirti quanto. Gli annotatori sono d’accordo tra loro solo nel 78% dei casi, quindi Raya ha toccato il tetto di ciò che queste etichette riescono a misurare.
Raya è anche più debole dove Jev è più forte. Sulla domanda minima fa il 67% in turco contro l’82% di Jev, e il 76% in portoghese contro il 90%. Come Jev, manda a frontier solo 7 dei 21 prompt frontier.
Un classificatore da 300M di parametri non ha niente da fare su una GPU.
La model card di Raya indica 17 ms su GPU. Un’intera GPU per un piccolo forward pass a prompt è parecchio hardware, quindi ho esportato Raya su ONNX Runtime e ho provato cinque varianti su due CPU: un Intel i9-13900, che ha le istruzioni int8 VNNI, e un AMD EPYC 7502P, che non le ha.
| File | Dimensione | Accuratezza | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
|---|---|---|---|---|
| fp32 | 1,23 GB | 81,2% | 38 / 297 ms | 60 / 487 ms |
| int8 a blocchi | 0,89 GB | 81,5% | 34 / 282 ms | 127 / 975 ms |
| int8 per tensore | 0,92 GB | 79,0% | 24 / 200 ms | inutilizzabile |
| riferimento PyTorch | 81,0% | 42 / 421 ms | 89 / 526 ms |
Il file più veloce perde due punti e mezzo di accuratezza, che in un router significa prompt reali mandati al modello sbagliato. Sull’EPYC, l’int8 per tensore è andato in overflow e l’accuratezza è scesa a valori tra il 54% e l’80% a seconda delle impostazioni.
L’int8 a blocchi sul chip con VNNI ha conservato ogni punto di accuratezza. È quello che mettiamo in produzione. Sedici thread erano più lenti di otto su entrambe le CPU, quindi ogni pod ne ha otto.
Passare a int8 su una CPU con VNNI ha tagliato il p95 da 1.066 ms a 228 ms.
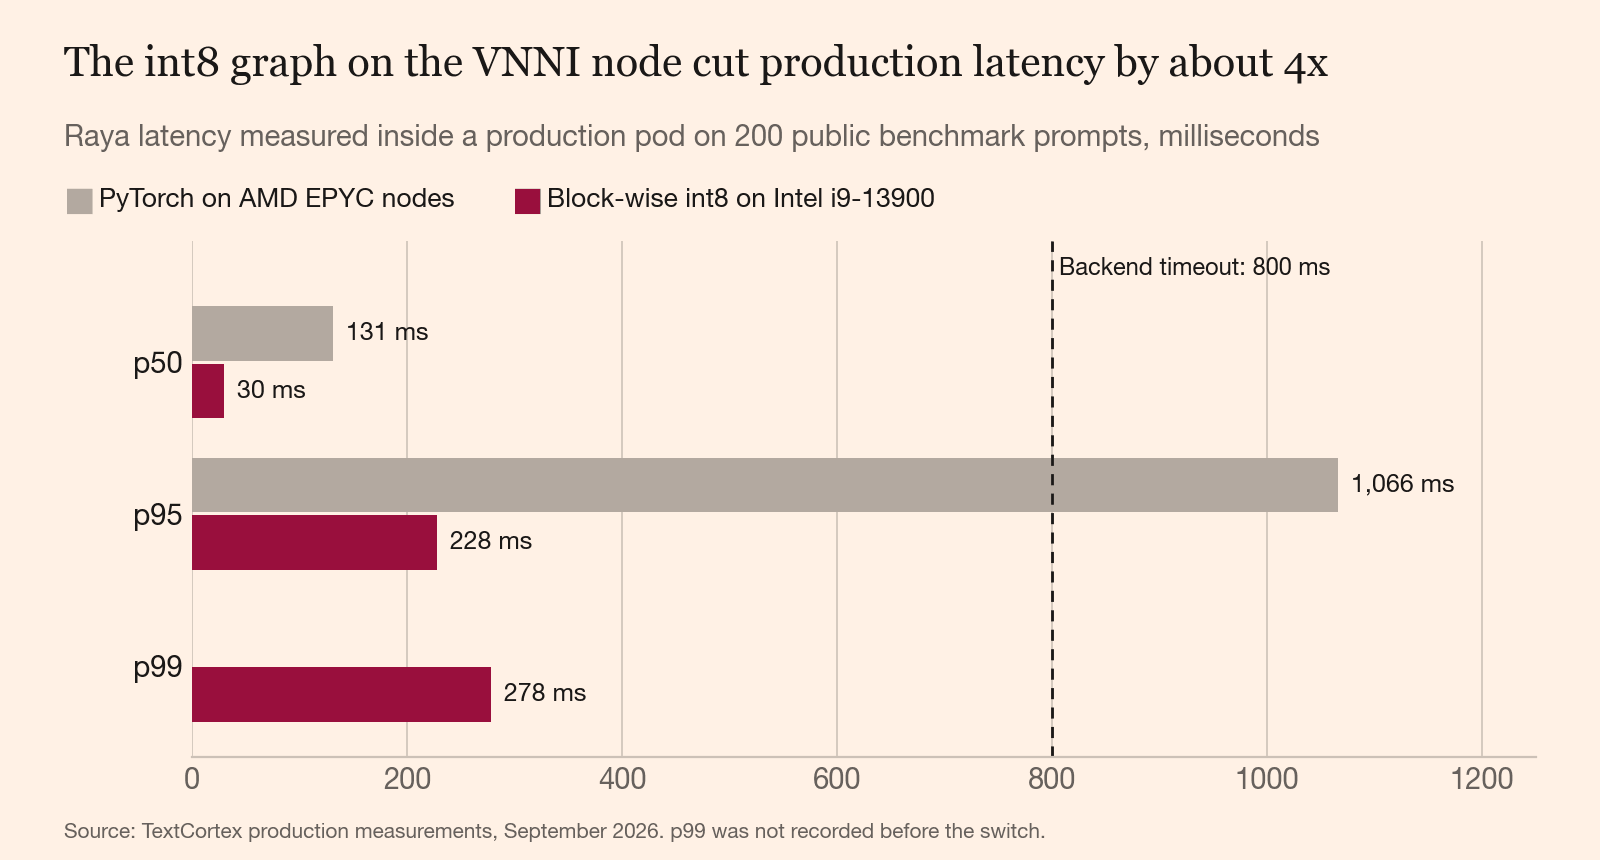
Il primo deployment in produzione girava con PyTorch sui nostri nodi EPYC. Il suo p95 era di 1.066 ms, sopra gli 800 ms che il backend aspetta prima di rinunciare al router. Più di una richiesta su venti sarebbe andata in timeout.
Dopo il passaggio, misurato dentro un pod di produzione: 30 ms p50, 228 ms p95, 278 ms p99. Ogni pod gestisce da 16 a 18 richieste al secondo, contro circa 4 prima. L’immagine è passata da 4,0 GB a 1,0 GB. L’accuratezza sul benchmark è dell’81,5%, contro l’81,0% dell’originale PyTorch.
I calcoli in int8 dipendono dalla CPU, quindi l’immagine si controlla da sola. La build verifica lo SHA-256 del file del modello. Ogni pod si rifiuta di partire su una CPU senza VNNI e confronta le sue risposte con il riferimento PyTorch prima di accettare traffico.
Il server costa 84 € al mese ed era già nella bolletta.
Il nostro cluster gira sul Kubernetes gestito di Cloudfleet, con server dedicati Hetzner come nodi. Il nodo di Raya ha le stesse specifiche dell’EX101 di Hetzner: un i9-13900, 64 GB di memoria ECC, due unità NVMe da 1,92 TB. Hetzner lo mette a listino a 84 € al mese più 39 € di attivazione, IVA esclusa (settembre 2026). Cloudfleet fa pagare per vCPU in aggiunta, da 2,45 € a 7,25 € al mese a seconda del piano.
Non abbiamo comprato niente per Raya. Il nodo faceva già girare altri workload, con il 22% della CPU riservato. Con i pod di Raya è all’86%. Il router ci è costato capacità inutilizzata su una macchina che stavamo già pagando.
Il tetto, come stima: due pod di produzione gestiscono circa 32 richieste al secondo, cioè circa 83 milioni di decisioni di routing in un mese di 30 giorni. Addebita a Raya l’intero server e fa circa 1 € per milione di decisioni a pieno carico, IVA e commissione di Cloudfleet escluse. Con il traffico reale, quello che conta sono gli 84 € fissi.
Tutto dipende da un solo server.
Solo un nodo del nostro cluster ha VNNI, quindi entrambi i pod di produzione sono vincolati a quel nodo. Se quel server muore, i pod restano in pending e Auto manda ogni prompt a medium. È il router costante del primo post. La chat continua a funzionare finché il nodo non torna.
Il nodo è anche pieno. All’86% di CPU riservata non c’è spazio per un terzo pod, quindi andare oltre circa 32 richieste al secondo significa affittare un secondo server con VNNI. Con otto richieste simultanee per pod, il p95 sale a circa 1,2 secondi, oltre il timeout di 800 ms, e l’eccedenza ripiega su medium. Oggi il traffico di Auto è lontanissimo da quel livello.
E mentre scrivo, nessuna richiesta dei clienti arriva a Raya. Lo smoke test instrada correttamente tutti e tre i tier in staging e in produzione. La modifica al backend che lo chiama è ancora in review.
Un modello open su cui fai fine-tuning batte un modello open che ti limiti a scaricare.
Laya così com’era perdeva contro una costante. Sei minuti di addestramento sulle nostre etichette hanno chiuso gran parte del divario con un modello ospitato, e un server CPU da 84 € ha chiuso quello di latenza.
Sulle domande a scelta Jev è ancora migliore. Però non ha un deployment nell’UE. Per un’azienda europea, un router peggiore di tre punti che gira a Falkenstein batte uno migliore che gira in un posto dove non possiamo mandare il prompt.
Raya è pubblico con licenza Apache-2.0, con i file ONNX, i loro checksum e i
risultati grezzi del benchmark sulla sua model card.
Fallo girare sui tuoi prompt contro return "medium". Se non riesce a batterlo
di dieci punti sul tuo traffico, dimmelo, e pubblicherò anche quello.