Tradotto automaticamente. Leggi l’originale in inglese: Open source Jev alternatives sucks, here is the benchmark →
Ogni prodotto di chat con un menu a tendina dei modelli scarica sui suoi utenti un lavoro di routing. Devono indovinare se la loro domanda merita il modello costoso o quello economico, e quasi tutti scelgono una volta e non ci pensano più. Così pagano troppo per “cos’è una cotta?” e troppo poco per una dimostrazione sui campioni di Bernoulli.
Stiamo costruendo la selezione automatica del modello in TextCortex perché nessuno debba più indovinare. Un router legge il prompt e sceglie il tier più economico che risponderà comunque bene. Il modo ovvio per costruirne uno è un piccolo modello open sul tuo hardware: nessun costo per chiamata, circa 60 millisecondi a chiamata, e il prompt non esce mai dall’edificio. Davo per scontato che saremmo finiti lì.
Quindi l’ho misurato. Su 563 prompt reali di chatbot in 14 lingue, il modello ospitato Jev ha mandato al tier giusto l’84,5% dei prompt. Laya e Von, modelli open sul mio portatile, si sono fermati al 61,6% e al 58,8%. Un router che risponde “medium” a ogni prompt fa il 56,3%. Chiamiamolo router costante. Quattro delle sei esecuzioni di Laya e Von hanno perso contro di lui.
Un router è una domanda a scelta multipla posta prima di ogni prompt.
Tutti e tre i sistemi parlano la stessa API. Invii il prompt, più una domanda con opzioni nominate e una frase che descrive ciascuna. Ricevi indietro una probabilità per ogni opzione.
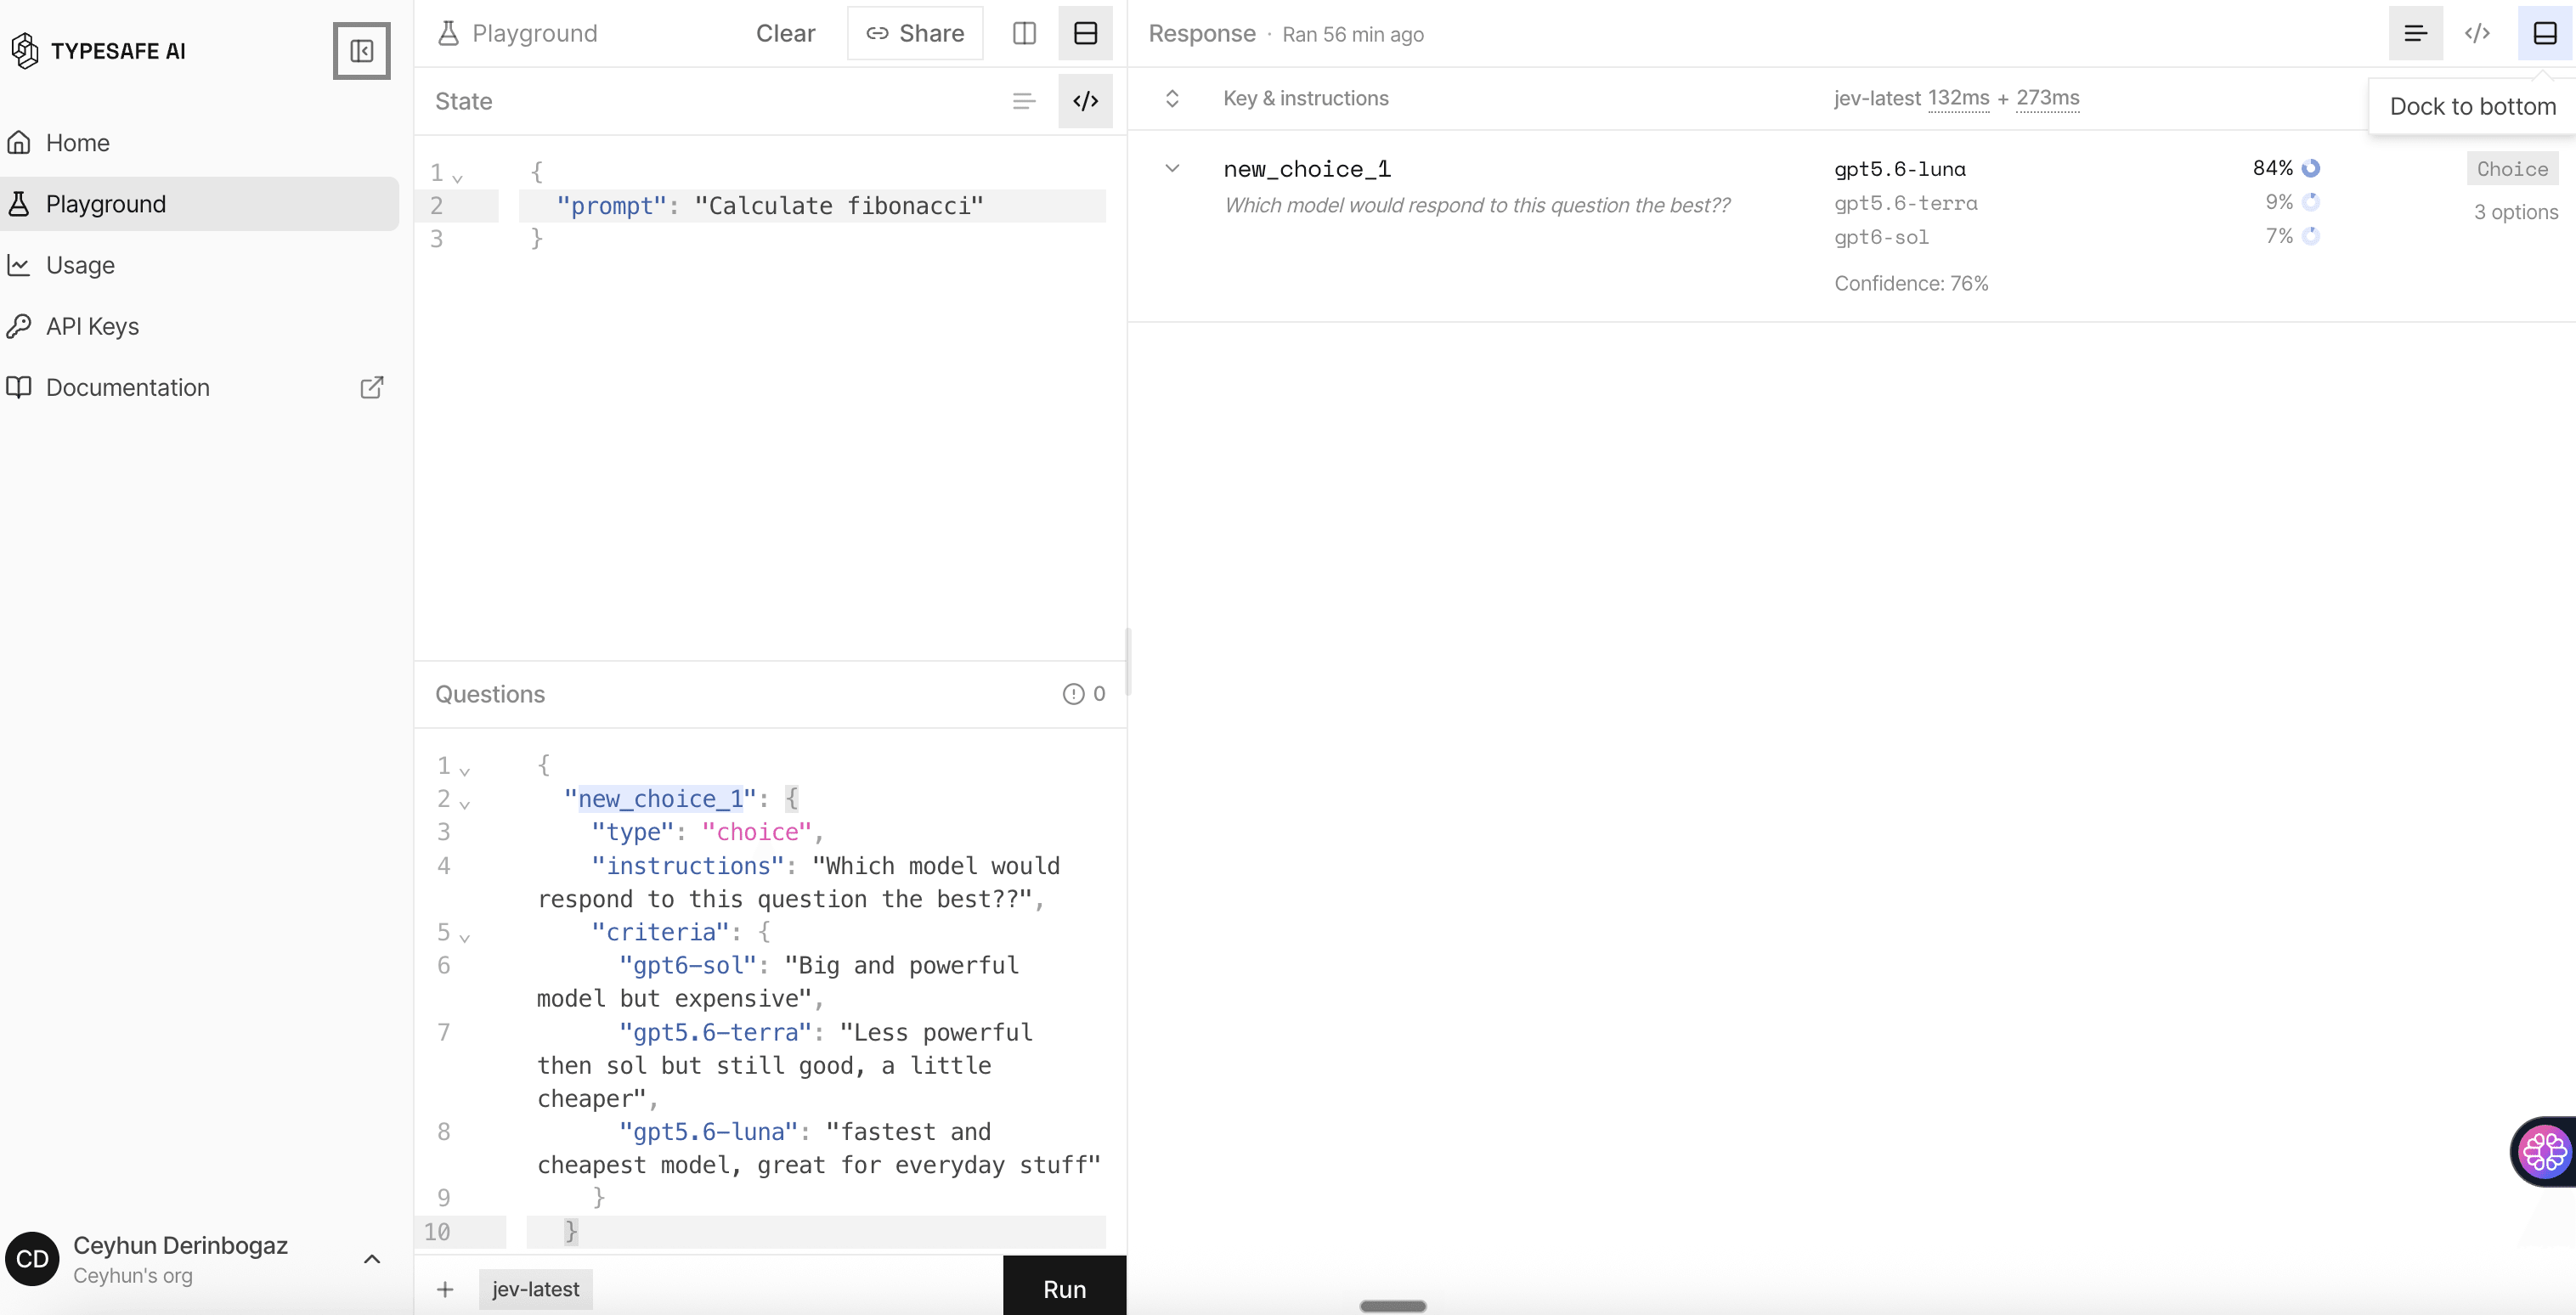
“Calculate fibonacci” va al tier economico. Ovvio. All’inizio ho testato tutti e tre i router su prompt di quel tipo, e anche quel round l’ha vinto Jev, ma i prompt che scrivo io per un router sono prompt di cui conosco già la risposta. Non dimostrava quasi nulla.
Ho usato prompt reali, perché i miei erano troppo facili.
I prompt vengono da WildChat-1M, un dataset pubblico di conversazioni reali con chatbot (licenza ODC-BY, quelle tossiche filtrate). Ho preso 40 primi messaggi per ciascuna lingua tra inglese, tedesco, francese, spagnolo, italiano, portoghese, olandese, polacco, turco, russo, arabo, cinese, giapponese e coreano, poi ho aggiunto 168 prompt più lunghi o più tecnici, perché il traffico reale non ne contiene quasi di difficili.
Due annotatori alla cieca su modelli diversi, Claude Opus e Claude Sonnet, hanno etichettato tutti i 728 prompt come small, medium o frontier. Erano d’accordo sul 77,5% (κ di Cohen = 0,60). Ho tenuto i 563 su cui concordavano: 225 small, 317 medium, 21 frontier.
Ogni sistema ha risposto a tre domande per prompt, 5.067 chiamate senza un solo errore bloccante:
- Q1, descritta. “Scegli il tier più economico che risponderà comunque bene”, con esempi di attività per ogni tier.
- Q2, minima. Richieste “semplici”, “moderatamente complesse” e “molto difficili”.
- Q3, punteggio. Un punteggio di difficoltà a tre livelli, mappato sui tier.
Due dei tre router battono a stento una costante.
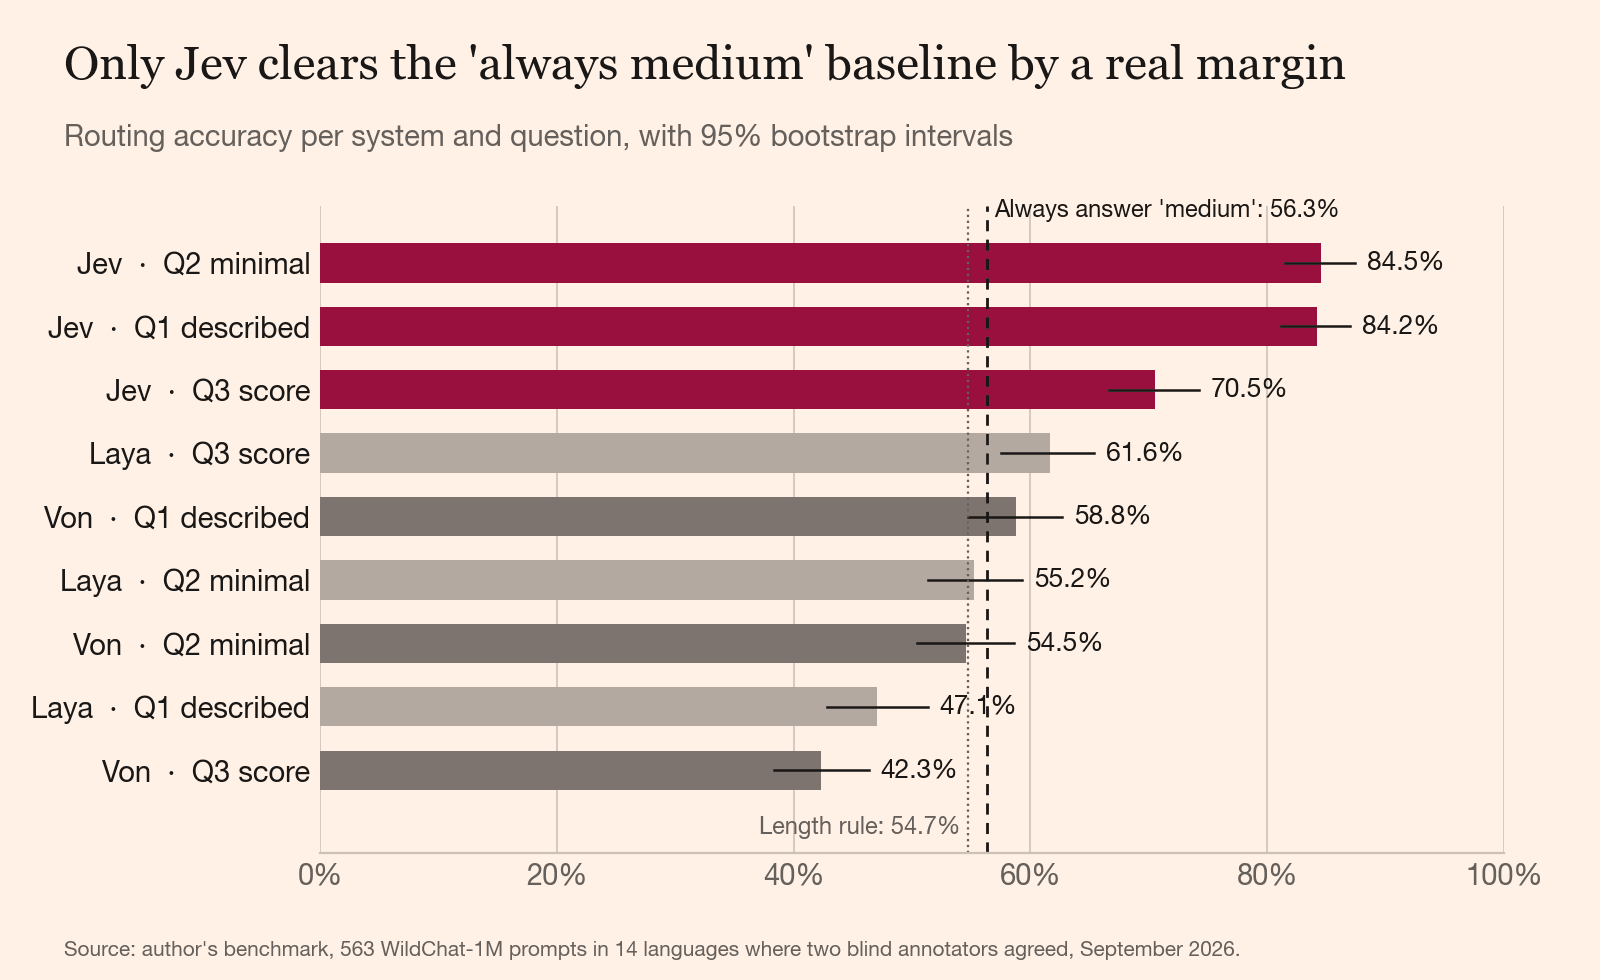
Jev ha fatto l’84,5% con descrizioni di due o tre parole e l’84,2% con la rubrica completa. Quella differenza è rumore, quindi nessuno nel mio team deve diventare prompt engineer per scrivere una domanda di routing.
La migliore esecuzione di Laya ha battuto il router costante di 5,3 punti. Quella di Von di 2,5, con un intervallo al 95% (dal 55% al 63%) che contiene ancora la costante. Una regola che guarda solo la lunghezza del prompt ha fatto il 54,7%, sopra due esecuzioni locali e a meno di un punto da altre due.
Un router che perde contro return "medium" è un generatore di numeri casuali
con un modello da scaricare in allegato.
I modelli locali tirano a indovinare “medium” e la chiamano decisione.
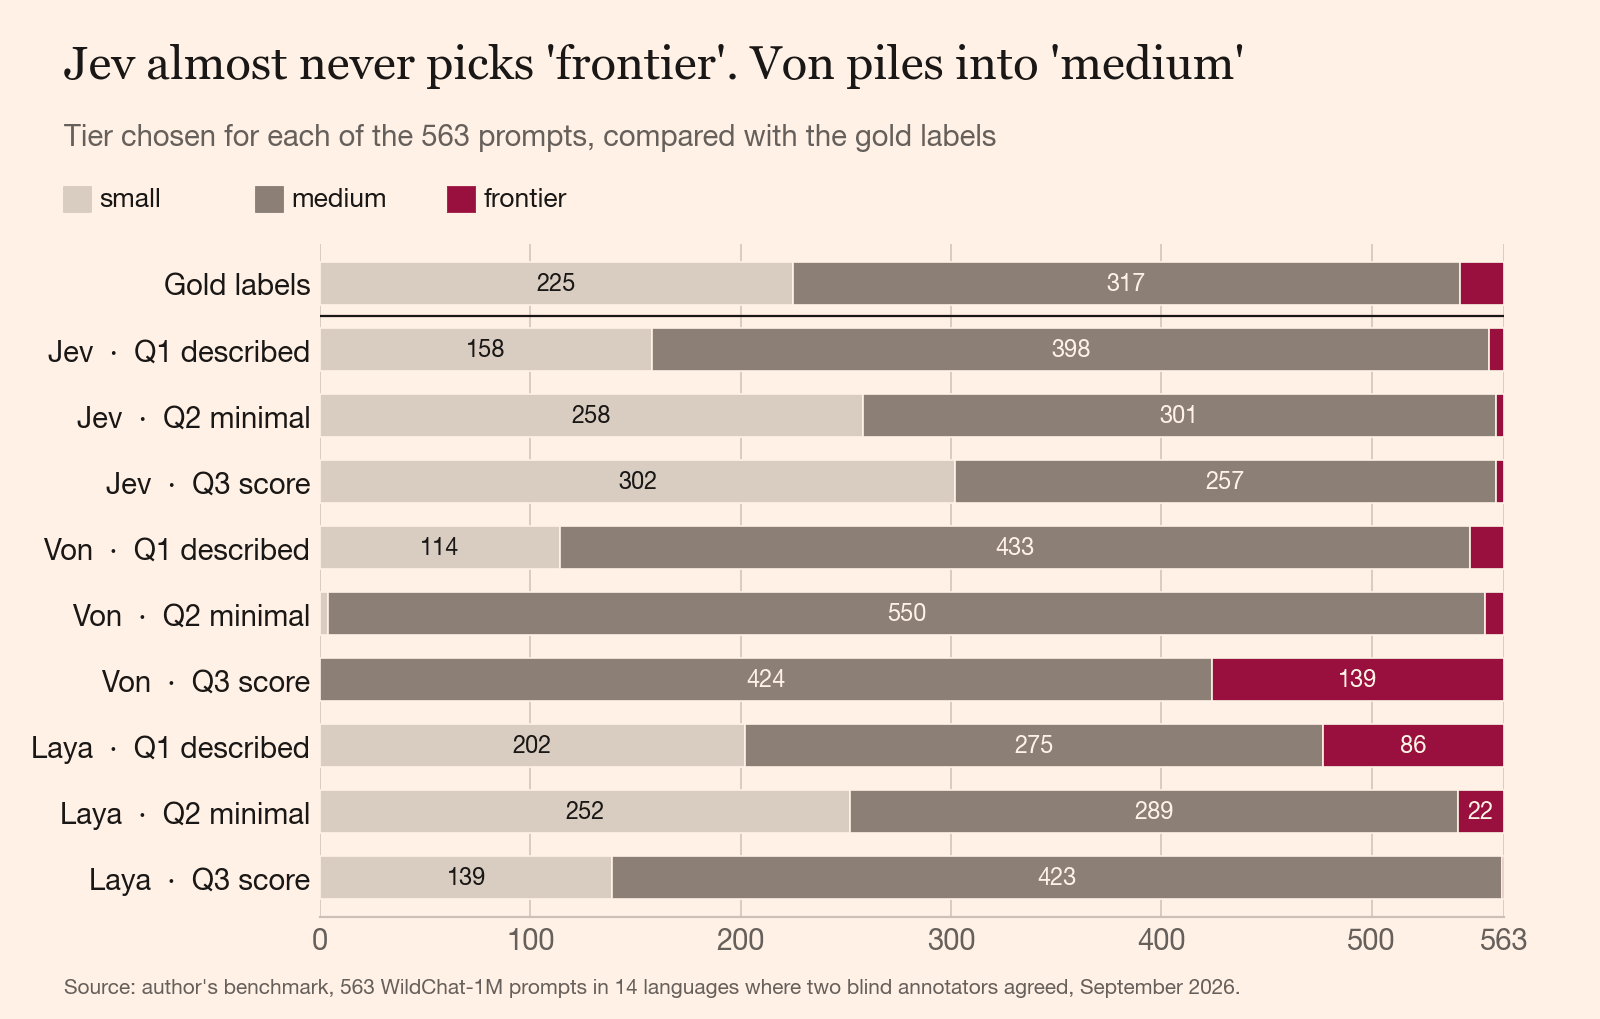
Von su Q2 ha risposto “medium” 550 volte su 563. Su Q3 non ha detto small nemmeno una volta, e ha mandato 139 prompt a frontier quando quelli da frontier sono 21. Laya su Q1 ha mandato 86 prompt a frontier e ne ha azzeccati sei. Il suo checkpoint multilingue ha gestito 1.329 delle sue 1.689 chiamate, e sul francese ha fatto comunque il 29%.
Von e Laya mandano fino al 55% dei prompt a un tier troppo caro.
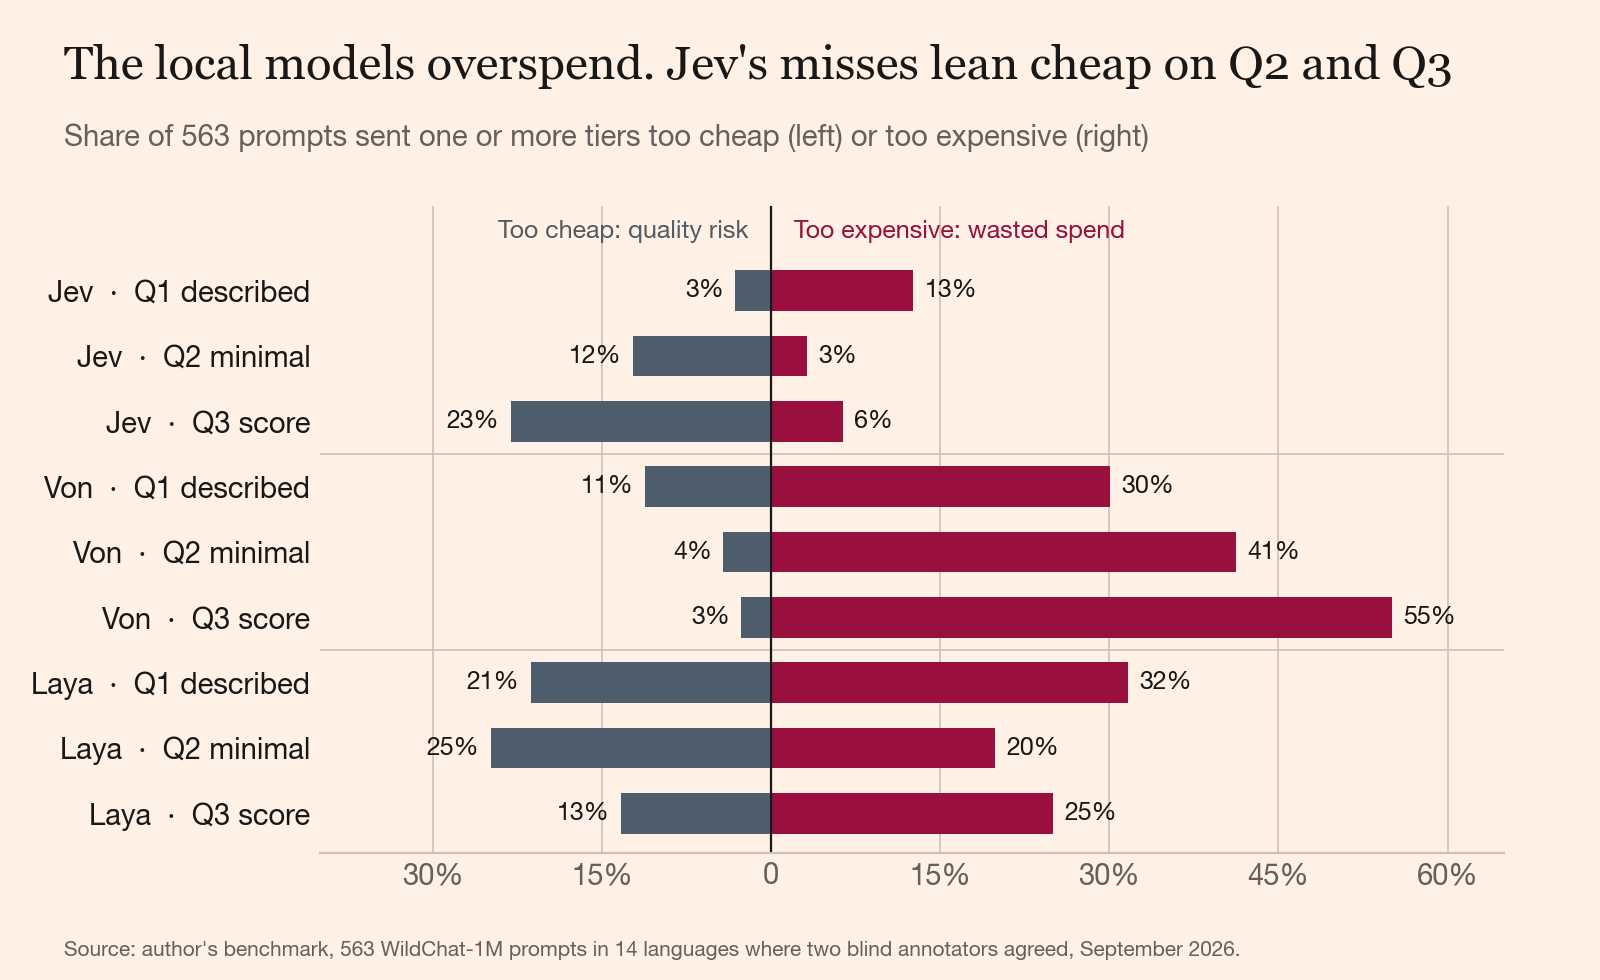
Von su Q3 manda il 55% di tutti i prompt a un tier più caro di quello che serve. Quel router gonfia la bolletta che esiste per tagliare.
Jev pende dall’altra parte su Q2 e Q3, ed è peggio per ogni singolo errore. Una risposta pagata troppo costa la differenza di prezzo. Una sottodimensionata costa un utente che ha fatto una domanda difficile e ha ricevuto una risposta sbagliata data con sicurezza. Su Q2, 51 errori di Jev erano prompt medium mandati a small. Su Q3, 113.
La lingua ha spostato appena Jev e ha spostato di molto tutti gli altri.
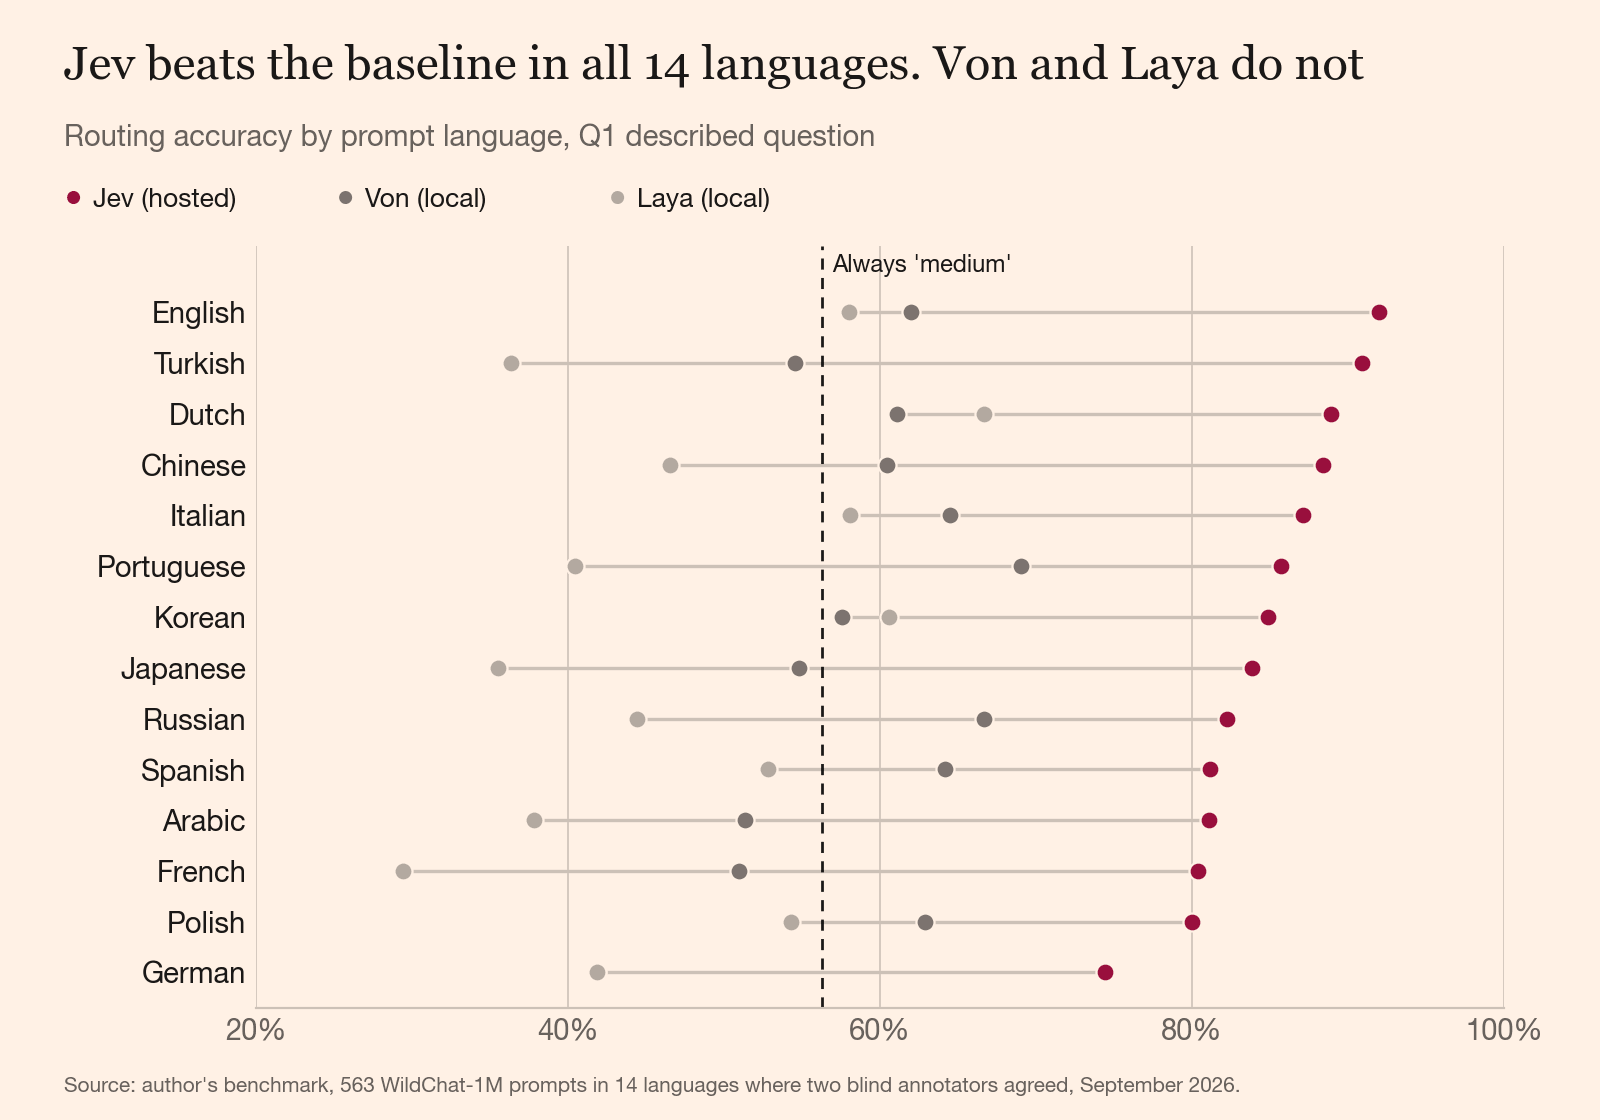
Jev è rimasto tra il 74% (tedesco) e il 92% (inglese), e ha fatto l’84% sia sugli alfabeti latini sia su quelli non latini. Von è andato dal 42% in tedesco al 69% in portoghese, Laya dal 29% in francese al 67% in olandese. Un router che azzecca il francese meno di una volta su tre non può avvicinarsi ai clienti francesi.
Jev sbaglia proprio i prompt che contano di più.
Dei 21 prompt frontier, Jev su Q1 ne ha mandati sei a frontier e 15 a medium. Su Q2 ne ha mandati tre. È lì che un routing al risparmio fa più danni: un problema di statistica in turco, regole di decisione per gli investimenti in tedesco, una scaletta sulla distribuzione quantistica delle chiavi. Ventuno è un campione piccolo, e lo dico io per primo.
Le probabilità di Jev aiutano. Scala a frontier ogni volta che Jev gli assegna più di 0,2, e Q1 ne intercetta 14 su 21 scalando solo 18 prompt su 563. Q2 con la stessa soglia ne intercetta sette. Ho scelto 0,2 dopo aver visto questi dati, quindi prendilo come un punto di partenza da tarare.
Altre tre cose vanno contro il titolo:
- L’84% lusinga Jev. Il set gold è fatto dei prompt su cui entrambi gli annotatori erano d’accordo, cioè i più facili. Sull’intero set gli annotatori concordavano solo nel 77,5% dei casi, quindi circa l’80% è un tetto realistico per qualsiasi router con questi tier.
- Sono etichette di giudizio. Due modelli hanno stimato di quale tier ha bisogno un prompt. Nessuno ha controllato cosa producesse davvero ogni tier.
- Jev è più lento. La latenza mediana era di circa 330 ms per chiamata dal mio portatile, per lo più rete, contro i 56-170 ms dei modelli locali.
Il router economico è quello costoso.
Alla fine non abbiamo potuto adottare Jev: non ha un deployment nell’UE. Così ho fatto il fine-tuning di Laya sulle nostre etichette, e quel router ora gira su un solo server CPU in Germania.
Un router locale non costa nulla a chiamata. Se manda il 41% del tuo traffico a un tier che non gli serve, come ha fatto Von su Q2, lo paghi su ognuna di quelle chiamate, e quel costo non compare su nessuna model card che io abbia letto.
Quindi conta. Prendi WildChat o i tuoi log, etichetta qualche centinaio di
prompt con due annotatori, scarta quelli su cui non sono d’accordo e confronta
il tuo router con return "medium". Se non supera quella soglia di dieci punti,
non hai un router.
Il test migliore, che faremo come prossimo passo, si basa sui risultati: fai passare traffico reale attraverso ogni tier, registra il tier più economico la cui risposta era abbastanza buona e valuta il router rispetto a quello. Se l’84% di Jev crolla lì, pubblicherò anche quello.