Traducción automática. Leer el original en inglés: Open source Jev alternatives sucks, here is the benchmark →
Todo producto de chat con un desplegable de modelos les encarga a sus usuarios un trabajo de enrutado. Tienen que adivinar si su pregunta merece el modelo caro o el barato, y la mayoría elige una vez y no vuelve a tocarlo. Así que pagan de más por “¿qué es el amor de cachorro?” y de menos por una demostración sobre muestras de Bernoulli.
En TextCortex estamos construyendo la selección automática de modelo para que nadie tenga que adivinar. Un router lee el prompt y elige el nivel más barato que aún lo responda bien. La forma obvia de construirlo es un modelo abierto pequeño en tu propio hardware: sin tarifa por llamada, unos 60 milisegundos por llamada, y el prompt nunca sale del edificio. Di por hecho que acabaríamos ahí.
Así que lo medí. Con 563 prompts reales de chatbot en 14 idiomas, el modelo alojado Jev envió el 84,5% al nivel correcto. Laya y Von, modelos abiertos en mi portátil, llegaron como mucho al 61,6% y al 58,8%. Un router que responde “medium” a todos los prompts saca un 56,3%. Llamémoslo el router constante. Cuatro de las seis ejecuciones de Laya y Von perdieron contra él.
Un router es una pregunta tipo test que se hace antes de cada prompt.
Los tres sistemas hablan la misma API. Envías el prompt, más una pregunta con opciones con nombre y una frase que describe cada una. Recibes una probabilidad por opción.
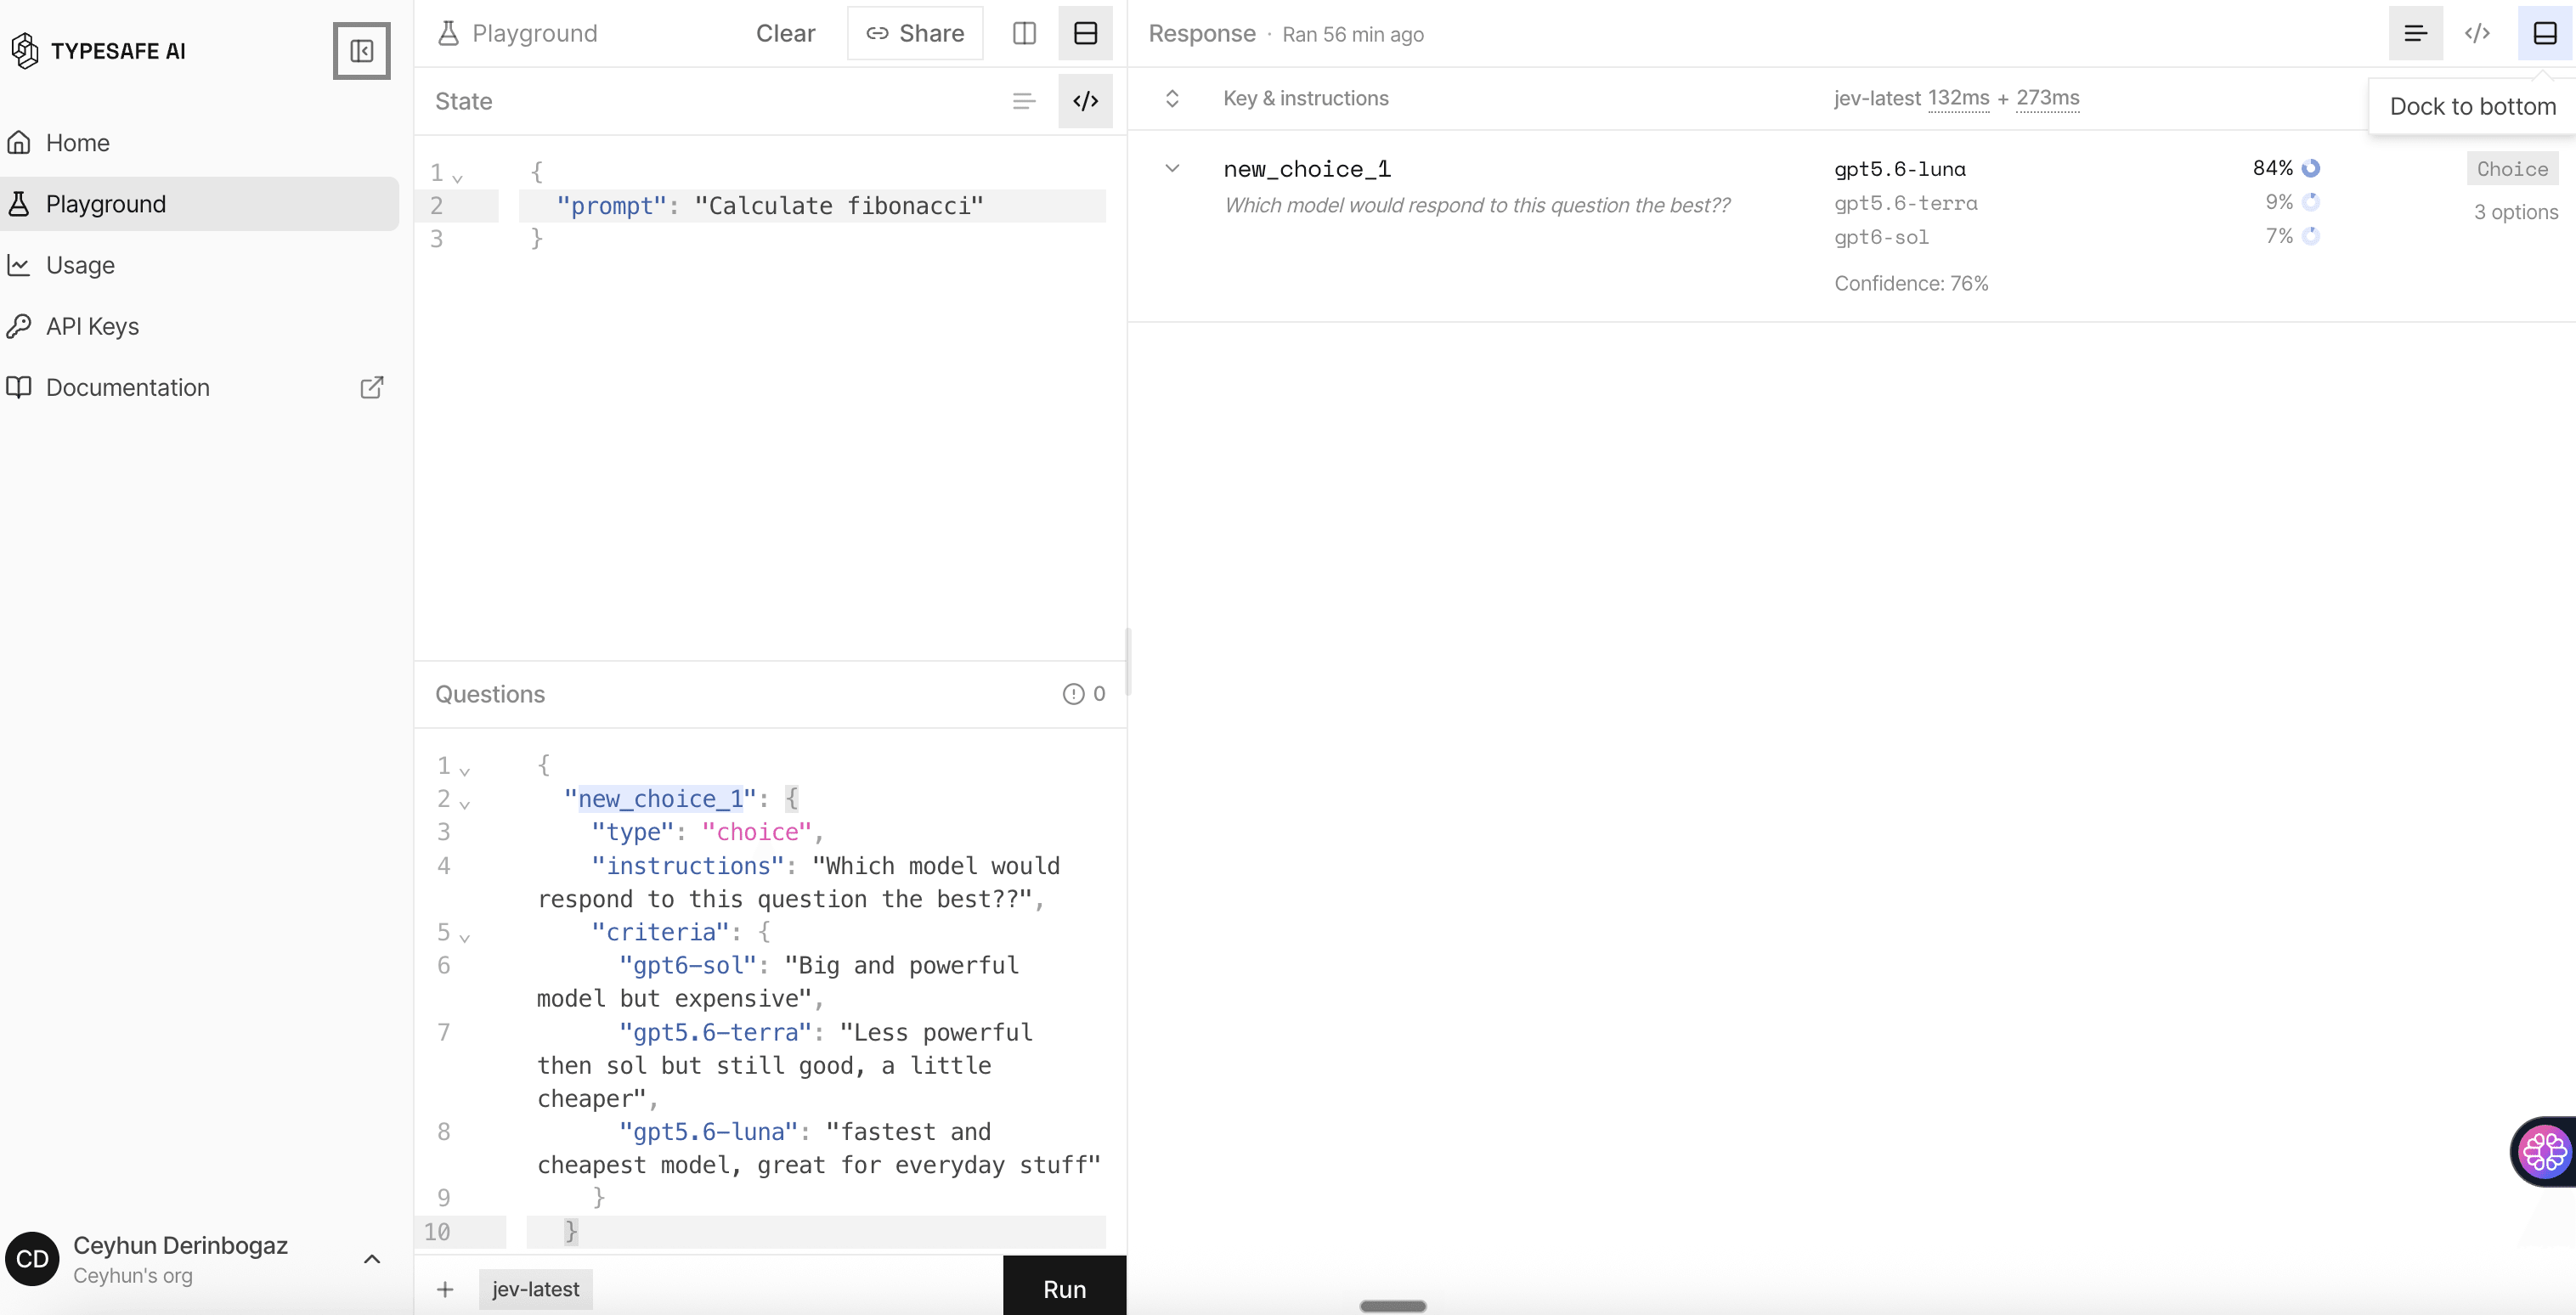
“Calculate fibonacci” va al nivel barato. Evidentemente. Primero probé los tres routers con prompts así, y Jev también ganó esa ronda, pero los prompts que yo escribo para un router son prompts cuya respuesta ya conozco. No demostraba casi nada.
Usé prompts reales, porque los míos eran demasiado fáciles.
Los prompts vienen de WildChat-1M, un dataset público de conversaciones reales con chatbots (licencia ODC-BY, con las tóxicas filtradas). Tomé 40 mensajes iniciales en cada uno de estos idiomas: inglés, alemán, francés, español, italiano, portugués, neerlandés, polaco, turco, ruso, árabe, chino, japonés y coreano. Después añadí 168 prompts más largos o más técnicos, porque el tráfico real casi no contiene prompts difíciles.
Dos anotadores ciegos con modelos distintos, Claude Opus y Claude Sonnet, etiquetaron los 728 prompts como small, medium o frontier. Coincidieron en el 77,5% (κ de Cohen = 0,60). Me quedé con los 563 en los que coincidieron: 225 small, 317 medium, 21 frontier.
Cada sistema respondió tres preguntas por prompt, 5.067 llamadas sin ningún fallo grave:
- Q1, descrita. “Elige el nivel más barato que aún lo responda bien”, con tareas de ejemplo para cada nivel.
- Q2, mínima. “Peticiones simples”, “moderadamente complejas” y “muy difíciles”.
- Q3, puntuación. Una puntuación de dificultad de tres niveles, mapeada a los niveles.
Dos de los tres routers apenas superan a una constante.
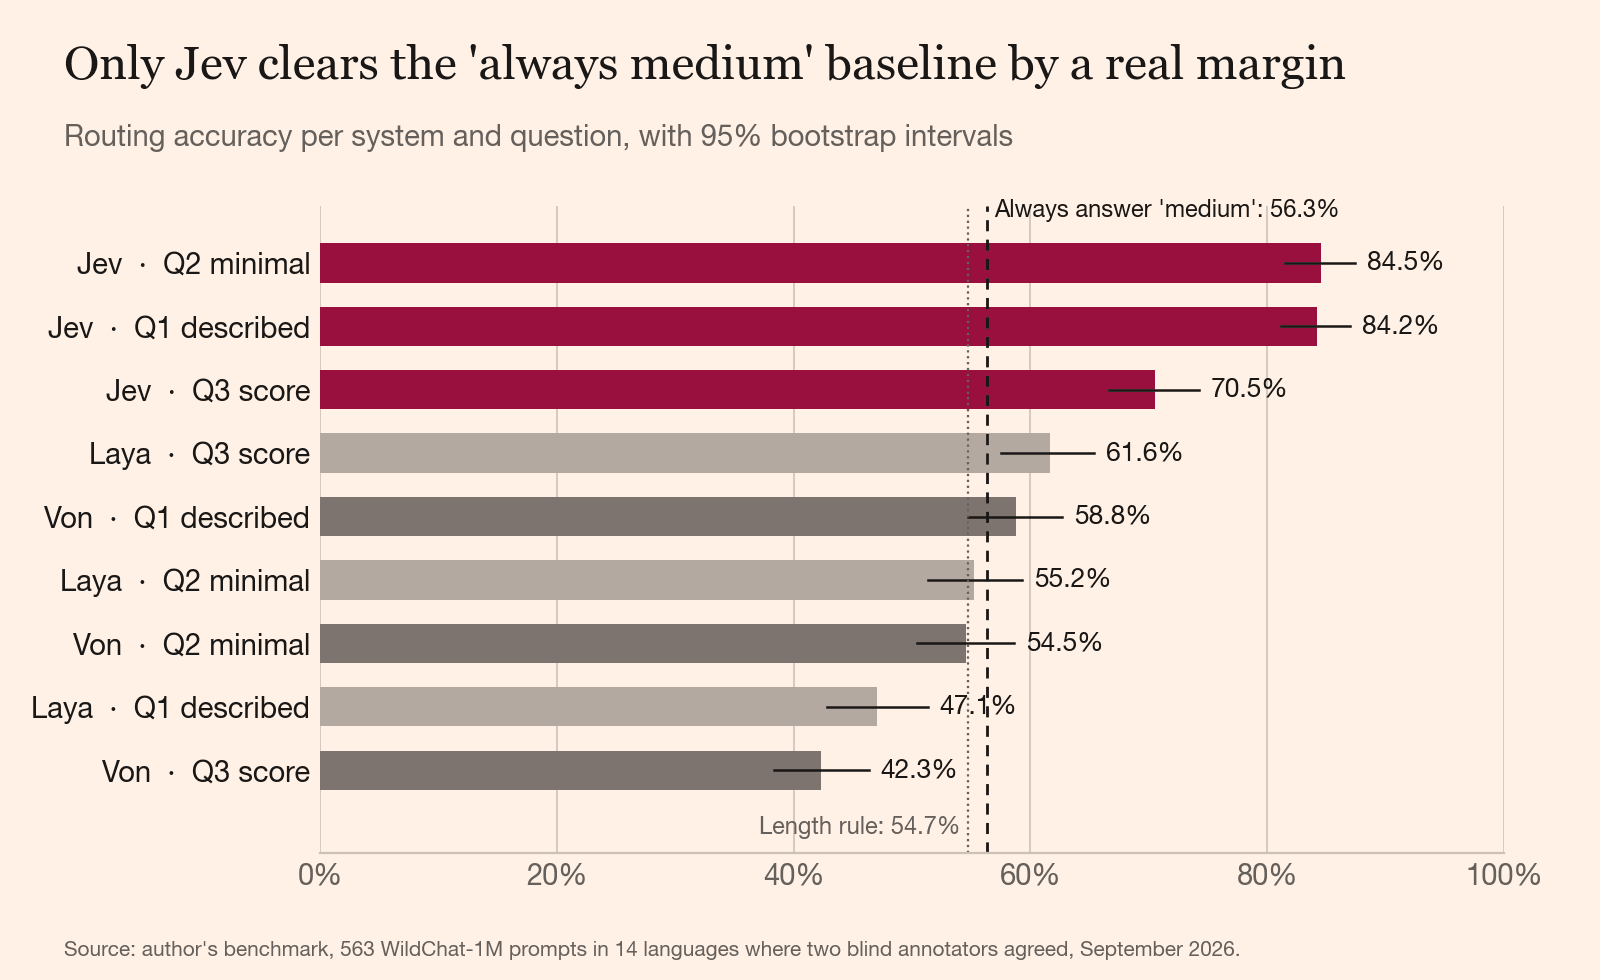
Jev sacó un 84,5% con descripciones de dos y tres palabras y un 84,2% con la rúbrica completa. Esa diferencia es ruido, así que nadie de mi equipo tiene que convertirse en prompt engineer para escribir una pregunta de enrutado.
La mejor ejecución de Laya superó al router constante por 5,3 puntos. La de Von, por 2,5, con un intervalo del 95% (del 55% al 63%) que todavía contiene a la constante. Una regla que solo mira la longitud del prompt sacó un 54,7%, por encima de dos ejecuciones locales y a menos de un punto de otras dos.
Un router que pierde contra return "medium" es un generador de números aleatorios con una descarga de modelo incluida.
Los modelos locales adivinan “medium” y lo llaman decisión.
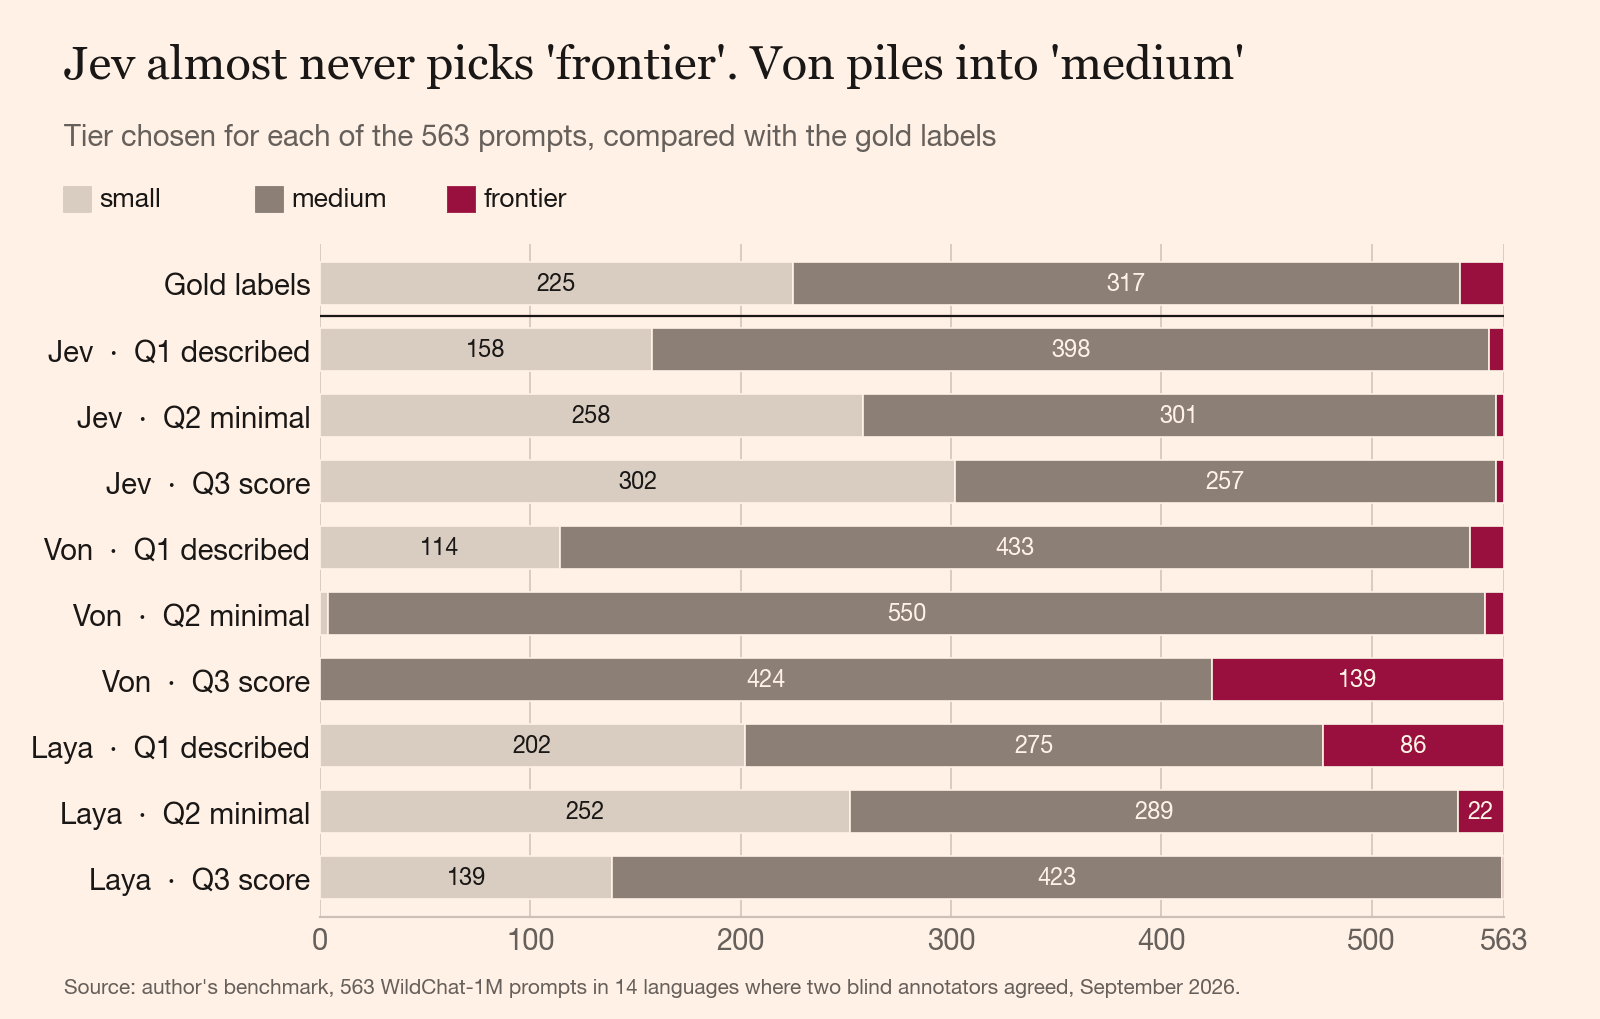
Von en Q2 respondió “medium” 550 veces de 563. En Q3 no dijo small ni una sola vez, y envió 139 prompts a frontier cuando ahí corresponden 21. Laya en Q1 envió 86 prompts a frontier y acertó en seis. Su checkpoint multilingüe atendió 1.329 de sus 1.689 llamadas, y aun así sacó un 29% en francés.
Von y Laya gastan de más en hasta el 55% de los prompts.
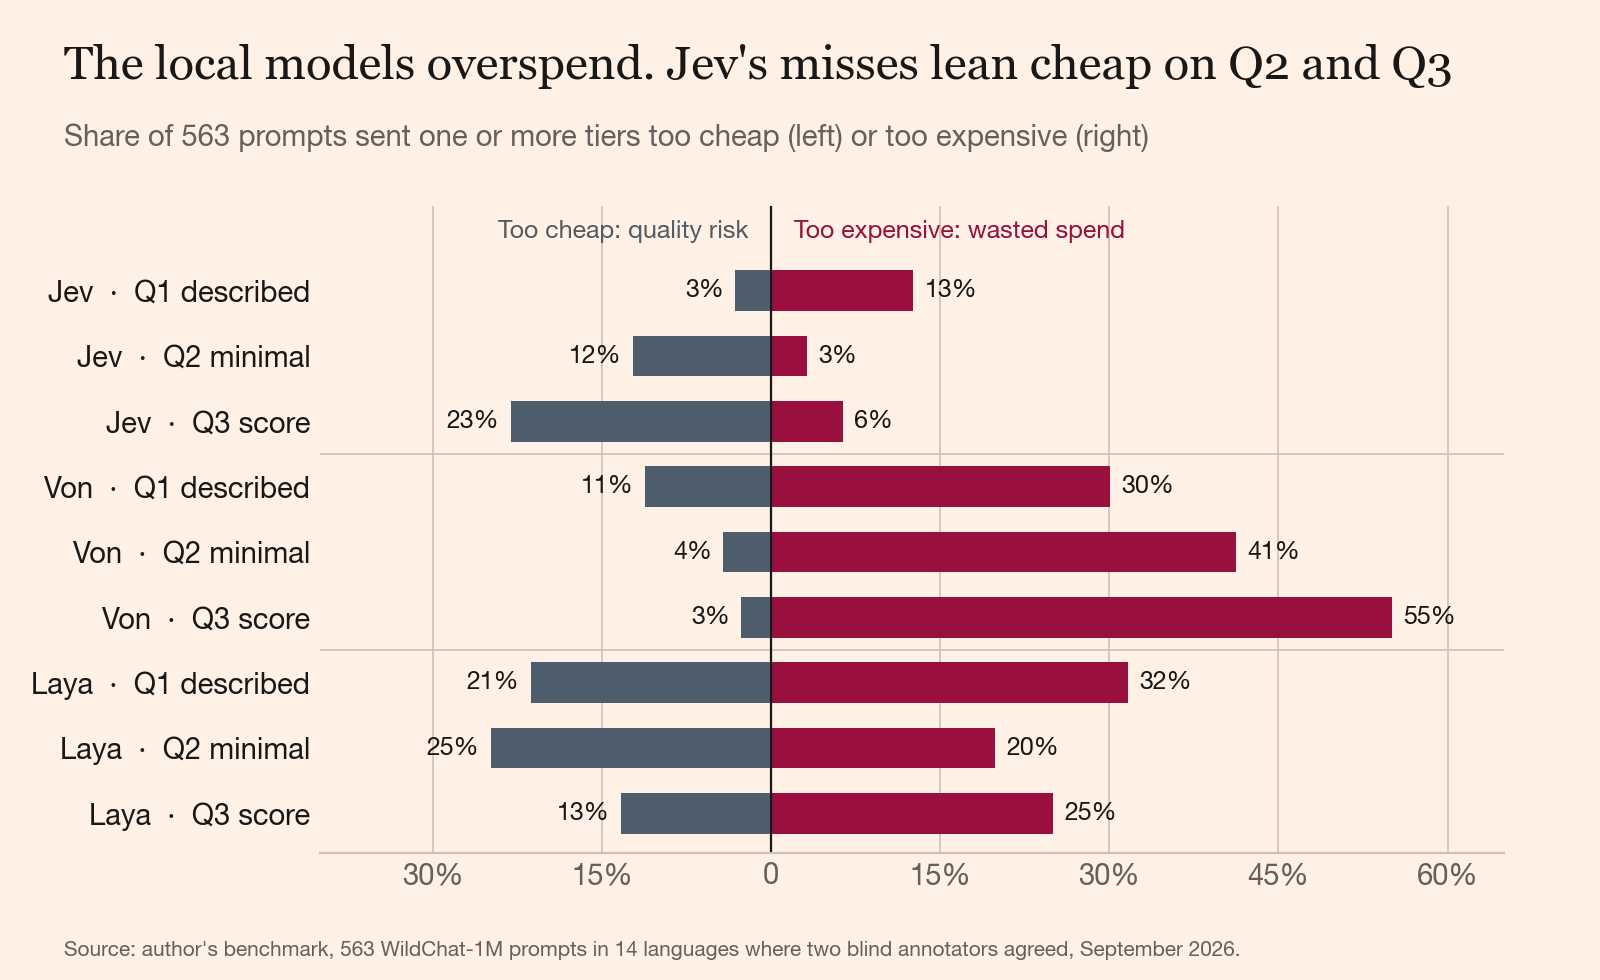
Von en Q3 envía el 55% de todos los prompts a un nivel más caro del que necesitan. Ese router infla la factura que existe para recortar.
Jev se desvía hacia el otro lado en Q2 y Q3, y eso es peor por cada error. Una respuesta demasiado cara cuesta la diferencia de precio. Una que se queda corta cuesta un usuario que hizo una pregunta difícil y recibió una respuesta equivocada dicha con total seguridad. En Q2, 51 de los fallos de Jev fueron prompts medium enviados a small. En Q3, 113.
El idioma apenas movió a Jev y movió mucho a todos los demás.
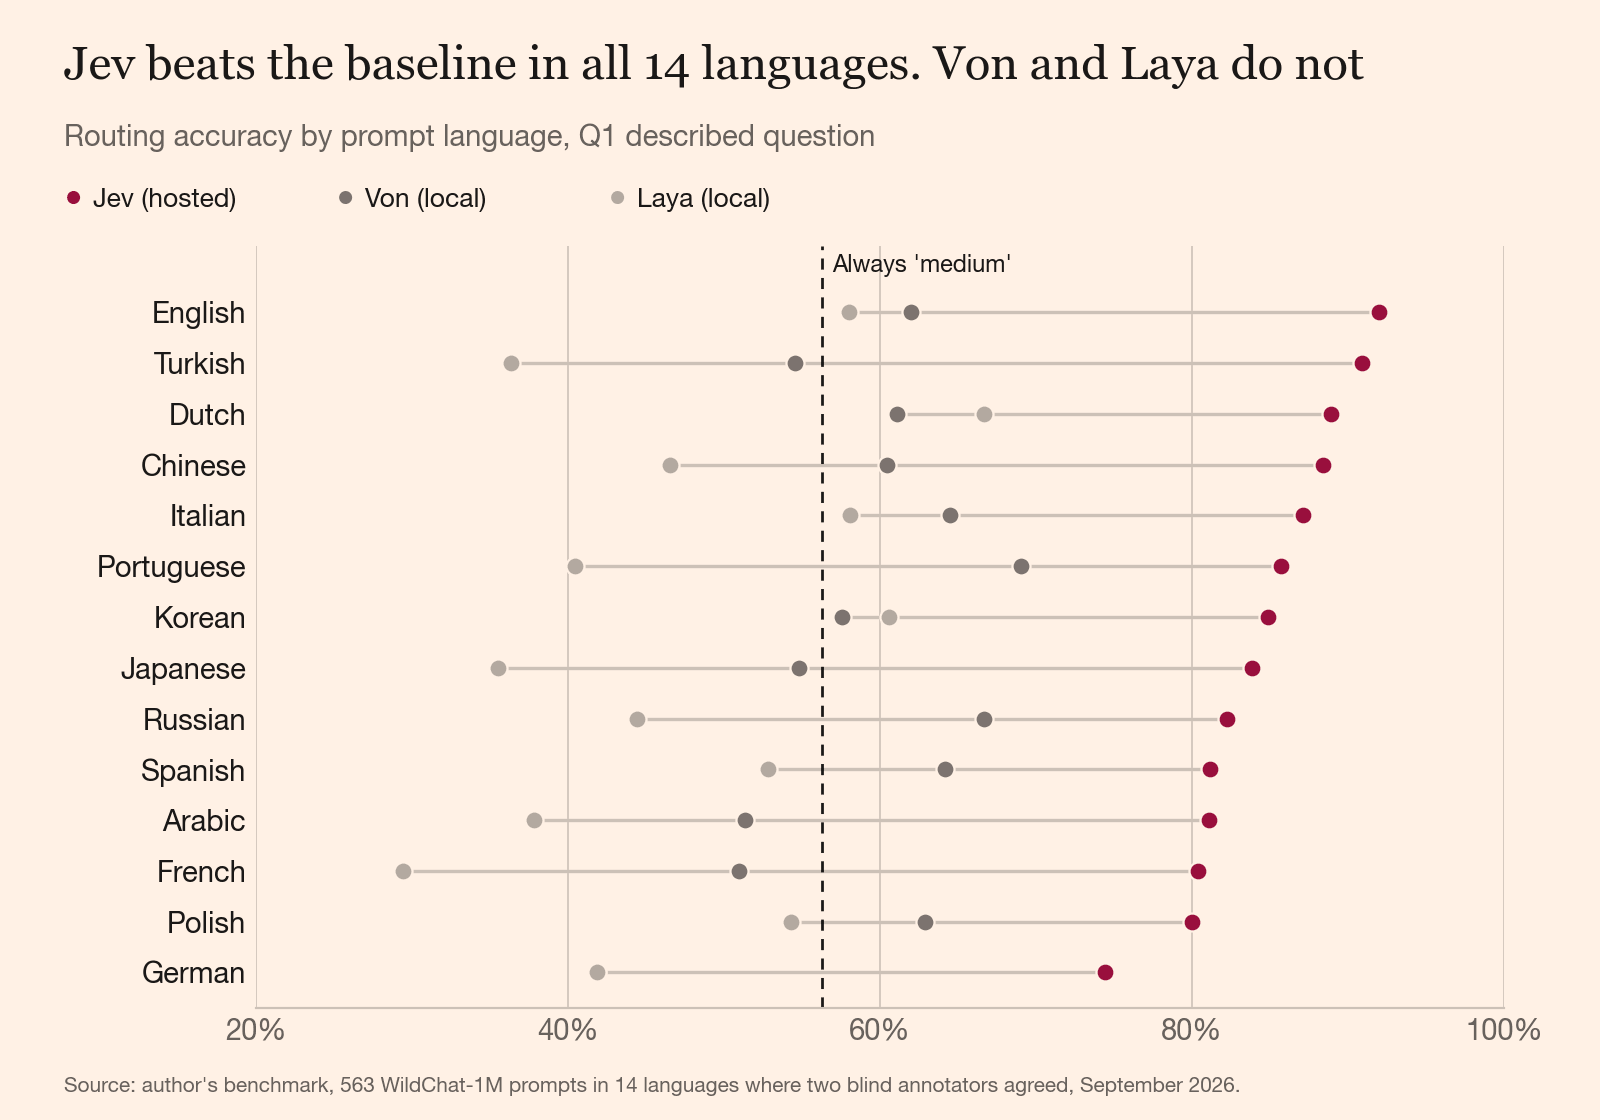
Jev se mantuvo entre el 74% (alemán) y el 92% (inglés), y sacó un 84% tanto en alfabetos latinos como no latinos. Von fue del 42% en alemán al 69% en portugués, y Laya del 29% en francés al 67% en neerlandés. Un router que acierta en francés menos de una vez de cada tres no puede acercarse a clientes franceses.
Jev falla en los prompts que más importan.
De los 21 prompts frontier, Jev en Q1 envió seis a frontier y 15 a medium. En Q2 envió tres. Ahí es donde enrutar barato hace más daño: un problema de estadística en turco, reglas de decisión de inversión en alemán, un esquema sobre distribución cuántica de claves. Veintiuno es una muestra pequeña, y lo digo yo primero.
Las probabilidades de Jev ayudan. Escala a frontier siempre que Jev le dé más de 0,2, y Q1 atrapa 14 de los 21 escalando solo 18 de 563 prompts. Q2 con el mismo umbral atrapa siete. Elegí 0,2 después de ver estos datos, así que tómalo como un punto de partida que hay que ajustar.
Tres cosas más van en contra del titular:
- El 84% favorece a Jev. El conjunto de referencia son los prompts en los que coincidieron ambos anotadores, los más fáciles. Los anotadores solo coincidieron el 77,5% de las veces en el conjunto completo, así que un 80% es un techo realista para cualquier router con estos niveles.
- Son etiquetas de criterio. Dos modelos adivinaron qué nivel necesita un prompt. Nadie comprobó lo que produjo realmente cada nivel.
- Jev es más lento. La latencia mediana fue de unos 330 ms por llamada desde mi portátil, casi todo red, frente a entre 56 y 170 ms de los modelos locales.
El router barato es el caro.
Al final no pudimos poner Jev en producción: no tiene despliegue en la UE. Así que hice fine-tuning de Laya con nuestras propias etiquetas, y ese router ahora corre en un único servidor con CPU en Alemania.
Un router local no cuesta nada por llamada. Si envía el 41% de tu tráfico a un nivel que no necesita, como hizo Von en Q2, lo pagas en cada una de esas llamadas, y ese coste no aparece en ninguna model card que yo haya leído.
Así que cuenta. Coge WildChat o tus propios logs, etiqueta unos cientos de prompts con dos anotadores, descarta aquellos en los que no coinciden y puntúa tu router contra return "medium". Si no supera esa línea por diez puntos, no tienes un router.
La mejor prueba, que es la que vamos a hacer ahora, se basa en resultados: pasar tráfico real por todos los niveles, registrar el nivel más barato cuya respuesta fue suficientemente buena y puntuar el router contra eso. Si el 84% de Jev se desmorona ahí, también lo publicaré.