Tłumaczenie maszynowe. Przeczytaj angielski oryginał: Open source Jev alternatives sucks, here is the benchmark →
Każdy produkt czatowy z listą modeli do wyboru zrzuca na użytkowników zadanie routingu. Muszą zgadnąć, czy ich pytanie zasługuje na drogi model, czy na tani, a większość ludzi wybiera raz i nigdy więcej tego nie rusza. Przepłacają więc na „co to jest szczenięca miłość?”, a niedopłacają na dowodzie o próbach Bernoulliego.
W TextCortex budujemy automatyczny wybór modelu, żeby nikt nie musiał zgadywać. Router czyta prompt i wybiera najtańszy tier, który nadal dobrze na niego odpowie. Najbardziej oczywisty sposób, żeby go zbudować, to mały otwarty model na własnym sprzęcie: zero opłat za wywołanie, około 60 milisekund na wywołanie, a prompt nigdy nie opuszcza budynku. Zakładałem, że tam właśnie wylądujemy.
Więc to zmierzyłem. Na 563 prawdziwych promptach z chatbotów w 14 językach hostowany model Jev skierował 84,5% z nich do właściwego tieru. Laya i Von, otwarte modele na moim laptopie, doszły najwyżej do 61,6% i 58,8%. Router, który na każdy prompt odpowiada „medium”, ma 56,3%. Nazwijmy go routerem stałym. Cztery z sześciu przebiegów Layi i Vona z nim przegrały.
Router to jedno pytanie wielokrotnego wyboru zadawane przed każdym promptem.
Wszystkie trzy systemy mówią tym samym API. Wysyłasz prompt plus pytanie z nazwanymi opcjami i jednym zdaniem opisu każdej z nich. Dostajesz z powrotem prawdopodobieństwo dla każdej opcji.
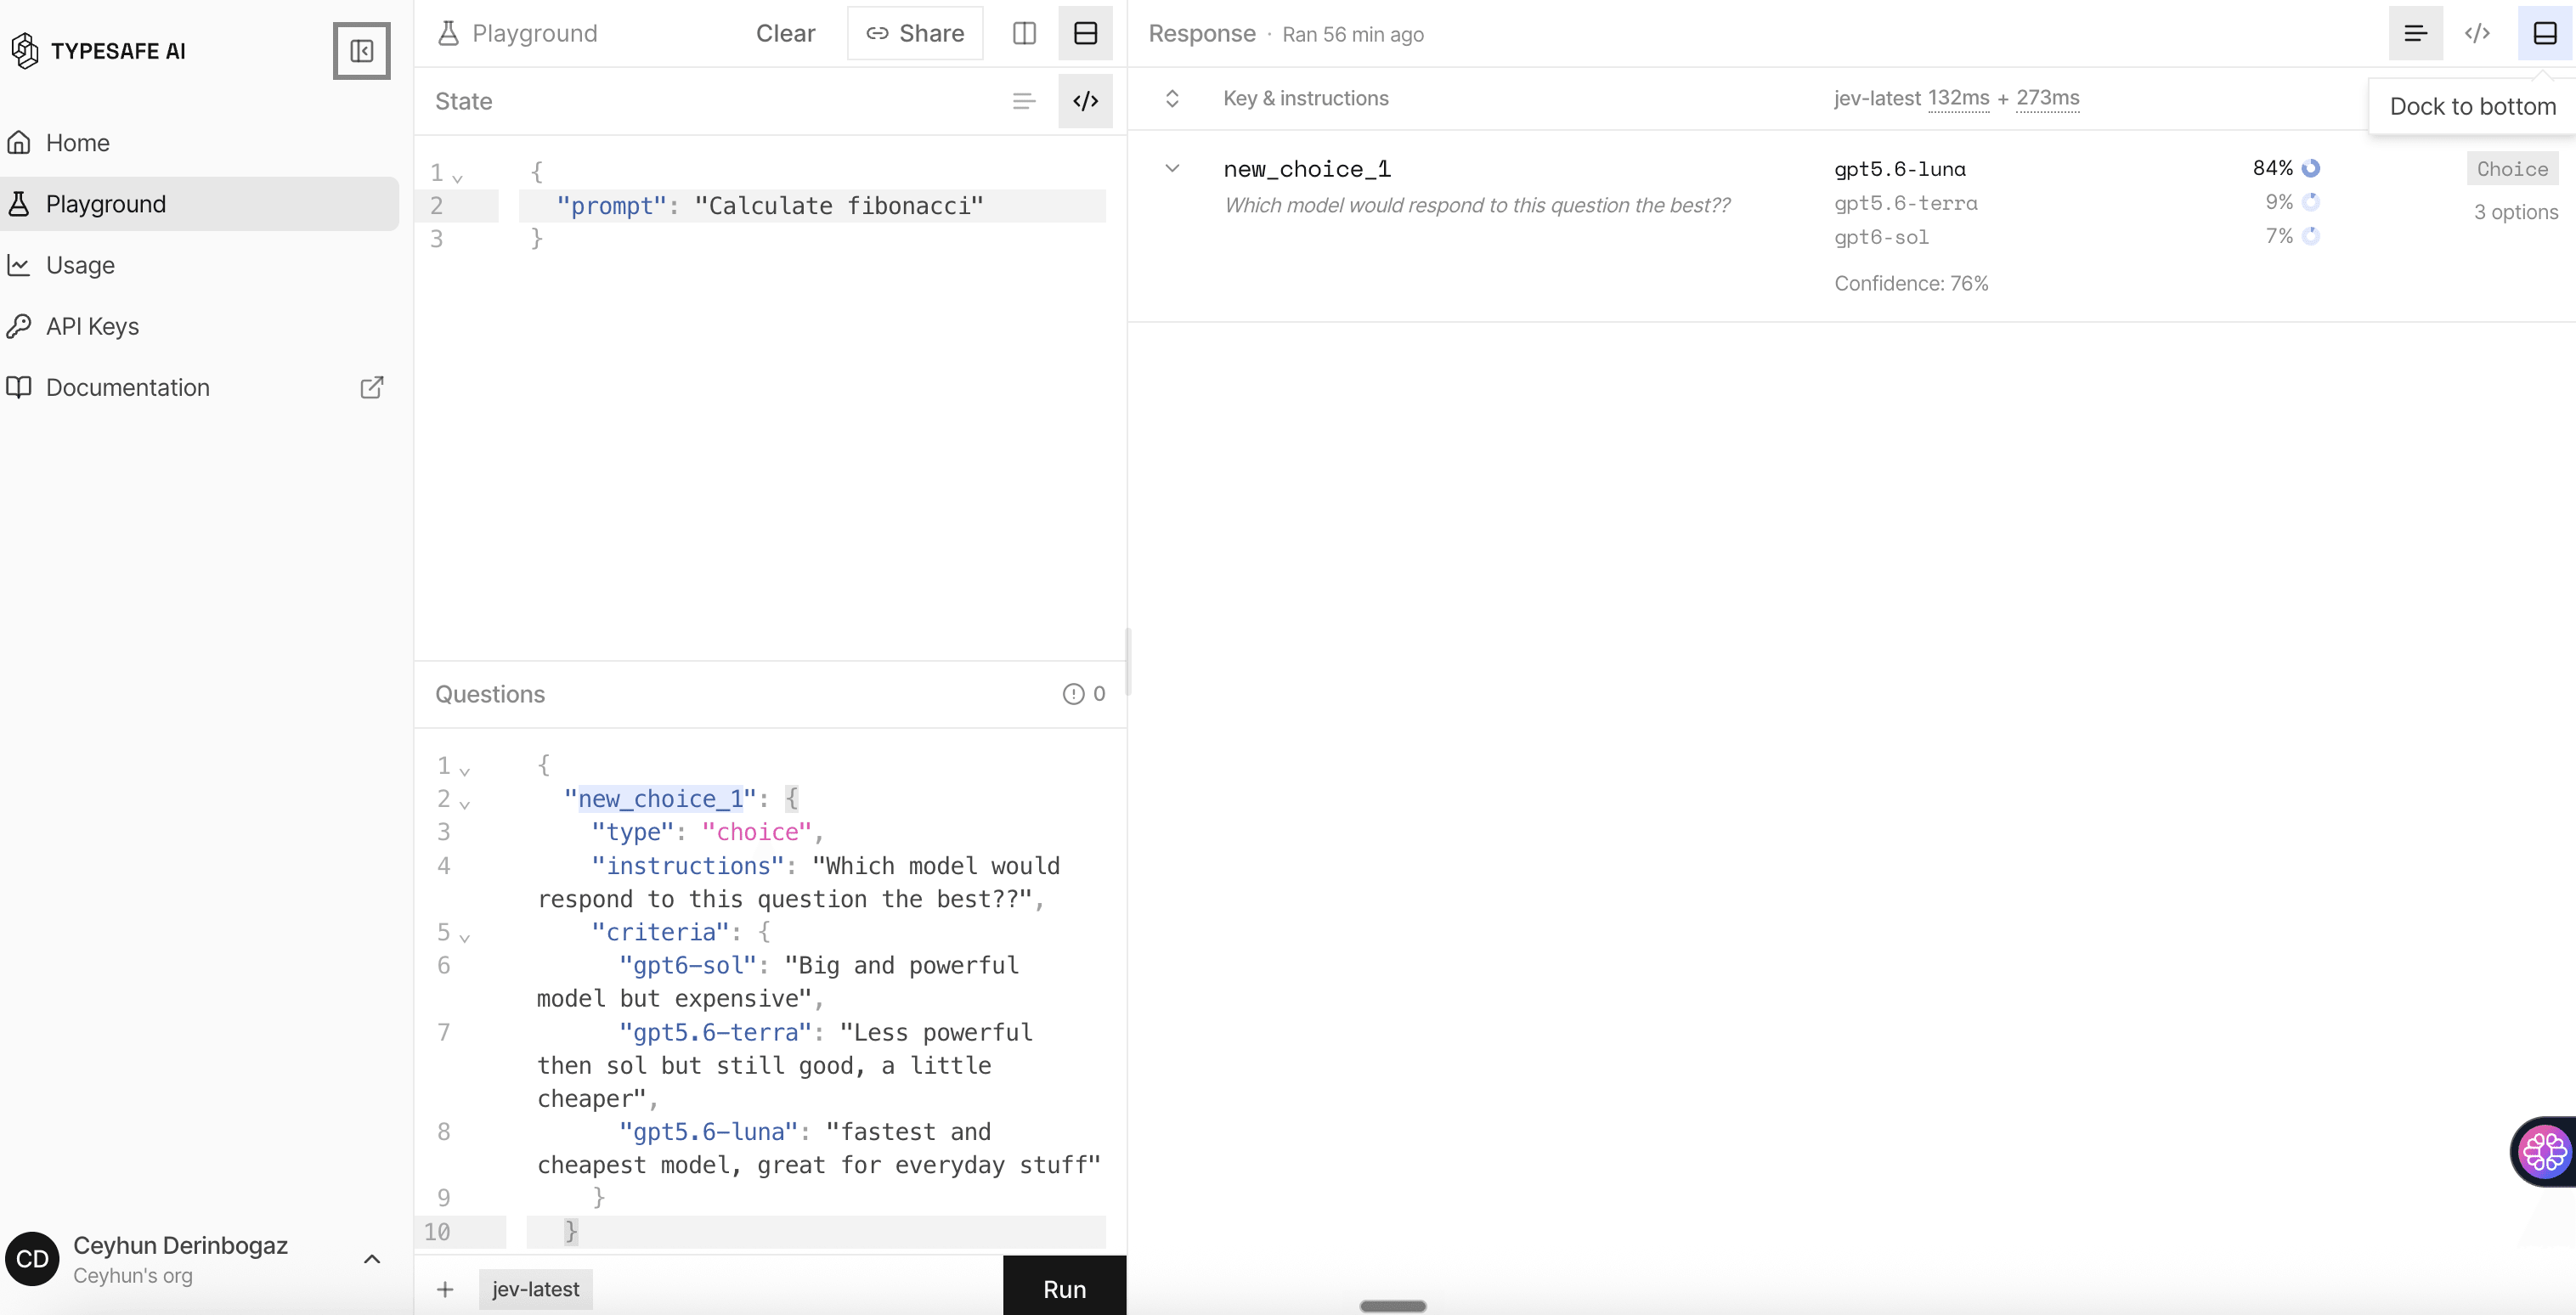
„Calculate fibonacci” idzie do taniego tieru. Oczywiście. Najpierw testowałem wszystkie trzy routery na takich promptach i tę rundę też wygrał Jev, ale prompty, które piszę dla routera, to prompty, na które już znam odpowiedź. To nie dowodziło prawie niczego.
Użyłem prawdziwych promptów, bo moje były za łatwe.
Prompty pochodzą z WildChat-1M, publicznego zbioru prawdziwych rozmów z chatbotami (licencja ODC-BY, toksyczne odfiltrowane). Wziąłem po 40 pierwszych wiadomości w każdym z języków: angielskim, niemieckim, francuskim, hiszpańskim, włoskim, portugalskim, niderlandzkim, polskim, tureckim, rosyjskim, arabskim, chińskim, japońskim i koreańskim, a potem dodałem 168 dłuższych albo bardziej technicznych promptów, bo w prawdziwym ruchu trudnych prawie nie ma.
Dwóch niezależnych anotatorów na różnych modelach, Claude Opus i Claude Sonnet, oznaczyło wszystkie 728 promptów jako small, medium albo frontier. Zgodzili się w 77,5% przypadków (κ Cohena = 0,60). Zostawiłem 563, co do których byli zgodni: 225 small, 317 medium, 21 frontier.
Każdy system odpowiedział na trzy pytania na prompt, 5067 wywołań i zero twardych błędów:
- Q1, z opisem. „Wybierz najtańszy tier, który nadal dobrze na to odpowie”, z przykładowymi zadaniami dla każdego tieru.
- Q2, minimalne. „Proste”, „umiarkowanie złożone” i „bardzo trudne prośby”.
- Q3, ocena. Trzystopniowa ocena trudności, zmapowana na tiery.
Dwa z trzech routerów ledwo pobiły stałą.
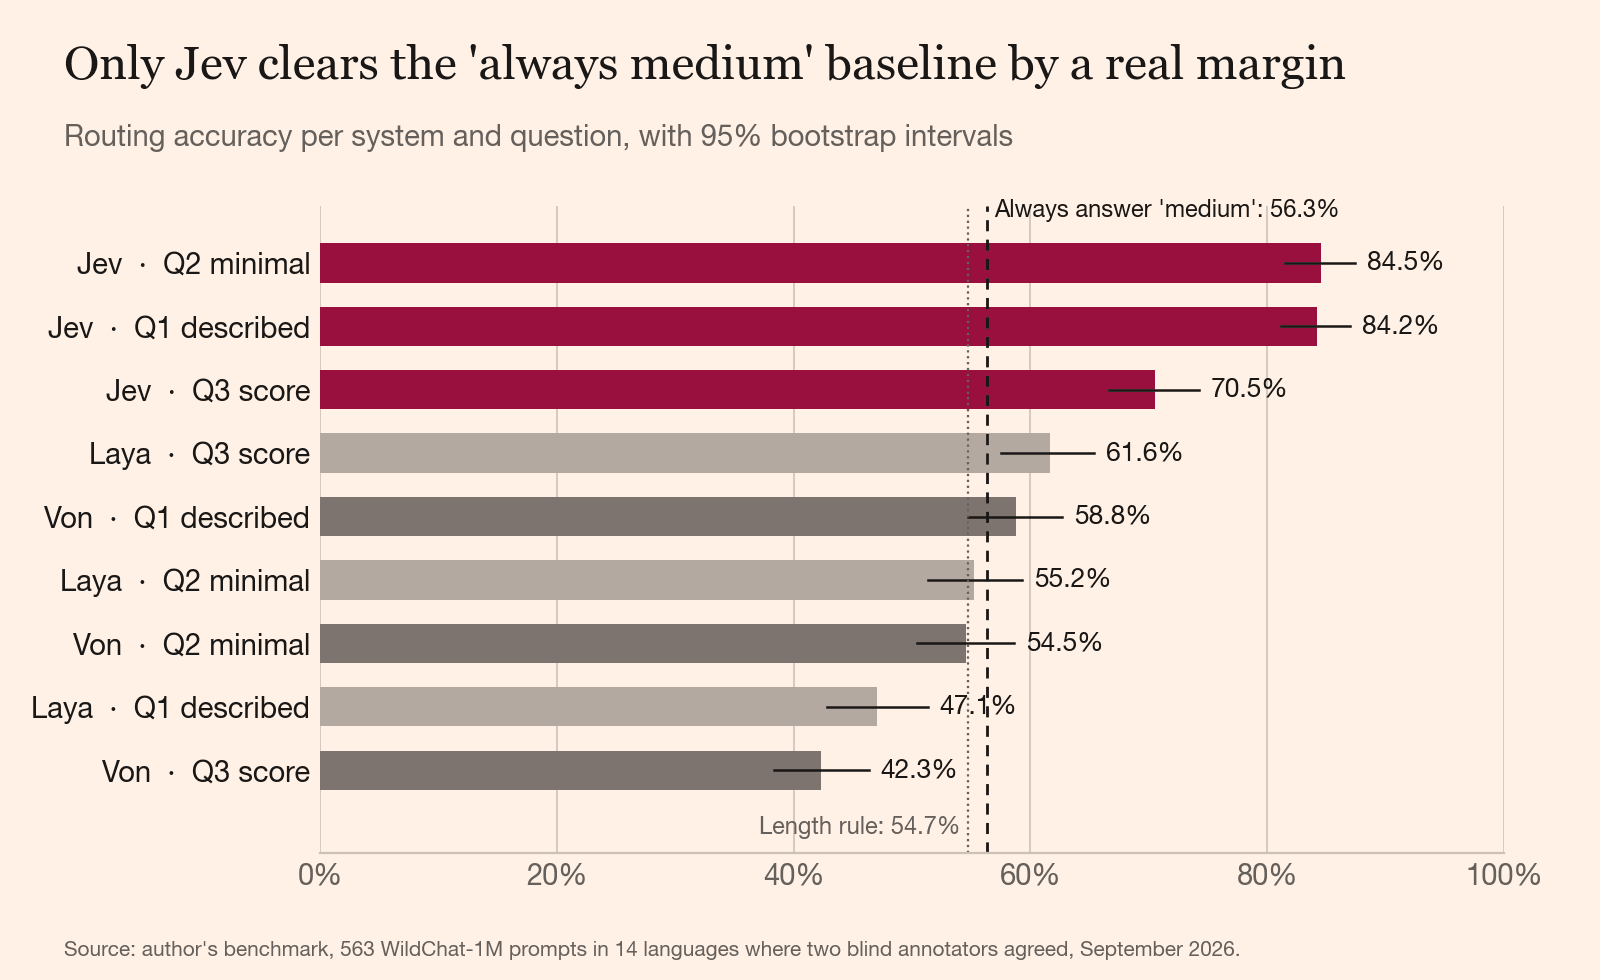
Jev miał 84,5% z opisami na dwa, trzy słowa i 84,2% z pełną rubryką. Ta różnica to szum, więc nikt w moim zespole nie musi zostawać prompt engineerem, żeby napisać pytanie routingowe.
Najlepszy przebieg Layi pobił router stały o 5,3 punktu. Najlepszy przebieg Vona o 2,5, z 95-procentowym przedziałem (55% do 63%), który nadal obejmuje wynik stałej. Reguła, która patrzy tylko na długość promptu, miała 54,7%, więcej niż dwa lokalne przebiegi i mniej niż punkt od dwóch kolejnych.
Router, który przegrywa z return "medium", to generator liczb losowych, do którego trzeba
jeszcze pobrać model.
Lokalne modele zgadują „medium” i nazywają to decyzją.
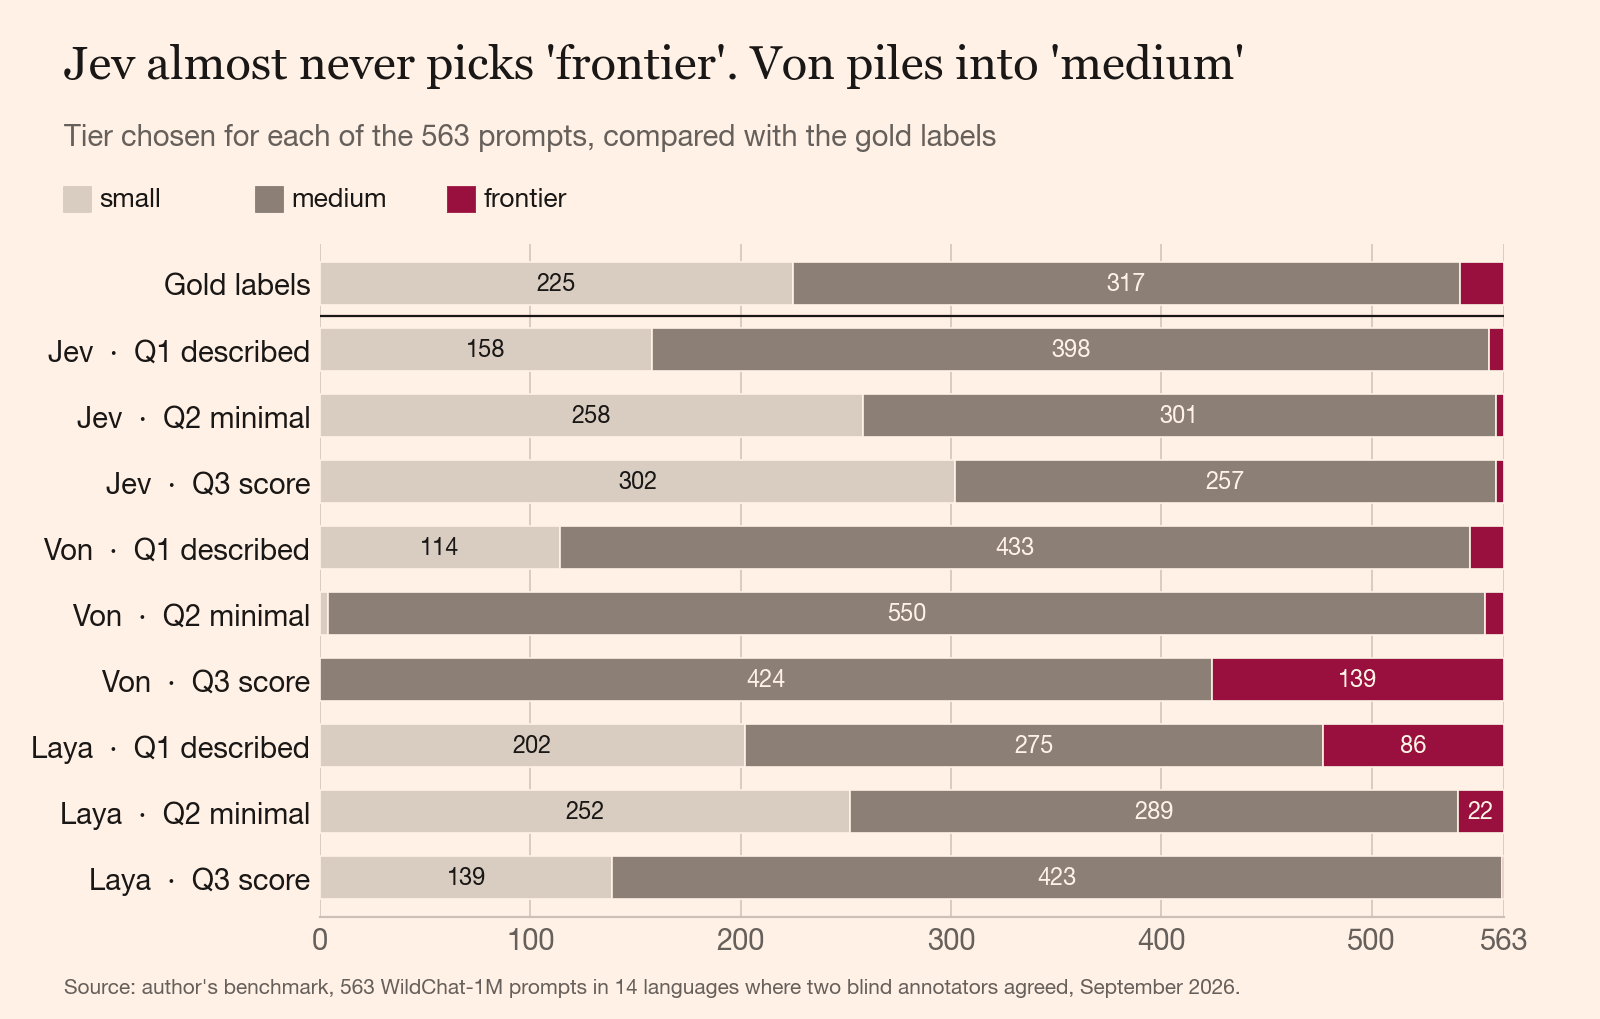
Von na Q2 odpowiedział „medium” 550 razy na 563. Na Q3 ani razu nie powiedział small, a do frontier wysłał 139 promptów, choć należy tam 21. Laya na Q1 wysłała do frontier 86 promptów i miała rację w sześciu przypadkach. Jej wielojęzyczny checkpoint obsłużył 1329 z jej 1689 wywołań, a mimo to po francusku miała 29%.
Von i Laya przepłacają na nawet 55% promptów.
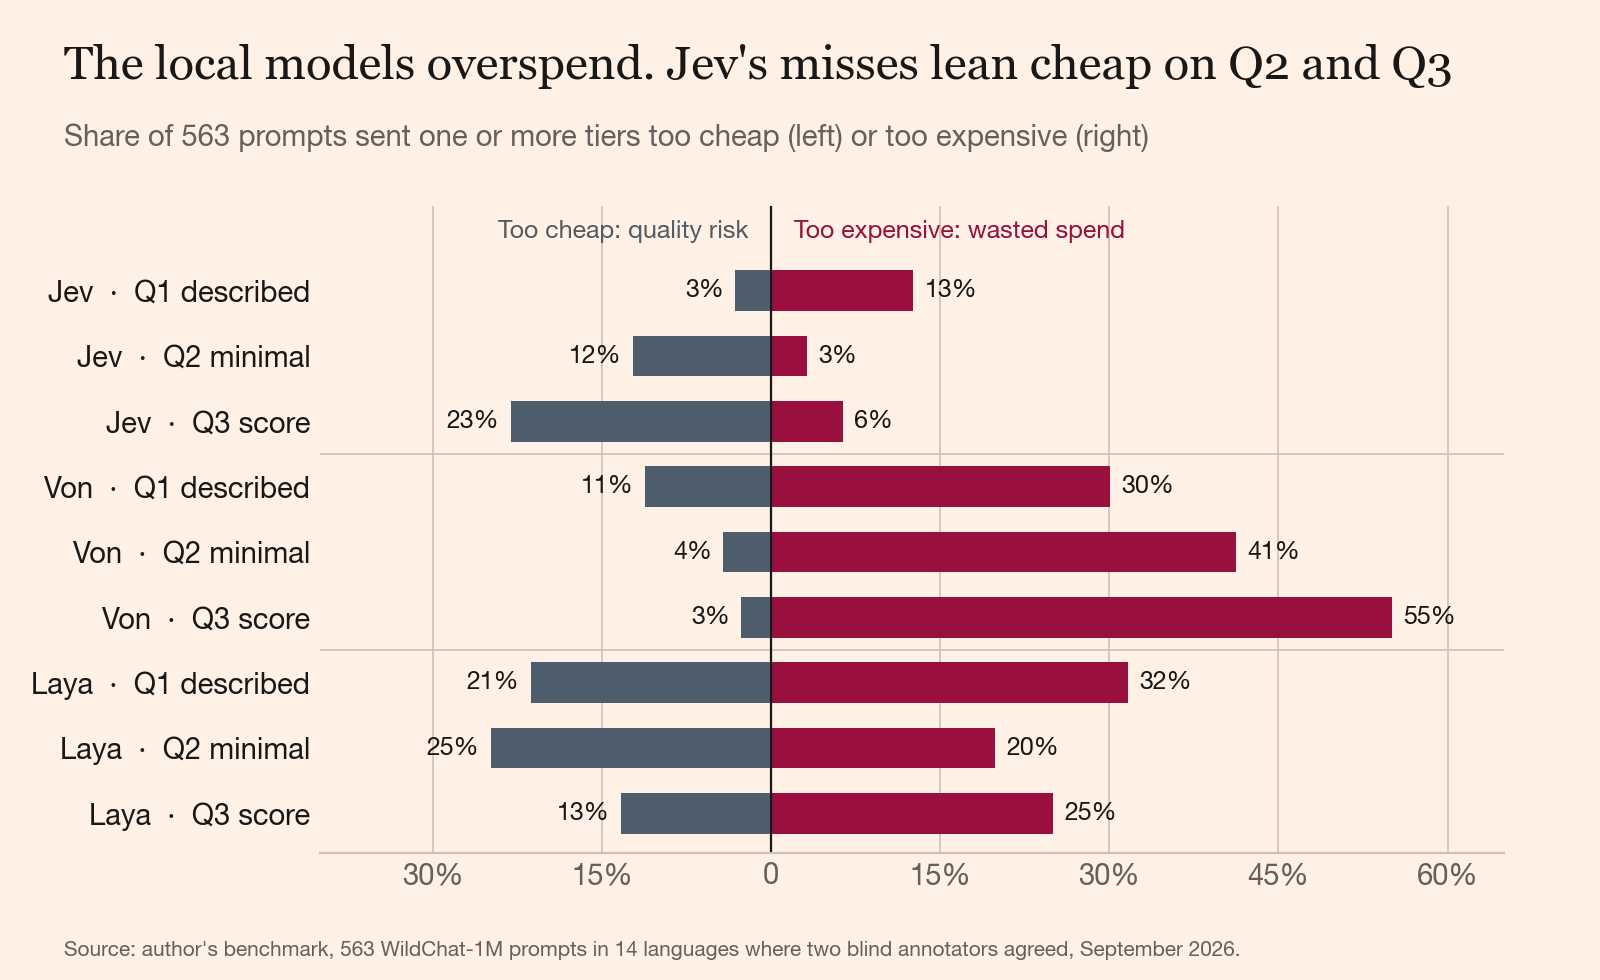
Von na Q3 wysyła 55% wszystkich promptów do droższego tieru, niż potrzebują. Ten router podnosi rachunek, który miał obcinać.
Jev na Q2 i Q3 myli się w drugą stronę, a to jest gorsze w przeliczeniu na pomyłkę. Przepłacona odpowiedź kosztuje różnicę w cenie. Zbyt słaba kosztuje użytkownika, który zadał trudne pytanie i dostał pewną siebie, błędną odpowiedź. Na Q2 51 pomyłek Jev to prompty medium wysłane do small. Na Q3 takich było 113.
Język ledwo ruszył Jev, a pozostałymi mocno zachwiał.
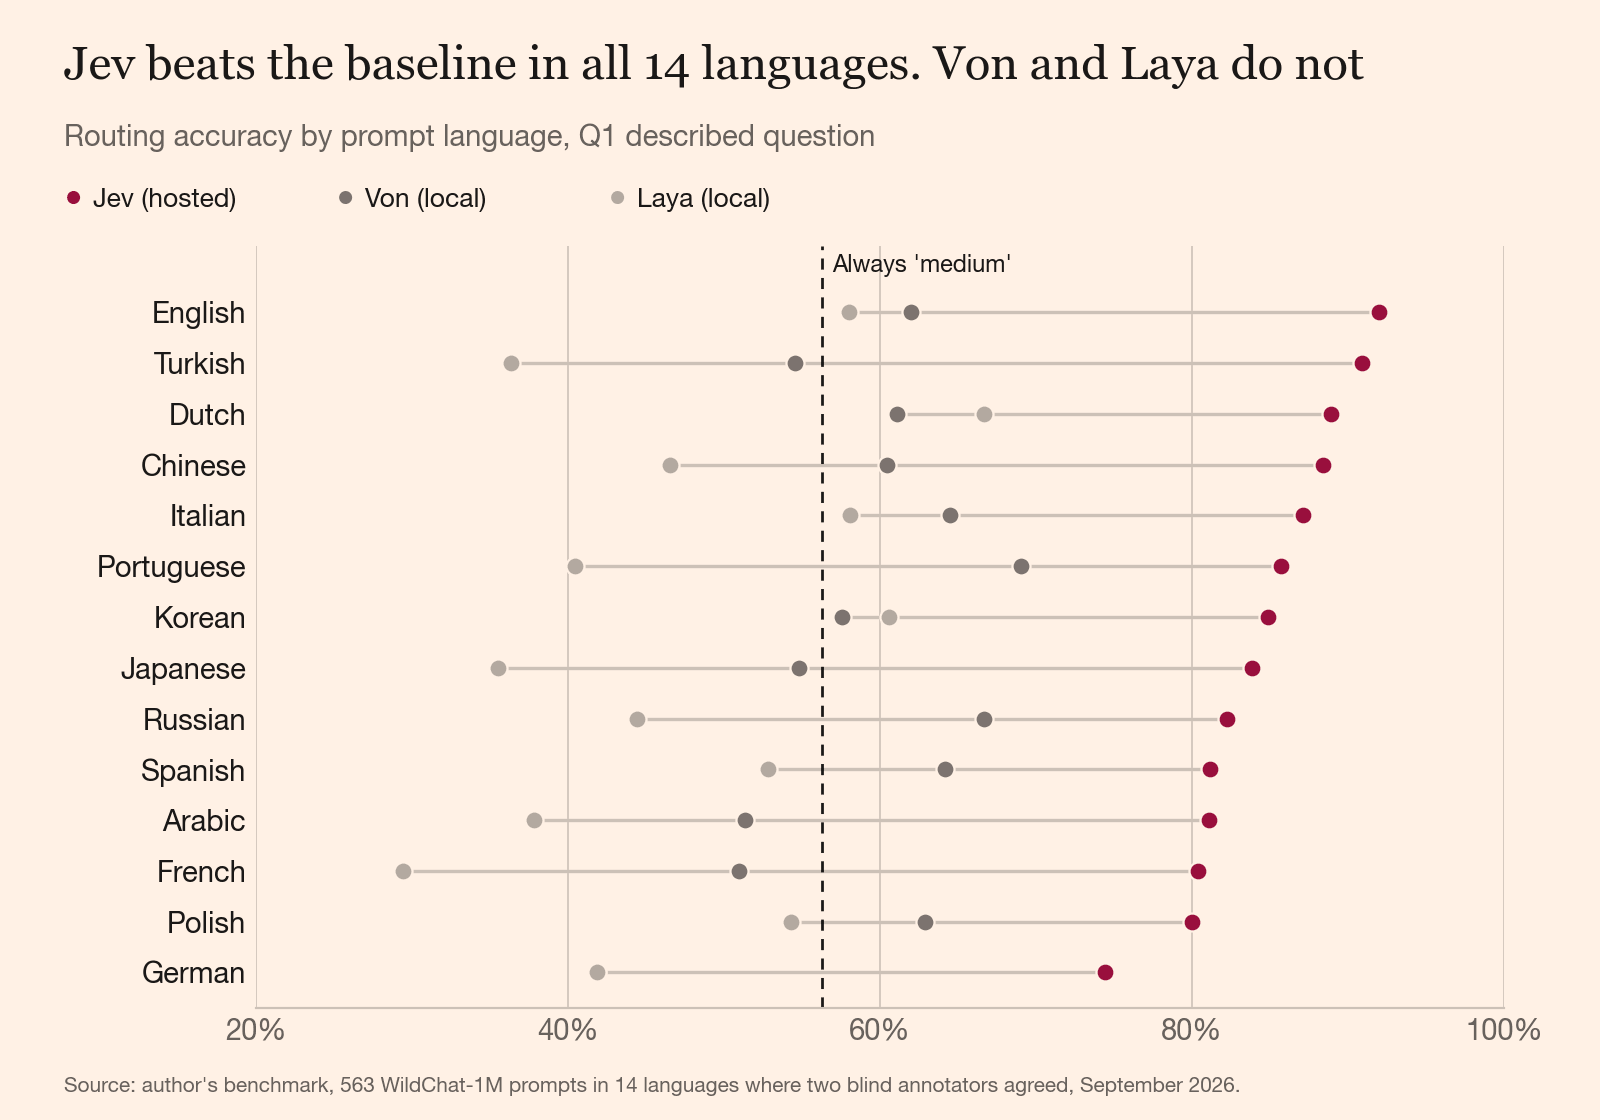
Jev utrzymał się między 74% (niemiecki) a 92% (angielski) i miał 84% zarówno na alfabetach łacińskich, jak i niełacińskich. Von wahał się od 42% po niemiecku do 69% po portugalsku, Laya od 29% po francusku do 67% po niderlandzku. Router, który trafia po francusku w mniej niż co trzecim przypadku, nie może nawet zbliżyć się do francuskich klientów.
Jev pudłuje na promptach, które liczą się najbardziej.
Z 21 promptów frontier Jev na Q1 wysłał sześć do frontier i 15 do medium. Na Q2 wysłał trzy. To właśnie tam tani routing robi najwięcej szkód: zadanie ze statystyki po turecku, reguły decyzji inwestycyjnych po niemiecku, konspekt o kwantowej dystrybucji klucza. Dwadzieścia jeden to mała próba i mówię to pierwszy.
Prawdopodobieństwa Jev pomagają. Eskaluj do frontier zawsze, gdy Jev daje mu więcej niż 0,2, a Q1 wyłapie 14 z 21, eskalując tylko 18 z 563 promptów. Q2 przy tym samym progu wyłapuje siedem. Próg 0,2 wybrałem po zobaczeniu tych danych, więc traktuj go jako punkt wyjścia do strojenia.
Trzy kolejne rzeczy podważają główny wynik:
- 84% schlebia Jev. Zbiór referencyjny to prompty, co do których obaj anotatorzy się zgodzili, czyli te łatwiejsze. Na pełnym zbiorze anotatorzy zgadzali się tylko w 77,5% przypadków, więc około 80% to realistyczny sufit dla każdego routera z tymi tierami.
- To są etykiety z oceny. Dwa modele zgadywały, jakiego tieru potrzebuje prompt. Nikt nie sprawdził, co każdy tier faktycznie wyprodukował.
- Jev jest wolniejszy. Mediana latencji wyniosła około 330 ms na wywołanie z mojego laptopa, głównie sieć, wobec 56 do 170 ms dla lokalnych modeli.
Tani router jest tym drogim.
Ostatecznie nie mogliśmy wdrożyć Jev: nie ma wdrożenia w UE. Dostroiłem więc Layę na naszych własnych etykietach i ten router działa teraz na jednym serwerze CPU w Niemczech.
Lokalny router nie kosztuje nic za wywołanie. Jeśli wysyła 41% twojego ruchu do tieru, którego ten ruch nie potrzebuje, jak Von na Q2, płacisz za to przy każdym z tych wywołań, a ten koszt nie pojawia się na żadnej karcie modelu, jaką czytałem.
Więc licz. Weź WildChat albo własne logi, oznacz kilkaset promptów przez dwóch
anotatorów, wyrzuć te, co do których się nie zgadzają, i porównaj swój router z
return "medium". Jeśli nie przeskoczy tej poprzeczki o dziesięć punktów, nie masz
routera.
Lepszy test, który przeprowadzimy jako następny, opiera się na wynikach: przepuść prawdziwy ruch przez każdy tier, zapisz najtańszy tier, którego odpowiedź była wystarczająco dobra, i oceń router względem tego. Jeśli tam 84% Jev się rozsypie, to też opublikuję.