# Treine o seu próprio Jev: um modelo System-1 11x mais rápido com hosting quase gratuito
> O código de treino do Raya é público: dois LLMs etiquetam os dados, um encoder de 300M aprende em minutos e o ONNX serve-o em CPU. Testei tudo num portátil.
- Source: https://jays.fyi/pt/blog/receita-treino-raya-open-source
- Author: Jay Derinbogaz
- Published: 2026-09-27
- Language: pt
- Tags: ai, open-source, tooling
- Reading time: 8 min
- Machine translated: yes — original: https://jays.fyi/blog/train-your-own-system-1-model
---
Na sexta-feira escrevi sobre o
[Raya](/pt/blog/router-llm-servidor-hetzner-sem-gpu), o router que
escolhe um tier de modelo para cada prompt na TextCortex. Faz 81% no nosso
benchmark de 563 prompts e responde em 30 ms num CPU em Falkenstein. Esse artigo não
explicava como construir um.
A receita é agora pública, na
[pasta `training/`](https://huggingface.co/TextCortex/raya/blob/main/training/README.md)
do repositório do Raya no Hugging Face, sob Apache-2.0. Descreva a decisão, ponha dois
LLMs a etiquetar os seus dados, treine, avalie, exporte para ONNX. Esta manhã corri todos os passos exceto
a etiquetagem num portátil Apple M4 para confirmar que funciona tal como está
escrito. O treino levou **34 segundos** e a exportação levou 24.
A tese é esta. Se envia a um modelo frontier a mesma pergunta com um conjunto fixo
de respostas em cada pedido, essa pergunta pertence a um pequeno classificador
que é seu. Use o modelo grande uma vez, como professor, e deixe de lhe pagar por
cada decisão.
## Está a pagar a um LLM para responder à mesma pergunta um milhão de vezes.
O README chama ao resultado um **System-1 model**, e vou manter o termo. Um
modelo System-1 responde a uma pergunta bem definida sobre um input, de imediato,
com probabilidades a que pode aplicar um limiar. *Que modelo deve responder a este prompt?*
*Este ticket precisa de um humano?* *Que equipa é dona deste pedido?* É um
encoder [Laya](https://huggingface.co/convaiinnovations/laya) com fine-tuning, de
cerca de 300 milhões de parâmetros, corre em dezenas de milissegundos e não tem
custo por chamada.
Chamar um modelo de chat para isto é contratar um advogado para separar o correio: uma fatura
por envelope, uma espera em cada um, e uma cópia do seu correio no servidor
de outra pessoa. Para uma empresa europeia
essa última parte pode encerrar a conversa: construímos o Raya porque o router que
queríamos não tinha deployment na UE.
A espera é fácil de medir. O Raya responde em 30 ms no p50 em produção. Quando
medi o Jev, o router alojado que o Raya substitui, levava cerca de 350 ms por chamada:
o Raya é aproximadamente **11 vezes mais rápido**. Corre num servidor Hetzner de 84 € por mês
que já estava na nossa fatura, por isso o alojamento não nos custou nada de novo.
## A receita inteira são quatro scripts e um ficheiro JSON.
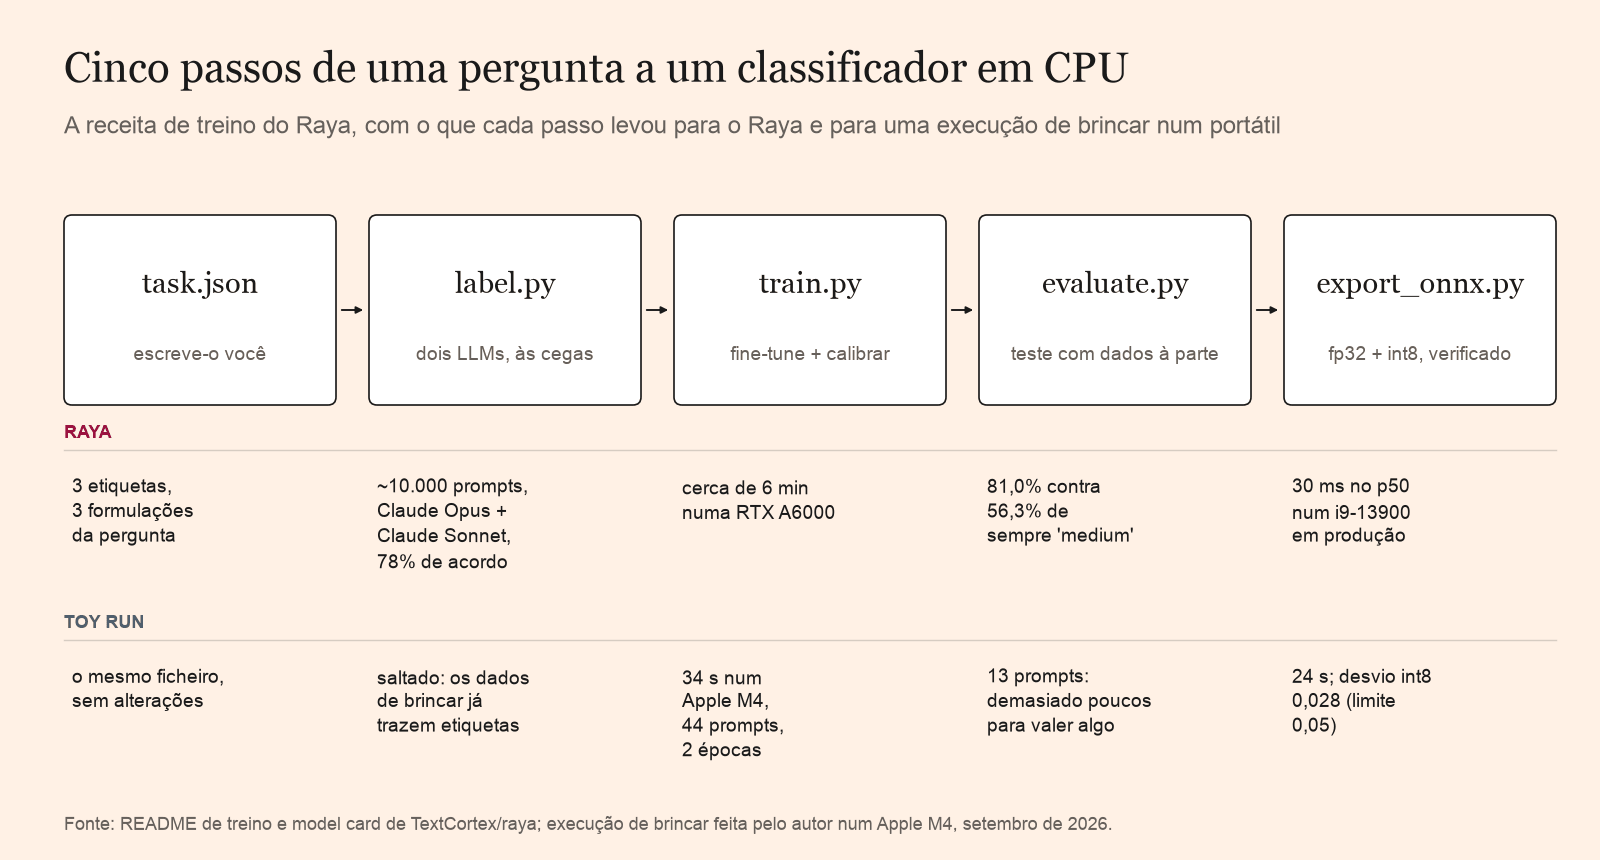
Os números do Raya vêm do README de treino e do artigo anterior. A execução de brincar usou os 44 prompts de demonstração que vêm com o código.
```bash
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
--annotator --annotator @https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
```
Antes de tudo isso escreve o `task.json`: as etiquetas e uma ou mais
*formulações* da pergunta. O Raya tem três: "Route this prompt to a model", uma
versão mais longa com uma rubrica por tier, e uma pontuação de dificuldade de 1 a 3. O
modelo treina com todas as formulações, com as opções baralhadas em cada época, por isso
aprende a decisão em si. O ficheiro também contém a rubrica que os anotadores
leem, e
[a do próprio Raya](https://huggingface.co/TextCortex/raya/blob/main/training/task.example.json)
vem como modelo.
## Dois anotadores que discordam valem mais do que um que parece seguro.
Provavelmente tem inputs e não tem etiquetas. O `label.py` envia cada input a dois ou
mais LLMs, em separado, com a mesma rubrica. As cerca de 10.000 etiquetas do Raya vieram
do Claude Opus e do Claude Sonnet, cegos um ao outro. Qualquer endpoint compatível com OpenAI
serve, incluindo o da Anthropic, OpenRouter, vLLM e Ollama.
Onde os anotadores concordam, obtém uma etiqueta limpa. Onde discordam, a linha
guarda os dois votos e o `train.py` aprende um alvo 50/50. É a resposta
honesta para um prompt em que dois modelos fortes se dividem. Forçar ali uma etiqueta rígida
ensina ao modelo um lançamento de moeda como se fosse um facto.
O script também mostra com que frequência os anotadores concordaram. **Aponte esse
número.** É aproximadamente o teto do que o seu modelo consegue pontuar contra estas
etiquetas. Para o Raya foi 78%. Se os seus anotadores concordam 75% das vezes e o seu
modelo faz 90%, aprendeu os hábitos de um dos anotadores, e a solução é uma
rubrica mais apertada.
Quanto ao volume, o README fala de 1.000 a 5.000 inputs reais para um primeiro modelo, nas
línguas que realmente serve. Deixe as classes desequilibradas; o `train.py`
dá ele próprio mais peso às etiquetas raras. Guarde um conjunto de teste
em que nada treine nem valide.
## A GPU é a parte barata.
O Raya treinou em cerca de seis minutos numa única RTX A6000 de 48 GB. No meu M4 fez duas épocas sobre as 40 linhas de treino
de brincar em 22 segundos, 34 com o carregamento do modelo.
Congela a tabela de embeddings de tokens para poupar memória, escolhe a melhor época na
validação e depois ajusta uma temperatura por pergunta para que uma probabilidade de 0,9
acerte cerca de nove vezes em dez. É essa calibração que lhe permite agir com base num
limiar mais tarde, como enviar um prompt para o tier frontier só acima de 0,6.
O ponto de partida por omissão é o mmBERT-base multilingue do Laya. Passe
`--base TextCortex/raya` para adaptar o Raya ao seu próprio tráfego de encaminhamento.
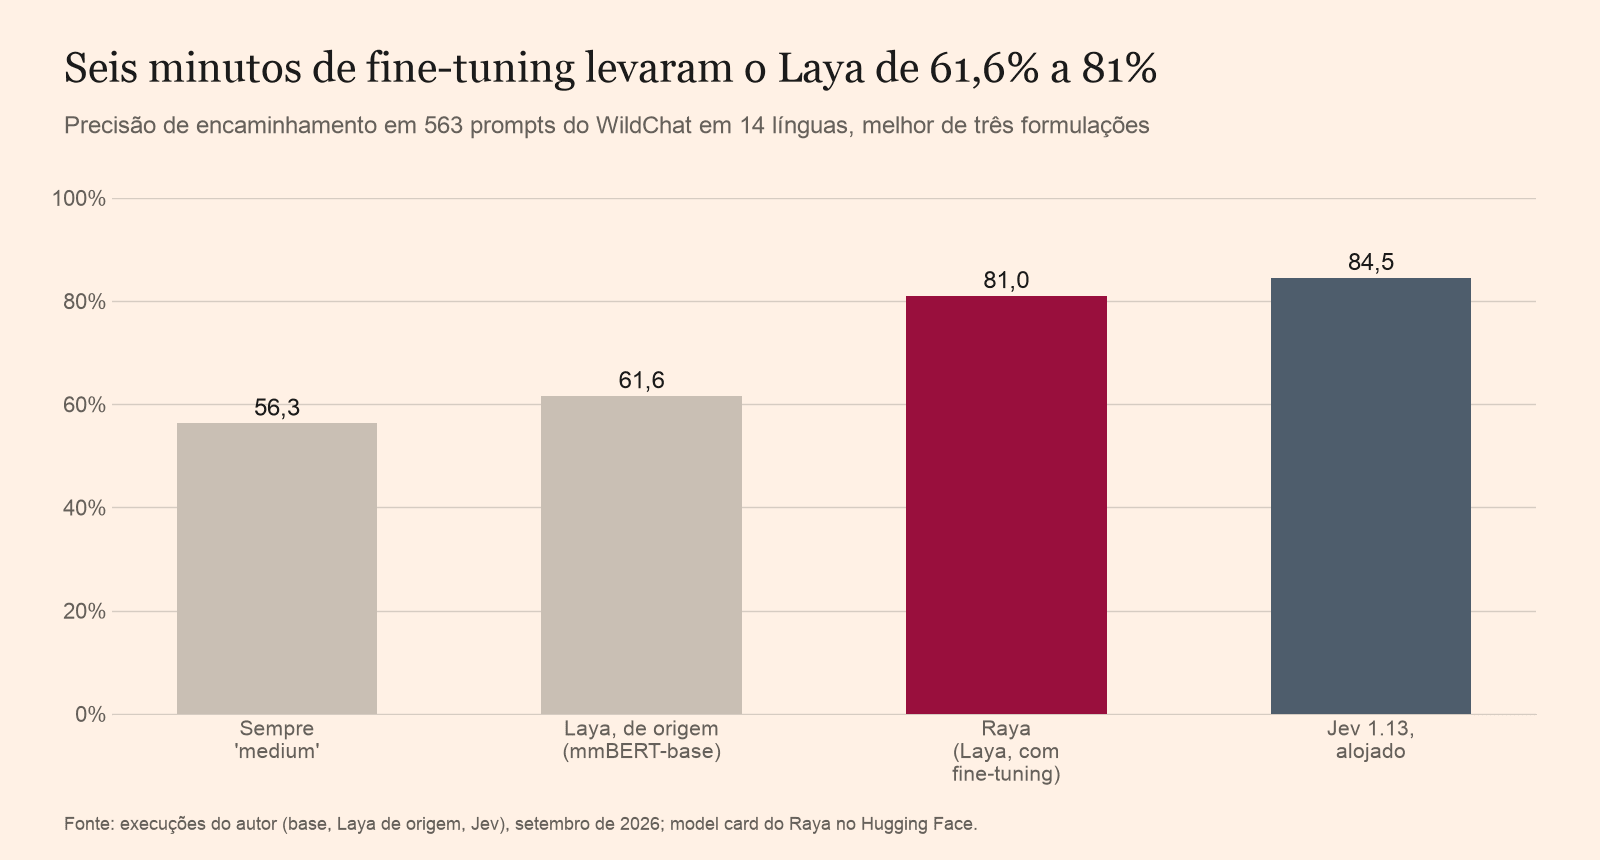
O melhor de três estilos de pergunta no benchmark de 563 prompts do primeiro artigo.
Seis minutos de GPU levaram o Laya de 61,6% para 81%, a três pontos e meio
do Jev. As etiquetas são onde se vai a sua tarde.
## Os dados de brincar provam que a canalização funciona e mais nada.
A pasta inclui 44 prompts de encaminhamento escritos à mão para treino e 13 para
teste. O README promete cinco minutos. Treino e exportação levaram menos de
um minuto, sem contar a instalação, com as versões fixadas. A chamada de exemplo do README encaminhou "Prove that √2 is irrational."
para `frontier_model` com 0,52.
O `evaluate.py` deu depois ao modelo de brincar 46,2% na formulação curta, 84,6%
na formulação com rubrica e 69,2% na pontuação de dificuldade. A formulação curta
mandou 12 de 13 prompts para medium. Treze prompts não chegam para separar esses
números do ruído, e 44 linhas de treino são, nas palavras do README, "demasiado
pouco para treinar um modelo útil".
A coisa útil que o `evaluate.py` fez foi imprimir primeiro esta linha:
```text
13 rows with a gold label; always answering 'small_model' scores 38.5%
```
Essa é a baseline constante. No
[primeiro benchmark](/pt/blog/alternativas-open-source-jev-benchmark),
o Laya de origem perdeu contra `return "medium"` em dois dos seus três estilos de pergunta.
Toda a avaliação deve abrir com a pontuação do modelo que não faz nada.
## Exporte uma vez e depois meça no CPU que vai realmente alugar.
O `export_onnx.py` escreve um ficheiro fp32 e um ficheiro int8 por blocos, e depois compara
ambos com o PyTorch nos seus dados de teste. A exportação falha se alguma escolha mudar
ou se as probabilidades se desviarem mais de 0,001 no fp32 ou 0,05 no int8. O meu modelo
de brincar ficou em 0,00000 e 0,02790.
O ficheiro a pôr em produção depende do silício. Como mediu o
[último artigo](/pt/blog/router-llm-servidor-hetzner-sem-gpu),
o int8 por blocos manteve a precisão do Raya e foi o mais rápido num i9-13900 com instruções
VNNI, mas demorou mais do dobro do fp32 num EPYC 7502P sem elas.
Meça no seu próprio hardware antes de escolher.
## Alugue o modelo grande uma vez e depois deixe de lhe pagar por cada decisão.
A indústria dos modelos frontier cobra cada chamada, por isso cada chamada parece um trabalho
para um modelo frontier. Qualquer chamada que escolha de uma lista fixa de respostas é uma
classificação, faturada como raciocínio. Depois de as etiquetas estarem escritas, o LLM é uma forma cara de chegar a um veredicto a que um encoder de 300M
chega em 30 ms em hardware que já paga.
Há um limite que lhe devo dizer. Os dados de treino do Raya não são públicos, por isso pode
construir o seu próprio Raya com esta pasta mas não reproduzir o nosso. E o Raya
aprendeu com os mesmos dois anotadores que escreveram as etiquetas do benchmark, o que
favorece os seus 81%.
Por isso meça-o no seu próprio tráfego. Corra o `evaluate.py` num conjunto de teste que o seu modelo
nunca viu. Se não ficar bem acima da baseline constante,
aperte a rubrica antes de mexer em qualquer outra coisa. Se a receita falhar na sua
decisão, mande-me os números e eu publico-os.