# Nasz router LLM ma p50 30 ms na serwerze Hetzner za 84 € miesięcznie, bez GPU
> Z Layi zrobiliśmy Rayę, otwarty router LLM z trafnością 81%, działający na CPU jednego serwera Hetzner przez Cloudfleet. 30 ms p50, hosting w UE.
- Source: https://jays.fyi/pl/blog/router-llm-na-serwerze-hetzner-bez-gpu
- Author: Jay Derinbogaz
- Published: 2026-09-25
- Language: pl
- Tags: ai, open-source, benchmarks, infrastructure
- Reading time: 7 min
- Machine translated: yes — original: https://jays.fyi/blog/fine-tuned-llm-router-on-a-hetzner-cpu-server
---
Dwa dni temu opublikowałem benchmark pokazujący, że
[otwarte alternatywy dla Jev przegrywają z zakodowanym na sztywno „medium”](/pl/blog/otwarte-alternatywy-dla-jev-benchmark).
Jev skierował 84,5% z 563 prawdziwych promptów do właściwego tieru modelu. Laya
i Von, modele otwarte, doszły w najlepszym razie do 61,6%.
Potem spróbowaliśmy kupić Jev i się nie dało. TextCortex sprzedaje europejskim
firmom, a kiedy sprawdzaliśmy we wrześniu 2026, nie było do kupienia żadnego
wdrożenia Jev w UE. Router czyta każdy prompt, który wpisuje klient, więc musi
działać tam, gdzie dane klienta wolno wysłać.
Wziąłem więc model, który przegrał, i go dostroiłem. Efekt to
[Raya](https://huggingface.co/TextCortex/raya), router z 300 milionami
parametrów, który ma **81%** na tym samym benchmarku. Działa teraz w naszym
produkcyjnym klastrze na CPU w Falkenstein w Niemczech, z medianą latencji
**30 ms**, na serwerze Hetzner, który kosztuje 84 € miesięcznie i już był na
naszym rachunku.
## Najlepszy router nie miał regionu w UE, więc dostroiliśmy ten, który przegrał.
[Laya](https://huggingface.co/convaiinnovations/laya) to model decyzyjny na
licencji Apache-2.0: enkoder [mmBERT](https://huggingface.co/jhu-clsp/mmBERT-base)
z małą głowicą, która ocenia każdą opcję w pytaniu wielokrotnego wyboru. Mówi
tym samym API co Jev. Prosto z pudełka routowała gorzej niż stała.
Dwóch niezależnych
anotatorów, Claude Opus i Claude Sonnet, oznaczyło prompty z WildChat według tej
samej spisanej rubryki. Raya uczy się na ich etykietach traktowanych jako
miękkie cele, 50/50 tam, gdzie się nie zgadzali, plus syntetyczne trudne prompty we
wszystkich 14 językach i trochę naszych wewnętrznych danych routingowych. 563
prompty testowe pochodzą z fragmentów WildChat, których trening nigdy nie dotknął.
Trening zajął około sześciu minut na jednej karcie NVIDIA RTX A6000.
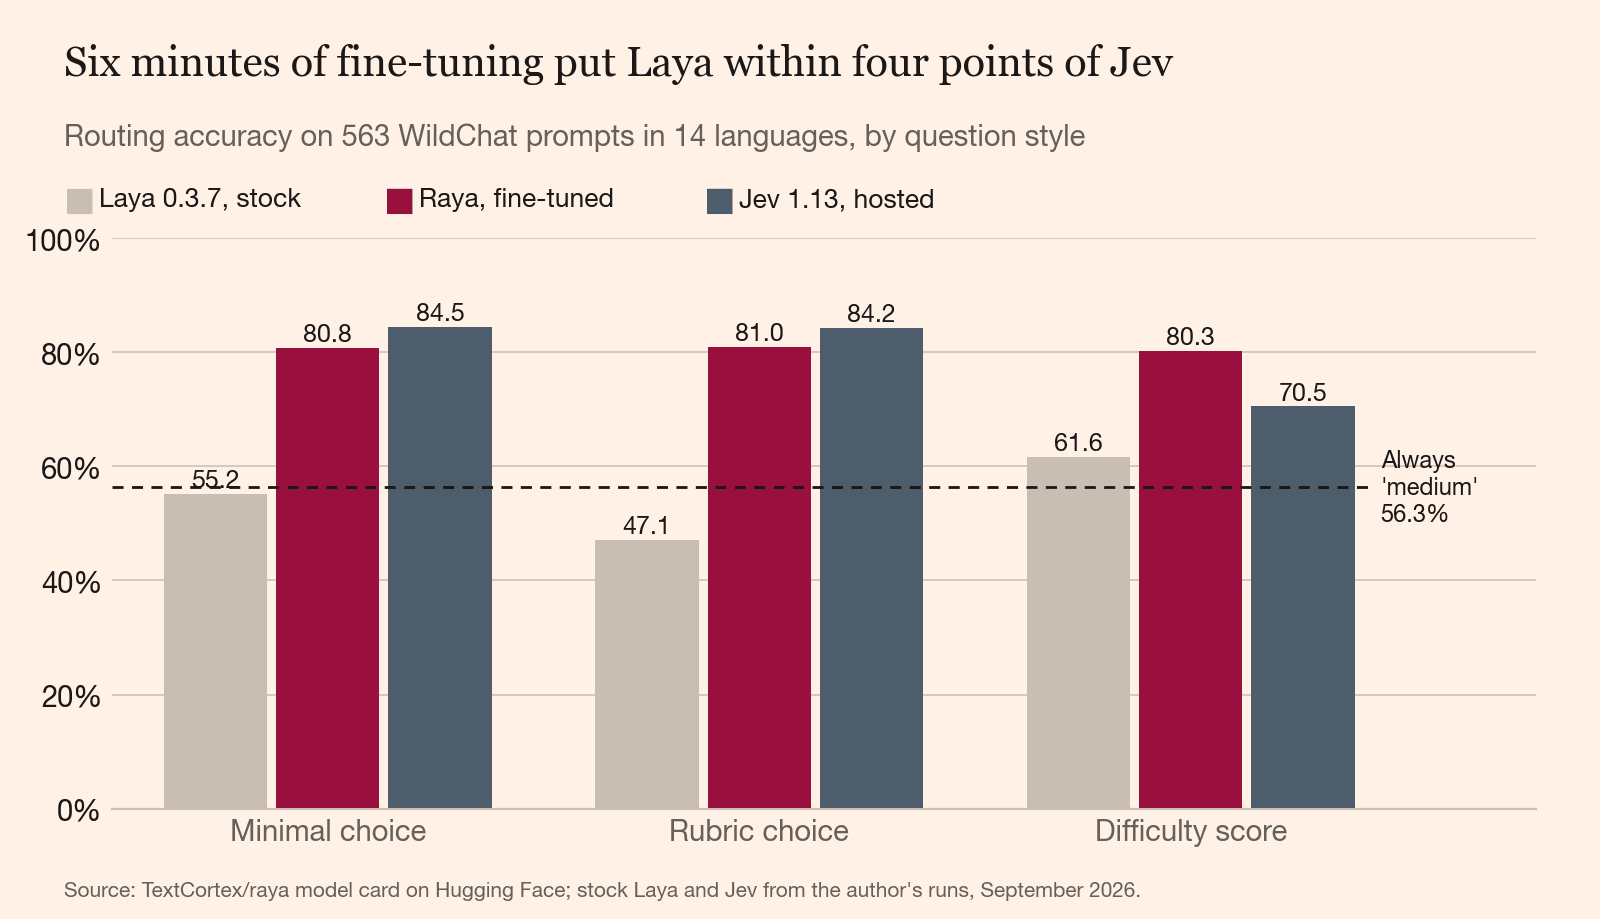
## Sześć minut na jednym GPU dało Layi od 25 do 34 punktów.
Trafność na benchmarku z 563 promptami z pierwszego posta. Liczby Rayi pochodzą z jej publicznej karty modelu.
Raya ma od 80 do 81% na wszystkich trzech stylach pytań. Na ocenie trudności
bije Jev o dziesięć punktów (80,3% wobec 70,5%, McNemar p < 0,001). Na dwóch
pytaniach wielokrotnego wyboru Jev nadal prowadzi o trzy do czterech punktów.
Przy tej wielkości próby ta różnica nie jest istotna statystycznie (p = 0,07 i
0,13), ale pojawia się w obu przypadkach i założyłbym się, że jest prawdziwa.
Teraz ustępstwo, i to duże. Raya uczyła się od tych samych dwóch anotatorów,
którzy napisali etykiety referencyjne. Jev nigdy ich nie widział. Część z 81%
Rayi to atut własnego boiska i nie potrafię powiedzieć, jak duża. Anotatorzy
zgadzają się ze sobą tylko w 78% przypadków, więc Raya doszła do sufitu tego, co
te etykiety potrafią zmierzyć.
Raya jest też najsłabsza tam, gdzie Jev jest najmocniejszy. Na minimalnym
pytaniu ma 67% po turecku wobec 82% Jev i 76% po portugalsku wobec 90%. Tak
jak Jev, wysyła do frontier tylko 7 z 21 promptów frontier.
## Klasyfikator z 300M parametrów nie ma czego szukać na GPU.
Karta modelu Rayi podaje 17 ms na GPU. Całe GPU na jeden mały forward pass na
prompt to dużo sprzętu, więc wyeksportowałem Rayę do [ONNX Runtime](https://onnxruntime.ai/) i sprawdziłem pięć wariantów na dwóch
CPU: Intel i9-13900, który ma instrukcje int8 VNNI, i AMD EPYC 7502P, który ich
nie ma.
| Plik | Rozmiar | Trafność | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
| --- | ---: | ---: | ---: | ---: |
| fp32 | 1,23 GB | 81,2% | 38 / 297 ms | 60 / 487 ms |
| int8 blokowy | 0,89 GB | **81,5%** | **34 / 282 ms** | 127 / 975 ms |
| int8 per tensor | 0,92 GB | 79,0% | 24 / 200 ms | nie nadaje się |
| referencja PyTorch | | 81,0% | 42 / 421 ms | 89 / 526 ms |
Najszybszy plik traci dwa i pół punktu trafności, co w routerze oznacza
prawdziwe prompty wysłane do złego modelu. Na EPYC int8 per tensor się
przepełniał, a trafność spadała do wartości od 54% do 80% w zależności od
ustawień.
Blokowy int8 na chipie z VNNI zachował każdy punkt trafności. To ten wdrażamy.
Szesnaście wątków było wolniejsze niż osiem na obu CPU, więc każdy pod dostaje
osiem.
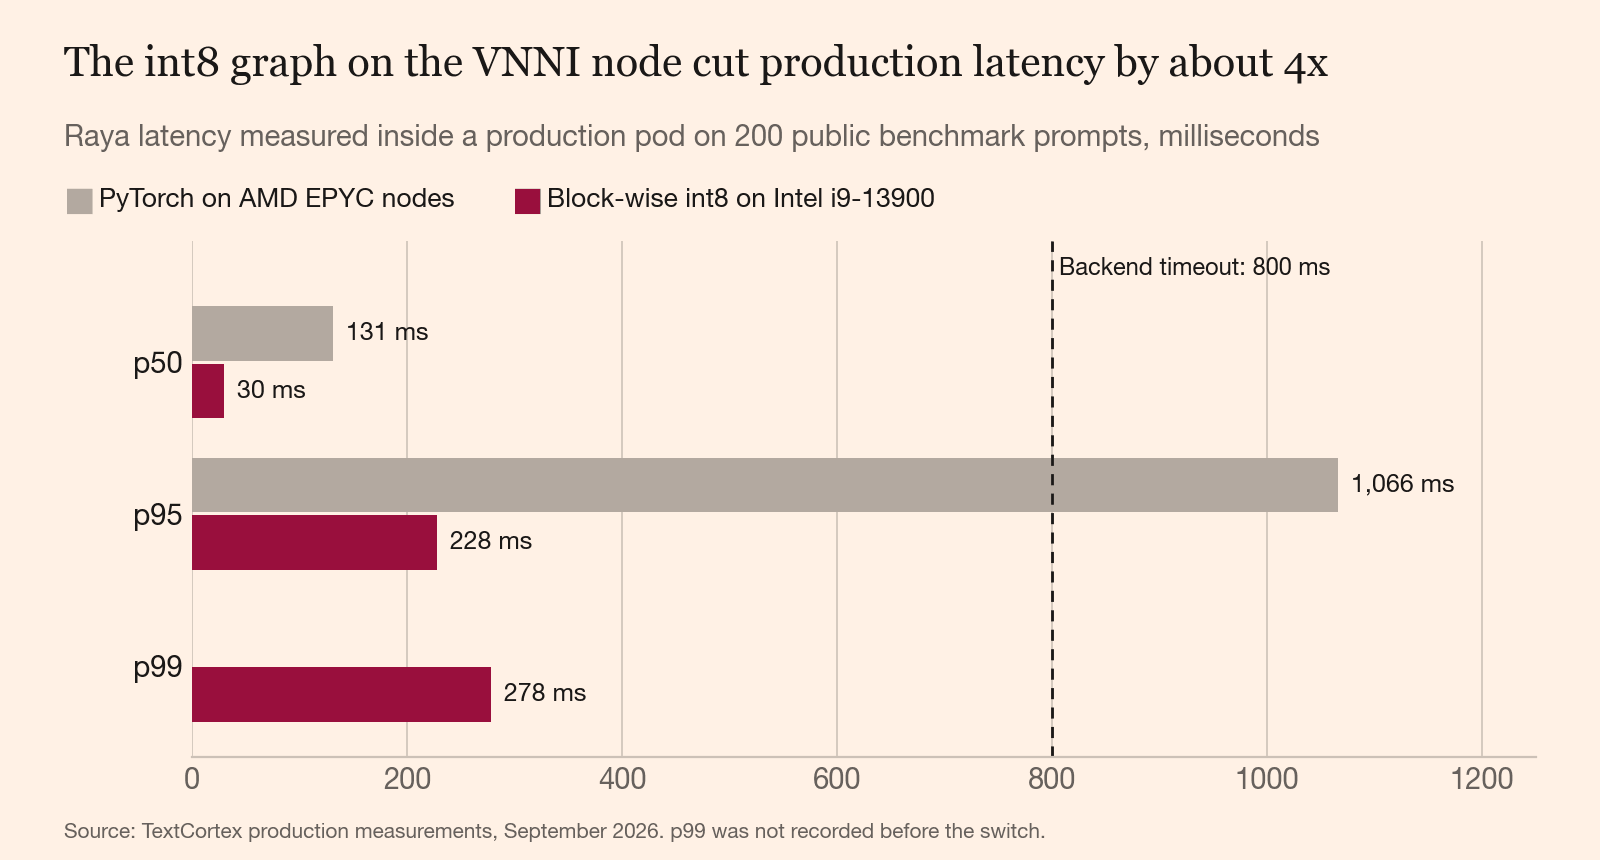
## Przejście na int8 na CPU z VNNI obcięło p95 z 1066 ms do 228 ms.
Zmierzone wewnątrz produkcyjnego poda na 200 publicznych promptach z benchmarku. Między tymi dwoma pomiarami zmienił się zarówno runtime, jak i CPU.
Pierwsze wdrożenie produkcyjne działało na PyTorch na naszych węzłach EPYC. Jego
p95 wynosiło 1066 ms, więcej niż 800 ms, które backend czeka, zanim da sobie
spokój z routerem. Ponad jedno żądanie na dwadzieścia skończyłoby się timeoutem.
Po zmianie, mierząc wewnątrz produkcyjnego poda: 30 ms p50, 228 ms p95, 278 ms
p99. Każdy pod obsługuje od 16 do 18 żądań na sekundę, wcześniej około 4. Obraz
zmalał z 4,0 GB do 1,0 GB. Trafność na benchmarku wynosi 81,5%, wobec 81,0% dla
oryginału w PyTorch.
Numeryka int8 zależy od CPU, więc obraz sprawdza sam siebie. Build weryfikuje
SHA-256 pliku modelu. Każdy pod odmawia startu na CPU bez VNNI i zanim przyjmie
ruch, porównuje swoje odpowiedzi z referencją w PyTorch.
## Serwer kosztuje 84 € miesięcznie i już był na rachunku.
Nasz klaster działa na zarządzanym Kubernetesie od [Cloudfleet](https://cloudfleet.ai/),
z serwerami dedykowanymi Hetzner jako węzłami.
Węzeł Rayi ma tę samą specyfikację co
[EX101](https://www.hetzner.com/dedicated-rootserver/ex101/) od Hetzner: i9-13900,
64 GB pamięci ECC, dwa dyski NVMe po 1,92 TB. Hetzner wycenia go na 84 €
miesięcznie plus 39 € opłaty instalacyjnej, bez VAT (wrzesień 2026). Cloudfleet
[pobiera opłatę za vCPU](https://cloudfleet.ai/pricing/) na dodatek, od 2,45 € do
7,25 € miesięcznie w zależności od planu.
Nie kupiliśmy nic dla Rayi. Węzeł obsługiwał inne obciążenia przy 22%
zarezerwowanego CPU. Z podami Rayi jest na 86%. Koszt routera to
niewykorzystana moc na maszynie, za którą i tak już płaciliśmy.
Sufit, jako szacunek: dwa produkcyjne pody obsługują około 32 żądania na sekundę,
czyli mniej więcej 83 miliony decyzji routingowych w 30-dniowym miesiącu.
Obciąż Rayę kosztem całego serwera, a wyjdzie około 1 € za milion decyzji przy
pełnym obciążeniu, bez VAT i opłaty Cloudfleet. Przy prawdziwym ruchu liczy się
stałe 84 €.
## Wszystko wisi na jednym serwerze.
Tylko jeden węzeł w naszym klastrze ma VNNI, więc oba produkcyjne pody są do
niego przypięte. Jeśli ten serwer padnie, pody zostaną w stanie pending, a Auto
wyśle każdy prompt do medium. To router stały z pierwszego posta. Czat działa
dalej, dopóki węzeł nie wróci.
Węzeł jest też pełny. Przy 86% rezerwacji nie ma miejsca na trzeci pod, więc
wyjście powyżej około 32 żądań na sekundę oznacza wynajęcie drugiego serwera z
VNNI. Przy ośmiu równoczesnych żądaniach na pod p95 rośnie do około 1,2 sekundy,
ponad timeout 800 ms, a nadmiar spada do medium. Dzisiejszy ruch w Auto jest
od tego daleko.
A w chwili, gdy to piszę, żadne żądanie klienta nie trafia do Rayi. Smoke test
poprawnie routuje wszystkie trzy tiery na stagingu i na produkcji. Zmiana w
backendzie, która ją wywołuje, jest jeszcze w review.
## Otwarty model, który dostroisz, bije otwarty model, który pobierzesz.
Bazowa Laya przegrała ze stałą. Sześć minut treningu na naszych własnych
etykietach zamknęło większość luki do modelu hostowanego, a serwer CPU za 84 €
zamknął lukę w latencji.
Jev nadal jest lepszy na pytaniach z wyborem. Nie ma też wdrożenia w UE.
Dla europejskiej firmy router, który jest o trzy punkty gorszy i działa w
Falkenstein, bije taki, który jest lepszy i działa gdzieś, dokąd nie możemy
wysłać promptu.
Raya jest publiczna na licencji Apache-2.0, z plikami ONNX, ich sumami
kontrolnymi i surowymi wynikami benchmarku na [jej karcie modelu](https://huggingface.co/TextCortex/raya).
Puść ją na własnych promptach przeciwko `return "medium"`. Jeśli na twoim ruchu
nie przebije tego o dziesięć punktów, daj mi znać, a to też opublikuję.