# As alternativas open source ao Jev não prestam, eis o benchmark
> Testei três routers de LLM com 563 prompts reais em 14 línguas. O Jev encaminhou bem 84%. Dois modelos abertos locais mal batem responder sempre "medium".
- Source: https://jays.fyi/pt/blog/alternativas-open-source-jev-benchmark
- Author: Jay Derinbogaz
- Published: 2026-09-23
- Language: pt
- Tags: ai, open-source, benchmarks
- Reading time: 8 min
- Machine translated: yes — original: https://jays.fyi/blog/local-llm-routers-lost-to-always-answering-medium
---
Qualquer produto de chat com um menu de modelos entrega aos utilizadores um trabalho de encaminhamento. Têm de adivinhar se a pergunta merece o modelo caro ou o barato, e a maioria das pessoas escolhe uma vez e nunca mais lhe toca. Por isso pagam a mais por "o que é o amor de adolescente?" e a menos por uma demonstração sobre amostras de Bernoulli.
Estamos a construir seleção automática de modelo na
[TextCortex](https://textcortex.com/) para que ninguém tenha de adivinhar. Um router lê o prompt e escolhe o tier mais barato que ainda o vai responder bem. A forma óbvia de construir um é um pequeno modelo aberto no seu próprio hardware: sem custo por chamada, cerca de 60 milissegundos por chamada, e o prompt nunca sai do edifício. Parti do princípio de que seria aí que íamos acabar.
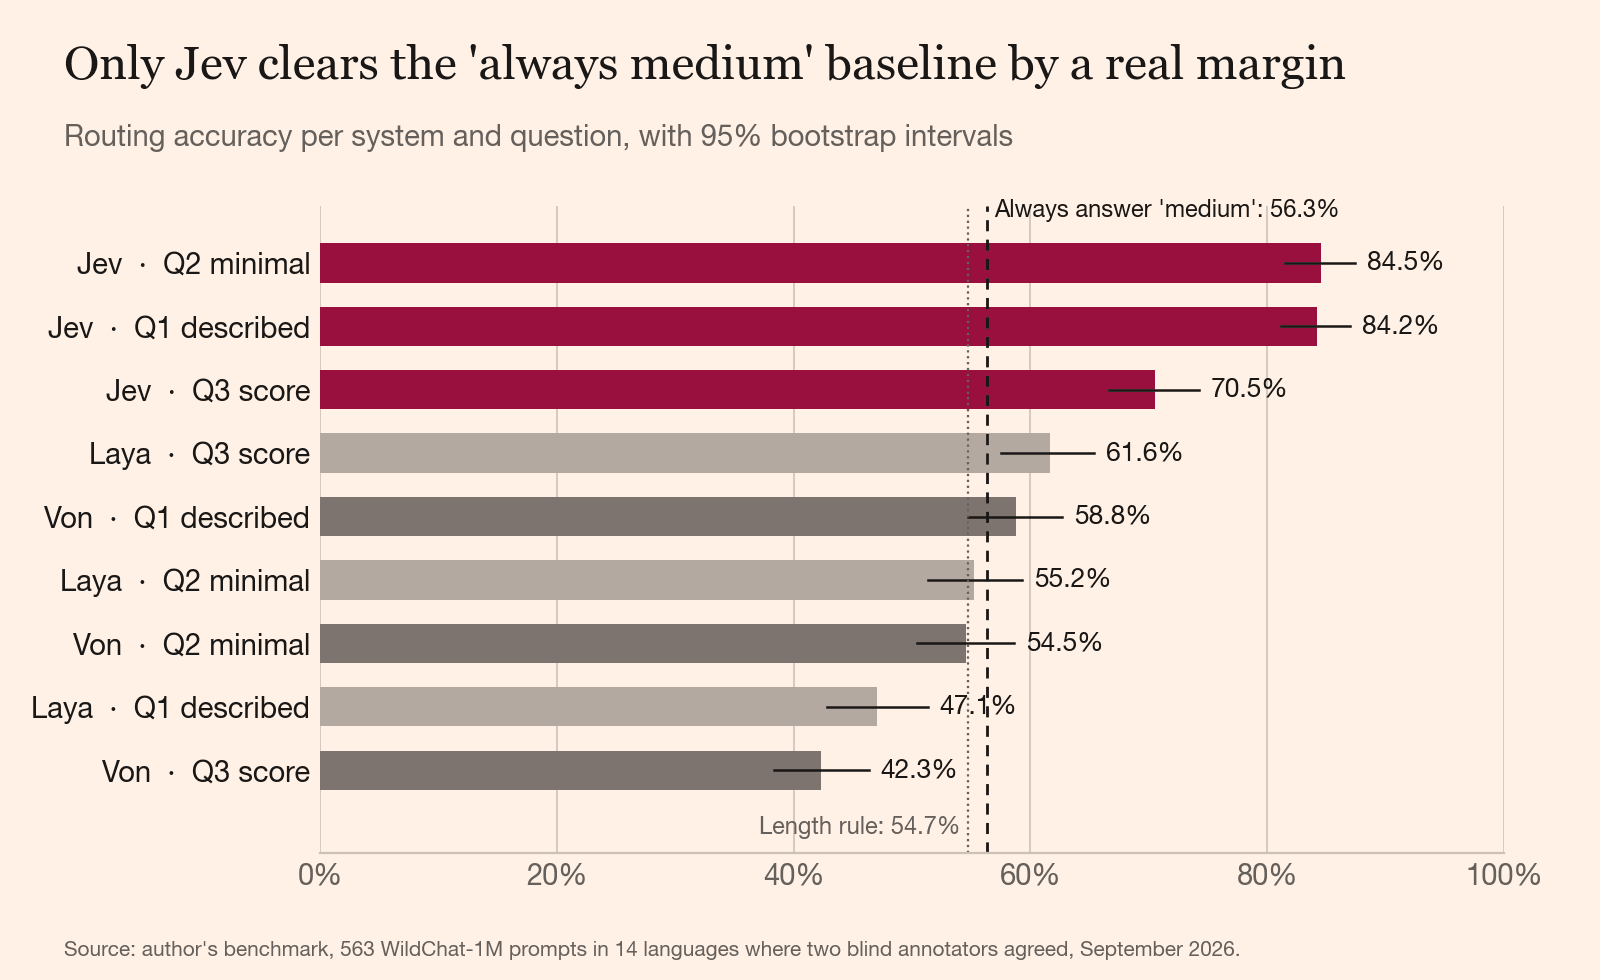
Por isso medi. Em 563 prompts reais de chatbot em 14 línguas, o modelo alojado Jev encaminhou **84,5%** deles para o tier certo. Laya e Von, modelos abertos no meu portátil, chegaram no máximo a 61,6% e 58,8%. Um router que responde "medium" a todos os prompts faz 56,3%. Chamemos-lhe o router constante. Quatro das seis execuções de Laya e Von perderam contra ele.
## Um router é uma pergunta de escolha múltipla feita antes de cada prompt.
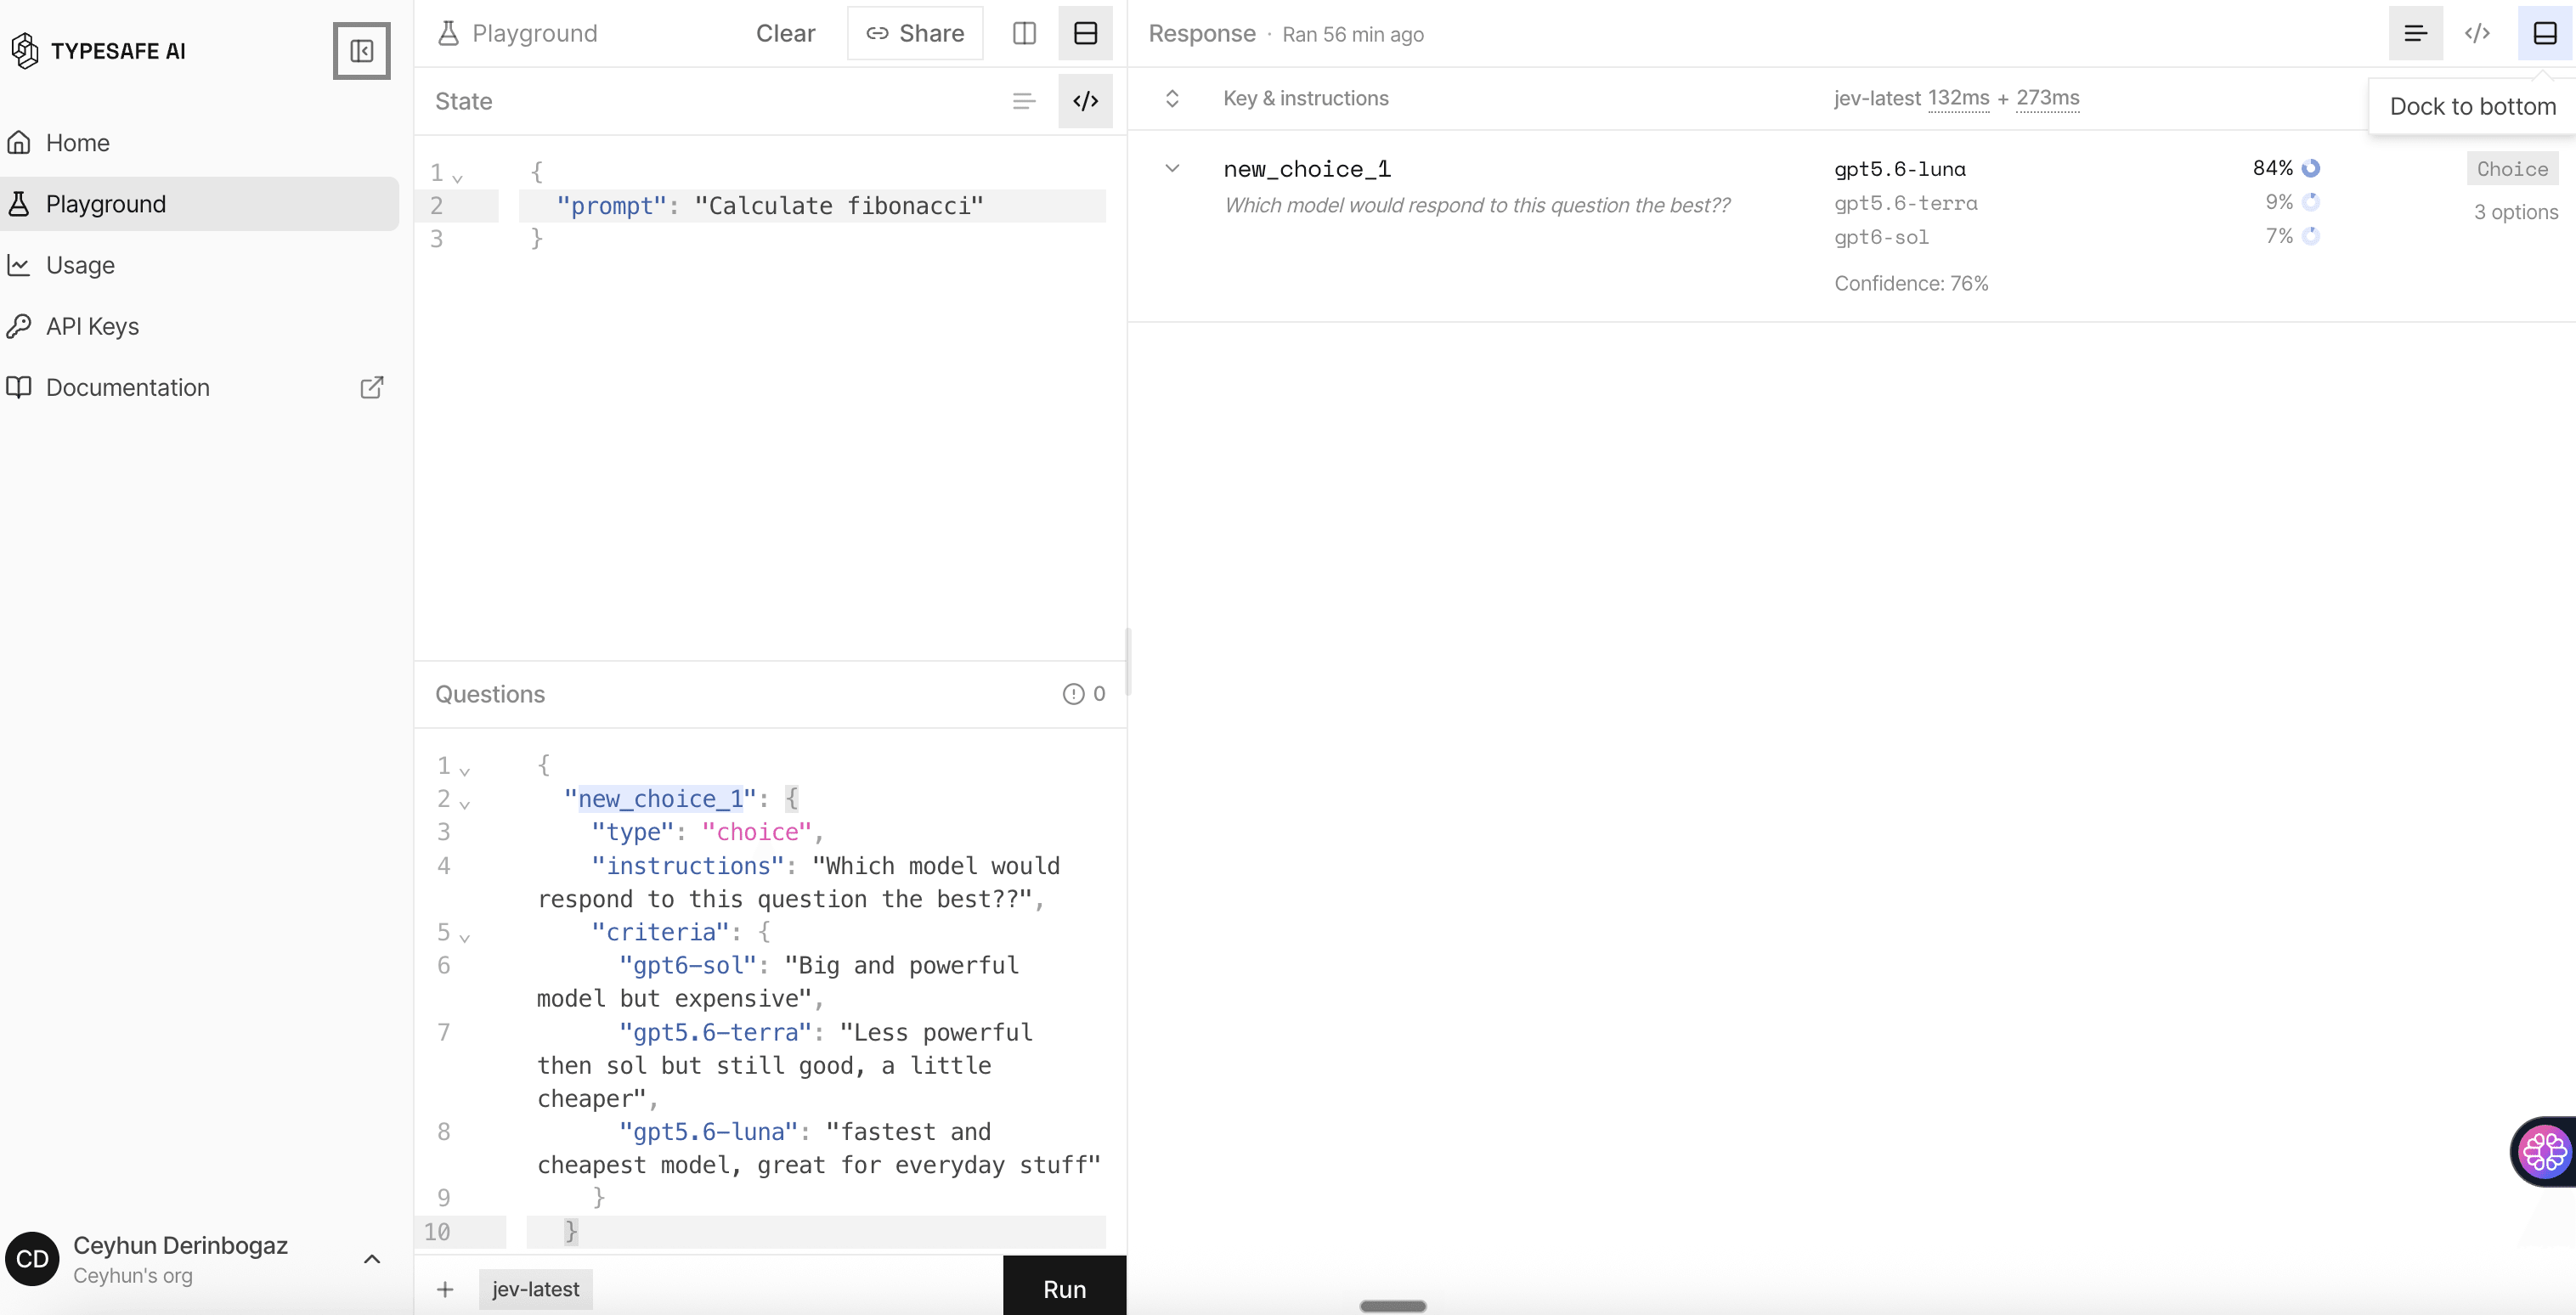
Os três sistemas falam a mesma API. Envia o prompt, mais uma pergunta com opções nomeadas e uma frase a descrever cada uma. Recebe de volta uma probabilidade por opção.
A minha primeira pergunta de encaminhamento no playground da Typesafe AI, com nomes de tier inventados. O benchmark usou uma redação nova e nomes de tier neutros.
"Calculate fibonacci" vai para o tier barato. Evidentemente. Testei primeiro os três routers com prompts desse género, e o Jev também ganhou essa ronda, mas os prompts que eu escrevo para um router são prompts cuja resposta já conheço. Isso não provou quase nada.
## Usei prompts reais, porque os meus eram fáceis demais.
Os prompts vêm do
[WildChat-1M](https://huggingface.co/datasets/allenai/WildChat-1M), um dataset público de conversas reais com chatbots (licença ODC-BY, com as tóxicas filtradas). Tirei 40 primeiras mensagens em cada uma destas línguas: inglês, alemão, francês, espanhol, italiano, português, neerlandês, polaco, turco, russo, árabe, chinês, japonês e coreano. Depois juntei 168 prompts mais longos ou mais técnicos, porque o tráfego real quase não tem prompts difíceis.
Dois anotadores cegos em modelos diferentes, Claude Opus e Claude Sonnet, classificaram os 728 prompts como small, medium ou frontier. Concordaram em 77,5% (κ de Cohen = 0,60). Fiquei com os 563 em que concordaram: 225 small, 317 medium, 21 frontier.
Cada sistema respondeu a três perguntas por prompt, 5.067 chamadas sem uma única falha grave:
- **Q1, descrita.** "Escolhe o tier mais barato que ainda o vai responder bem", com tarefas de exemplo para cada tier.
- **Q2, mínima.** "Pedidos simples", "moderadamente complexos" e "muito difíceis".
- **Q3, pontuação.** Uma pontuação de dificuldade em três níveis, mapeada para tiers.
## Dois dos três routers mal batem uma constante.
Precisão nos 563 prompts com acordo, com intervalos bootstrap de 95%. A regra de comprimento manda prompts com menos de 60 caracteres para small, com menos de 1.500 para medium e o resto para frontier.
O Jev fez 84,5% com descrições de duas e três palavras e 84,2% com a rubrica completa. Essa diferença é ruído, por isso ninguém na minha equipa tem de se tornar prompt engineer para escrever uma pergunta de encaminhamento.
A melhor execução do Laya bateu o router constante por 5,3 pontos. A do Von bateu-o por 2,5, com um intervalo de 95% (55% a 63%) que ainda contém a constante. Uma regra que olha apenas para o comprimento do prompt fez 54,7%, acima de duas execuções locais e a menos de um ponto de outras duas.
Um router que perde contra `return "medium"` é um gerador de números aleatórios com um download de modelo incluído.
## Os modelos locais apostam em "medium" e chamam-lhe uma decisão.
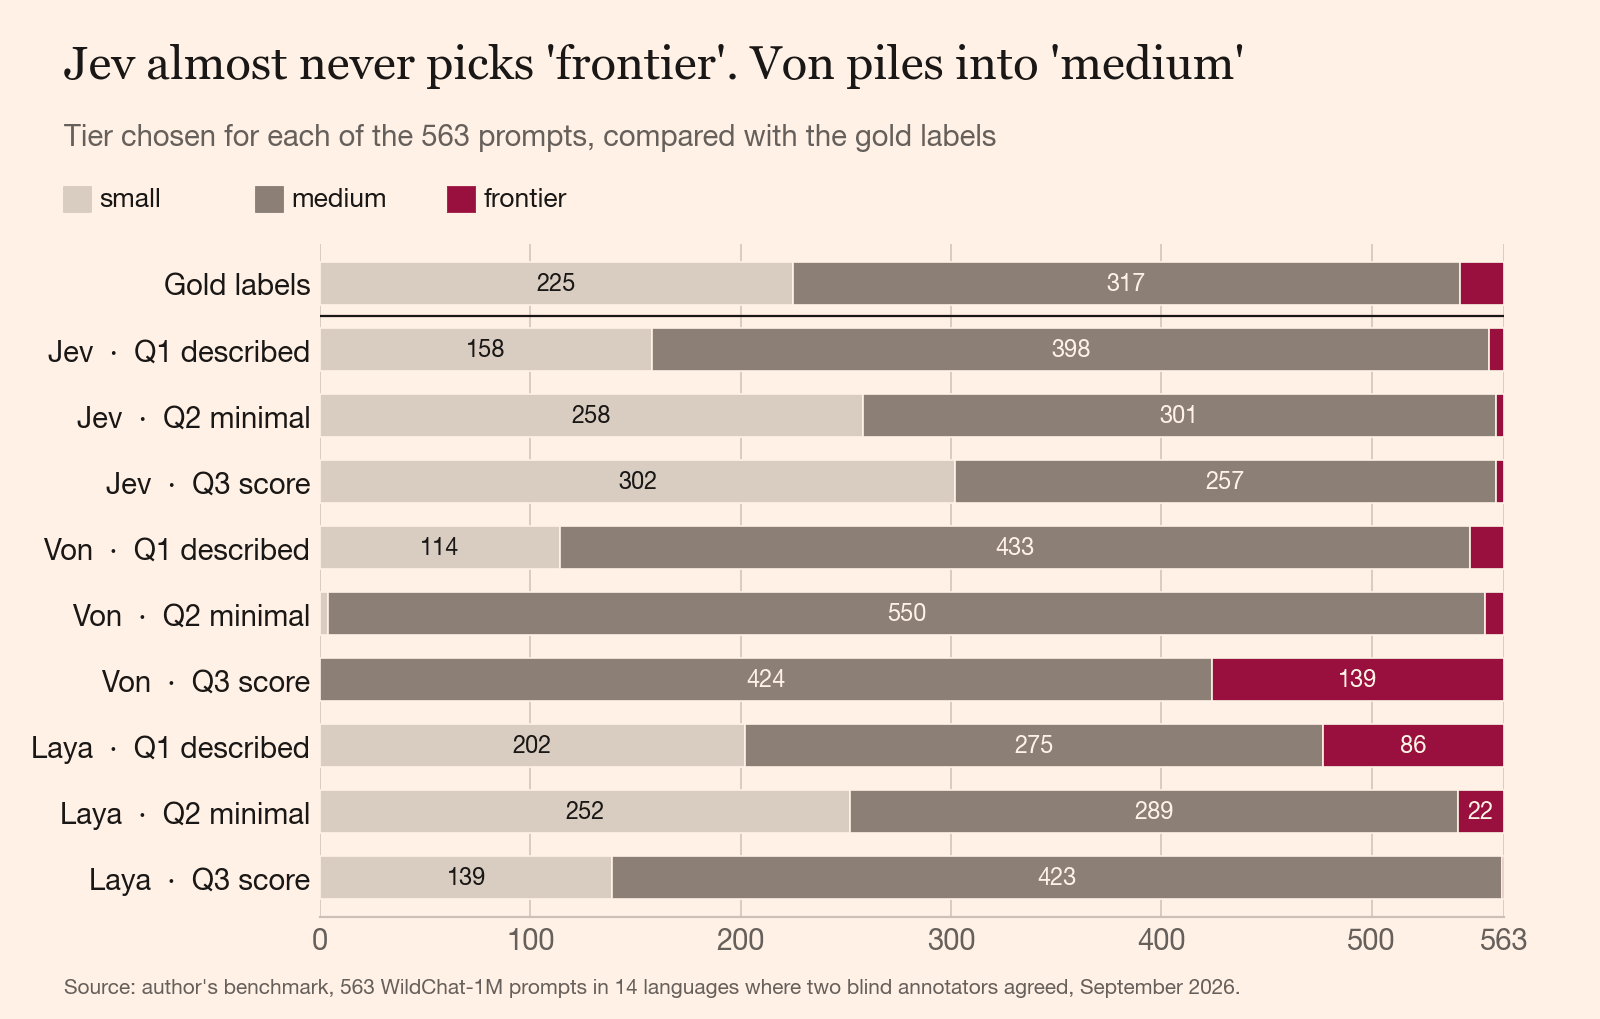
O que cada execução respondeu, face às etiquetas de referência.
O Von na Q2 respondeu "medium" 550 vezes em 563. Na Q3 nunca disse small uma única vez, e mandou 139 prompts para frontier quando lá pertencem 21. O Laya na Q1 mandou 86 prompts para frontier e acertou em seis. O seu checkpoint multilingue tratou 1.329 das suas 1.689 chamadas, e mesmo assim fez 29% em francês.
## Von e Laya gastam a mais em até 55% dos prompts.
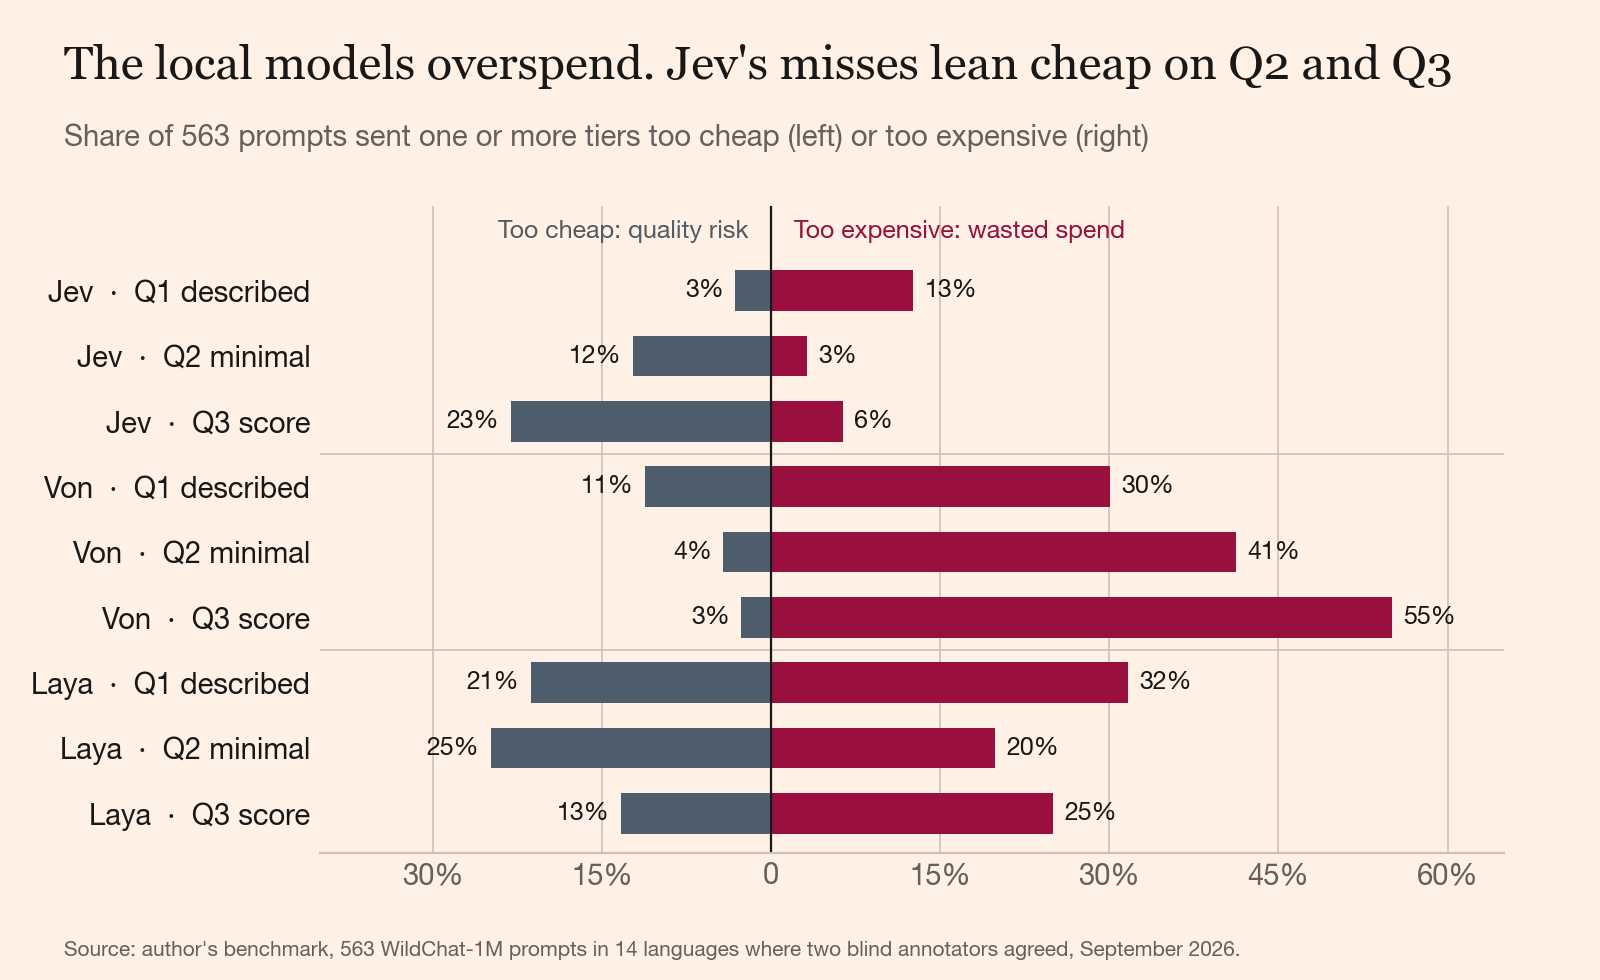
Proporção de prompts enviados para um tier mais barato (esquerda) ou mais caro (direita) do que a etiqueta de referência.
O Von na Q3 manda 55% de todos os prompts para um tier mais caro do que precisam. Esse router aumenta a fatura que existe para cortar.
O Jev inclina-se para o outro lado na Q2 e na Q3, e isso é pior por cada erro. Uma resposta cara demais custa a diferença de preço. Uma resposta fraca demais custa um utilizador que fez uma pergunta difícil e recebeu uma resposta errada cheia de confiança. Na Q2, 51 dos erros do Jev foram prompts medium enviados para small. Na Q3, 113.
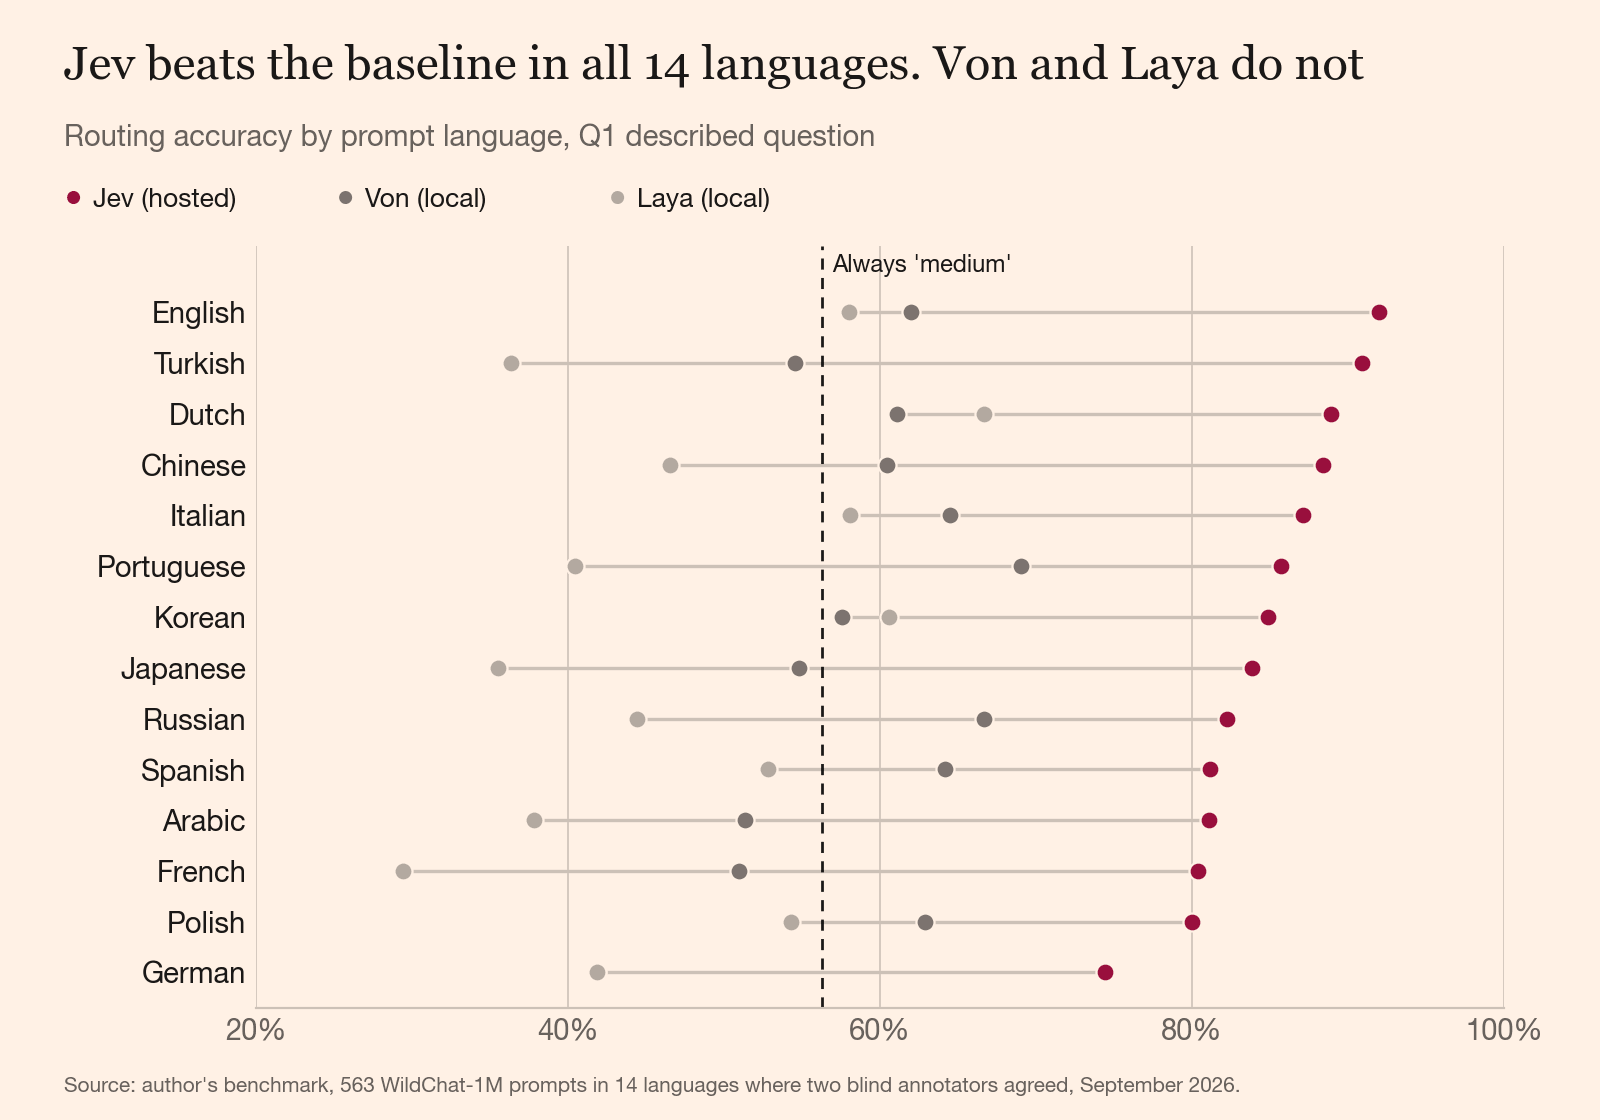
## A língua quase não mexeu com o Jev e mexeu muito com todos os outros.
Precisão por língua na Q1. Com 31 a 53 prompts por língua, um único prompt mexe uma pontuação em 2 a 3 pontos.
O Jev ficou entre 74% (alemão) e 92% (inglês), e fez 84% tanto em alfabetos latinos como não latinos. O Von foi de 42% em alemão a 69% em português, o Laya de 29% em francês a 67% em neerlandês. Um router que acerta no francês menos de um terço das vezes não pode chegar perto de clientes franceses.
## O Jev falha os prompts que mais importam.
Dos 21 prompts frontier, o Jev na Q1 mandou seis para frontier e 15 para medium. Na Q2 mandou três. É aí que encaminhar para o barato faz mais estragos: um problema de estatística em turco, regras de decisão de investimento em alemão, um esquema sobre distribuição quântica de chaves. Vinte e um é uma amostra pequena, e sou eu o primeiro a dizê-lo.
As probabilidades do Jev ajudam. Se escalar para frontier sempre que o Jev lhe der mais de 0,2, a Q1 apanha 14 dos 21 e só escala 18 de 563 prompts. A Q2 com o mesmo limiar apanha sete. Escolhi 0,2 depois de ver estes dados, por isso trate-o como ponto de partida para afinar.
Há mais três coisas que jogam contra o título:
- **84% favorece o Jev.** O conjunto de referência são os prompts em que os dois anotadores concordaram, os mais fáceis. Os anotadores só concordaram em 77,5% das vezes no conjunto completo, por isso cerca de 80% é um teto realista para qualquer router com estes tiers.
- **Estas são etiquetas de julgamento.** Dois modelos adivinharam de que tier um prompt precisa. Ninguém verificou o que cada tier produziu de facto.
- **O Jev é mais lento.** A latência mediana foi de cerca de 330 ms por chamada a partir do meu portátil, sobretudo rede, contra 56 a 170 ms dos modelos locais.
## O router barato é o caro.
No fim não pudemos pôr o Jev em produção: não tem deployment na UE. Por isso fiz fine-tuning do Laya com as nossas próprias etiquetas, e esse router
[corre agora num único servidor CPU na Alemanha](/pt/blog/router-llm-servidor-hetzner-sem-gpu).
Um router local não custa nada por chamada. Se mandar 41% do seu tráfego para um tier de que não precisa, como o Von fez na Q2, paga isso em cada uma dessas chamadas, e esse custo não aparece em nenhum model card que eu tenha lido.
Por isso, conte. Pegue no WildChat ou nos seus próprios logs, etiquete umas centenas de prompts com dois anotadores, deite fora aqueles em que discordam e ponha o seu router contra
`return "medium"`. Se não passar essa linha por dez pontos, não tem um router.
O melhor teste, que vamos correr a seguir, é baseado em resultados: passar tráfego real por todos os tiers, registar o tier mais barato cuja resposta foi boa o suficiente e avaliar o router contra isso. Se os 84% do Jev se desfizerem aí, também publico isso.