# Train je eigen Jev: een 11x sneller System-1-model met bijna gratis hosting
> De trainingscode van Raya is openbaar. Twee LLM's labelen je data, een encoder van 300M leert het in minuten, ONNX serveert het op een CPU. Getest op een laptop.
- Source: https://jays.fyi/nl/blog/raya-trainingsrecept-open-source
- Author: Jay Derinbogaz
- Published: 2026-09-27
- Language: nl
- Tags: ai, open-source, tooling
- Reading time: 7 min
- Machine translated: yes — original: https://jays.fyi/blog/train-your-own-system-1-model
---
Vrijdag schreef ik over
[Raya](/nl/blog/llm-router-op-hetzner-cpu-server), de router die
voor elke prompt in TextCortex een modeltier kiest. Hij scoort 81% op onze
benchmark van 563 prompts en antwoordt in 30 ms op een CPU in Falkenstein. Hoe je er zelf een bouwt,
stond niet in die post.
Het recept is nu openbaar, in de
[`training/`-map](https://huggingface.co/TextCortex/raya/blob/main/training/README.md)
van Raya's Hugging Face-repo, onder Apache-2.0. Beschrijf de beslissing, laat twee
LLM's je data labelen, train, evalueer, exporteer naar ONNX. Vanochtend draaide ik elke stap behalve
het labelen op een Apple M4-laptop om te controleren dat het werkt zoals het
beschreven staat. De training duurde **34 seconden** en de export 24.
Dit is de stelling. Als je een frontier-model bij elke request dezelfde vraag stuurt met een vaste
set antwoorden, dan hoort die vraag thuis in een kleine classifier
die je zelf bezit. Gebruik het grote model één keer, als leraar, en stop met het per
beslissing te betalen.
## Je betaalt een LLM om een miljoen keer dezelfde vraag te beantwoorden.
De README noemt het resultaat een **System-1-model**, en die term houd ik aan. Een
System-1-model beantwoordt één goed afgebakende vraag over een input, direct,
met kansen waar je een drempel op kunt zetten. *Welk model moet deze prompt beantwoorden?*
*Heeft dit ticket een mens nodig?* *Welk team is eigenaar van dit verzoek?* Het is een
gefinetunede [Laya](https://huggingface.co/convaiinnovations/laya)-encoder van
ongeveer 300 miljoen parameters, het draait in tientallen milliseconden, en er hangen geen
kosten per call aan.
Hiervoor een chatmodel aanroepen is een advocaat inhuren om je post te sorteren: een rekening
per envelop, wachten op elke envelop, en een kopie van je post op de server
van iemand anders. Voor een Europees bedrijf
kan dat laatste het gesprek beëindigen: we bouwden Raya omdat de router die we
wilden geen EU-deployment had.
Het wachten is makkelijk te meten. Raya antwoordt in productie in 30 ms op p50. Toen
ik Jev mat, de gehoste router die Raya vervangt, kostte die ongeveer 350 ms per call:
Raya is ruwweg **11 keer sneller**. Het draait op een Hetzner-server van €84 per maand
die al op onze rekening stond, dus de hosting kostte ons niets nieuws.
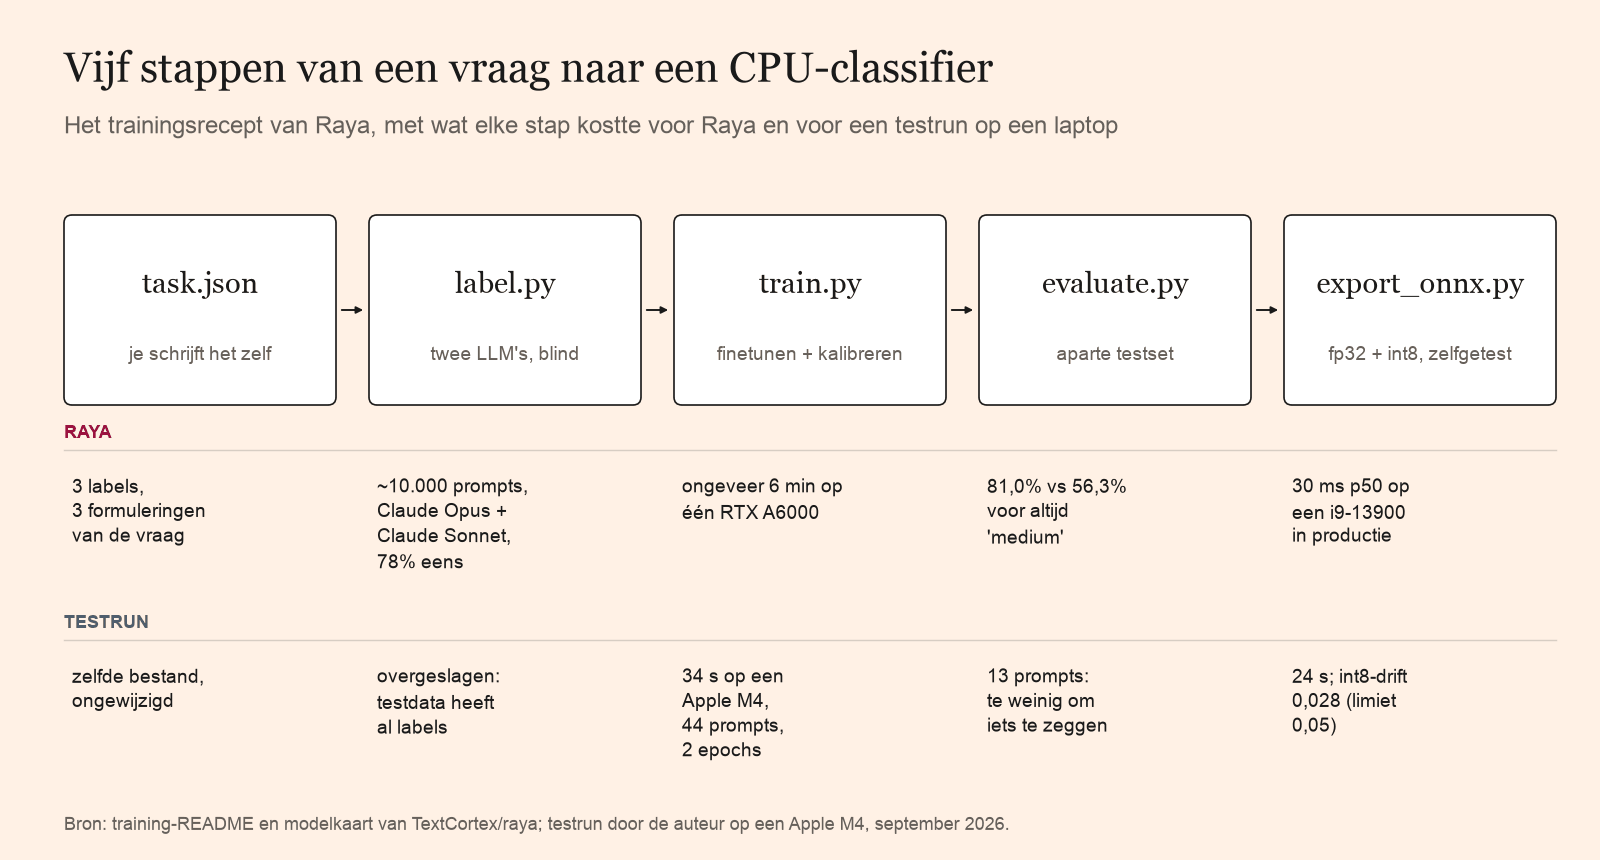
## Het hele recept is vier scripts en een JSON-bestand.
De cijfers van Raya komen uit de training-README en de vorige post. De testrun gebruikte de 44 demoprompts die met de code meekomen.
```bash
python label.py --task my_task.json --data prompts.jsonl --out labelled.jsonl \
--annotator --annotator @https://api.anthropic.com/v1/#ANTHROPIC_API_KEY
python train.py --task my_task.json --data labelled.jsonl --out my-model
python evaluate.py --model my-model --task my_task.json --data test.jsonl
python export_onnx.py --model my-model --task my_task.json --data test.jsonl
```
Voor dat allemaal schrijf je `task.json`: de labels, en een of meer
*formuleringen* van de vraag. Raya heeft er drie: "Route this prompt to a model", een
langere versie met een rubric per tier, en een moeilijkheidsscore van 1 tot 3. Het
model traint op elke formulering met de opties elke epoch opnieuw geschud, zodat het
de beslissing zelf leert. Het bestand bevat ook de rubric die de annotators
lezen, en
[die van Raya zelf](https://huggingface.co/TextCortex/raya/blob/main/training/task.example.json)
wordt meegeleverd als sjabloon.
## Twee annotators die het oneens zijn, zijn meer waard dan één die zeker klinkt.
Je hebt waarschijnlijk inputs en geen labels. `label.py` stuurt elke input naar twee of
meer LLM's, los van elkaar, met dezelfde rubric. Raya's ruwweg 10.000 labels kwamen
van Claude Opus en Claude Sonnet, blind voor elkaar. Elk OpenAI-compatibel
endpoint werkt, ook dat van Anthropic, OpenRouter, vLLM en Ollama.
Waar de annotators het eens zijn, krijg je een schoon label. Waar ze het oneens zijn, houdt de rij
beide stemmen en leert `train.py` een target van 50/50. Dat is het eerlijke
antwoord voor een prompt waarover twee sterke modellen verdeeld zijn. Daar een hard label forceren
leert het model een muntworp alsof het een feit is.
Het script print ook hoe vaak de annotators het eens waren. **Schrijf dat getal
op.** Het is ruwweg het plafond van wat je model tegen deze labels kan scoren.
Voor Raya was het 78%. Als je annotators het in 75% van de gevallen eens zijn en je
model scoort 90%, dan heeft het de gewoontes van één annotator geleerd, en de oplossing is een
strakkere rubric.
Qua volume zegt de README 1.000 tot 5.000 echte inputs voor een eerste model, in
de talen die je echt bedient. Laat de klassen ongebalanceerd; `train.py`
weegt zeldzame labels zelf zwaarder. Houd een testset apart
waar nooit iets op traint of valideert.
## De GPU is het goedkope deel.
Raya trainde in ongeveer zes minuten op één RTX A6000 van 48 GB. Op mijn M4 draaide het twee epochs over de 40
trainingsrijen van de testdata in 22 seconden, 34 inclusief het laden van het model.
Het bevriest de token-embeddingtabel om geheugen te sparen, kiest de beste epoch op
validatie, en fit daarna per vraag een temperatuur zodat een kans van 0,9
ongeveer negen van de tien keer klopt. Die kalibratie is wat je later op een
drempel laat handelen, zoals een prompt pas boven 0,6 naar de frontier-tier sturen.
Het standaard startpunt is Laya's meertalige mmBERT-base. Geef
`--base TextCortex/raya` mee om Raya in plaats daarvan aan te passen aan je eigen routeringsverkeer.
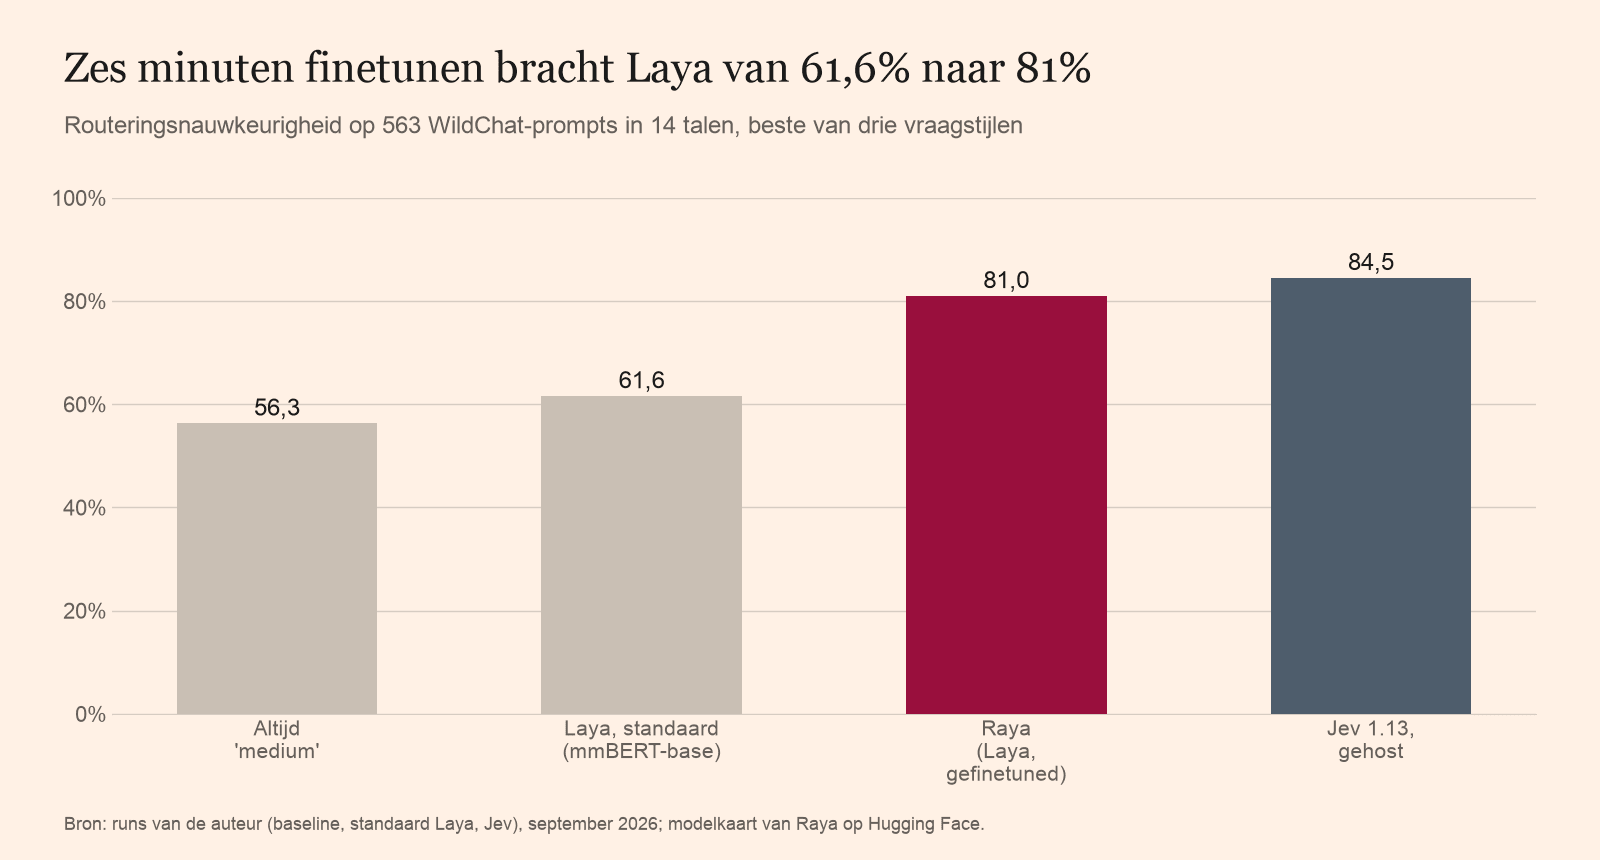
Beste van drie vraagstijlen op de benchmark met 563 prompts uit de eerste post.
Zes minuten GPU-tijd brachten Laya van 61,6% naar 81%, drie en een half punt
onder Jev. Je middag gaat op aan de labels.
## De testdata bewijst dat de leidingen werken en verder niets.
De map bevat 44 handgeschreven routeringsprompts voor training en 13 voor
testen. De README belooft vijf minuten. Training en export duurden samen minder dan
een minuut, de installatie niet meegerekend, op de vastgepinde versies. De voorbeeldaanroep uit de README routeerde "Prove that √2 is irrational."
naar `frontier_model` met 0,52.
`evaluate.py` gaf het testmodel daarna 46,2% op de korte formulering, 84,6%
op de formulering met rubric en 69,2% op de moeilijkheidsscore. De korte formulering
stuurde 12 van de 13 prompts naar medium. Met dertien prompts kun je die
getallen niet van ruis onderscheiden, en 44 trainingsrijen is, in de woorden van de README, "far too
small to train a useful model".
Het nuttige wat `evaluate.py` deed, was eerst deze regel printen:
```text
13 rows with a gold label; always answering 'small_model' scores 38.5%
```
Dat is de constante baseline. In de
[eerste benchmark](/nl/blog/open-source-jev-alternatieven-benchmark)
verloor standaard Laya van `return "medium"` op twee van zijn drie vraagstijlen.
Elke evaluatie zou moeten openen met de score van het model dat niets doet.
## Exporteer één keer en meet dan op de CPU die je echt gaat huren.
`export_onnx.py` schrijft een fp32-bestand en een blockwise int8-bestand, en controleert
daarna beide tegen PyTorch op je testdata. De export faalt als er ook maar één keuze verandert
of als kansen meer dan 0,001 afwijken voor fp32 of 0,05 voor int8. Mijn
testmodel kwam uit op 0,00000 en 0,02790.
Welk bestand je uitrolt, hangt af van het silicium. Zoals de
[vorige post](/nl/blog/llm-router-op-hetzner-cpu-server) mat,
hield blockwise int8 de nauwkeurigheid van Raya intact en was het het snelst op een i9-13900 met VNNI-
instructies, maar duurde het meer dan twee keer zo lang als fp32 op een EPYC 7502P zonder die instructies.
Meet op je eigen hardware voordat je kiest.
## Huur het grote model één keer en stop dan met het per beslissing te betalen.
De frontier-modelindustrie rekent per call, dus elke call lijkt een klus
voor een frontier-model. Elke call die kiest uit een vaste lijst antwoorden is een
classificatie, gefactureerd als redeneerwerk. Zodra de labels geschreven zijn, is de LLM een dure manier om tot een oordeel te komen dat een encoder van 300M
in 30 ms bereikt op hardware waar je al voor betaalt.
Er is een grens die ik je verschuldigd ben. Raya's trainingsdata is niet gepubliceerd, dus met deze map kun je
je eigen Raya bouwen, maar de onze niet reproduceren. En Raya
leerde van dezelfde twee annotators die de benchmarklabels schreven, en dat
flatteert zijn 81%.
Meet het dus op je eigen verkeer. Draai `evaluate.py` op een testset die je model
nooit heeft gezien. Als het de constante baseline niet ruim verslaat,
maak dan eerst de rubric strakker voordat je iets anders aanraakt. Als het recept faalt op jouw
beslissing, stuur me de getallen en ik publiceer ze.