# Open-source alternatieven voor Jev deugen niet, hier is de benchmark
> Ik testte drie LLM-routers op 563 echte prompts in 14 talen. Jev routeerde 84% correct. Twee lokale open modellen deden amper beter dan altijd "medium".
- Source: https://jays.fyi/nl/blog/open-source-jev-alternatieven-benchmark
- Author: Jay Derinbogaz
- Published: 2026-09-23
- Language: nl
- Tags: ai, open-source, benchmarks
- Reading time: 7 min
- Machine translated: yes — original: https://jays.fyi/blog/local-llm-routers-lost-to-always-answering-medium
---
Elk chatproduct met een modelkeuzemenu schuift zijn gebruikers een routeringsklus
toe. Ze moeten raden of hun vraag het dure model verdient of het goedkope, en de
meeste mensen kiezen één keer en raken het daarna nooit meer aan. Dus betalen ze
te veel voor "wat is kalverliefde?" en te weinig voor een bewijs over
Bernoulli-steekproeven.
We bouwen bij [TextCortex](https://textcortex.com/) automatische modelselectie,
zodat niemand meer hoeft te raden. Een router leest de prompt en kiest de
goedkoopste tier die hem nog goed beantwoordt. De voor de hand liggende manier om
er een te bouwen is een klein open model op je eigen hardware: geen kosten per
call, ongeveer 60 milliseconden per call, en de prompt verlaat het gebouw nooit.
Ik ging ervan uit dat we daar zouden uitkomen.
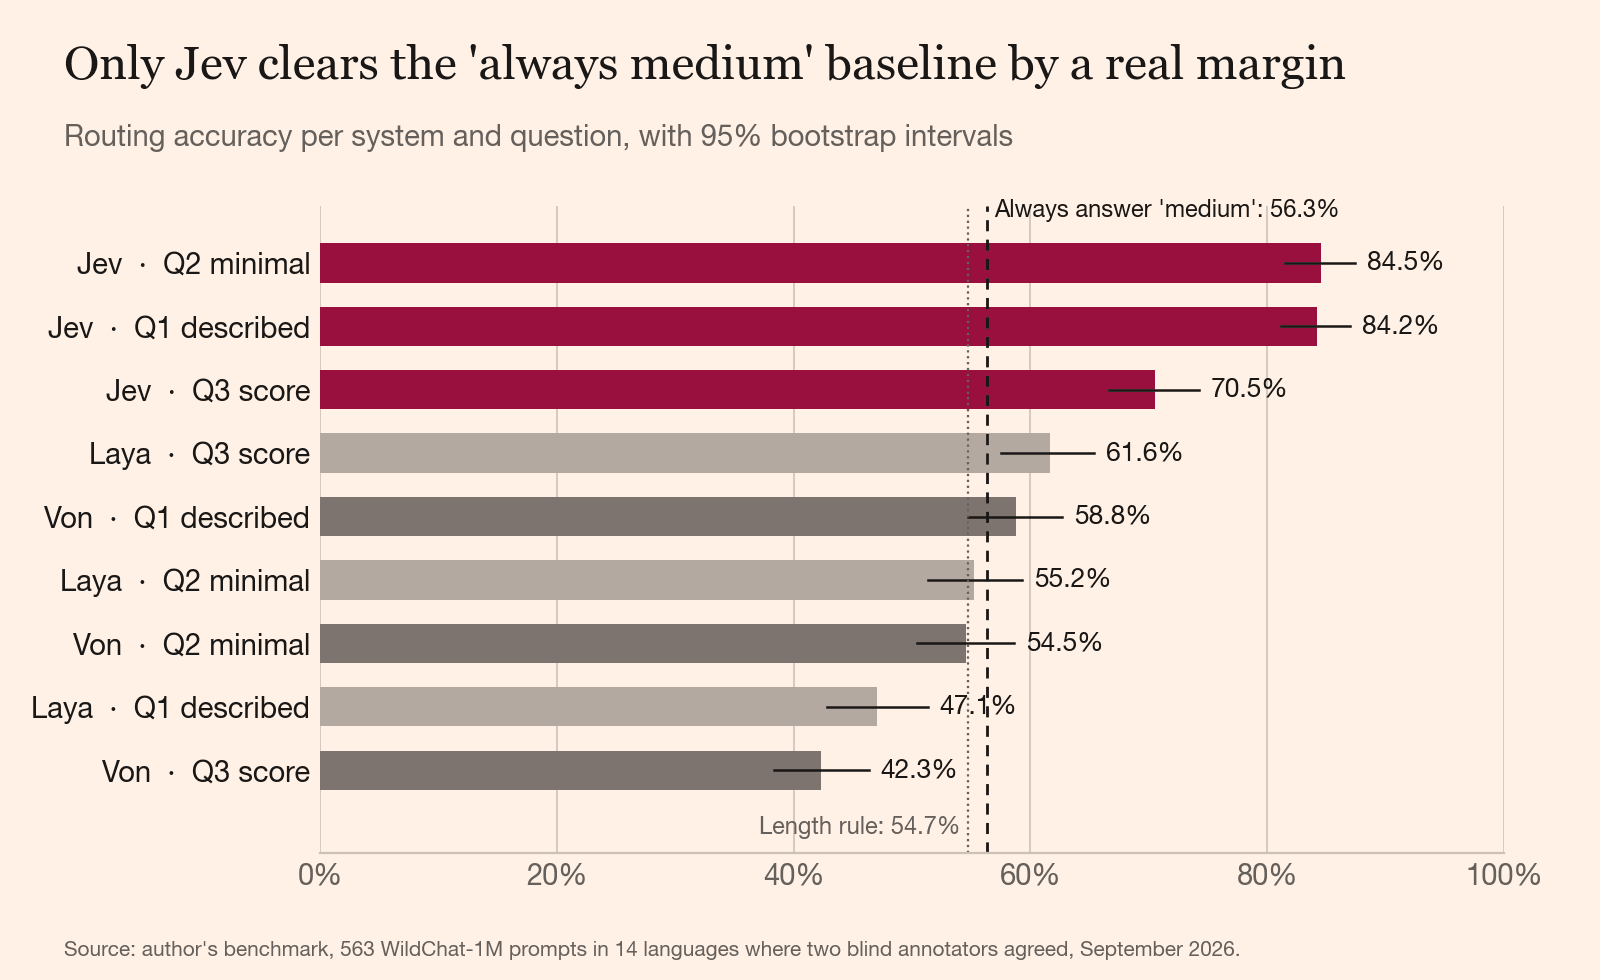
Dus heb ik het gemeten. Op 563 echte chatbotprompts in 14 talen routeerde het
gehoste model Jev er **84,5%** naar de juiste tier. Laya en Von, open modellen op
mijn laptop, kwamen maximaal uit op 61,6% en 58,8%. Een router die op elke prompt
"medium" antwoordt, scoort 56,3%. Noem dat de constante router. Vier van de zes
runs van Laya en Von verloren ervan.
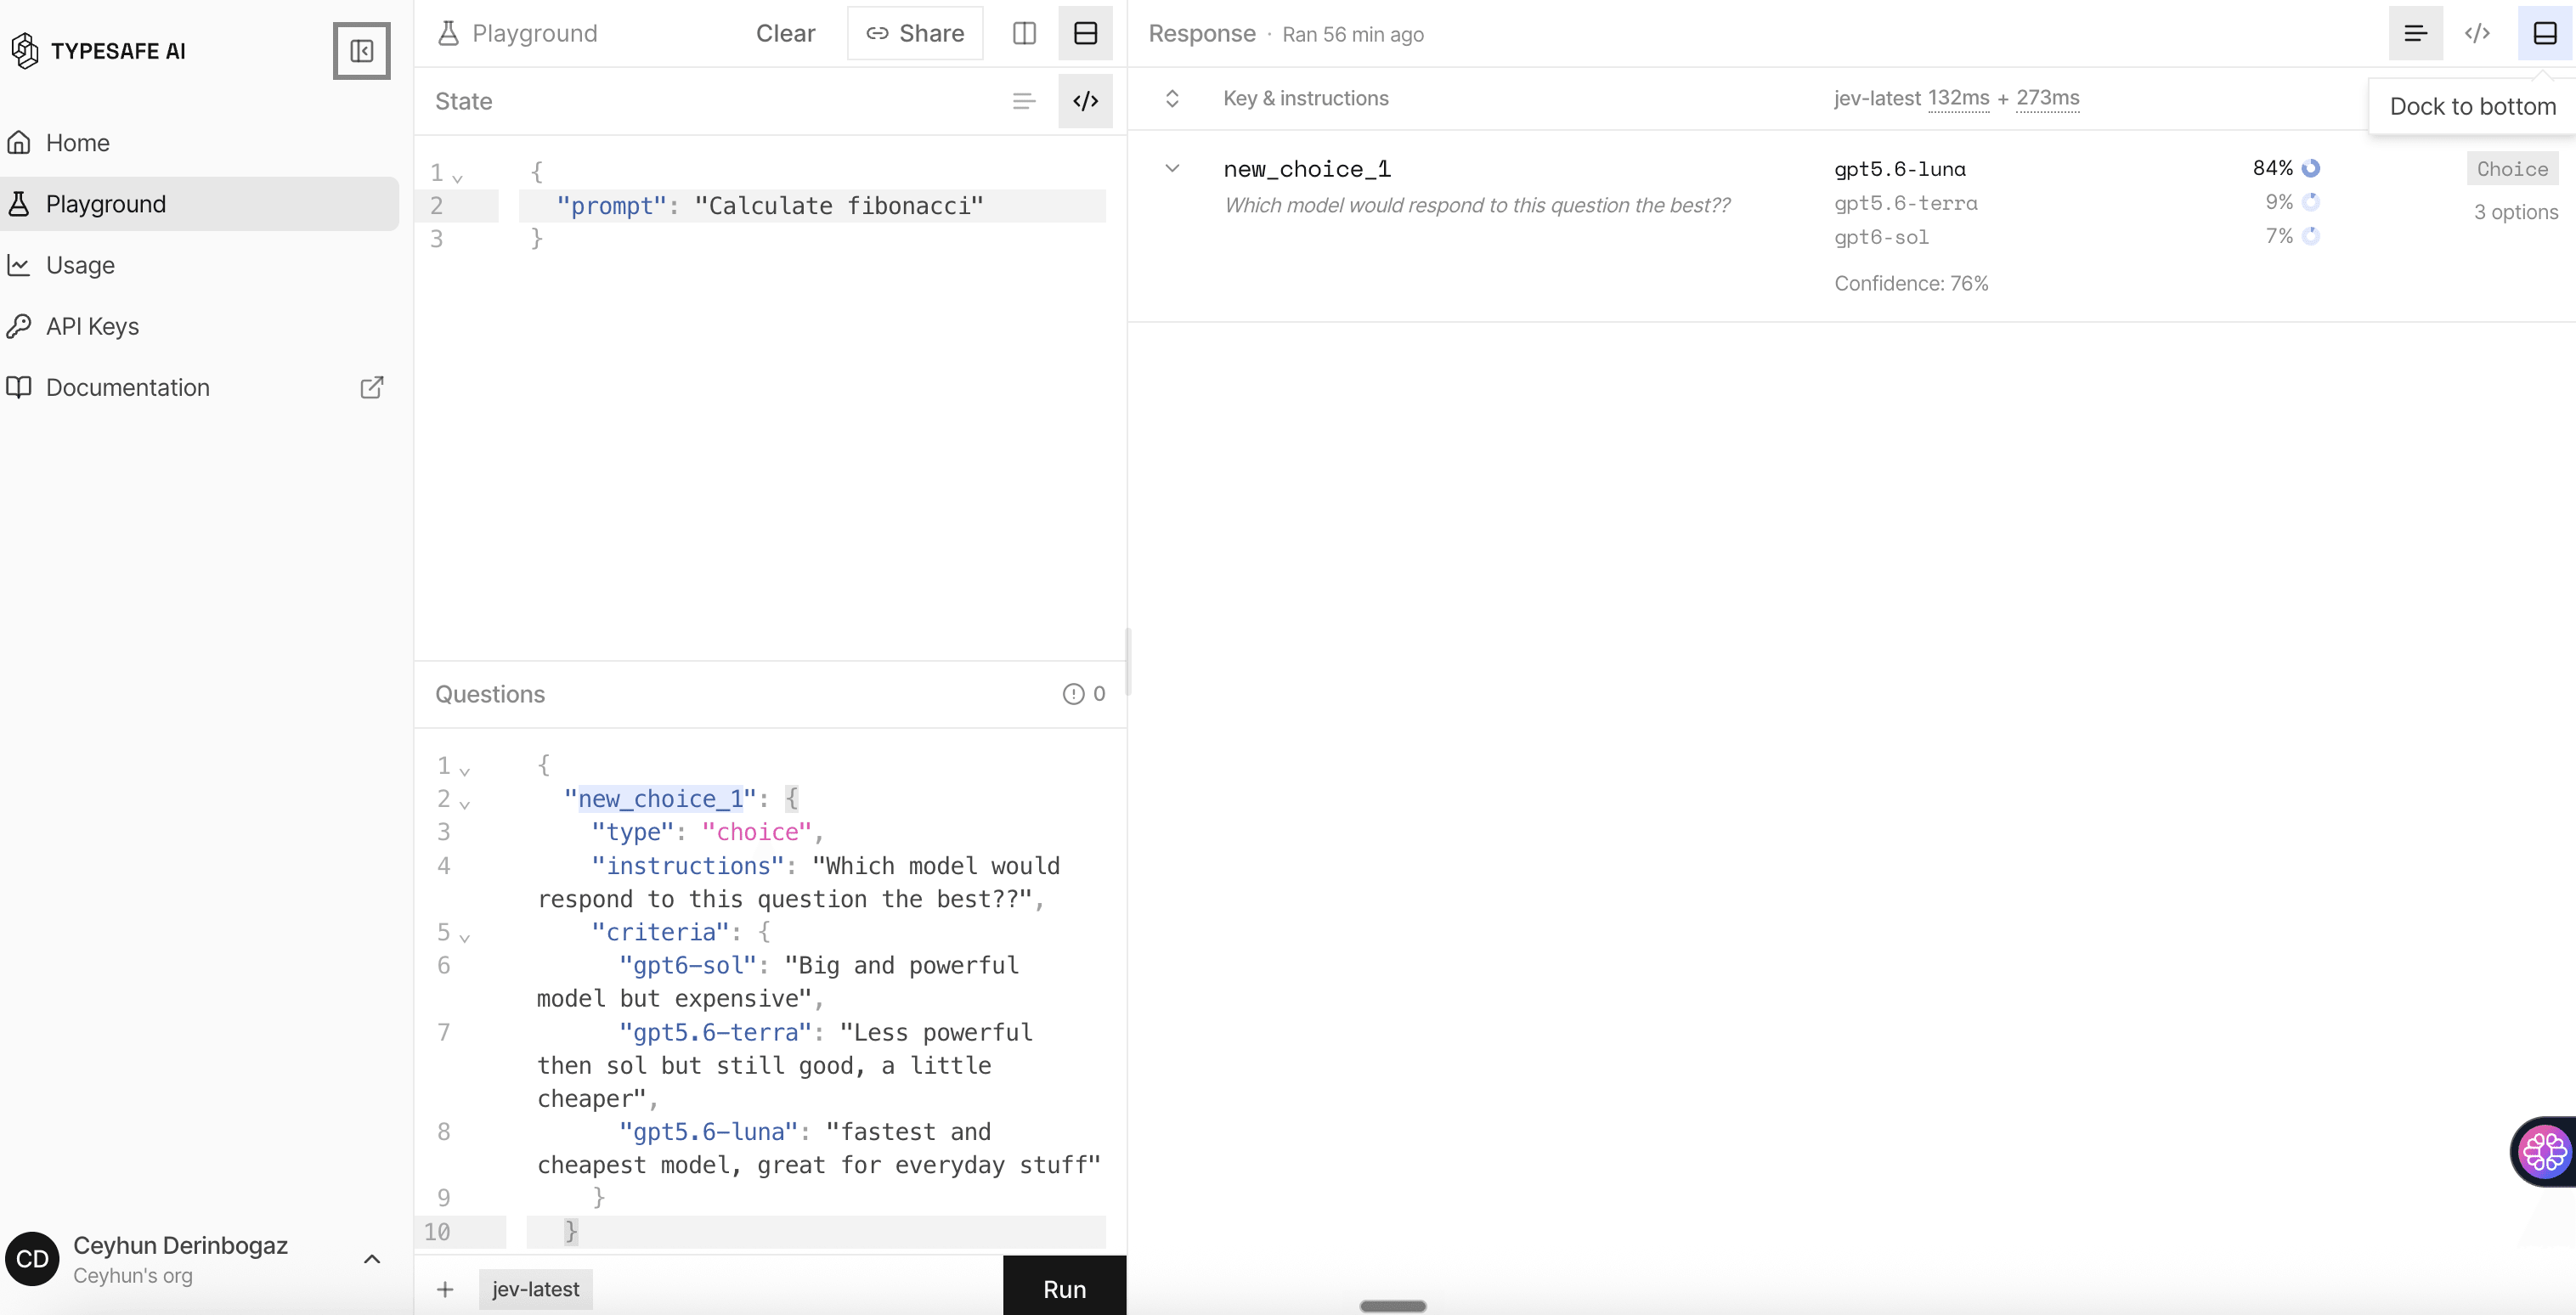
## Een router is één meerkeuzevraag die vóór elke prompt wordt gesteld.
Alle drie de systemen spreken dezelfde API. Je stuurt de prompt, plus een vraag
met benoemde opties en een zin die elke optie beschrijft. Je krijgt per optie een
kans terug.
Mijn eerste routeringsvraag in de Typesafe AI-playground, met verzonnen tiernamen. De benchmark gebruikte nieuwe formuleringen en neutrale tiernamen.
"Calculate fibonacci" gaat naar de goedkope tier. Uiteraard. Ik testte alle drie
de routers eerst op zulke prompts, en ook die ronde won Jev, maar de prompts die
ik voor een router schrijf zijn prompts waarvan ik het antwoord al ken. Het
bewees bijna niets.
## Ik gebruikte echte prompts, omdat de mijne te makkelijk waren.
De prompts komen uit
[WildChat-1M](https://huggingface.co/datasets/allenai/WildChat-1M), een publieke
dataset van echte chatbotgesprekken (ODC-BY-licentie, toxische gesprekken eruit
gefilterd). Ik nam 40 eerste berichten in elk van het Engels, Duits, Frans,
Spaans, Italiaans, Portugees, Nederlands, Pools, Turks, Russisch, Arabisch,
Chinees, Japans en Koreaans, en voegde daar 168 langere of technischere prompts
aan toe, omdat echt verkeer bijna geen moeilijke bevat.
Twee blinde annotators op verschillende modellen, Claude Opus en Claude Sonnet,
labelden alle 728 prompts als small, medium of frontier. Ze waren het eens over
77,5% (Cohens κ = 0,60). Ik hield de 563 over waarover ze het eens waren: 225
small, 317 medium, 21 frontier.
Elk systeem beantwoordde drie vragen per prompt, 5.067 calls zonder één harde
fout:
- **Q1, beschreven.** "Kies de goedkoopste tier die hem nog goed beantwoordt",
met voorbeeldtaken per tier.
- **Q2, minimaal.** "Eenvoudige", "matig complexe" en "zeer moeilijke verzoeken".
- **Q3, score.** Een moeilijkheidsscore met drie niveaus, omgezet naar tiers.
## Twee van de drie routers verslaan een constante maar net.
Nauwkeurigheid op de 563 prompts waarover de annotators het eens waren, met 95%-bootstrapintervallen. De lengteregel stuurt prompts onder 60 tekens naar small, onder 1.500 naar medium en de rest naar frontier.
Jev scoorde 84,5% met beschrijvingen van twee en drie woorden en 84,2% met de
volledige rubric. Dat verschil is ruis, dus niemand in mijn team hoeft
prompt engineer te worden om een routeringsvraag te schrijven.
Laya's beste run versloeg de constante router met 5,3 punten. Die van Von met
2,5, met een 95%-interval (55% tot 63%) waar de constante nog steeds in valt. Een
regel die alleen naar de lengte van de prompt kijkt, scoorde 54,7%, boven twee
lokale runs en binnen een punt van nog twee.
Een router die verliest van `return "medium"` is een randomgenerator met een
modeldownload erbij.
## De lokale modellen gokken "medium" en noemen dat een beslissing.
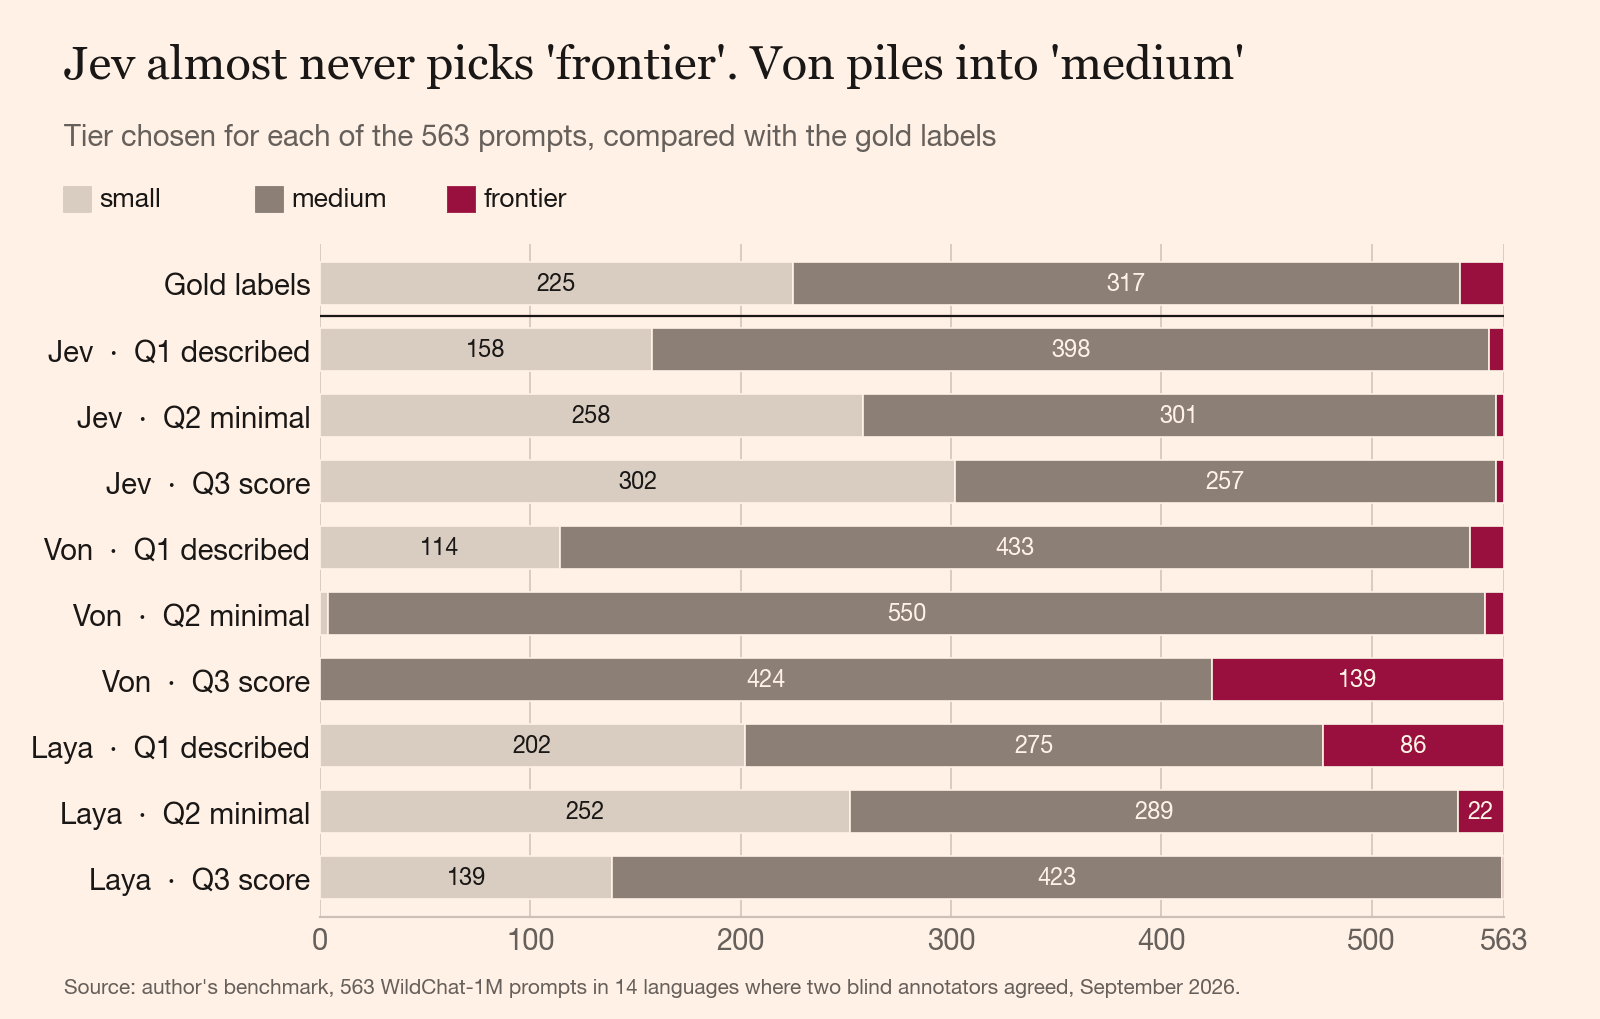
Wat elke run antwoordde, afgezet tegen de gouden labels.
Von antwoordde op Q2 550 van de 563 keer "medium". Op Q3 zei hij niet één keer
small, en stuurde hij 139 prompts naar frontier terwijl er 21 thuishoren. Laya
stuurde op Q1 86 prompts naar frontier en had er zes goed. Zijn meertalige
checkpoint verwerkte 1.329 van zijn 1.689 calls, en toch scoorde hij 29% op
Frans.
## Von en Laya geven op tot 55% van de prompts te veel uit.
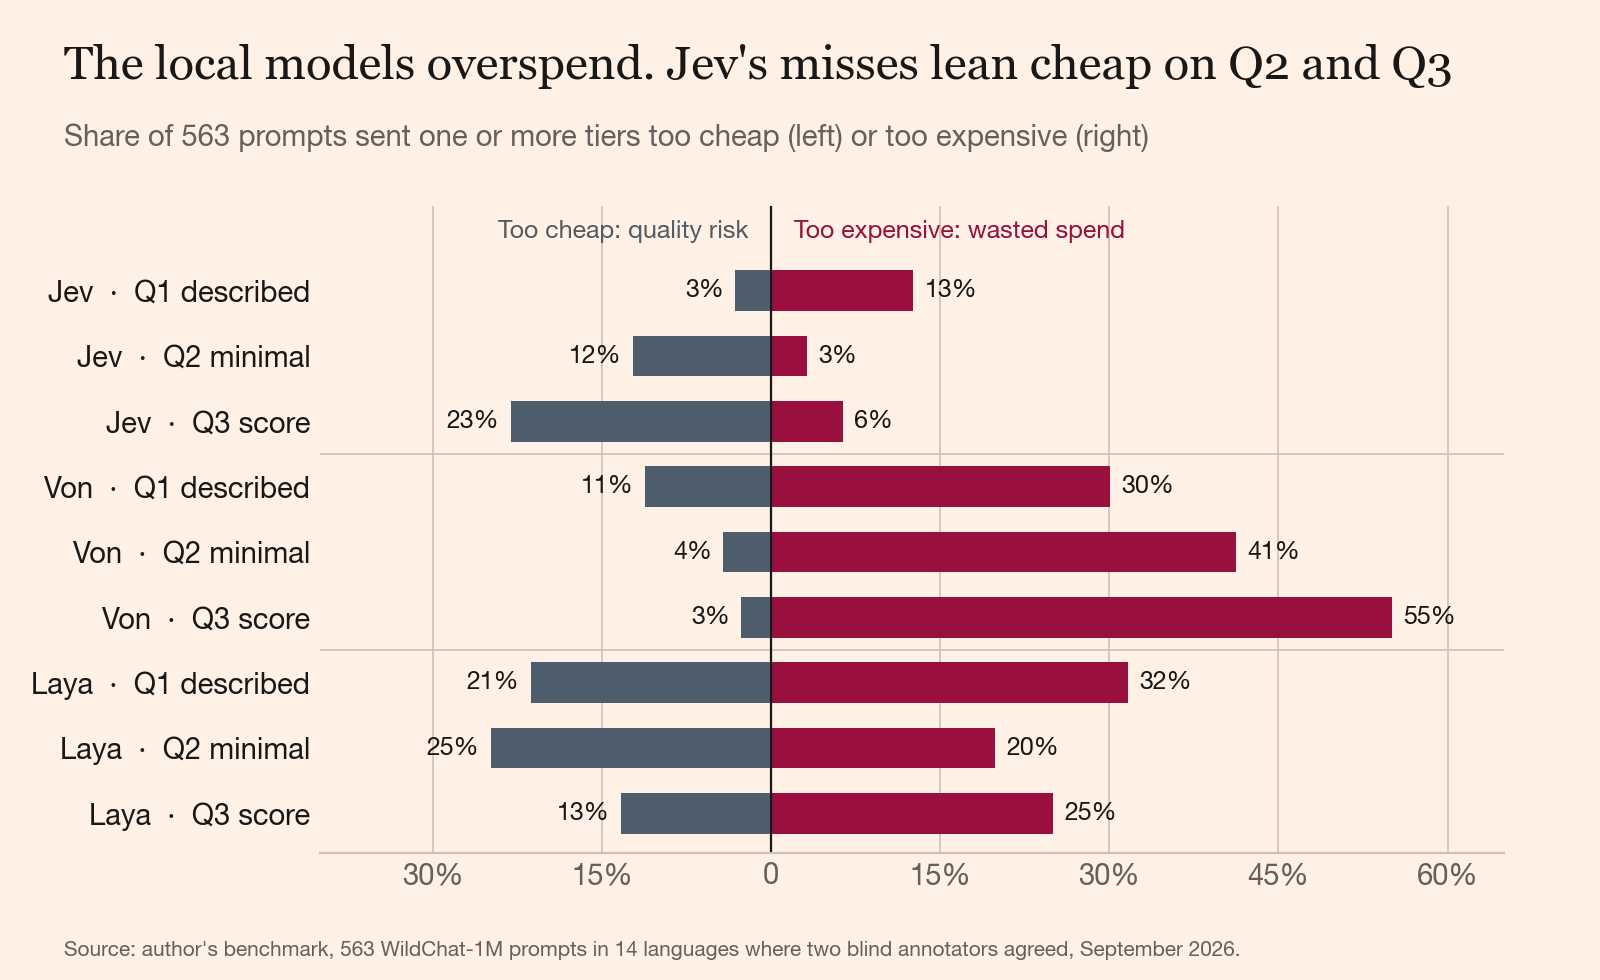
Aandeel prompts dat goedkoper (links) of duurder (rechts) werd gerouteerd dan het gouden label.
Von stuurt op Q3 55% van alle prompts naar een duurdere tier dan ze nodig hebben.
Die router verhoogt de rekening die hij juist moet verlagen.
Jev helt op Q2 en Q3 de andere kant op, en dat is per fout erger. Een te duur
antwoord kost het prijsverschil. Een te zwak antwoord kost je een gebruiker die
een moeilijke vraag stelde en een zelfverzekerd fout antwoord kreeg. Op Q2 waren
51 van Jevs missers mediumprompts die naar small gingen. Op Q3 waren het er 113.
## Taal maakte voor Jev nauwelijks uit en voor de rest des te meer.
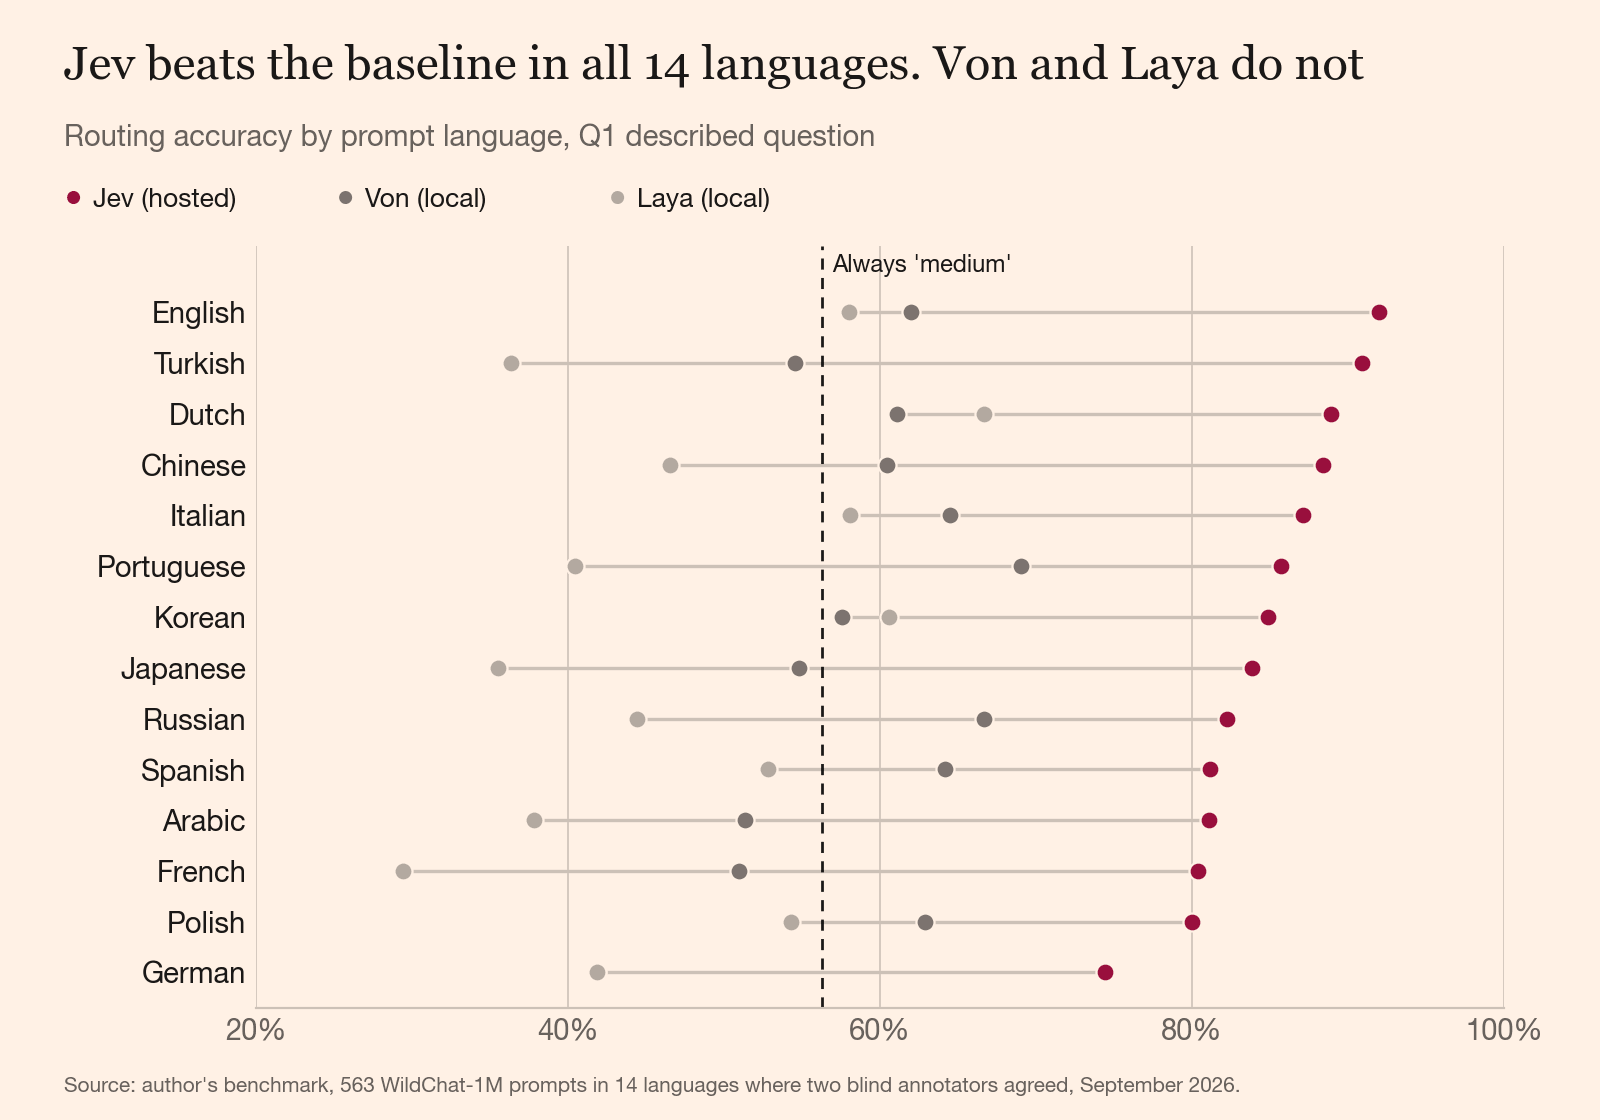
Nauwkeurigheid per taal op Q1. Met 31 tot 53 prompts per taal verschuift één prompt een score met 2 tot 3 punten.
Jev bleef tussen 74% (Duits) en 92% (Engels), en scoorde 84% op zowel Latijnse als
niet-Latijnse schriften. Von liep van 42% in het Duits tot 69% in het
Portugees, Laya van 29% in het Frans tot 67% in het Nederlands. Een router die
Frans in minder dan een derde van de gevallen goed heeft, mag niet in de buurt
van Franse klanten komen.
## Jev mist juist de prompts die het zwaarst wegen.
Van de 21 frontierprompts stuurde Jev op Q1 er zes naar frontier en 15 naar
medium. Op Q2 stuurde hij er drie. Juist daar richt goedkoop routeren de meeste
schade aan: een statistiekvraagstuk in het Turks, beslisregels voor investeringen
in het Duits, een opzet over quantum key distribution. Eenentwintig is een kleine
steekproef, en dat zeg ik er meteen bij.
Jevs kansen helpen. Escaleer naar frontier zodra Jev die optie meer dan 0,2
geeft, en Q1 vangt 14 van de 21, terwijl maar 18 van de 563 prompts escaleren.
Q2 vangt er met dezelfde drempel zeven. Ik koos 0,2 nadat ik deze data had
gezien, dus zie het als een startpunt om bij te stellen.
Nog drie dingen spreken de kop tegen:
- **84% flatteert Jev.** De gouden set bestaat uit de prompts waarover beide
annotators het eens waren, de makkelijkere. Op de volledige set waren de
annotators het maar in 77,5% van de gevallen eens, dus ongeveer 80% is een
realistisch plafond voor elke router met deze tiers.
- **Dit zijn inschattingslabels.** Twee modellen gokten welke tier een prompt
nodig heeft. Niemand controleerde wat elke tier daadwerkelijk opleverde.
- **Jev is trager.** De mediane latency was ongeveer 330 ms per call vanaf mijn
laptop, grotendeels netwerk, tegenover 56 tot 170 ms voor de lokale modellen.
## De goedkope router is de dure.
We konden Jev uiteindelijk niet inzetten: er is geen EU-deployment van. Dus heb
ik Laya gefinetuned op onze eigen labels, en die router
[draait nu op één CPU-server in Duitsland](/nl/blog/llm-router-op-hetzner-cpu-server).
Een lokale router kost niets per call. Als hij 41% van je verkeer naar een tier
stuurt die het niet nodig heeft, zoals Von op Q2 deed, betaal je daarvoor bij
elk van die calls, en die kosten staan op geen enkele model card die ik heb
gelezen.
Dus tel. Neem WildChat of je eigen logs, label een paar honderd prompts met twee
annotators, gooi de prompts eruit waarover ze het oneens zijn, en scoor je router
tegen `return "medium"`. Als hij daar niet minstens tien punten boven zit, heb je
geen router.
De betere test, die we hierna draaien, is gebaseerd op uitkomsten: stuur echt
verkeer door elke tier, noteer de goedkoopste tier waarvan het antwoord goed
genoeg was, en scoor de router daartegen. Als Jevs 84% daar instort, publiceer ik
dat ook.