# Onze LLM-router draait op 30 ms p50 op een Hetzner-server van €84 per maand, zonder GPU
> We finetunden Laya tot Raya, een open LLM-router met 81% nauwkeurigheid, en draaien die op CPU op één Hetzner-server via Cloudfleet. 30 ms p50, in de EU.
- Source: https://jays.fyi/nl/blog/llm-router-op-hetzner-cpu-server
- Author: Jay Derinbogaz
- Published: 2026-09-25
- Language: nl
- Tags: ai, open-source, benchmarks, infrastructure
- Reading time: 7 min
- Machine translated: yes — original: https://jays.fyi/blog/fine-tuned-llm-router-on-a-hetzner-cpu-server
---
Twee dagen geleden publiceerde ik een benchmark die liet zien dat de
[open alternatieven voor Jev verliezen van een hardgecodeerd "medium"](/nl/blog/open-source-jev-alternatieven-benchmark).
Jev routeerde 84,5% van 563 echte prompts naar de juiste modeltier. Laya en Von,
de open modellen, haalden hooguit 61,6%.
Toen probeerden we Jev te kopen en lukte dat niet. TextCortex verkoopt aan
Europese bedrijven, en toen we in september 2026 keken, was er geen
EU-deployment van Jev te koop. Een router leest elke prompt die een klant typt,
dus hij moet draaien waar de data van die klant naartoe mag.
Dus nam ik het model dat verloor en finetunede het. Het resultaat is
[Raya](https://huggingface.co/TextCortex/raya), een router van 300 miljoen
parameters die **81%** scoort op dezelfde benchmark. Hij draait nu in ons
productiecluster op een CPU in Falkenstein, Duitsland, met een mediane latency
van **30 ms**, op een Hetzner-server die €84 per maand kost en al op onze
rekening stond.
## De beste router had geen EU-regio, dus finetunden we degene die verloor.
[Laya](https://huggingface.co/convaiinnovations/laya) is een beslismodel onder
Apache-2.0: een [mmBERT](https://huggingface.co/jhu-clsp/mmBERT-base)-encoder met
een kleine head die elke optie in een meerkeuzevraag een score geeft. Het spreekt
dezelfde API als Jev. Kant-en-klaar routeerde het slechter dan een constante.
Twee blinde
annotators, Claude Opus en Claude Sonnet, hadden WildChat-prompts gelabeld met
dezelfde geschreven rubric. Raya traint op hun labels als soft
targets, 50/50 waar ze het oneens waren, plus synthetische moeilijke prompts in
alle 14 talen en wat eigen routeringsdata. De 563 testprompts komen uit
WildChat-shards die de training nooit heeft aangeraakt.
De training duurde ongeveer zes minuten op één NVIDIA RTX A6000.
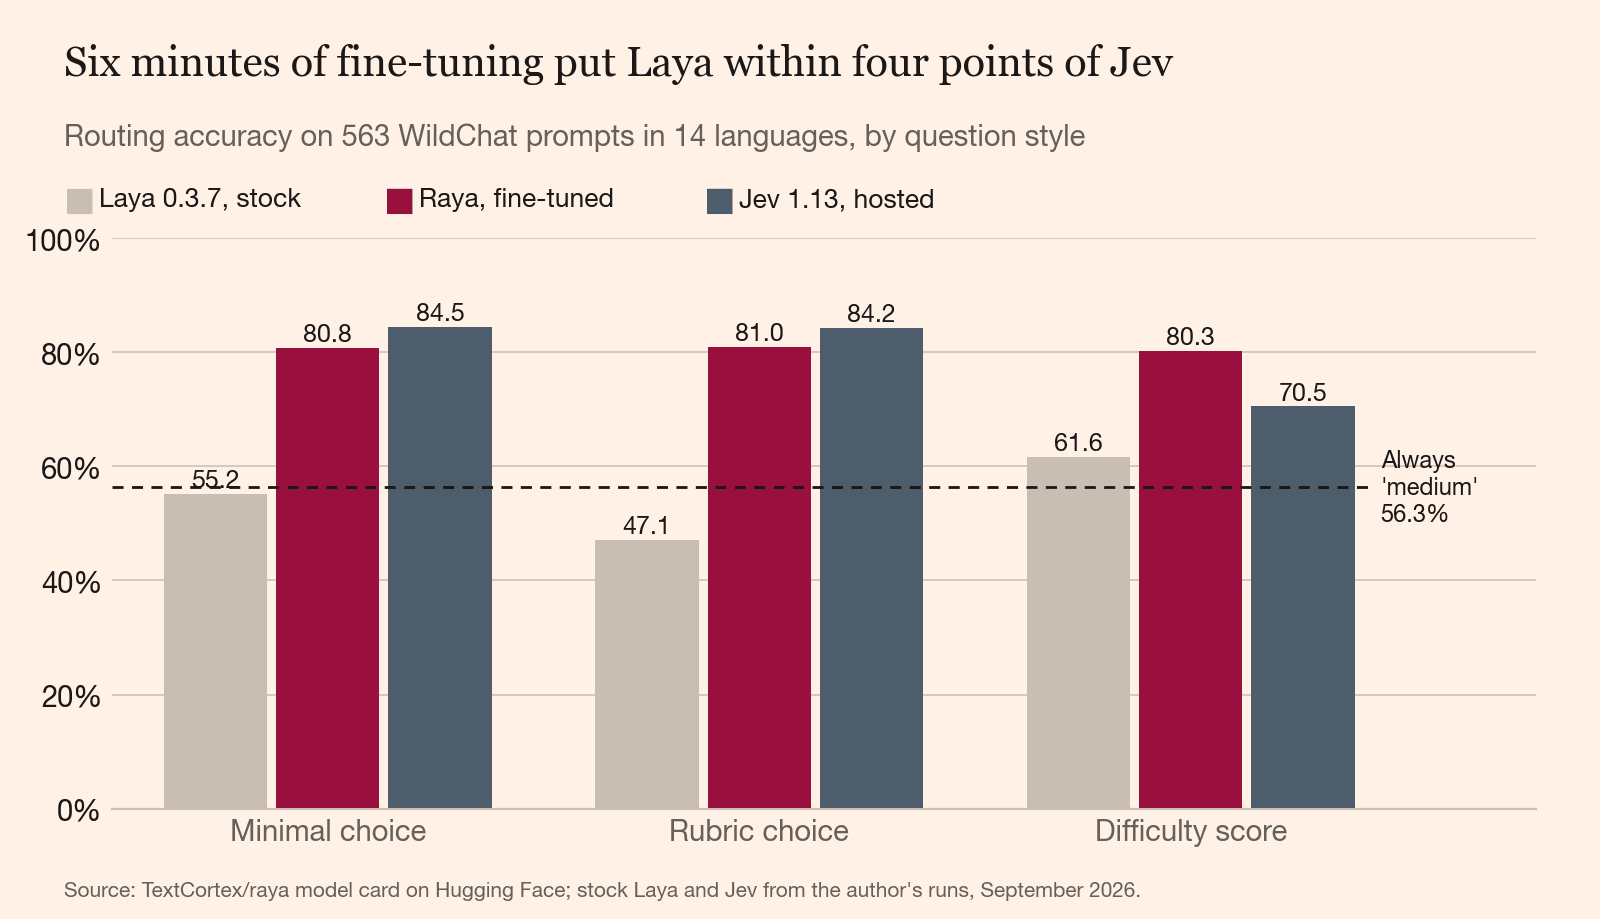
## Zes minuten op één GPU leverden Laya 25 tot 34 punten op.
Nauwkeurigheid op de benchmark met 563 prompts uit de eerste post. De cijfers van Raya komen uit zijn openbare model card.
Raya scoort 80 tot 81% op alle drie de vraagstijlen. Op de moeilijkheidsscore
verslaat hij Jev met tien punten (80,3% tegenover 70,5%, McNemar p < 0,001). Op
de twee meerkeuzevragen ligt Jev nog drie tot vier punten voor. Dat verschil is
bij deze steekproefgrootte niet significant (p = 0,07 en 0,13), maar het duikt
bij allebei op, en ik zou erop wedden dat het echt is.
Nu de concessie, en die is groot. Raya leerde van dezelfde twee annotators die de
gouden labels schreven. Jev heeft ze nooit gezien. Een deel van Raya's 81% is
thuisvoordeel, en ik kan je niet vertellen hoeveel. De annotators zijn het maar
in 78% van de gevallen met elkaar eens, dus Raya zit tegen het plafond van wat
deze labels kunnen meten.
Raya is bovendien het zwakst waar Jev het sterkst is. Op de minimale vraag scoort
hij 67% in het Turks tegenover 82% voor Jev, en 76% in het Portugees tegenover
90%. Net als Jev stuurt hij maar 7 van de 21 frontierprompts naar frontier.
## Een classifier van 300M parameters heeft niets te zoeken op een GPU.
De model card van Raya noemt 17 ms op een GPU. Een hele GPU voor één kleine
forward pass per prompt is een hoop hardware, dus exporteerde ik Raya naar
[ONNX Runtime](https://onnxruntime.ai/) en probeerde ik vijf varianten op twee
CPU's: een Intel i9-13900, die VNNI-int8-instructies heeft, en een AMD EPYC
7502P, die ze niet heeft.
| Bestand | Grootte | Nauwkeurigheid | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
| --- | ---: | ---: | ---: | ---: |
| fp32 | 1,23 GB | 81,2% | 38 / 297 ms | 60 / 487 ms |
| blockwise int8 | 0,89 GB | **81,5%** | **34 / 282 ms** | 127 / 975 ms |
| per-tensor int8 | 0,92 GB | 79,0% | 24 / 200 ms | onbruikbaar |
| PyTorch-referentie | | 81,0% | 42 / 421 ms | 89 / 526 ms |
Het snelste bestand verliest tweeënhalf punt nauwkeurigheid, en in een router
betekent dat echte prompts die naar het verkeerde model gaan. Op de EPYC gaf
per-tensor int8 overflow en zakte de nauwkeurigheid naar tussen 54% en 80%,
afhankelijk van de instellingen.
Blockwise int8 op de VNNI-chip behield elk punt nauwkeurigheid. Die leveren we
uit. Zestien threads waren op beide CPU's trager dan acht, dus elke pod krijgt er
acht.
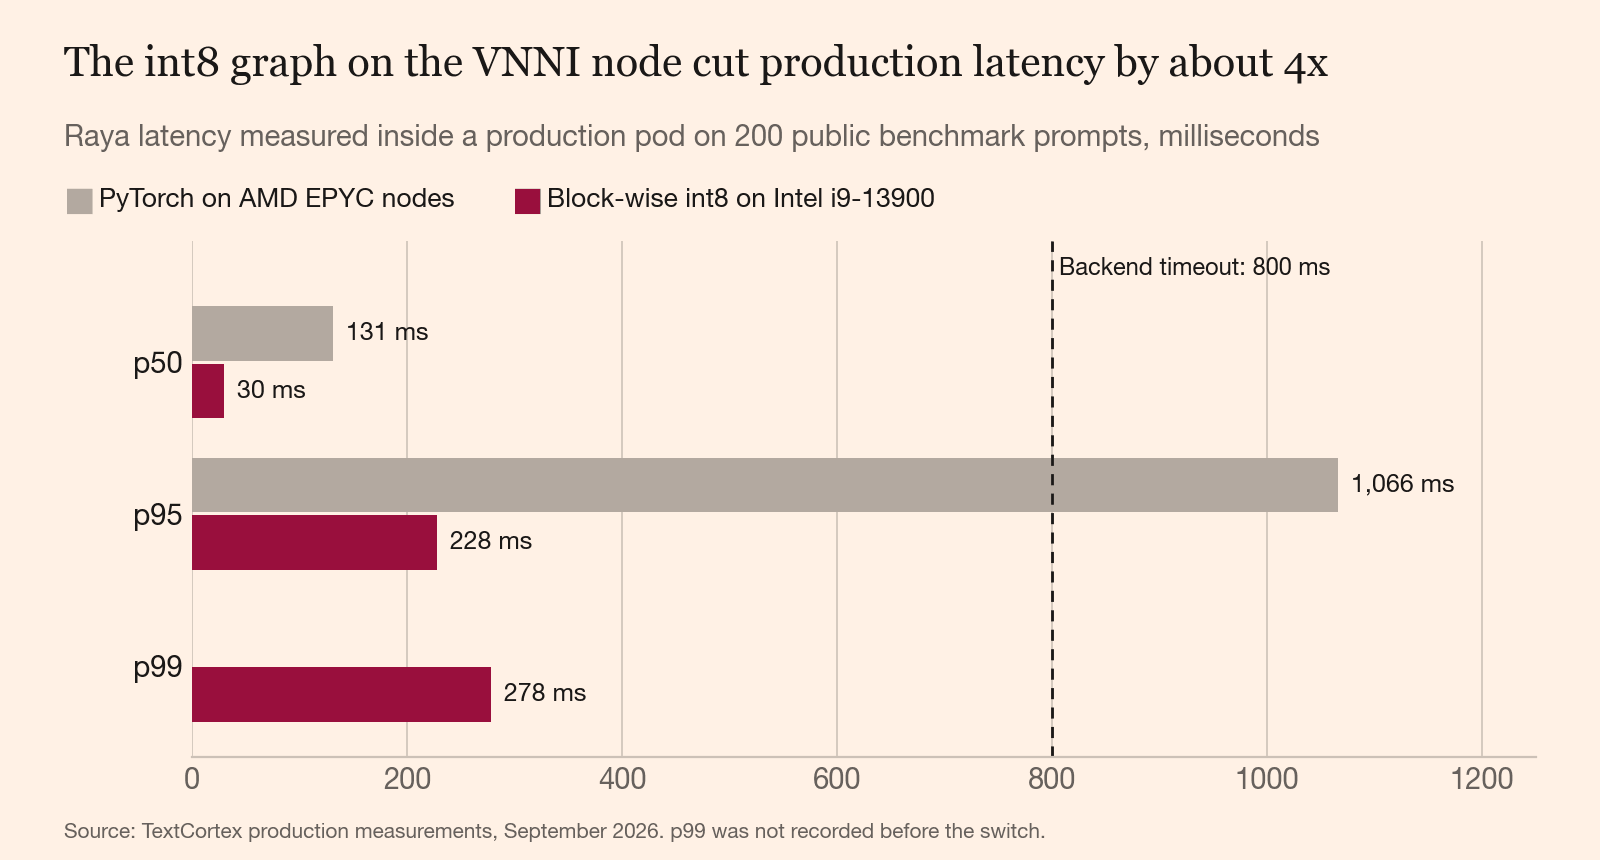
## De overstap naar int8 op een VNNI-CPU bracht p95 van 1.066 ms naar 228 ms.
Gemeten in een productiepod op 200 openbare benchmarkprompts. Tussen de twee runs veranderden zowel de runtime als de CPU.
De eerste productiedeployment draaide PyTorch op onze EPYC-nodes. De p95 was
1.066 ms, boven de 800 ms die de backend wacht voordat hij de router opgeeft.
Meer dan één op de twintig verzoeken zou een timeout hebben gekregen.
Na de overstap, gemeten in een productiepod: 30 ms p50, 228 ms p95, 278 ms p99.
Elke pod verwerkt 16 tot 18 verzoeken per seconde, tegen ongeveer 4 eerder.
Het image ging van 4,0 GB naar 1,0 GB. De nauwkeurigheid op de benchmark is
81,5%, tegenover 81,0% voor het PyTorch-origineel.
Int8-rekenwerk hangt af van de CPU, dus het image controleert zichzelf. De build
verifieert de SHA-256 van het modelbestand. Elke pod weigert te starten op een
CPU zonder VNNI, en vergelijkt zijn antwoorden met de PyTorch-referentie voordat
hij verkeer aanneemt.
## De server kost €84 per maand en stond al op de rekening.
Ons cluster draait op de managed Kubernetes van [Cloudfleet](https://cloudfleet.ai/),
met dedicated servers van Hetzner als nodes.
De node van Raya heeft dezelfde specificaties als Hetzners
[EX101](https://www.hetzner.com/dedicated-rootserver/ex101/): een i9-13900, 64
GB ECC-geheugen, twee NVMe-schijven van 1,92 TB. Hetzner vraagt er €84 per maand
voor plus €39 installatiekosten, exclusief btw (september 2026). Cloudfleet
[rekent per vCPU](https://cloudfleet.ai/pricing/) daarbovenop, van €2,45 tot
€7,25 per maand, afhankelijk van het abonnement.
We hebben niets gekocht voor Raya. Op de node draaiden andere workloads met 22%
van de CPU gereserveerd. Met de pods van Raya is dat 86%. De router kostte ons
ongebruikte capaciteit op een machine waar we al voor betaalden.
Het plafond, als schatting: twee productiepods verwerken ongeveer 32 verzoeken
per seconde, oftewel zo'n 83 miljoen routeringsbeslissingen in een maand van 30
dagen. Reken de hele server toe aan Raya en dat is ongeveer €1 per miljoen
beslissingen bij volle belasting, exclusief btw en de vergoeding van Cloudfleet.
Bij het echte verkeer telt vooral die vaste €84.
## Alles hangt aan één server.
Maar één node in ons cluster heeft VNNI, dus beide productiepods zijn daaraan
vastgepind. Als die server uitvalt, blijven de pods op pending staan en stuurt
Auto elke prompt naar medium. Dat is de constante router uit de eerste post. Chat
blijft werken tot de node terug is.
De node is ook vol. Met 86% gereserveerd is er geen ruimte voor een derde pod, dus
boven ongeveer 32 verzoeken per seconde moet er een tweede VNNI-server gehuurd
worden. Bij acht gelijktijdige verzoeken per pod loopt p95 op tot ongeveer 1,2
seconden, voorbij de timeout van 800 ms, en valt de overloop terug op medium. Het
huidige Auto-verkeer komt daar bij lange na niet in de buurt.
En terwijl ik dit schrijf, bereikt nog geen enkel klantverzoek Raya. De smoketest routeert alle drie
de tiers correct in staging en productie. De
backendwijziging die hem aanroept, ligt nog in review.
## Een open model dat je finetunet, verslaat een open model dat je downloadt.
Standaard Laya verloor van een constante. Zes minuten trainen op onze eigen
labels dichtte het grootste deel van het gat met een gehost model, en een
CPU-server van €84 dichtte het latencygat.
Jev is nog steeds beter op de keuzevragen. Er is ook geen EU-deployment van.
Voor een Europees bedrijf wint een router die drie punten slechter scoort en in
Falkenstein draait van een betere router op een plek waar we de prompt niet
naartoe kunnen sturen.
Raya is openbaar onder Apache-2.0, met de ONNX-bestanden, hun checksums en de
ruwe benchmarkresultaten op [zijn model card](https://huggingface.co/TextCortex/raya).
Draai hem op je eigen prompts tegen `return "medium"`. Als hij dat op jouw
verkeer niet met tien punten verslaat, laat het me weten, en dan publiceer ik
dat ook.