# Notre routeur LLM tourne à 30 ms p50 sur un serveur Hetzner à 84 €/mois, sans GPU
> Laya fine-tuné devient Raya, un routeur LLM ouvert précis à 81 %, servi sur CPU par un serveur Hetzner via Cloudfleet. 30 ms p50, hébergé dans l'UE.
- Source: https://jays.fyi/fr/blog/routeur-llm-serveur-hetzner-cpu
- Author: Jay Derinbogaz
- Published: 2026-09-25
- Language: fr
- Tags: ai, open-source, benchmarks, infrastructure
- Reading time: 8 min
- Machine translated: yes — original: https://jays.fyi/blog/fine-tuned-llm-router-on-a-hetzner-cpu-server
---
Il y a deux jours, j'ai publié un benchmark montrant que les [alternatives ouvertes à Jev perdent face à un « medium » codé en dur](/fr/blog/alternatives-open-source-jev-benchmark). Jev routait 84,5 % de 563 vrais prompts vers le bon niveau de modèle. Laya et Von, les modèles ouverts, plafonnaient à 61,6 %.
Ensuite, nous avons essayé d'acheter Jev, et nous n'avons pas pu. TextCortex vend à des entreprises européennes, et quand nous avons regardé en septembre 2026, il n'existait aucun déploiement de Jev dans l'UE à acheter. Un routeur lit chaque prompt qu'un client tape, il doit donc tourner là où les données du client ont le droit d'aller.
Alors j'ai pris le modèle qui avait perdu et je l'ai fine-tuné. Le résultat s'appelle [Raya](https://huggingface.co/TextCortex/raya), un routeur de 300 millions de paramètres qui obtient **81 %** sur le même benchmark. Il tourne désormais dans notre cluster de production sur un CPU à Falkenstein, en Allemagne, avec une latence médiane de **30 ms**, sur un serveur Hetzner qui coûte 84 € par mois et figurait déjà sur notre facture.
## Le meilleur routeur n'avait pas de région UE, alors nous avons fine-tuné celui qui avait perdu.
[Laya](https://huggingface.co/convaiinnovations/laya) est un modèle de décision sous licence Apache-2.0 : un encodeur [mmBERT](https://huggingface.co/jhu-clsp/mmBERT-base) surmonté d'une petite tête qui note chaque option d'une question à choix multiple. Il parle la même API que Jev. Tel quel, il routait moins bien qu'une constante.
Deux annotateurs à l'aveugle, Claude Opus et Claude Sonnet, avaient étiqueté des prompts WildChat avec la même grille écrite. Raya s'entraîne sur leurs étiquettes utilisées comme cibles souples, 50/50 là où ils n'étaient pas d'accord, plus des prompts difficiles synthétiques dans les 14 langues et une partie de nos données de routage internes. Les 563 prompts de test viennent de shards WildChat que l'entraînement n'a jamais touchés.
L'entraînement a pris environ six minutes sur une seule NVIDIA RTX A6000.
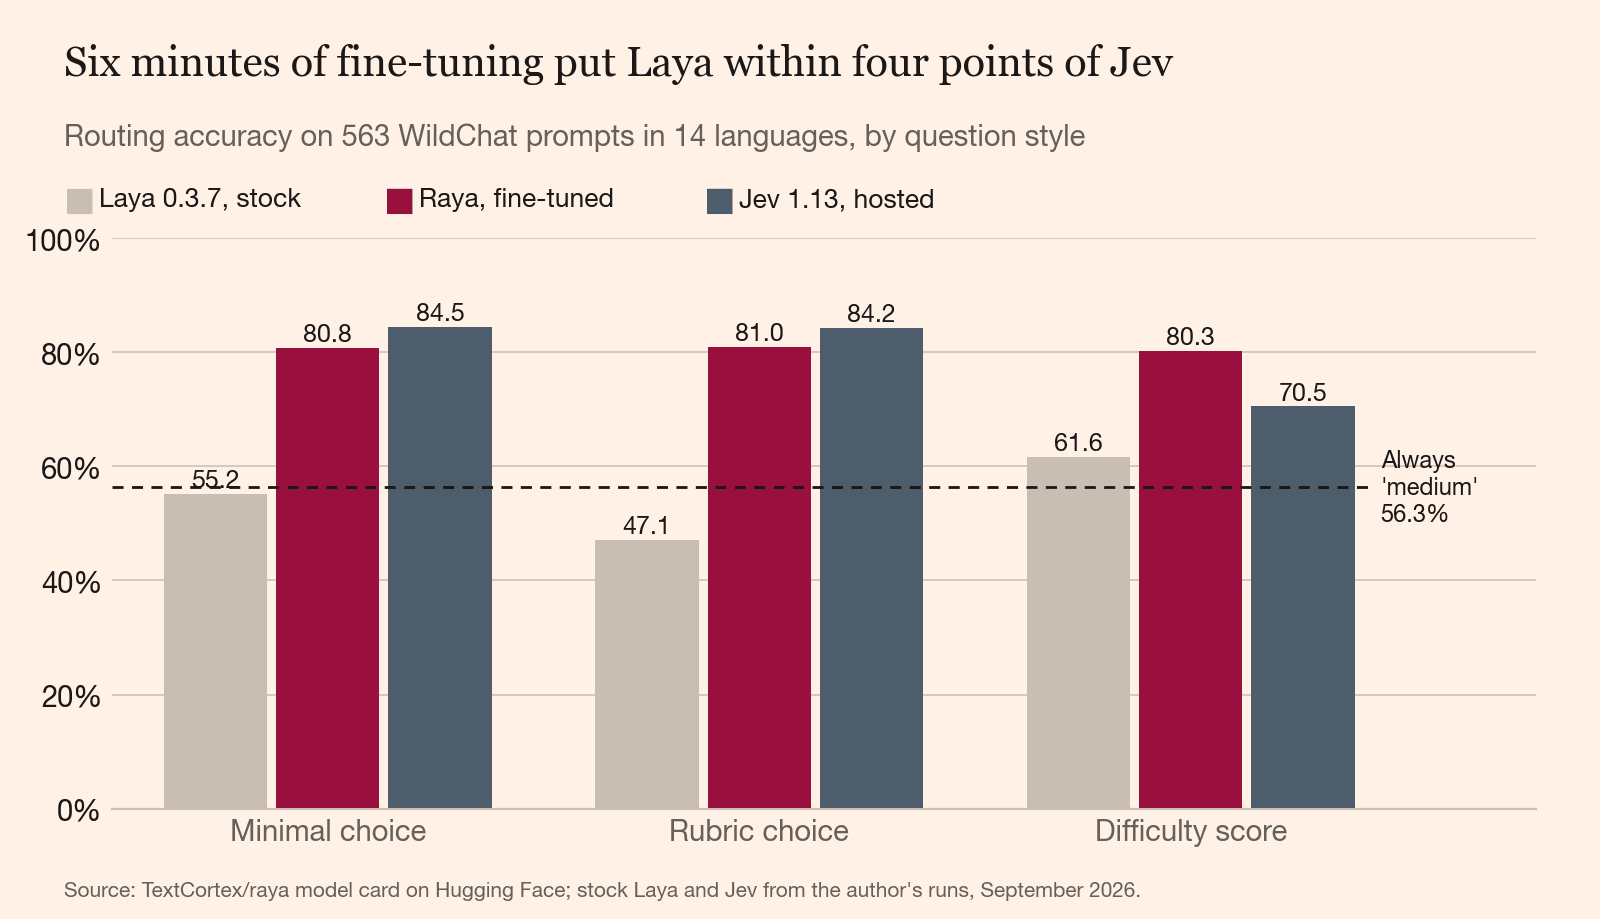
## Six minutes sur un seul GPU ont fait gagner à Laya de 25 à 34 points.
Précision sur le benchmark de 563 prompts du premier article. Les chiffres de Raya viennent de sa fiche de modèle publique.
Raya obtient de 80 à 81 % sur les trois styles de question. Sur le score de difficulté, il bat Jev de dix points (80,3 % contre 70,5 %, McNemar p < 0,001). Sur les deux questions à choix multiple, Jev garde trois à quatre points d'avance. Cet écart n'est pas significatif avec cette taille d'échantillon (p = 0,07 et 0,13), mais il apparaît sur les deux, et je parierais qu'il est réel.
Maintenant la concession, et elle est de taille. Raya a appris des deux mêmes annotateurs qui ont écrit les étiquettes de référence. Jev ne les a jamais vues. Une partie des 81 % de Raya est un avantage du terrain, et je ne peux pas vous dire quelle part. Les annotateurs ne sont d'accord entre eux que 78 % du temps, donc Raya a atteint le plafond de ce que ces étiquettes peuvent mesurer.
Raya est aussi le plus faible là où Jev est le plus fort. Sur la question minimale, il obtient 67 % en turc contre 82 % pour Jev, et 76 % en portugais contre 90 %. Comme Jev, il n'envoie que 7 des 21 prompts frontier vers frontier.
## Un classifieur de 300M de paramètres n'a rien à faire sur un GPU.
La fiche de modèle de Raya annonce 17 ms sur GPU. Un GPU entier pour une seule petite passe avant par prompt, c'est beaucoup de matériel, alors j'ai exporté Raya vers [ONNX Runtime](https://onnxruntime.ai/) et essayé cinq variantes sur deux CPU : un Intel i9-13900, qui dispose des instructions int8 VNNI, et un AMD EPYC 7502P, qui ne les a pas.
| Fichier | Taille | Précision | i9-13900 p50 / p95 | EPYC 7502P p50 / p95 |
| --- | ---: | ---: | ---: | ---: |
| fp32 | 1,23 Go | 81,2 % | 38 / 297 ms | 60 / 487 ms |
| int8 par blocs | 0,89 Go | **81,5 %** | **34 / 282 ms** | 127 / 975 ms |
| int8 par tenseur | 0,92 Go | 79,0 % | 24 / 200 ms | inutilisable |
| Référence PyTorch | | 81,0 % | 42 / 421 ms | 89 / 526 ms |
Le fichier le plus rapide perd deux points et demi de précision, ce qui, pour un routeur, signifie de vrais prompts envoyés vers le mauvais modèle. Sur l'EPYC, l'int8 par tenseur débordait et la précision tombait entre 54 % et 80 % selon les réglages.
L'int8 par blocs sur la puce VNNI a conservé chaque point de précision. C'est celui que nous livrons. Seize threads étaient plus lents que huit sur les deux CPU, donc chaque pod en reçoit huit.
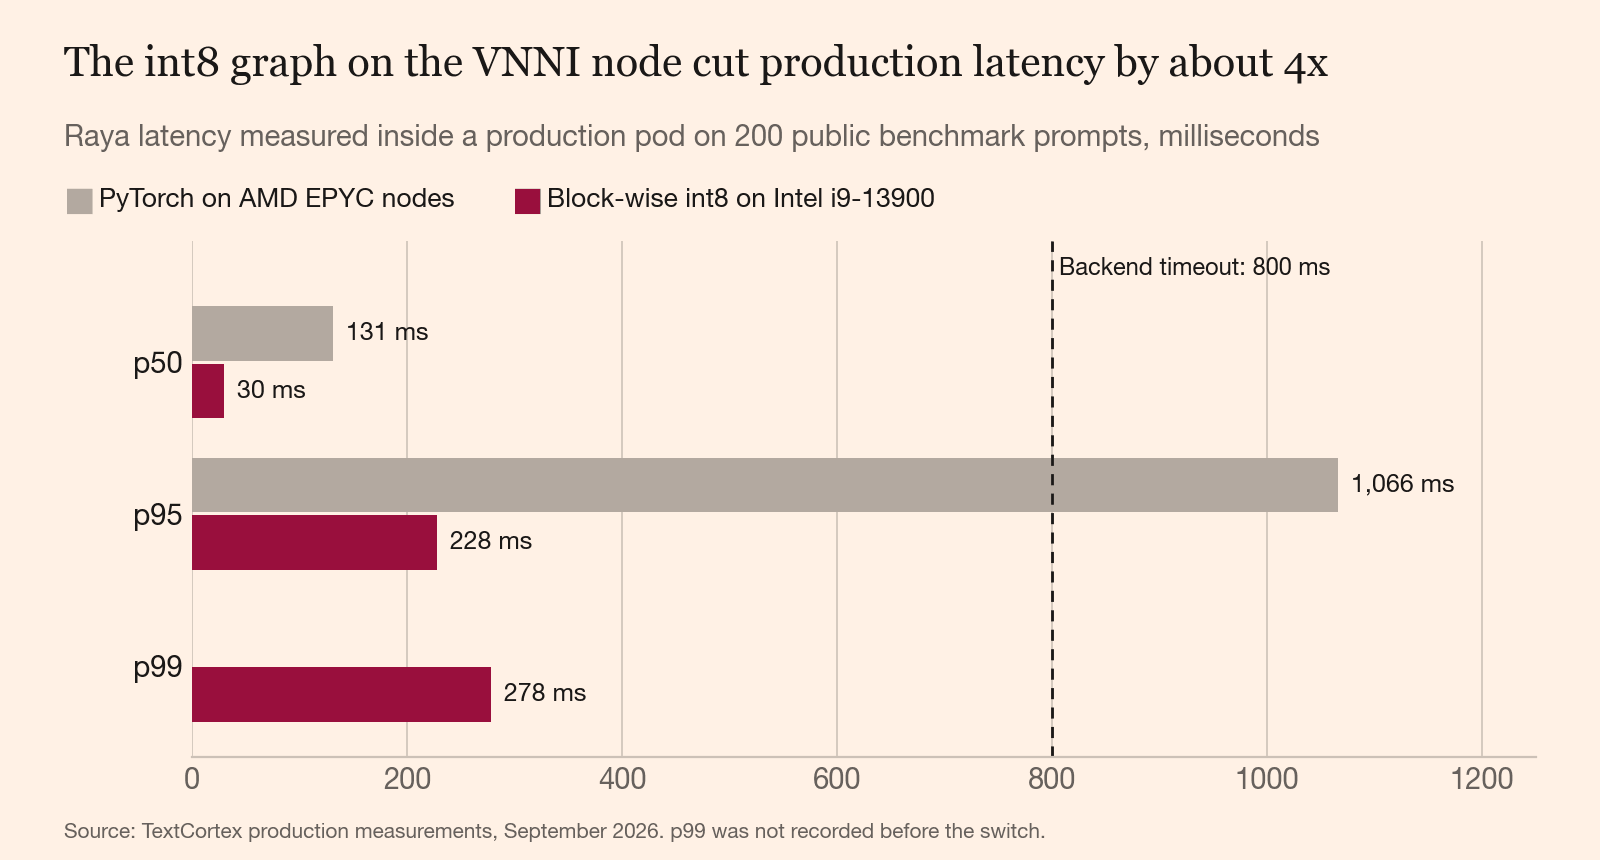
## Passer à l'int8 sur un CPU VNNI a fait tomber le p95 de 1 066 ms à 228 ms.
Mesuré dans un pod de production sur 200 prompts du benchmark public. Le runtime et le CPU ont tous deux changé entre les deux mesures.
Le premier déploiement en production faisait tourner PyTorch sur nos nœuds EPYC. Son p95 était de 1 066 ms, au-dessus des 800 ms que le backend attend avant d'abandonner le routeur. Plus d'une requête sur vingt aurait expiré.
Après le changement, mesuré dans un pod de production : 30 ms en p50, 228 ms en p95, 278 ms en p99. Chaque pod traite 16 à 18 requêtes par seconde, contre environ 4 auparavant. L'image est passée de 4,0 Go à 1,0 Go. La précision sur le benchmark est de 81,5 %, contre 81,0 % pour l'original PyTorch.
L'arithmétique int8 dépend du CPU, donc l'image se vérifie elle-même. Le build vérifie le SHA-256 du fichier de modèle. Chaque pod refuse de démarrer sur un CPU sans VNNI, et compare ses réponses à la référence PyTorch avant d'accepter du trafic.
## Le serveur coûte 84 € par mois et figurait déjà sur la facture.
Notre cluster tourne sur le Kubernetes managé de [Cloudfleet](https://cloudfleet.ai/), avec des serveurs dédiés Hetzner comme nœuds. Le nœud de Raya a la même configuration que l'[EX101](https://www.hetzner.com/dedicated-rootserver/ex101/) de Hetzner : un i9-13900, 64 Go de mémoire ECC, deux disques NVMe de 1,92 To. Hetzner l'affiche à 84 € par mois plus 39 € de frais d'installation, hors TVA (septembre 2026). Cloudfleet [facture par vCPU](https://cloudfleet.ai/pricing/) en plus, de 2,45 € à 7,25 € par mois selon l'offre.
Nous n'avons rien acheté pour Raya. Le nœud faisait tourner d'autres charges avec 22 % de son CPU réservé. Avec les pods de Raya, il est à 86 %. Le routeur nous a coûté de la capacité inutilisée sur une machine que nous payions déjà.
Le plafond, en estimation : deux pods de production traitent environ 32 requêtes par seconde, soit à peu près 83 millions de décisions de routage sur un mois de 30 jours. Imputez tout le serveur à Raya et cela fait environ 1 € par million de décisions à pleine charge, hors TVA et hors frais Cloudfleet. Au trafic réel, ce qui compte, ce sont les 84 € fixes.
## Tout repose sur un seul serveur.
Un seul nœud de notre cluster a VNNI, donc les deux pods de production y sont épinglés. Si ce serveur meurt, les pods restent en attente et Auto envoie chaque prompt vers medium. C'est le routeur constant du premier article. Le chat continue de fonctionner jusqu'au retour du nœud.
Le nœud est aussi plein. À 86 % réservé, il n'y a pas de place pour un troisième pod, donc dépasser environ 32 requêtes par seconde implique de louer un second serveur VNNI. À huit requêtes simultanées par pod, le p95 grimpe à environ 1,2 seconde, au-delà du timeout de 800 ms, et le surplus retombe sur medium. Le trafic Auto actuel en est très loin.
Et au moment où j'écris ces lignes, aucune requête client n'atteint Raya. Le smoke test route correctement les trois niveaux en staging comme en production. La modification du backend qui l'appelle est encore en revue.
## Un modèle ouvert que vous fine-tunez bat un modèle ouvert que vous téléchargez.
Laya d'origine perdait face à une constante. Six minutes d'entraînement sur nos propres étiquettes ont comblé l'essentiel de l'écart avec un modèle hébergé, et un serveur CPU à 84 € a comblé l'écart de latence.
Jev reste meilleur sur les questions à choix. Il n'a pas non plus de déploiement dans l'UE. Pour une entreprise européenne, un routeur trois points moins bon qui tourne à Falkenstein bat un routeur meilleur qui tourne quelque part où nous ne pouvons pas envoyer le prompt.
Raya est public sous licence Apache-2.0, avec les fichiers ONNX, leurs sommes de contrôle et les résultats bruts du benchmark sur [sa fiche de modèle](https://huggingface.co/TextCortex/raya). Faites-le tourner sur vos propres prompts face à `return "medium"`. S'il ne fait pas dix points de mieux sur votre trafic, dites-le-moi, et je le publierai aussi.