# Les alternatives open source à Jev sont nulles, voici le benchmark
> J'ai testé trois routeurs LLM sur 563 vrais prompts en 14 langues. Jev en route 84 % correctement. Deux modèles locaux ouverts battent à peine un « medium » fixe.
- Source: https://jays.fyi/fr/blog/alternatives-open-source-jev-benchmark
- Author: Jay Derinbogaz
- Published: 2026-09-23
- Language: fr
- Tags: ai, open-source, benchmarks
- Reading time: 9 min
- Machine translated: yes — original: https://jays.fyi/blog/local-llm-routers-lost-to-always-answering-medium
---
Chaque produit de chat doté d'un menu déroulant de modèles confie un travail de routage à ses utilisateurs. Ils doivent deviner si leur question mérite le modèle cher ou le modèle bon marché, et la plupart choisissent une fois pour toutes et n'y touchent plus jamais. Résultat, ils paient trop cher pour « c'est quoi un amour de jeunesse ? » et pas assez pour une démonstration sur des échantillons de Bernoulli.
Nous construisons chez [TextCortex](https://textcortex.com/) une sélection automatique du modèle pour que plus personne n'ait à deviner. Un routeur lit le prompt et choisit le niveau le moins cher qui y répondra encore bien. La façon évidente d'en construire un, c'est un petit modèle ouvert sur votre propre matériel : aucun coût par appel, environ 60 millisecondes par appel, et le prompt ne quitte jamais la maison. Je pensais que c'est là que nous finirions.
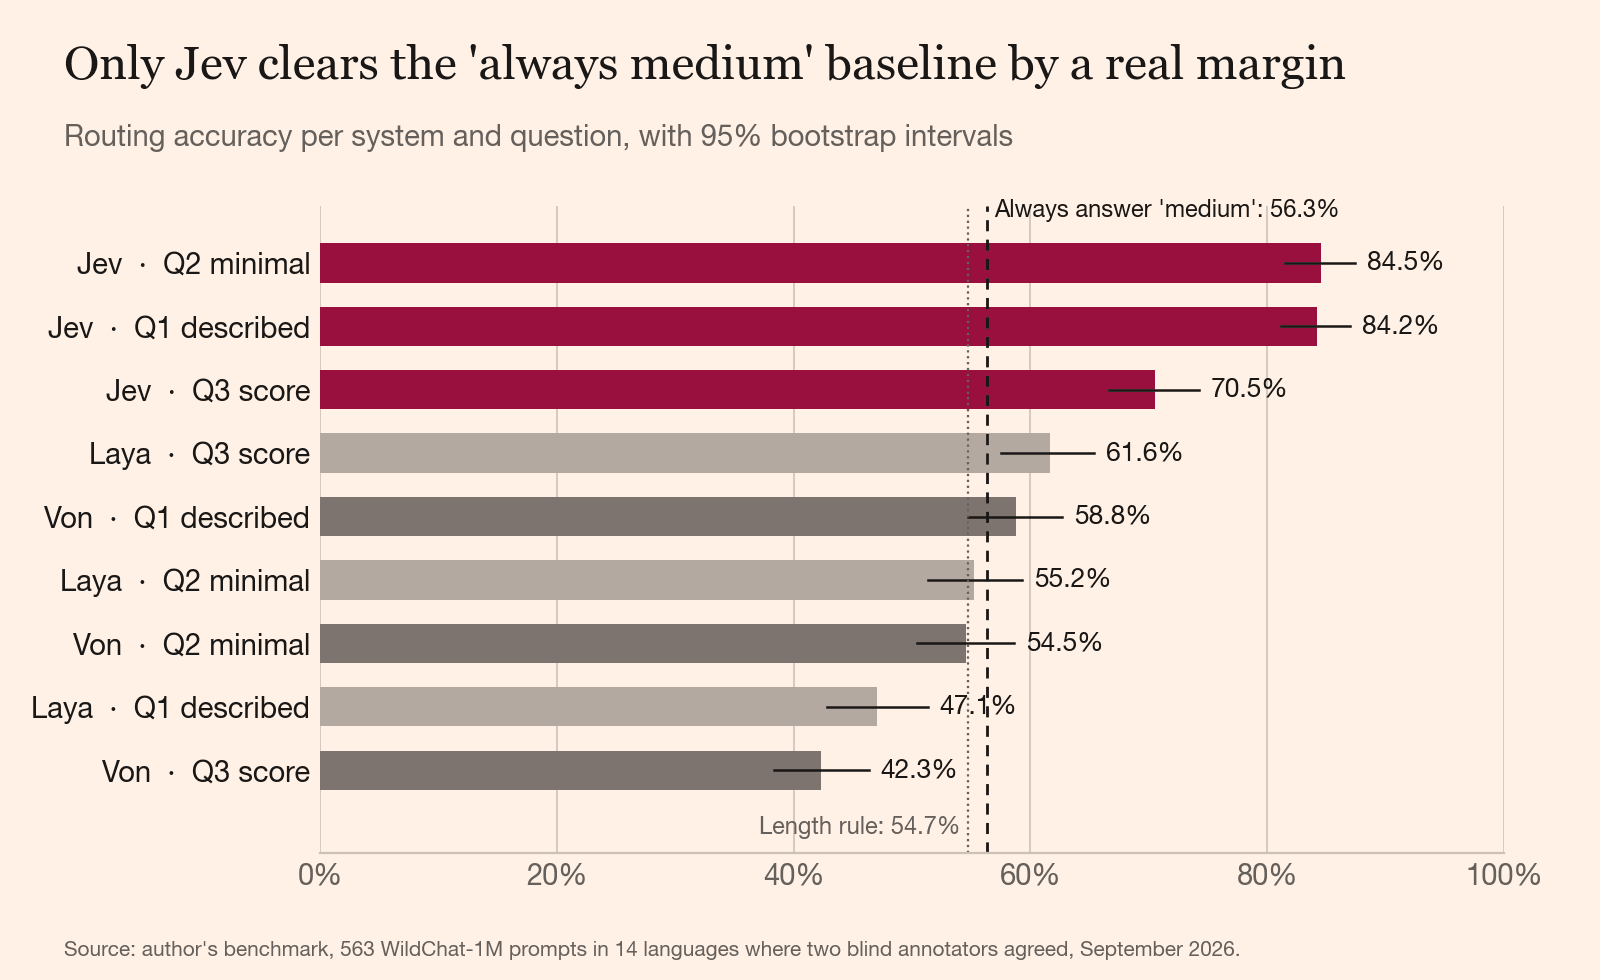
Alors j'ai mesuré. Sur 563 vrais prompts de chatbot en 14 langues, le modèle hébergé Jev en a routé **84,5 %** vers le bon niveau. Laya et Von, des modèles ouverts tournant sur mon portable, ont plafonné à 61,6 % et 58,8 %. Un routeur qui répond « medium » à chaque prompt obtient 56,3 %. Appelons-le le routeur constant. Quatre des six exécutions de Laya et Von ont perdu face à lui.
## Un routeur, c'est une question à choix multiple posée avant chaque prompt.
Les trois systèmes parlent la même API. Vous envoyez le prompt, plus une question avec des options nommées et une phrase qui décrit chacune d'elles. Vous recevez une probabilité par option.
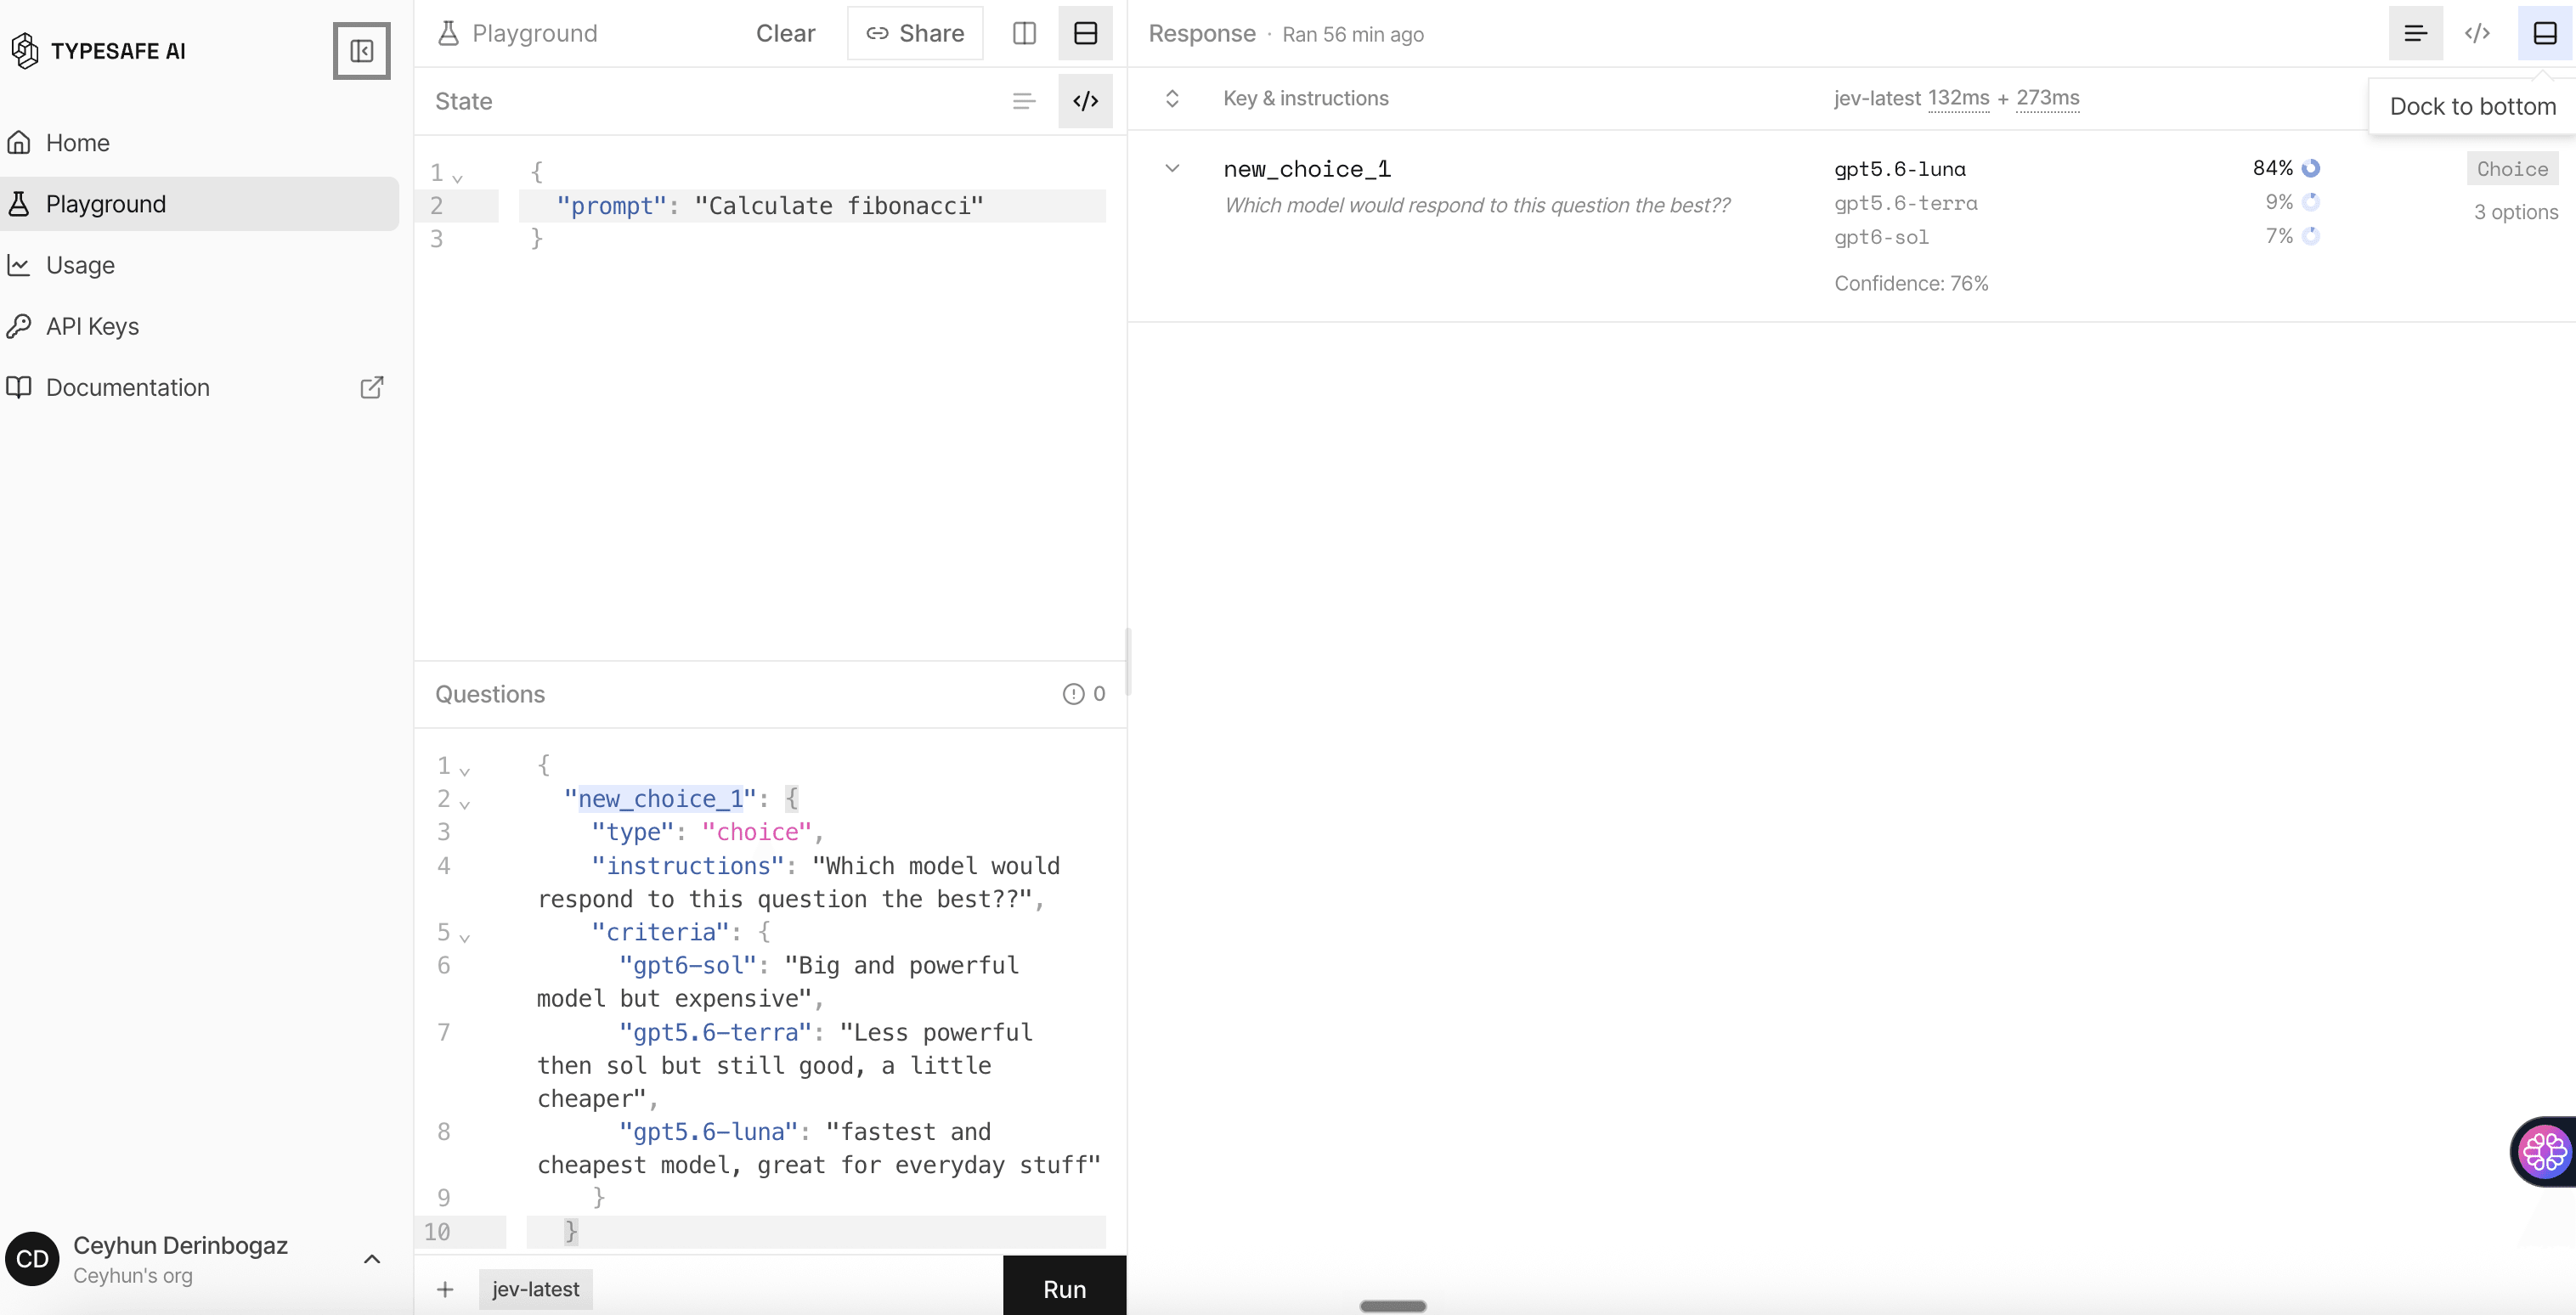
Ma première question de routage dans le playground de Typesafe AI, avec des noms de niveaux inventés. Le benchmark a utilisé une nouvelle formulation et des noms de niveaux neutres.
« Calculate fibonacci » part vers le niveau bon marché. Évidemment. J'ai d'abord testé les trois routeurs sur des prompts de ce genre, et Jev a gagné cette manche aussi, mais les prompts que j'écris pour un routeur sont des prompts dont je connais déjà la réponse. Cela ne prouvait presque rien.
## J'ai utilisé de vrais prompts, parce que les miens étaient trop faciles.
Les prompts viennent de [WildChat-1M](https://huggingface.co/datasets/allenai/WildChat-1M), un jeu de données public de vraies conversations de chatbot (licence ODC-BY, conversations toxiques filtrées). J'ai pris 40 premiers messages dans chacune de ces langues : anglais, allemand, français, espagnol, italien, portugais, néerlandais, polonais, turc, russe, arabe, chinois, japonais et coréen, puis j'ai ajouté 168 prompts plus longs ou plus techniques, parce que le trafic réel ne contient presque aucun prompt difficile.
Deux annotateurs à l'aveugle tournant sur des modèles différents, Claude Opus et Claude Sonnet, ont étiqueté les 728 prompts en small, medium ou frontier. Ils étaient d'accord sur 77,5 % d'entre eux (κ de Cohen = 0,60). J'ai gardé les 563 sur lesquels ils s'accordaient : 225 small, 317 medium, 21 frontier.
Chaque système a répondu à trois questions par prompt, soit 5 067 appels sans un seul échec franc :
- **Q1, décrite.** « Choisis le niveau le moins cher qui y répondra encore bien », avec des exemples de tâches pour chaque niveau.
- **Q2, minimale.** « Requêtes simples », « moyennement complexes » et « très difficiles ».
- **Q3, score.** Un score de difficulté à trois niveaux, projeté sur les niveaux de modèle.
## Deux des trois routeurs battent à peine une constante.
Précision sur les 563 prompts consensuels, avec des intervalles bootstrap à 95 %. La règle de longueur envoie les prompts de moins de 60 caractères vers small, ceux de moins de 1 500 vers medium, et le reste vers frontier.
Jev a obtenu 84,5 % avec des descriptions de deux ou trois mots et 84,2 % avec la grille complète. Cet écart, c'est du bruit, donc personne dans mon équipe n'a besoin de devenir prompt engineer pour écrire une question de routage.
La meilleure exécution de Laya a battu le routeur constant de 5,3 points. Celle de Von l'a battu de 2,5, avec un intervalle à 95 % (de 55 % à 63 %) qui contient encore la constante. Une règle qui ne regarde que la longueur du prompt a obtenu 54,7 %, au-dessus de deux exécutions locales et à moins d'un point de deux autres.
Un routeur qui perd face à `return "medium"`, c'est un générateur de nombres aléatoires avec un téléchargement de modèle en prime.
## Les modèles locaux devinent « medium » et appellent ça une décision.
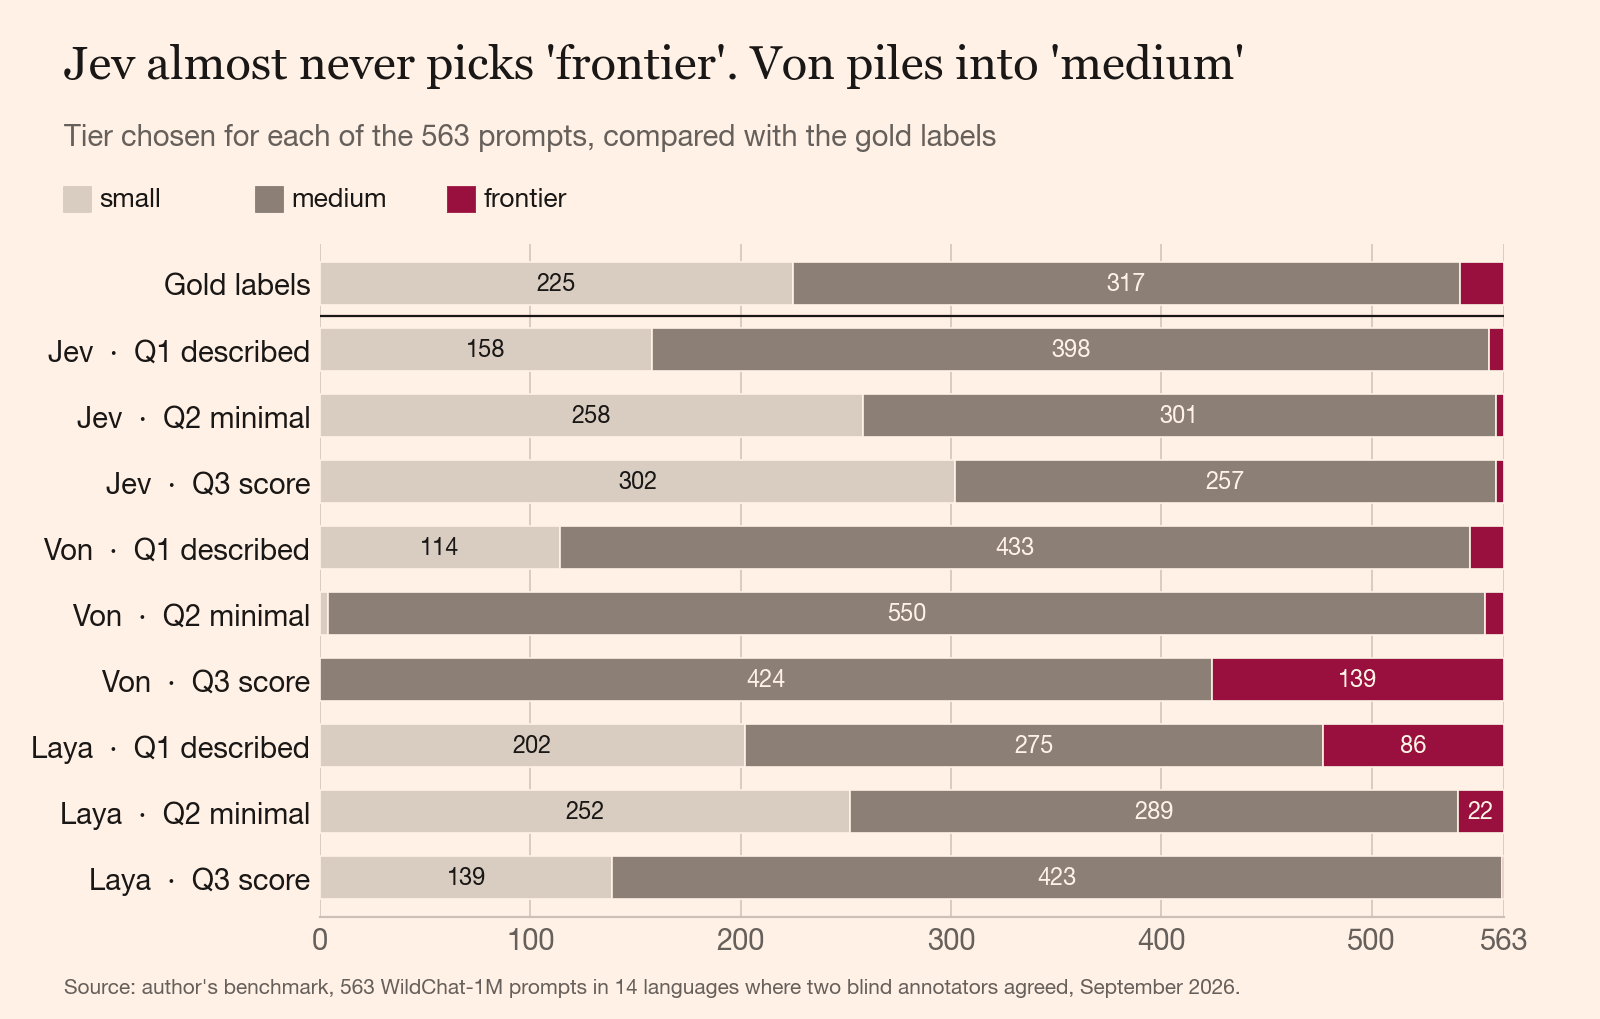
Ce que chaque exécution a répondu, comparé aux étiquettes de référence.
Sur Q2, Von a répondu « medium » 550 fois sur 563. Sur Q3, il n'a jamais dit small une seule fois, et a envoyé 139 prompts vers frontier alors que 21 y ont leur place. Sur Q1, Laya a envoyé 86 prompts vers frontier et avait raison pour six d'entre eux. Son checkpoint multilingue a traité 1 329 de ses 1 689 appels, et il a quand même obtenu 29 % en français.
## Von et Laya dépensent trop sur jusqu'à 55 % des prompts.
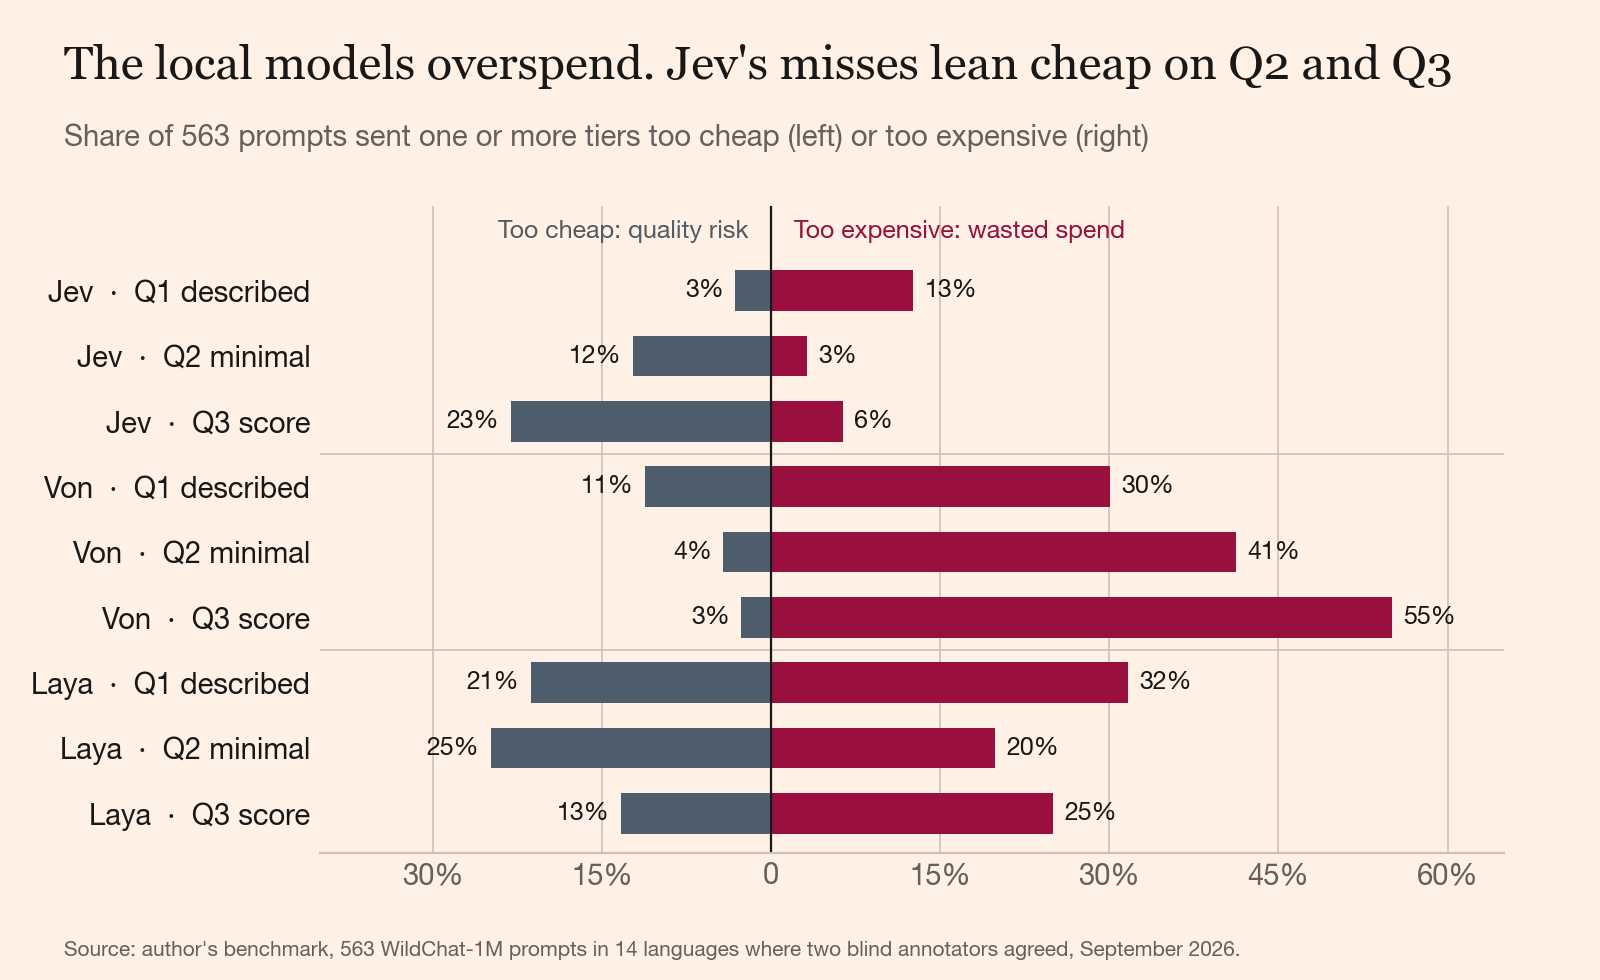
Part des prompts envoyés vers un niveau moins cher (à gauche) ou plus cher (à droite) que l'étiquette de référence.
Sur Q3, Von envoie 55 % de tous les prompts vers un niveau plus cher que nécessaire. Ce routeur fait grimper la facture qu'il est censé réduire.
Jev penche dans l'autre sens sur Q2 et Q3, et c'est pire à chaque erreur. Une réponse trop chère coûte la différence de prix. Une réponse sous-dimensionnée coûte un utilisateur qui a posé une question difficile et a reçu une réponse fausse, livrée avec assurance. Sur Q2, 51 des erreurs de Jev étaient des prompts medium envoyés vers small. Sur Q3, 113.
## La langue a à peine fait bouger Jev, et beaucoup fait bouger tous les autres.
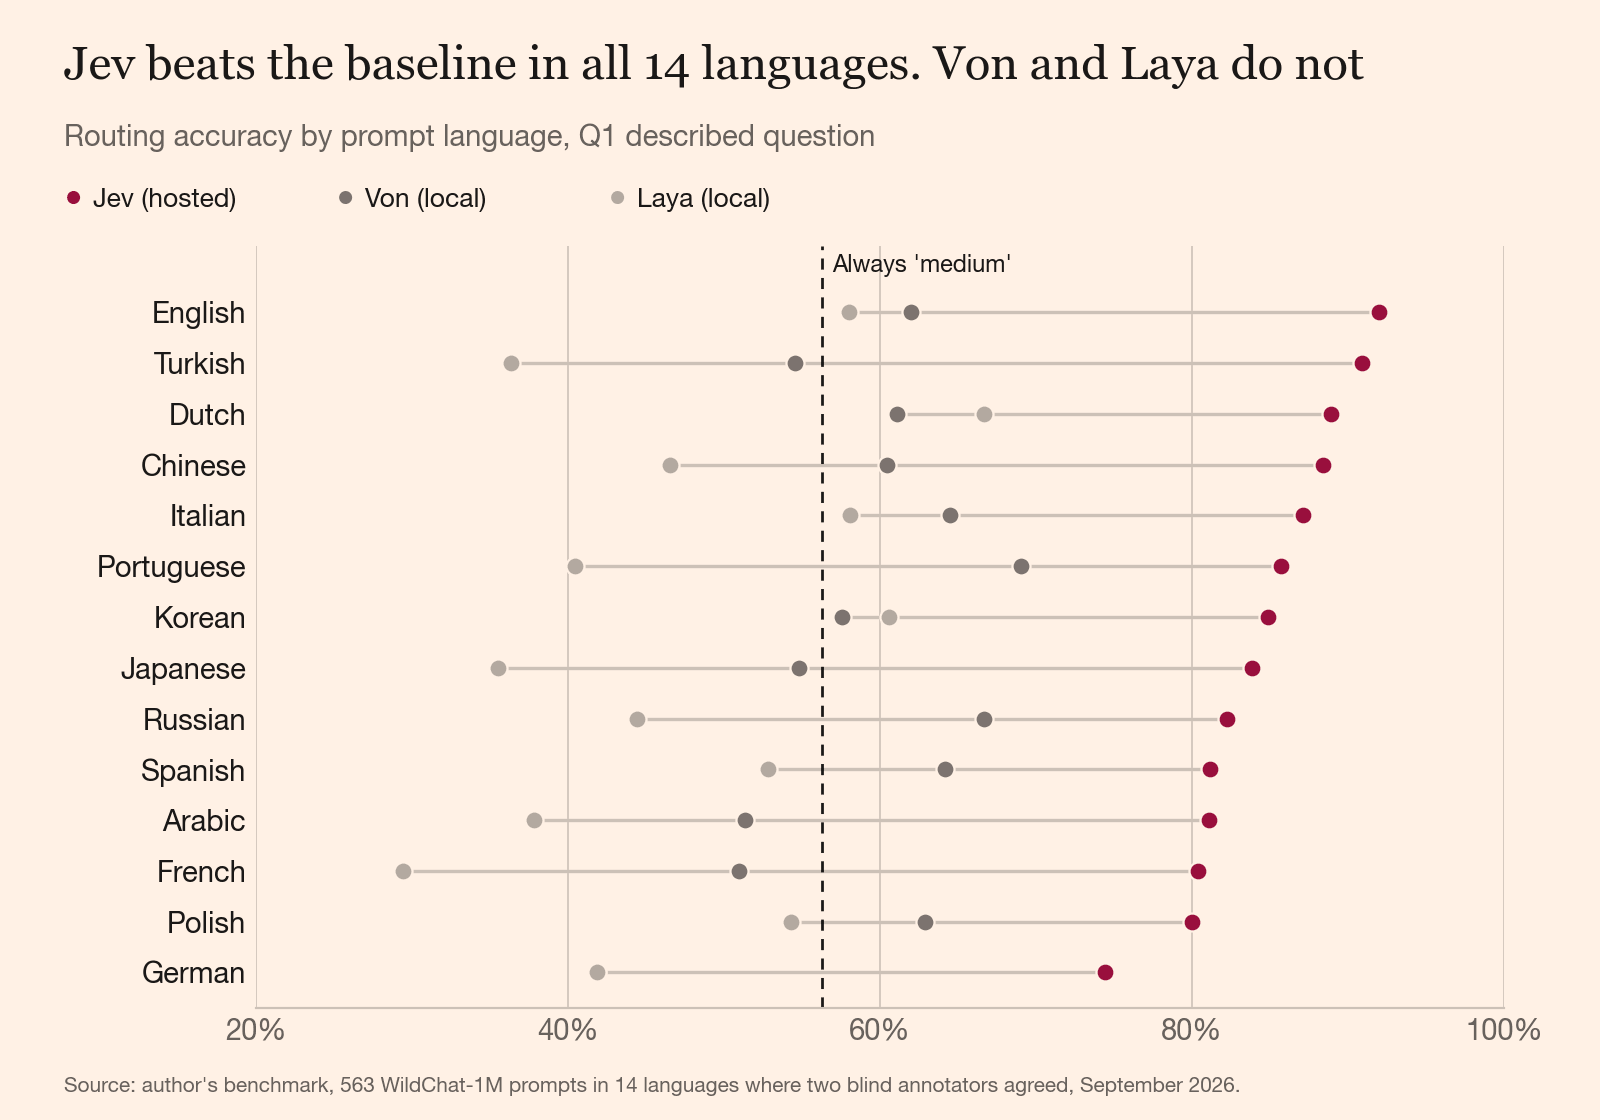
Précision par langue sur Q1. Avec 31 à 53 prompts par langue, un seul prompt fait bouger un score de 2 à 3 points.
Jev est resté entre 74 % (allemand) et 92 % (anglais), et a obtenu 84 % aussi bien sur les écritures latines que non latines. Von est allé de 42 % en allemand à 69 % en portugais, Laya de 29 % en français à 67 % en néerlandais. Un routeur qui ne tombe juste en français que moins d'une fois sur trois ne peut pas approcher un client francophone.
## Jev rate les prompts qui comptent le plus.
Sur les 21 prompts frontier, Jev en a envoyé six vers frontier et 15 vers medium sur Q1. Sur Q2, il en a envoyé trois. C'est précisément là que router vers le moins cher fait le plus de dégâts : un problème de statistiques en turc, des règles de décision d'investissement en allemand, un plan sur la distribution quantique de clés. Vingt et un, c'est un petit échantillon, et je suis le premier à le dire.
Les probabilités de Jev aident. Escaladez vers frontier dès que Jev lui attribue plus de 0,2, et Q1 en attrape 14 sur 21 tout en n'escaladant que 18 prompts sur 563. Q2, au même seuil, en attrape sept. J'ai choisi 0,2 après avoir vu ces données, alors prenez-le comme un point de départ à ajuster.
Trois autres éléments vont à l'encontre du chiffre principal :
- **84 % flatte Jev.** Le jeu de référence, ce sont les prompts sur lesquels les deux annotateurs étaient d'accord, donc les plus faciles. Les annotateurs n'étaient d'accord que 77,5 % du temps sur l'ensemble complet, donc environ 80 % est un plafond réaliste pour n'importe quel routeur avec ces niveaux.
- **Ce sont des étiquettes de jugement.** Deux modèles ont deviné de quel niveau un prompt avait besoin. Personne n'a vérifié ce que chaque niveau produisait réellement.
- **Jev est plus lent.** La latence médiane était d'environ 330 ms par appel depuis mon portable, surtout du réseau, contre 56 à 170 ms pour les modèles locaux.
## Le routeur bon marché est celui qui coûte cher.
Au final, nous n'avons pas pu déployer Jev : il n'a pas de déploiement dans l'UE. Alors j'ai fait du fine-tuning de Laya sur nos propres étiquettes, et ce routeur [tourne désormais sur un seul serveur CPU en Allemagne](/fr/blog/routeur-llm-serveur-hetzner-cpu).
Un routeur local ne coûte rien par appel. S'il envoie 41 % de votre trafic vers un niveau dont ce trafic n'a pas besoin, comme Von l'a fait sur Q2, vous payez cela sur chacun de ces appels, et ce coût n'apparaît sur aucune fiche de modèle que j'ai lue.
Alors comptez. Prenez WildChat ou vos propres logs, faites étiqueter quelques centaines de prompts par deux annotateurs, écartez ceux sur lesquels ils ne s'accordent pas, et évaluez votre routeur face à `return "medium"`. S'il ne dépasse pas cette barre de dix points, vous n'avez pas de routeur.
Le meilleur test, que nous lançons ensuite, est fondé sur les résultats : faire passer du trafic réel par chaque niveau, noter le niveau le moins cher dont la réponse était suffisante, et évaluer le routeur par rapport à cela. Si les 84 % de Jev s'effondrent là-dessus, je le publierai aussi.