# Open-Source-Alternativen zu Jev taugen nichts, hier ist der Benchmark
> Drei LLM-Router, 563 echte Prompts in 14 Sprachen. Jev routete 84 % richtig. Zwei lokale offene Modelle schlugen ein stures „medium“ nur knapp.
- Source: https://jays.fyi/de/blog/open-source-alternativen-zu-jev-benchmark
- Author: Jay Derinbogaz
- Published: 2026-09-23
- Language: de
- Tags: ai, open-source, benchmarks
- Reading time: 7 min
- Machine translated: yes — original: https://jays.fyi/blog/local-llm-routers-lost-to-always-answering-medium
---
Jedes Chat-Produkt mit einem Modell-Dropdown schiebt seinen Nutzern eine Routing-Aufgabe zu. Sie müssen raten, ob ihre Frage das teure oder das billige Modell verdient, und die meisten wählen einmal und fassen die Einstellung nie wieder an. Also zahlen sie zu viel für „Was ist Welpenliebe?“ und zu wenig für einen Beweis über Bernoulli-Stichproben.
Wir bauen bei [TextCortex](https://textcortex.com/) eine automatische Modellauswahl, damit niemand raten muss. Ein Router liest den Prompt und wählt die billigste Stufe, die ihn noch gut beantwortet. Der naheliegende Weg dahin ist ein kleines offenes Modell auf eigener Hardware: keine Gebühr pro Aufruf, etwa 60 Millisekunden pro Aufruf, und der Prompt verlässt nie das Haus. Ich bin davon ausgegangen, dass wir dort landen würden.
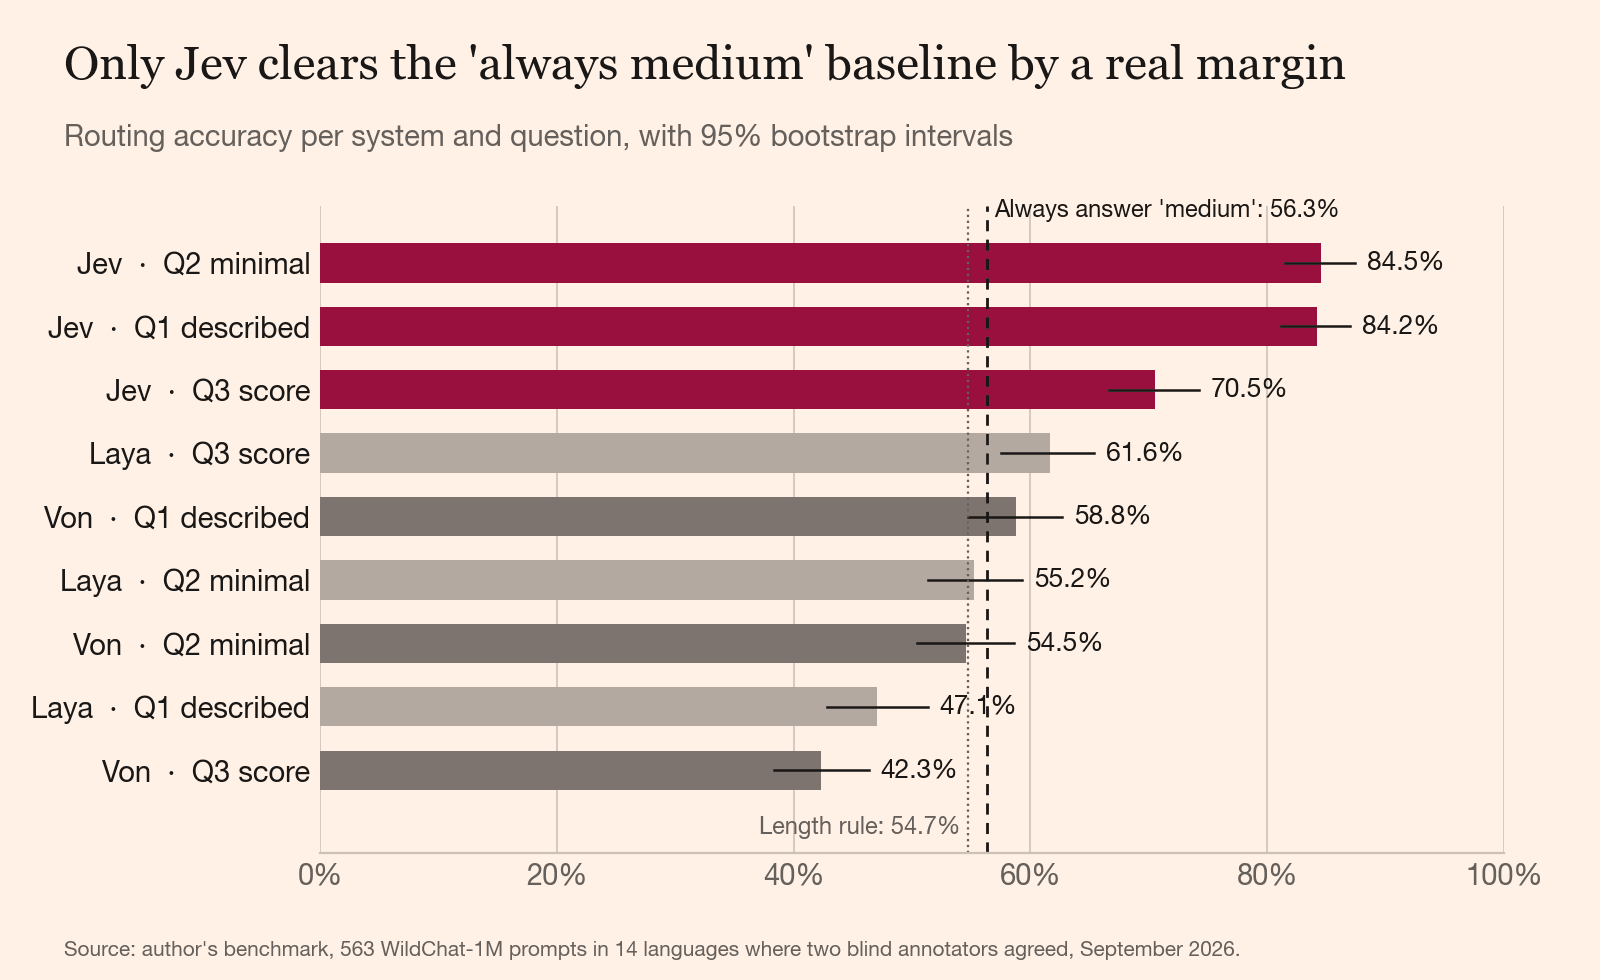
Also habe ich gemessen. Bei 563 echten Chatbot-Prompts in 14 Sprachen routete das gehostete Modell Jev **84,5 %** davon auf die richtige Stufe. Laya und Von, offene Modelle auf meinem Laptop, kamen auf höchstens 61,6 % und 58,8 %. Ein Router, der auf jeden Prompt „medium“ antwortet, erreicht 56,3 %. Nennen wir ihn den konstanten Router. Vier der sechs Läufe von Laya und Von verloren gegen ihn.
## Ein Router ist eine Multiple-Choice-Frage, die vor jedem Prompt gestellt wird.
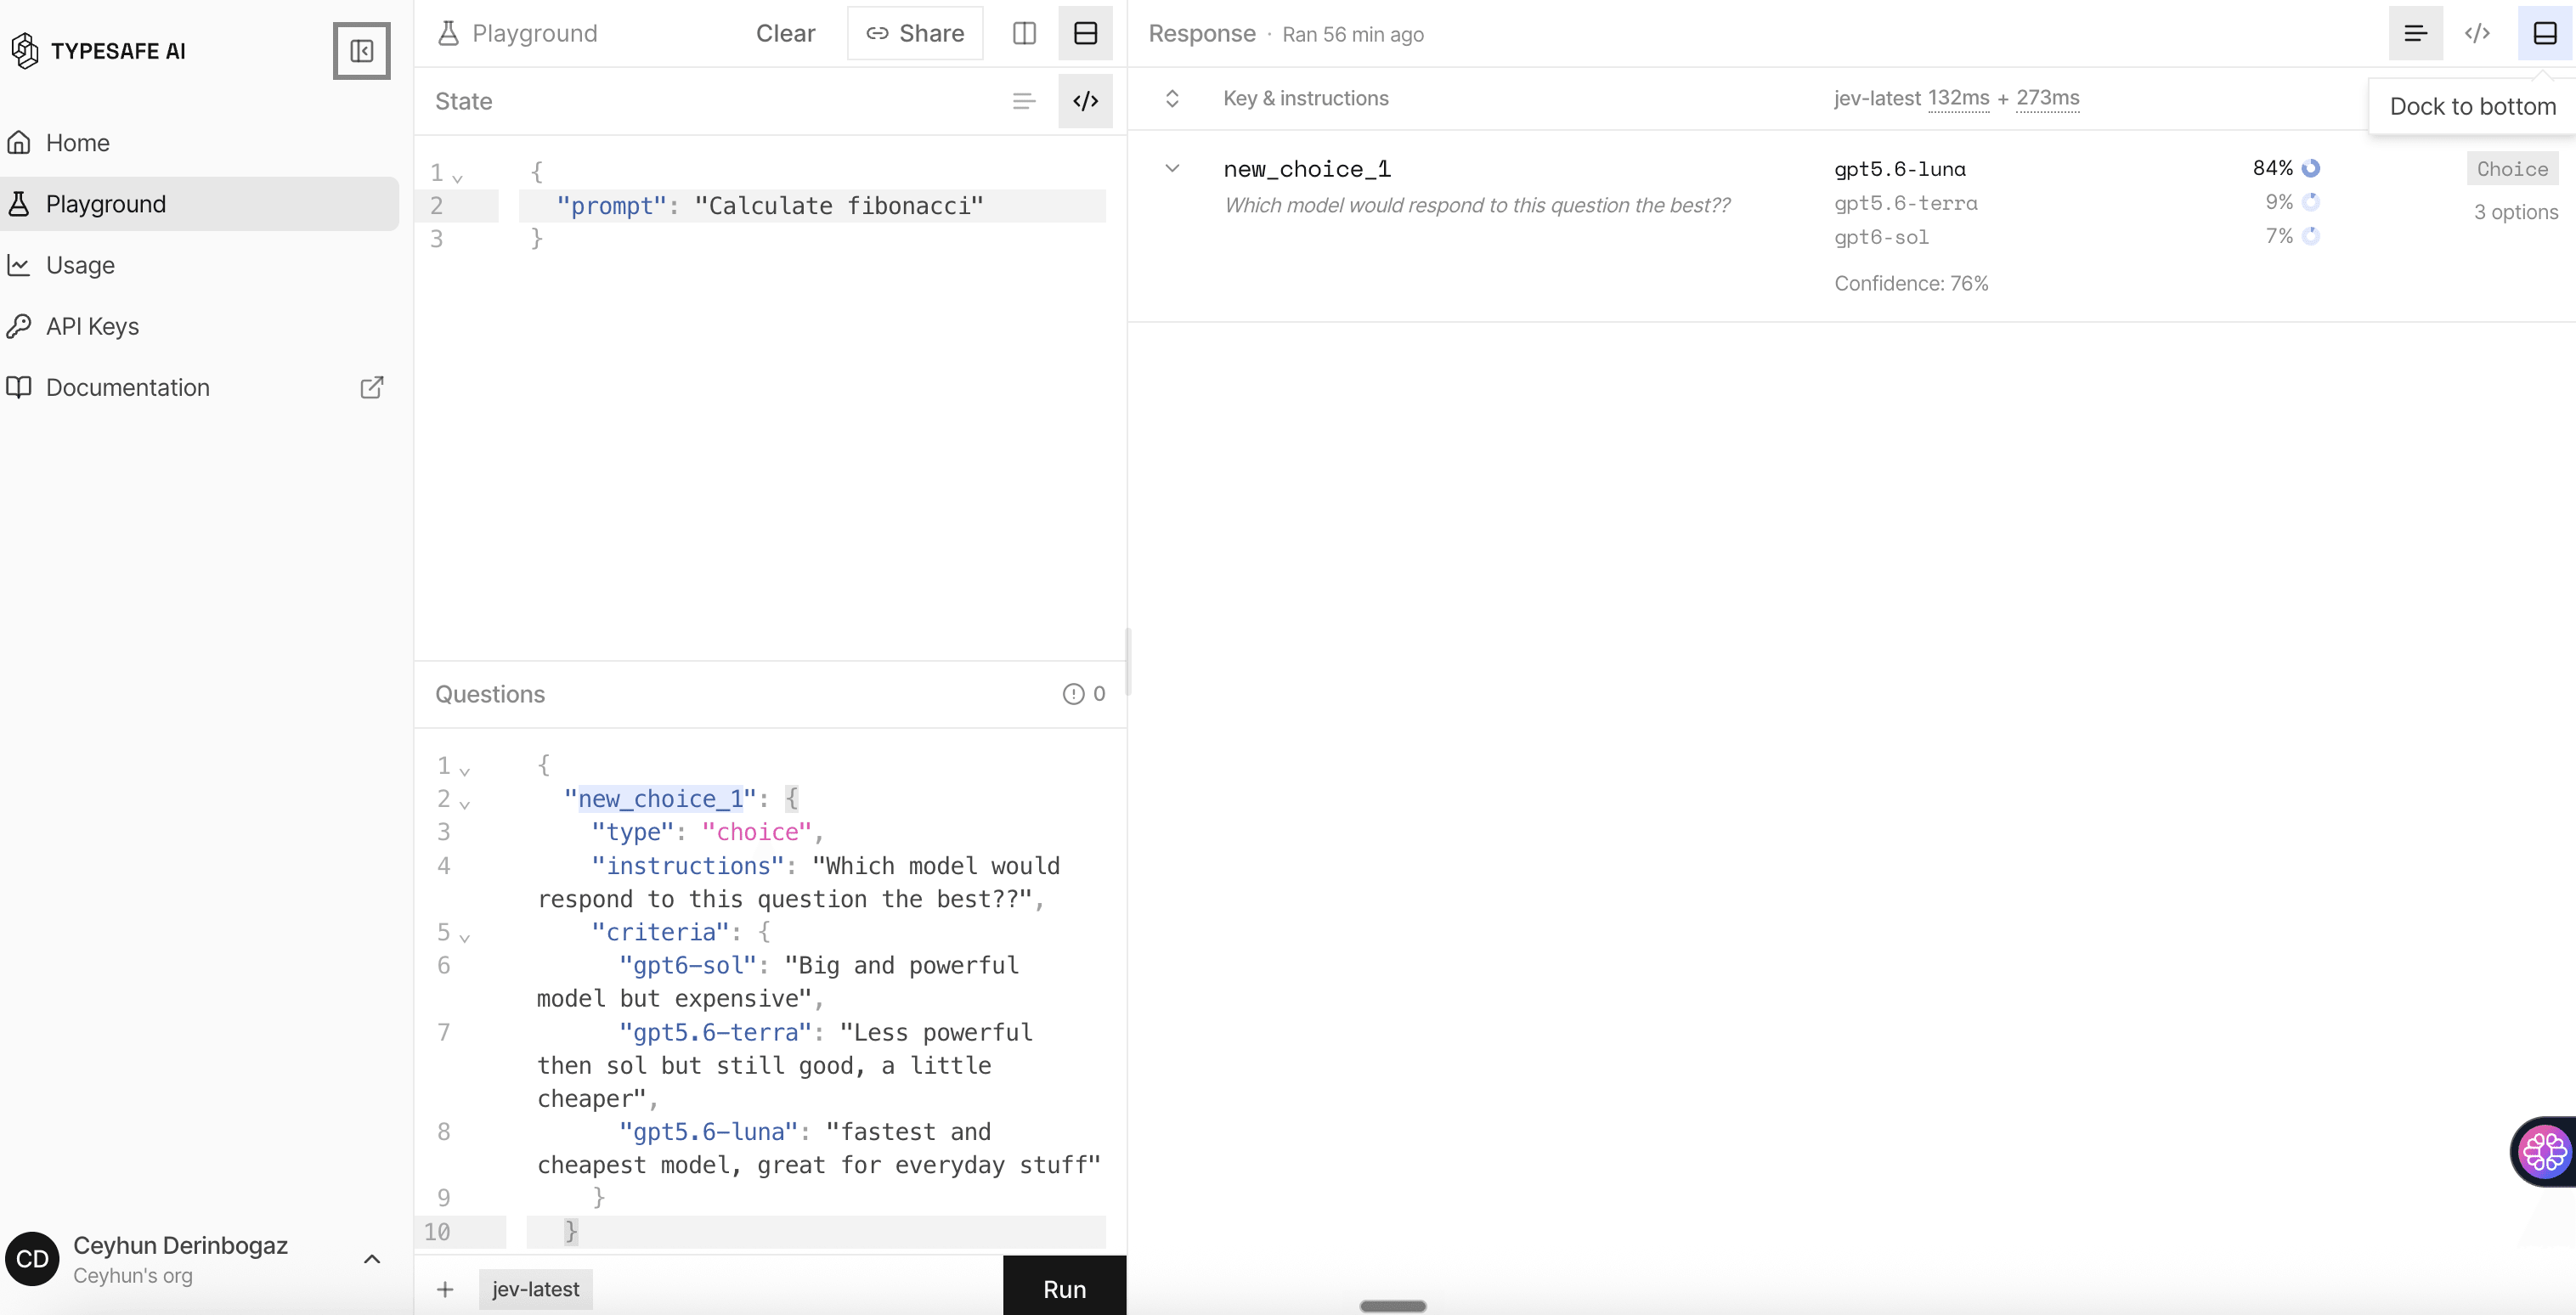
Alle drei Systeme sprechen dieselbe API. Du schickst den Prompt und dazu eine Frage mit benannten Optionen und einem Satz, der jede Option beschreibt. Zurück bekommst du eine Wahrscheinlichkeit pro Option.
Meine erste Routing-Frage im Typesafe AI-Playground, mit ausgedachten Stufennamen. Der Benchmark nutzte neue Formulierungen und neutrale Stufennamen.
„Calculate fibonacci“ geht an die billige Stufe. Natürlich. Ich habe alle drei Router zuerst mit solchen Prompts getestet, und Jev gewann auch diese Runde, aber die Prompts, die ich für einen Router schreibe, sind Prompts, deren Antwort ich schon kenne. Bewiesen hat das fast nichts.
## Ich habe echte Prompts genommen, weil meine zu leicht waren.
Die Prompts stammen aus [WildChat-1M](https://huggingface.co/datasets/allenai/WildChat-1M), einem öffentlichen Datensatz echter Chatbot-Unterhaltungen (ODC-BY-Lizenz, toxische herausgefiltert). Ich habe jeweils 40 erste Nachrichten auf Englisch, Deutsch, Französisch, Spanisch, Italienisch, Portugiesisch, Niederländisch, Polnisch, Türkisch, Russisch, Arabisch, Chinesisch, Japanisch und Koreanisch genommen und dann 168 längere oder technischere Prompts ergänzt, weil echter Traffic fast keine schweren enthält.
Zwei blinde Annotatoren auf unterschiedlichen Modellen, Claude Opus und Claude Sonnet, haben alle 728 Prompts als small, medium oder frontier gelabelt. Sie waren sich in 77,5 % der Fälle einig (Cohens κ = 0,60). Ich habe die 563 behalten, bei denen sie übereinstimmten: 225 small, 317 medium, 21 frontier.
Jedes System beantwortete drei Fragen pro Prompt, 5.067 Aufrufe ohne einen einzigen harten Fehler:
- **Q1, beschrieben.** „Wähle die billigste Stufe, die ihn noch gut beantwortet“, mit Beispielaufgaben für jede Stufe.
- **Q2, minimal.** „Einfache“, „mäßig komplexe“ und „sehr schwere Anfragen“.
- **Q3, Score.** Ein dreistufiger Schwierigkeitswert, auf Stufen abgebildet.
## Zwei der drei Router schlagen eine Konstante nur knapp.
Genauigkeit auf den 563 übereinstimmend gelabelten Prompts, mit 95-%-Bootstrap-Intervallen. Die Längenregel schickt Prompts unter 60 Zeichen an small, unter 1.500 an medium und den Rest an frontier.
Jev erreichte 84,5 % mit Beschreibungen aus zwei, drei Wörtern und 84,2 % mit der vollen Rubrik. Der Unterschied ist Rauschen, also muss niemand in meinem Team zum Prompt Engineer werden, um eine Routing-Frage zu schreiben.
Layas bester Lauf schlug den konstanten Router um 5,3 Punkte. Vons um 2,5, mit einem 95-%-Intervall (55 % bis 63 %), das die Konstante noch enthält. Eine Regel, die nur auf die Länge des Prompts schaut, erreichte 54,7 %, mehr als zwei lokale Läufe und höchstens einen Punkt hinter zwei weiteren.
Ein Router, der gegen `return "medium"` verliert, ist ein Zufallszahlengenerator mit angehängtem Modell-Download.
## Die lokalen Modelle raten „medium“ und nennen es eine Entscheidung.
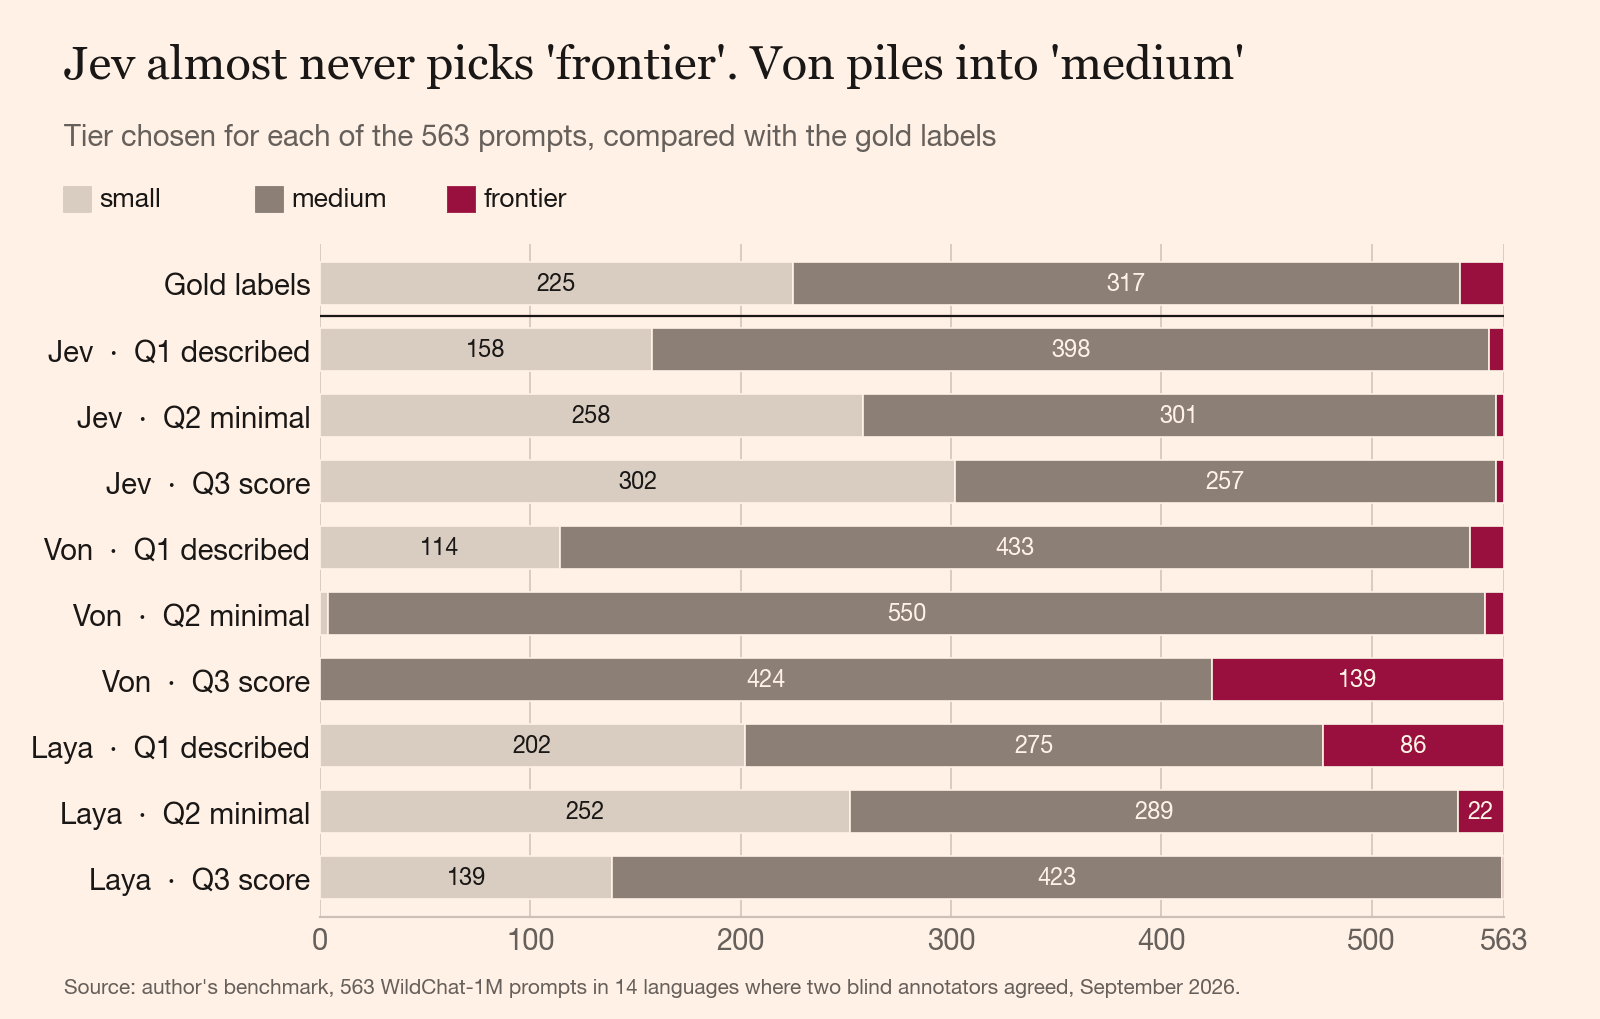
Was jeder Lauf geantwortet hat, verglichen mit den Gold-Labels.
Von antwortete bei Q2 in 550 von 563 Fällen „medium“. Bei Q3 sagte es kein einziges Mal small und schickte 139 Prompts an frontier, obwohl 21 dorthin gehören. Laya schickte bei Q1 86 Prompts an frontier und lag bei sechs richtig. Sein mehrsprachiger Checkpoint bearbeitete 1.329 seiner 1.689 Aufrufe, und trotzdem kam es auf Französisch auf 29 %.
## Von und Laya geben bei bis zu 55 % der Prompts zu viel aus.
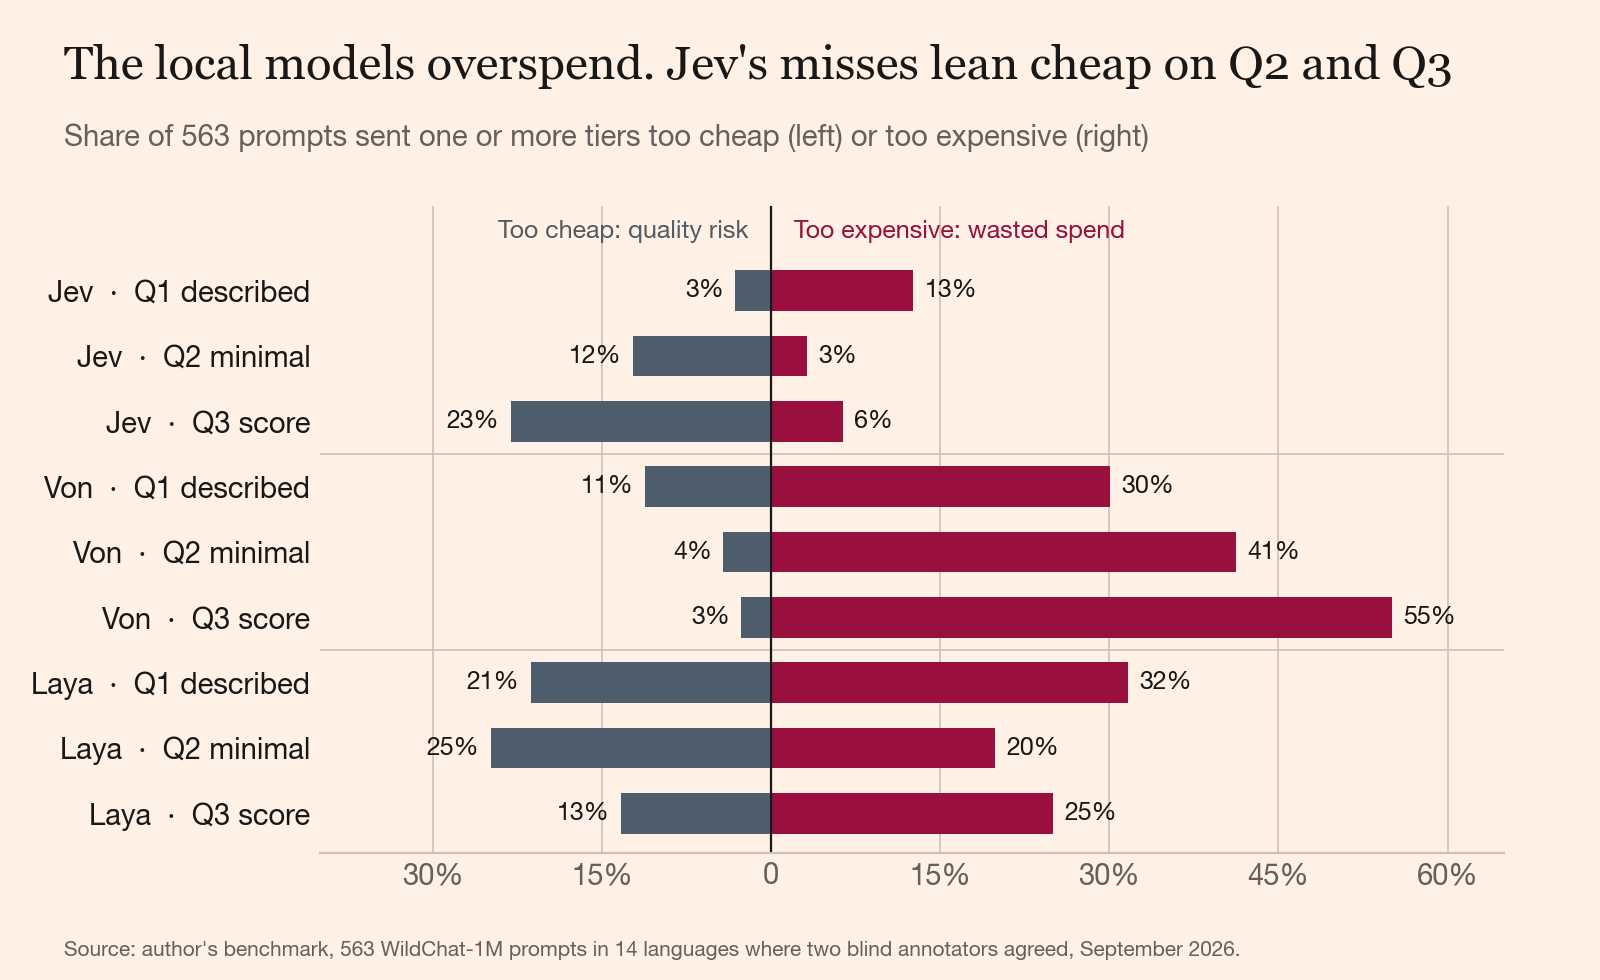
Anteil der Prompts, die billiger (links) oder teurer (rechts) geroutet wurden als das Gold-Label.
Von schickt bei Q3 55 % aller Prompts an eine teurere Stufe, als sie brauchen. Dieser Router treibt genau die Rechnung hoch, die er senken soll.
Jev kippt bei Q2 und Q3 in die andere Richtung, und das ist pro Fehler schlimmer. Eine zu teure Antwort kostet die Preisdifferenz. Eine zu schwache kostet einen Nutzer, der eine schwere Frage gestellt und eine selbstbewusste falsche Antwort bekommen hat. Bei Q2 waren 51 von Jevs Fehlern medium-Prompts, die an small gingen. Bei Q3 waren es 113.
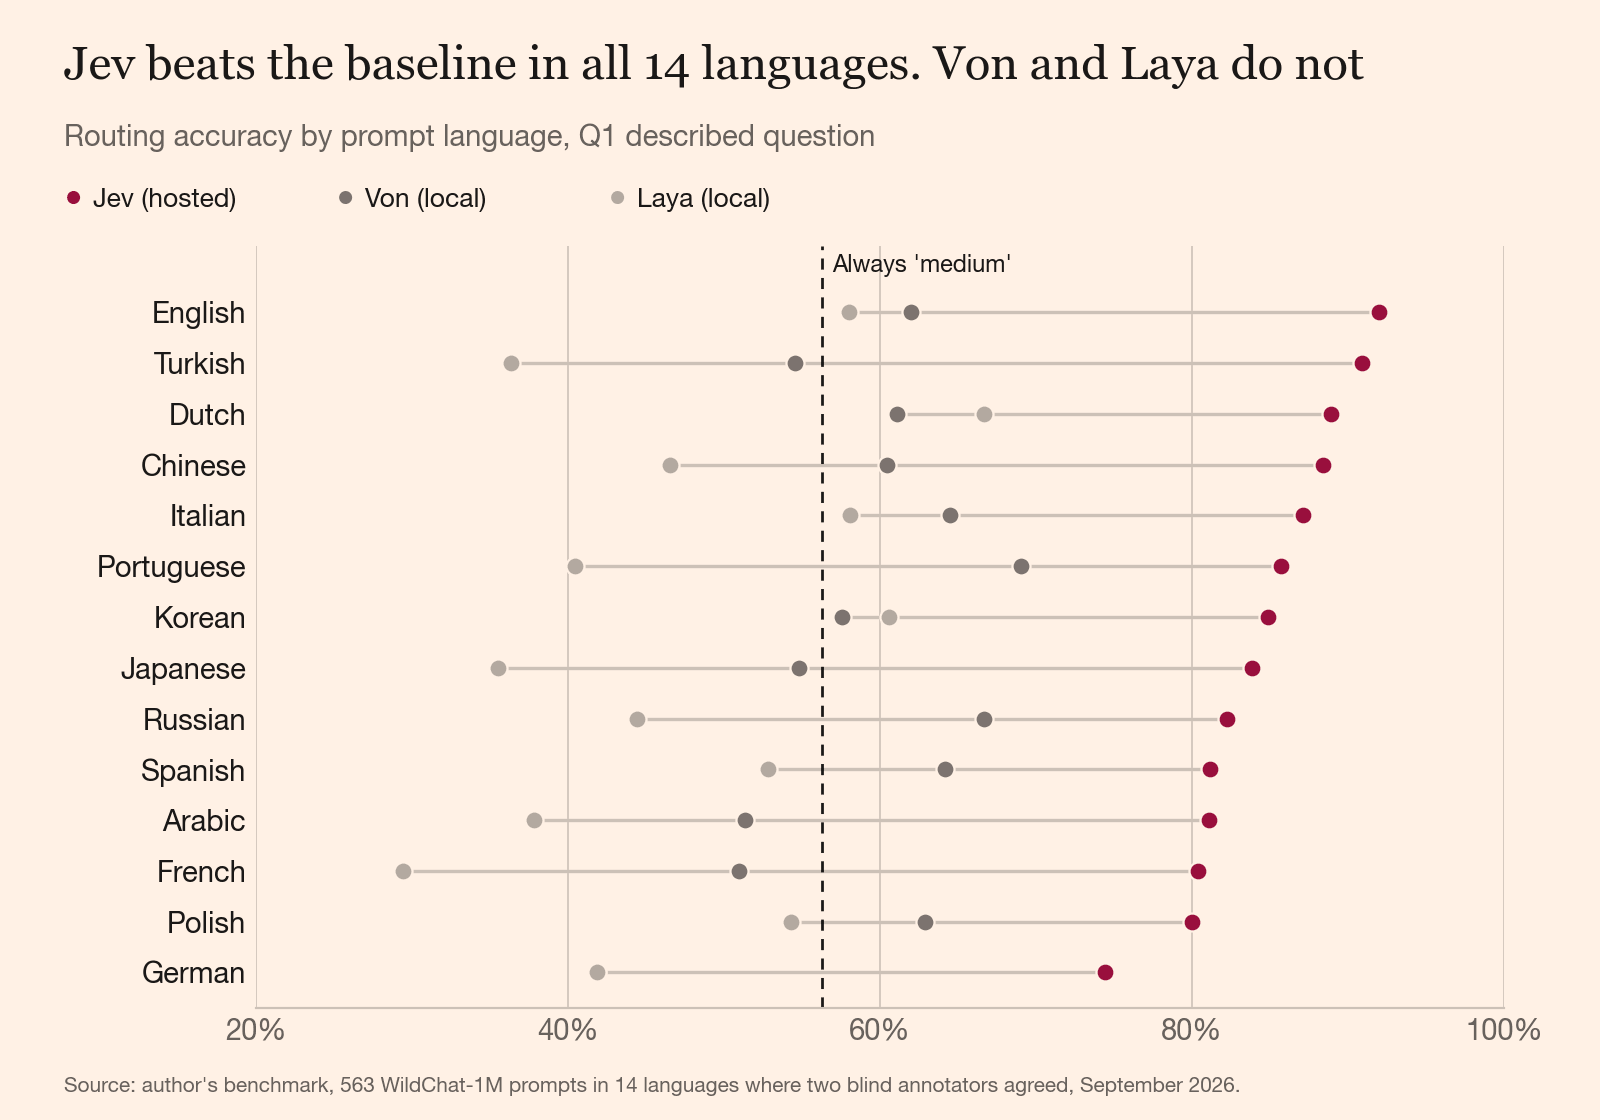
## Die Sprache hat Jev kaum bewegt und alle anderen stark.
Genauigkeit nach Sprache bei Q1. Bei 31 bis 53 Prompts pro Sprache verschiebt ein einzelner Prompt den Wert um 2 bis 3 Punkte.
Jev blieb zwischen 74 % (Deutsch) und 92 % (Englisch) und kam auf lateinischen wie nicht-lateinischen Schriften gleichermaßen auf 84 %. Von reichte von 42 % auf Deutsch bis 69 % auf Portugiesisch, Laya von 29 % auf Französisch bis 67 % auf Niederländisch. Ein Router, der Französisch in weniger als einem Drittel der Fälle richtig macht, darf nicht in die Nähe französischer Kunden.
## Jev verfehlt ausgerechnet die Prompts, auf die es am meisten ankommt.
Von den 21 frontier-Prompts schickte Jev bei Q1 sechs an frontier und 15 an medium. Bei Q2 waren es drei. Genau dort richtet billiges Routing den größten Schaden an: eine Statistikaufgabe auf Türkisch, Entscheidungsregeln für Investitionen auf Deutsch, eine Gliederung zur Quantenschlüsselverteilung. Einundzwanzig ist eine kleine Stichprobe, und ich sage das als Erster.
Jevs Wahrscheinlichkeiten helfen. Eskaliere an frontier, sobald Jev der Stufe mehr als 0,2 gibt, dann fängt Q1 14 der 21 ab und eskaliert dabei nur 18 von 563 Prompts. Q2 fängt beim selben Schwellenwert sieben ab. Ich habe 0,2 gewählt, nachdem ich diese Daten gesehen hatte, also nimm den Wert als Startpunkt zum Nachjustieren.
Drei weitere Punkte sprechen gegen die Schlagzeile:
- **84 % schmeicheln Jev.** Das Gold-Set besteht aus den Prompts, bei denen sich beide Annotatoren einig waren, also den leichteren. Auf dem vollen Set waren sich die Annotatoren nur in 77,5 % der Fälle einig, realistisch liegt die Obergrenze für jeden Router mit diesen Stufen also bei etwa 80 %.
- **Das sind Urteils-Labels.** Zwei Modelle haben geschätzt, welche Stufe ein Prompt braucht. Niemand hat geprüft, was jede Stufe tatsächlich geliefert hat.
- **Jev ist langsamer.** Die mediane Latenz lag von meinem Laptop aus bei etwa 330 ms pro Aufruf, größtenteils Netzwerk, gegenüber 56 bis 170 ms für die lokalen Modelle.
## Der billige Router ist der teure.
Am Ende konnten wir Jev nicht einsetzen: Es gibt kein EU-Deployment. Also habe ich Laya per Fine-Tuning auf unseren eigenen Labels nachtrainiert, und dieser Router [läuft jetzt auf einem einzigen CPU-Server in Deutschland](/de/blog/llm-router-hetzner-server-ohne-gpu).
Ein lokaler Router kostet nichts pro Aufruf. Wenn er 41 % deines Traffics an eine Stufe schickt, die dieser Traffic nicht braucht, wie Von bei Q2, zahlst du das bei jedem dieser Aufrufe, und diese Kosten stehen auf keiner Model Card, die ich gelesen habe.
Also zähl nach. Nimm WildChat oder deine eigenen Logs, lass ein paar hundert Prompts von zwei Annotatoren labeln, wirf die raus, bei denen sie sich uneinig sind, und miss deinen Router gegen `return "medium"`. Wenn er diese Linie nicht um zehn Punkte übertrifft, hast du keinen Router.
Der bessere Test, den wir als Nächstes fahren, misst das Ergebnis: echten Traffic durch jede Stufe schicken, die billigste Stufe festhalten, deren Antwort gut genug war, und den Router daran messen. Wenn Jevs 84 % dort zerfallen, veröffentliche ich das auch.